A Survey on Evaluation of Large Language Models
-
ArXiv URL: https://arxiv.org/abs/2307.03109v9
-
作者: Yue Zhang; Cunxiang Wang; Xu Wang; Hao Chen; Yi Chang; Kaijie Zhu; Yidong Wang; Xiaoyuan Yi; Linyi Yang; Yuan Wu; 等6人
-
发布机构: Carnegie Mellon University; Chinese Academy of Sciences; Hong Kong University of Science and Technology; Jilin University; Microsoft Research Asia; Peking University; University of Illinois at Chicago; Westlake University
A Survey on Evaluation of Large Language Models
引言
理解智能的本质并判断机器是否具备智能,是科学家们面临的一个引人入胜的问题。人工智能(AI)研究人员专注于发展基于机器的智能。在AI领域,图灵测试(Turing Test)长期以来被视为评估智能的黄金标准。AI的发展史也可以看作是智能模型与算法的创造和评估史。每一次新模型或算法的出现,都伴随着对其在真实场景中能力的审视。从早期的感知机(Perceptron)到支持向量机(SVMs)和深度学习,对AI的评估始终是识别系统局限性、指导未来设计的关键工具。
近年来,大型语言模型(Large Language Models, LLMs)在学术界和工业界引起了巨大关注。LLMs展现出的强大能力甚至让一些研究者认为它们可能是这个时代的人工通用智能(Artificial General Intelligence, AGI)的雏形。由于LLMs在处理通用自然语言任务和特定领域任务方面的卓越表现,它们越来越多地被用于满足学生、病人等用户群体的关键信息需求。
因此,对LLM的评估至关重要,原因如下:
- 理解优缺点:评估有助于我们更好地了解LLM的优势和劣势。
- 指导人机交互:更好的评估可以为未来的人机交互设计提供启发。
- 确保安全可靠:LLM的广泛应用,尤其是在金融和医疗等安全敏感领域,使得确保其安全性和可靠性至关重要。
- 应对新兴能力:随着LLM变得越来越大,并涌现出新的能力,现有的评估协议可能不足以评估其能力和潜在风险。
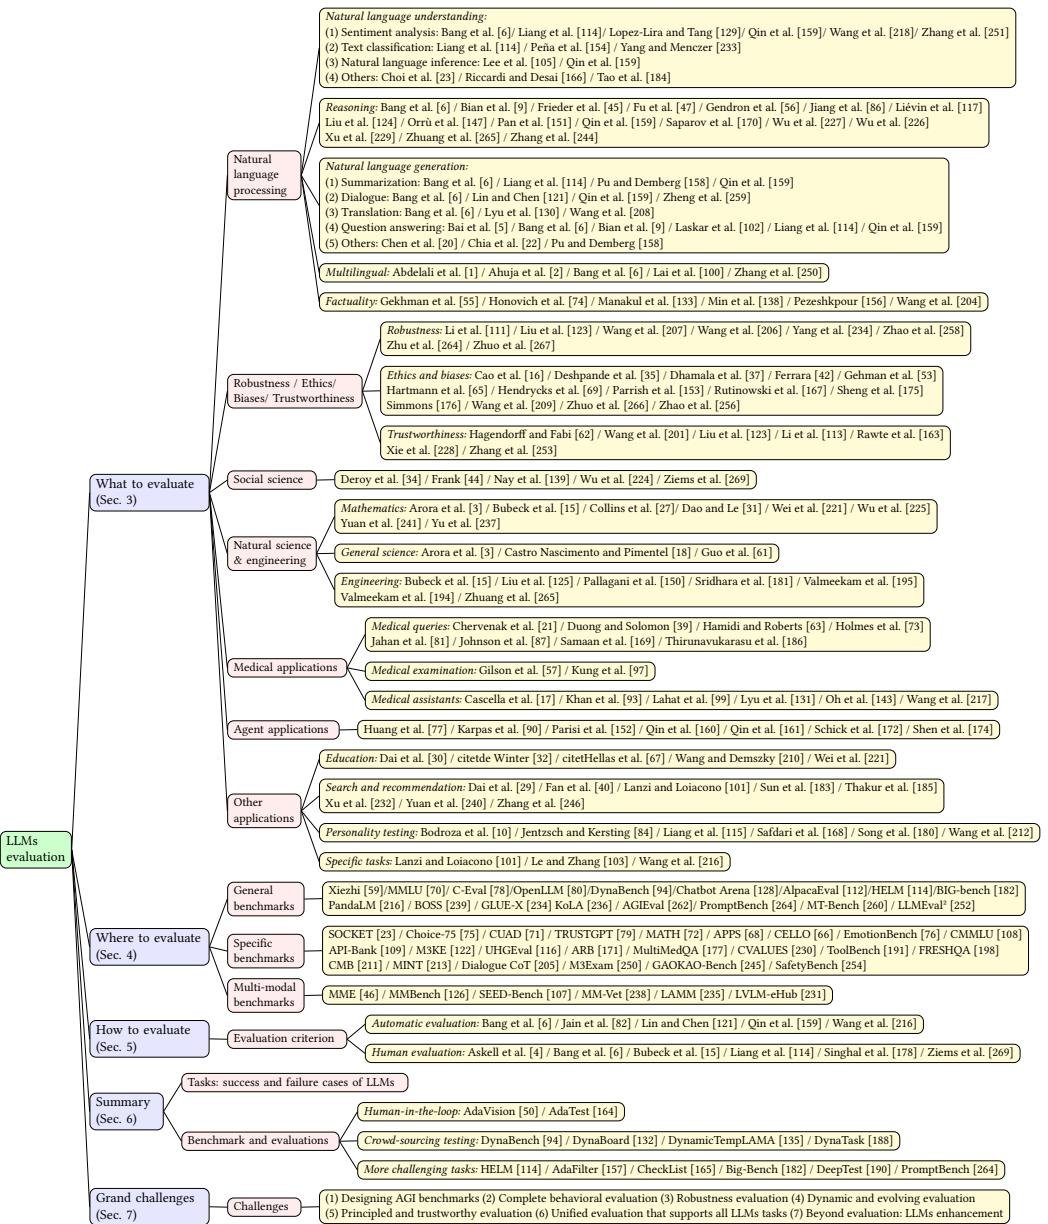
尽管已有不少研究从自然语言任务、推理、鲁棒性、伦理等多个方面对ChatGPT等模型进行评估,但仍缺乏一个全面的评估综述。本文旨在成为首个关于大型语言模型评估的综合性综述。如图1所示,本文从三个维度展开探讨:评估什么 (What to evaluate)、在哪里评估 (Where to evaluate) 和 如何评估 (How to evaluate)。具体而言,“评估什么”涵盖了LLM的现有评估任务;“在哪里评估”涉及为评估选择合适的数据集和基准;“如何评估”则关注在给定任务和数据集下的评估过程。
本文的贡献如下:
- 从“评估什么”、“在哪里评估”和“如何评估”三个方面,提供了一个关于LLM评估的全面综述。
- 在“评估什么”方面,总结了各个领域的现有任务,并对LLM的成功和失败案例进行了深入分析。
- 在“在哪里评估”方面,总结了评估指标、数据集和基准。在“如何评估”方面,探讨了当前的协议和新颖的评估方法。
- 探讨了LLM评估未来面临的挑战,并开源了相关资料以促进社区合作。
背景
大型语言模型 (LLMs)
语言模型(Language Models, LMs)是能够理解和生成人类语言的计算模型。大型语言模型(LLMs)是具有海量参数和卓越学习能力的先进语言模型。许多先进LLM(如GPT-3, GPT-4)背后的核心模块是Transformer [197]中的自注意力机制(self-attention module)。
LLM的一个关键特性是上下文学习(in-context learning)[14],模型根据给定的上下文或提示生成文本。另一个关键技术是基于人类反馈的强化学习(Reinforcement Learning from Human Feedback, RLHF)[25, 268],通过使用人类生成的反馈作为奖励来微调模型,使其从错误中学习并持续改进。
在自回归语言模型中,给定上下文序列 $X$,其目标是预测下一个 token $y$。模型通过最大化给定token序列的条件概率来进行训练,该概率可以通过链式法则分解:
\[P(y \mid X) = \prod_{t=1}^{T} P(y_t \mid \mathbf{x}_1, \mathbf{x}_2, \dots, \mathbf{x}_{t-1}),\]其中 $T$ 是序列长度。
与LLM交互的常用方法是提示工程(prompt engineering)[26, 222, 263],用户设计特定的提示来引导LLM生成期望的响应。
| 特性 | 传统机器学习 | 深度学习 | 大型语言模型 |
|---|---|---|---|
| 训练数据量 | 大 | 很大 | 超大规模 |
| 特征工程 | 手动 | 自动 | 自动 |
| 模型复杂度 | 有限 | 复杂 | 极其复杂 |
| 可解释性 | 好 | 差 | 更差 |
| 性能 | 中等 | 高 | 极高 |
| 硬件要求 | 低 | 高 | 极高 |
AI模型评估
AI模型评估是衡量模型性能的关键步骤。标准的评估协议包括k折交叉验证、留出验证、留一交叉验证(LOOCV)等。然而,由于深度学习模型训练规模庞大,这些方法通常不适用。因此,在静态验证集上进行评估长期以来成为深度学习模型的标准选择,例如计算机视觉领域的ImageNet和自然语言处理领域的GLUE。

随着LLM的规模越来越大、可解释性越来越差,现有的评估协议可能不足以全面评估其真实能力。
评估什么 (WHAT TO EVALUATE)
为了展示LLM的性能,应该在哪些任务上对其进行评估?本节将现有评估任务分为以下几类:自然语言处理、鲁棒性、伦理、偏见与可信赖性、社会科学、自然科学与工程、医疗应用、智能体应用等。
自然语言处理任务
LLM最初的目标就是提升在自然语言处理(Natural Language Processing, NLP)任务上的表现。因此,大多数评估研究都集中在NLP任务上,包括自然语言理解和生成。
| 参考文献 | 情感分析 | 文本分类 | 自然语言推理 | 其他NLU | 推理 | 摘要 | 对话 | 翻译 | 问答 | 其他NLG | 多语言 |
|---|---|---|---|---|---|---|---|---|---|---|---|
| Abdelali et al. [1] | ✓ | ✓ | |||||||||
| Ahuja et al. [2] | ✓ | ||||||||||
| Bian et al. [9] | ✓ | ✓ | |||||||||
| Bang et al. [6] | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | |||
| Bai et al. [5] | ✓ | ||||||||||
| Chen et al. [20] | ✓ | ||||||||||
| Choi et al. [23] | ✓ | ||||||||||
| Chia et al. [22] | ✓ | ||||||||||
| Frieder et al. [45] | ✓ | ||||||||||
| Fu et al. [47] | ✓ | ||||||||||
| Gekhman et al. [55] | ✓ | ✓ | |||||||||
| Gendron et al. [56] | ✓ | ✓ | ✓ | ✓ | |||||||
| Honovich et al. [74] | ✓ | ||||||||||
| Jiang et al. [86] | ✓ | ||||||||||
| Lai et al. [100] | ✓ | ||||||||||
| Laskar et al. [102] | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | |||
| Lopez-Lira & Tang [129] | ✓ | ||||||||||
| Liang et al. [114] | ✓ | ✓ | ✓ | ✓ | |||||||
| Lee et al. [105] | ✓ | ||||||||||
| Lin and Chen [121] | ✓ | ||||||||||
| Liévin et al. [117] | ✓ | ||||||||||
| Liu et al. [124] | ✓ | ||||||||||
| Lyu et al. [130] | ✓ | ||||||||||
| Manakul et al. [133] | ✓ | ||||||||||
| Min et al. [138] | ✓ | ||||||||||
| Orrù et al. [147] | ✓ | ||||||||||
| Pan et al. [151] | ✓ | ||||||||||
| Peña et al. [154] | ✓ | ||||||||||
| Pu and Demberg [158] | ✓ | ✓ | |||||||||
| Pezeshkpour [156] | ✓ | ||||||||||
| Qin et al. [159] | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | |||||
| Riccardi & Desai [166] | ✓ | ||||||||||
| Saparov et al. [170] | ✓ | ||||||||||
| Tao et al. [184] | ✓ | ||||||||||
| Wang et al. [208] | ✓ | ✓ | |||||||||
| Wang et al. [218] | ✓ | ||||||||||
| Wang et al. [204] | ✓ | ✓ | |||||||||
| Wu et al. [227] | ✓ | ||||||||||
| Wu et al. [226] | ✓ | ||||||||||
| Xu et al. [229] | ✓ | ||||||||||
| Yang & Menczer [233] | ✓ | ||||||||||
| Zheng et al. [259] | ✓ | ||||||||||
| Zhang et al. [251] | ✓ | ||||||||||
| Zhang et al. [250] | ✓ | ||||||||||
| Zhuang et al. [265] | ✓ | ||||||||||
| Zhang et al. [244] | ✓ |
自然语言理解
- 情感分析:LLM在此任务上表现出色,通常优于传统方法。但在低资源语言的情感理解上能力有限。
-
文本分类:LLM在文本分类上表现良好,甚至能处理非常规问题设置下的分类任务,准确率较高。
-
自然语言推理 (NLI):确定“假设”是否能从“前提”中逻辑推导出来。研究表明,ChatGPT在此任务上优于GPT-3.5,但也有研究发现LLM在处理NLI范围和人类分歧方面表现不佳,仍有很大提升空间。
-
语义理解:指对语言深层含义的理解。研究发现,LLM能理解单个事件,但感知事件间语义相似性的能力有限。在因果和意图关系推理上表现较好,但在其他关系类型上较弱。此外,LLM难以区分有意义和无意义的短语,表现逊于人类。
- 社会知识理解:评估结果显示,在社会知识概念的学习和识别上,经过监督微调的小模型(如BERT)的性能远超零样本下的大模型(如GPT系列)。这表明,模型参数量的增加并不一定带来更高水平的社会知识。
推理
推理任务对AI模型是巨大的挑战,需要模型不仅理解信息,还要进行推断。
- 数学推理:ChatGPT在算术推理上能力强,但整体数学推理能力仍需提高。
- 符号与抽象推理:ChatGPT在符号推理上表现不如GPT-3.5,且现有LLM在抽象推理和反事实推理上能力有限。
- 逻辑推理:ChatGPT和GPT-4在多数逻辑推理基准上优于传统微调方法,但在处理新颖和分布外(out-of-distribution)数据时面临挑战。
- 其他推理类型:LLM在常识推理、空间推理和多跳推理上表现普遍较差,但在因果和类比推理上表现尚可。
- 专业领域推理:零样本的InstructGPT和Codex在复杂医学推理等任务上展现出潜力,但仍需改进。
总的来说,LLM在推理方面展现出巨大潜力且持续进步,但仍面临诸多挑战和局限。
自然语言生成
- 摘要:LLM在该任务上表现一般。经过微调的BART模型甚至优于零样本的ChatGPT。
- 对话:Claude和ChatGPT在对话任务上表现优异且具有竞争力。针对特定任务进行微调的模型在面向任务和知识型对话中表现更佳。
- 翻译:虽然并非为翻译专门训练,但LLM表现出强大的性能。GPT-4在人工评估中优于商业机器翻译系统。但LLM在“英文→其他语言”的翻译以及非拉丁语系的翻译能力上仍有不足。
-
问答:LLM在问答任务上表现近乎完美。经过微调的模型(如Vícuna和ChatGPT)能取得极高分数。
- 其他生成任务:在句子风格迁移方面,ChatGPT通过少样本学习超越了先前的监督模型,但在控制句子正式性方面仍与人类行为有差距。在写作任务上,LLM在信息性、专业性、议论性和创造性写作等多方面表现出一致的通用能力。
多语言任务
尽管多数LLM在多语言数据上训练,但评估主要集中在英语上。研究表明,LLM在处理非拉丁语系语言和低资源语言时表现不佳。即使将输入翻译成英文再查询,其性能也劣于SOTA模型。这表明LLM在多语言任务上面临巨大挑战,未来需要关注多语言平衡和对非拉丁语系、低资源语言的支持。
事实性
事实性(Factuality)指模型提供的信息与现实世界事实相符的程度,这对于避免产生“事实幻觉”(factual hallucination)至关重要。
- 评估发现:GPT-4和BingChat等模型能在超过80%的问题上提供正确答案,但离完全准确仍有差距。
- 评估方法:研究者提出了多种评估事实性的方法,如将事实一致性任务转化为二元分类问题,或使用基于信息论的指标。TruthfulQA等数据集被设计用于专门测试模型的事实性。
- 核心挑战:研究发现,仅仅扩大模型规模并不一定能提高其真实性,这表明需要改进训练方法来解决事实性问题。
鲁棒性、伦理、偏见与可信赖性
| 参考文献 | 鲁棒性 | 伦理与偏见 | 可信赖性 |
|---|---|---|---|
| Cao et al. [16] | ✓ | ||
| Dhamala et al. [37] | ✓ | ||
| Deshpande et al. [35] | ✓ | ||
| Ferrara [42] | ✓ | ||
| Gehman et al. [53] | ✓ | ||
| Hartmann et al. [65] | ✓ | ||
| Hendrycks et al. [69] | ✓ | ||
| Hagendorff & Fabi [62] | ✓ | ||
| Li et al. [111] | ✓ | ||
| Liu et al. [123] | ✓ | ✓ | |
| Li et al. [113] | ✓ | ||
| Parrish et al. [153] | ✓ | ||
| Rutinowski et al. [167] | ✓ | ||
| Rawte et al. [163] | ✓ | ||
| Sheng et al. [175] | ✓ | ||
| Simmons [176] | ✓ | ||
| Wang et al. [207] | ✓ | ||
| Wang et al. [206] | ✓ | ||
| Wang et al. [201] | ✓ | ✓ | ✓ |
| Wang et al. [209] | ✓ | ||
| Xie et al. [228] | ✓ | ||
| Yang et al. [234] | ✓ | ||
| Zhao et al. [258] | ✓ | ||
| Zhuo et al. [267] | ✓ | ||
| Zhu et al. [264] | ✓ | ||
| Zhuo et al. [266] | ✓ | ||
| Zhang et al. [253] | ✓ |
鲁棒性
鲁棒性(Robustness)研究系统在面对意外输入时的稳定性,主要包括分布外(OOD)鲁棒性和对抗鲁棒性。
- OOD鲁棒性:研究表明,LLM在面对OOD数据时性能会下降,这凸显了系统安全的潜在风险。
- 对抗鲁棒性:PromptBench等基准的评估结果显示,当前的LLM容易受到对抗性提示(adversarial prompts)的攻击,在字符、词、句子和语义层面的攻击下都表现出脆弱性。AdvGLUE++等新基准也被提出用于评估对抗鲁棒性。
伦理与偏见
LLM可能内化并放大训练数据中存在的有害信息,如攻击性言论、仇恨言论以及针对特定人群(如性别、种族、职业)的社会偏见。
- 毒性与偏见:研究发现ChatGPT仍会产生有害内容,当引入“角色扮演”提示时,其生成内容的毒性会增加高达6倍。
- 政治与人格偏见:基于政治罗盘测试和MBTI测试的评估发现,LLM倾向于表现出进步主义观点和ENFJ人格类型。
- 道德与文化偏见:LLM在道德基础理论上也表现出偏见,并存在对某些文化价值观的偏向。
- 评估工具:研究者开发了如CHBias等中文对话偏见评估数据集,并利用系统提示“越狱”等方法来探测模型的刻板印象偏见。
可信赖性
可信赖性(Trustworthiness)是一个更广泛的概念,除了鲁棒性和伦理问题,还包括其他方面。
- 综合评估:DecodingTrust研究从毒性、偏见、鲁棒性、隐私、机器伦理和公平性等八个维度对GPT模型进行了全面的可信赖性评估。研究发现,虽然GPT-4在标准评估中通常比GPT-3.5更可信,但它也更容易受到特定攻击。
- 超理性与判断一致性:研究表明,LLM可以避免人类常见的认知错误,表现出“超理性”。然而,当面临质疑、否定或误导性线索时,即使其初始判断正确,其判断的一致性也会显著下降。
- 幻觉问题:LLM能够生成看似连贯且真实的文本,但这些信息可能包含事实错误或与现实脱节的陈述,即幻觉(hallucination)现象。评估这些问题有助于改进训练方法,提高模型的可靠性。