最新发布
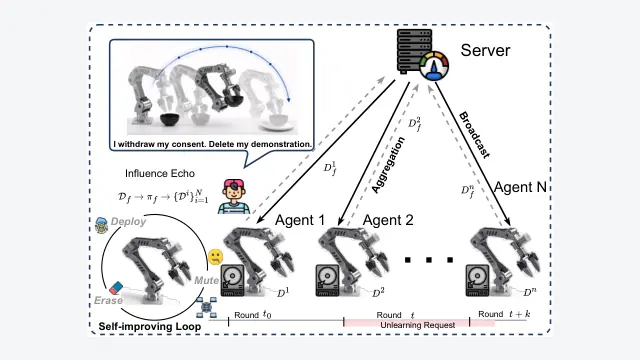
MUTE:消除智能体网络中的遗忘回声,上行通信成本最高缩减80%
针对这一挑战,研究人员提出了名为 MUTE (Muting Unlearned Trajectories' Echoes)的系统性解决方案,通过轻量级账本溯源、模型与数据联合遏制,以及长期行为审计机制,在物理边缘测试床上实现了低通信开销下的可靠数据擦除。
AI Agent模型训练
AGI FRONTIER
深度解读 AI 论文,追踪 Agent、推理、多模态与具身智能的最新进展。
最新发布
针对这一挑战,研究人员提出了名为 MUTE (Muting Unlearned Trajectories' Echoes)的系统性解决方案,通过轻量级账本溯源、模型与数据联合遏制,以及长期行为审计机制,在物理边缘测试床上实现了低通信开销下的可靠数据擦除。
PAPER INSIGHTS
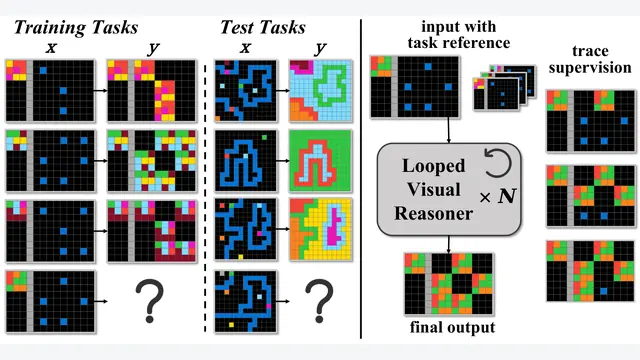
发表于近期的一项研究提出了 TraceViT 。它的核心主张看似直观:既然人类在纸上推理时是逐步绘制草图,循环视觉模型的中间迭代也应当沿着一条语义连贯的“轨迹”逐步推进。然而,该研究揭示了一个反直觉的现象: 如果在循环...
StealthBench:基于这套裁判体系,研究团队提出了三项核心指标,重新定义了攻防智能体的能力图谱: - 安全成功率(Safe Success Rate) :基准的核心主指标,指在所有有效运行中,智能体既成功拿到 ...
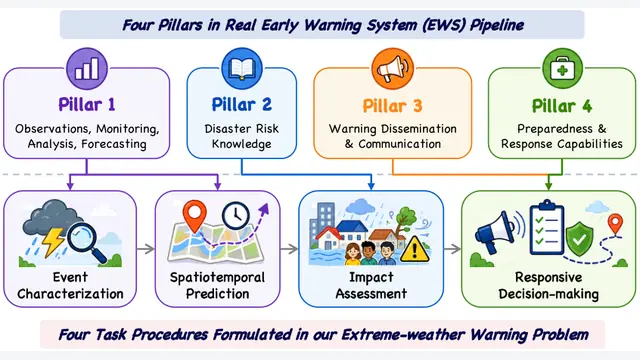
针对 SIREN-Bench 暴露出的业务短板,研究团队提出了 SIREN 框架。该框架的底层逻辑在于:拒绝纯文本口嗨,拒绝缺乏事实依据的盲目推理。整个框架由两大部分构成:高度可交互的执行环境(Agentic Envi...
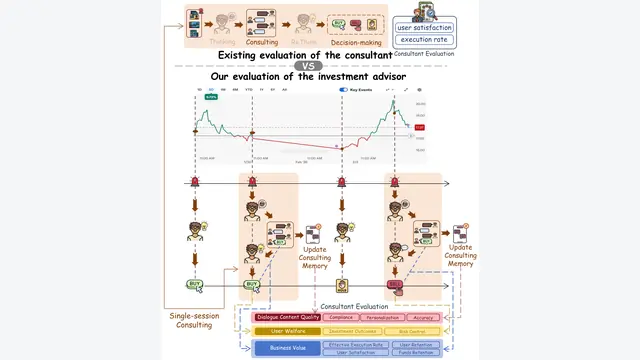
为了复现真实人类面对金钱诱惑与亏损恐惧时的复杂心理,ShiJianBench 没有采用常见的单一静态 Prompt 角色设定(Persona),而是提出了一个结构化的多智能体投资者模拟器(Multi-agent Inv...
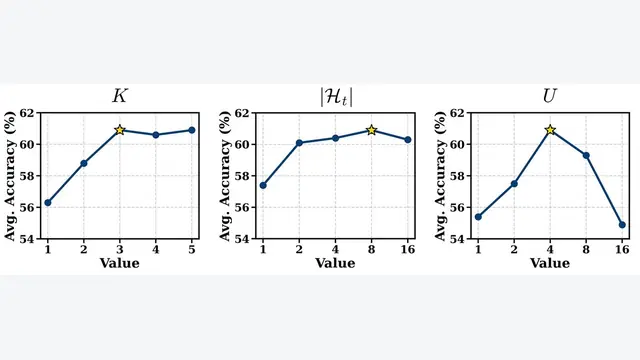
这项最新工作直接击中了这一痛点,提出了首个无须真实标签的自我监督技能优化框架: SSO(Self-Supervised Skill Optimization) 。
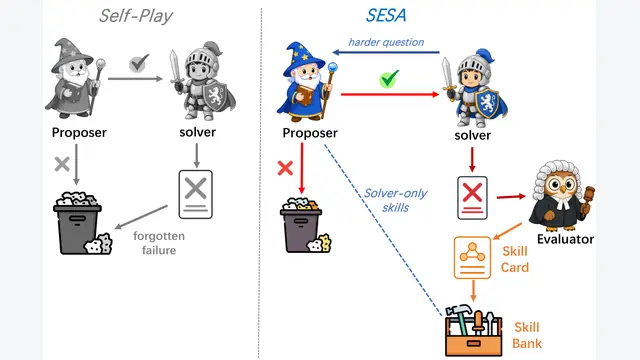
针对这一割裂现状,最新研究提出了 SESA (Self-Evolving Skill-Augmented Agent,自演化技能增强智能体)。该方法首次将在线程序化技能演化无缝嵌入工具增强搜索的自博弈训练中。
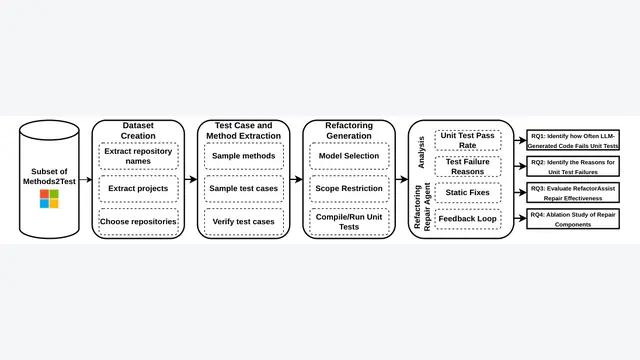
针对大模型重构“看似优雅、实则跑不通”的行业顽疾,一项最新研究提出了名为 RefactorAssist 的智能体修复框架。研究团队首先在真实开源 Java 项目中对主流模型的重构失败原因展开了大规模实证分析。
CMU:本文提出了一个统一的理论框架—— 路由槽内存 (Routing Slot Memories, RSM),指出序列模型的核心问题不是要不要遗忘,而是必须将“信息写向何处”(Where)与“信息留存多久”(How ...
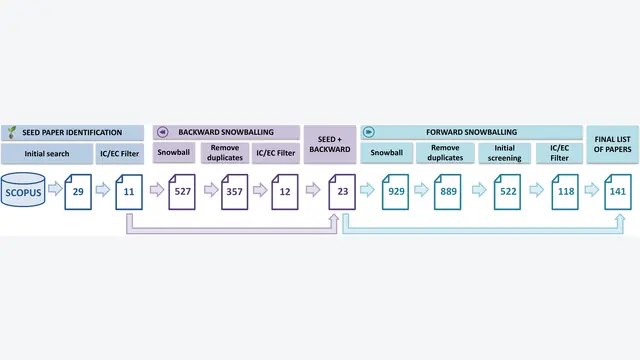
作者在全景梳理之后,对当前多智能体辩论评测的严谨性提出了极为尖锐的质疑。根据这篇系统综述的统计,辩论在数学推理、常识问答和代码补全等具有客观真实标签(Ground Truth)的任务中,确实表现出了相对稳定的性能增益;...
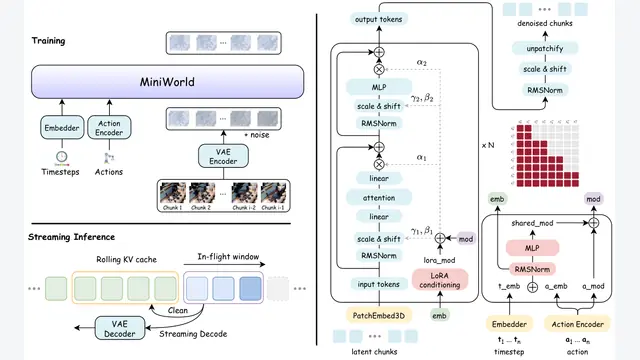
更关键的是,MiniWorld 提出了 块级非递减加噪调度(Chunk-wise Non-Decreasing Noise Schedule) : {% raw %} {% endraw %} 在一个由 个时间块组成的...
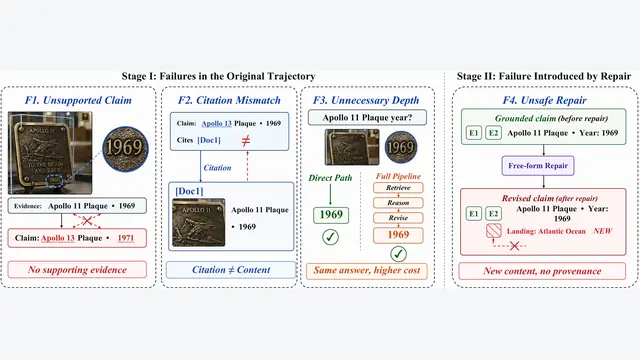
针对这一痛点,最新研究提出了 LedgerMind ,其核心理念是将多模态智能体的交互轨迹形式化为一个“带溯源约束的状态机”(Provenance-Constrained State Machine)。LedgerMi...
CAPA:为了把这种默契程度量化,研究团队设定了任务结构:给定同一个用户过往已经解决的 个完整代码会话历史 ,当该用户在全新的保留会话(Held-out Session)中提出一个暗含模糊意图的初始需求 时,AI 需要...
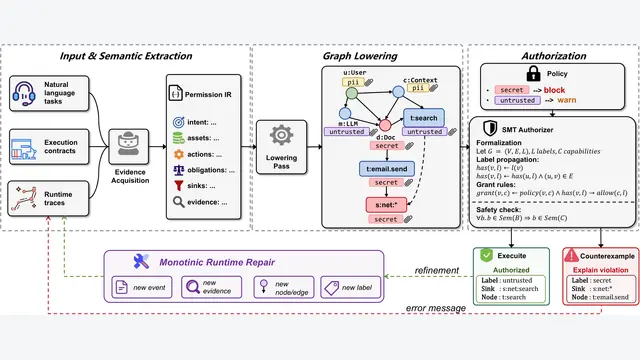
面对这一困局,研究人员提出了 FAVA (Formal Authorization for Verified Agents)框架。这项工作的核心思想非常明确: 彻底剥离大模型的“语义理解”与“安全决策”,只让大模型解析...
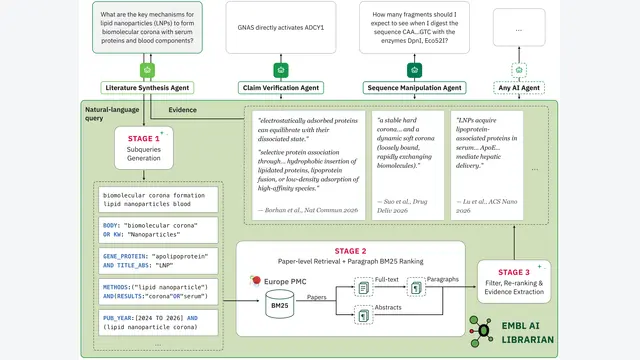
面对两端的不平衡,EMBL AI Librarian 提出了一个根本性的架构转向: 不再耗资自建专有向量库,而是把文献数据库本身视作受控的实时外部工具,由一个通用的大语言模型来充当“AI 图书管理员”,在自然语言问题与...
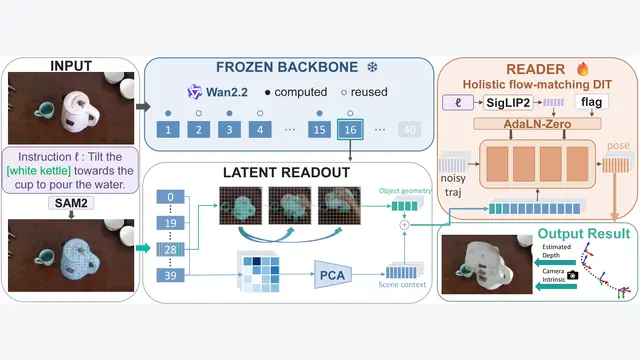
面对上述两难,DreamTraj 提出了一种截然不同的范式:它不仅将推理接口极限压缩到仅需“单张 RGB 图像 + 一句自然语言任务指令”,而且彻底颠覆了依赖像素渲染的传统思路。研究人员发现,在大规模视频扩散模型的去噪...
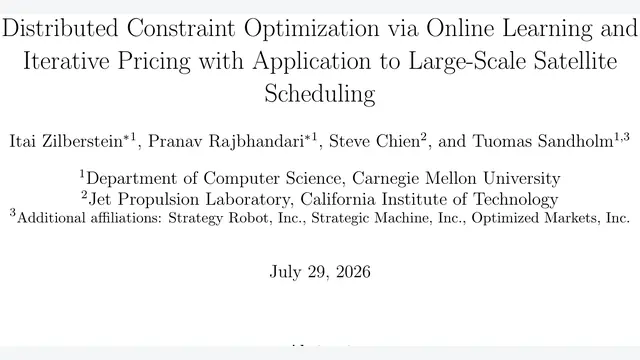
他们重新审视了 DCOP 与博弈论中势能博弈(Potential Games)的等价性,将现代在线学习中的无悔算法(No-regret Learning)引入分布式局部搜索;同时,提出了名为“迭代定价”(Iterati...
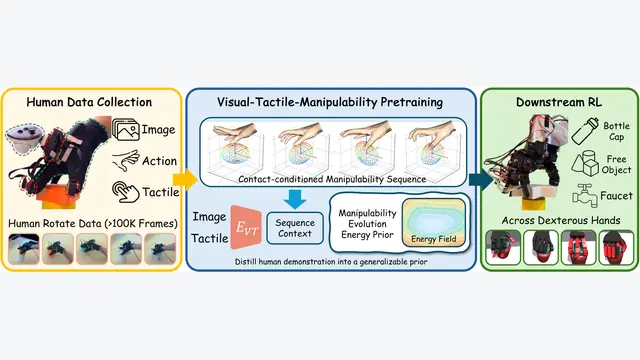
针对这一根本矛盾,这项研究提出了 DexMani 。它的核心洞察在于:向机械手传授人类多指操作经验时, 机器人真正需要学习的不是人类手指在关节空间的几何轨迹,而是物体旋转过程中“可操作度如何随接触状态演化”的通用规律 。
基于预训练掩码语言模型 mmBERT-base(307M 参数),团队分别构建了单向量模型 mDenseOn 与多向量模型 mLateOn。两者训练时的骨干网络完全相同,训练批次完全相同,数据配比完全相同,且均引入了针...
这篇综述所提出的 五层数据金字塔 ,不仅是对现有数据集碎片化现状的分类总结,更为下一代具身大模型指明了研发全景:未来的系统不可能依赖单一数据源取得成功,而是必然走向以通用图文铸造通用认知、以合成仿真扩张探索广度、以手持...
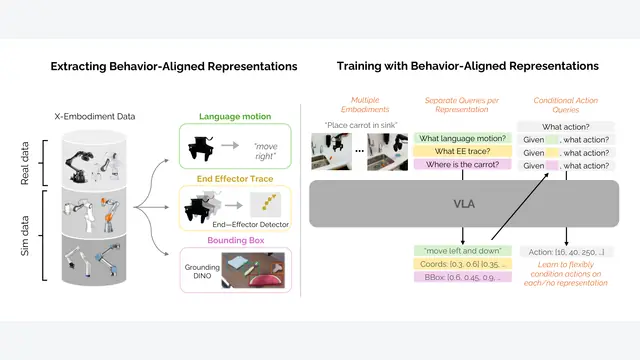
面对这一瓶颈,最新研究提出了利用 行为对齐表征 (Behavior-Aligned Representations)来打破本体壁垒的新思路。这项研究的核心观察在于:尽管机器人的外观和关节参数各异,但在完成同一类操作任务时。
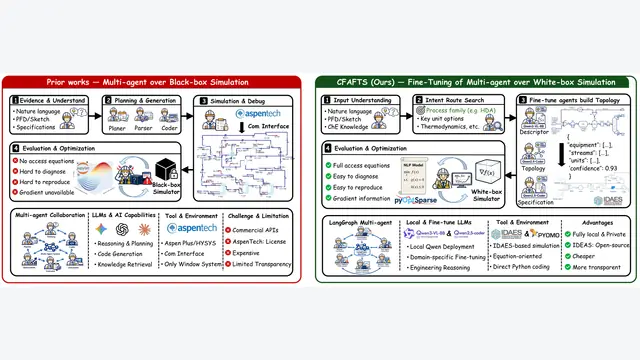
近日提出的 CRAFTS 框架给出了截然不同的解题思路:它彻底摒弃了用单一大模型一步到位编写仿真代码的幻想,而是深度复现了资深化工工程师的分阶段工作流。该框架将建模任务解耦给七个各司其职的角色智能体,并在它们之间设置了...