CMT-RAG:告别粗暴拼历史!子问题级DAG追踪让多轮问答F1提升6.8
为了弥合这一鸿沟,研究团队提出了 CMT-RAG(互补记忆轨迹框架)。其核心创新在于不再将记忆视为扁平的文本串,而是将其解构为 子问题级别的推理轨迹(Sub-question-level Reasoning Trace...
RAG知识系统
AGI FRONTIER
深度解读 AI 论文,追踪 Agent、推理、多模态与具身智能的最新进展。
PAPER INSIGHTS
为了弥合这一鸿沟,研究团队提出了 CMT-RAG(互补记忆轨迹框架)。其核心创新在于不再将记忆视为扁平的文本串,而是将其解构为 子问题级别的推理轨迹(Sub-question-level Reasoning Trace...
针对这两大瓶颈,来自阿里达摩院、清华大学、浙江大学及北京清华长庚医院等机构的研究团队提出了 ClinFusion 。这是一个专门为全景医学理解设计的视觉中心多模态大语言模型系统。
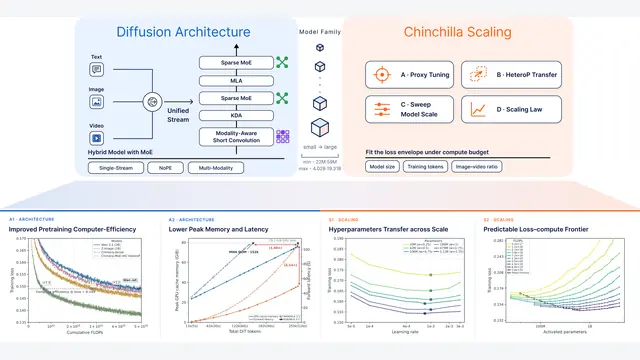
最新研究提出的 Chimera 正面打破了这一瓶颈。它是一套面向海量 Token 生成范式而设计的混合视觉扩散骨干网络,并配备了一套严密的缩放配方。Chimera 将单流统一表示、线性复杂度的 Kimi Delta A...
原论文作者指出,智能体确实敏锐地识别出了核心问题,甚至智能体在项目开端提出的几个候选假说,与人类学者数月前最初构思的研究方向惊人地相似。但在此之后,智能体的学术行为便迅速脱轨。
针对这一空白,来自蚂蚁集团、香港中文大学、香港科技大学、清华大学和浙江大学的研究团队提出了 CameraAnything 。这是首个将相机外参、内参以及画幅比例统一起来的视频编辑框架。
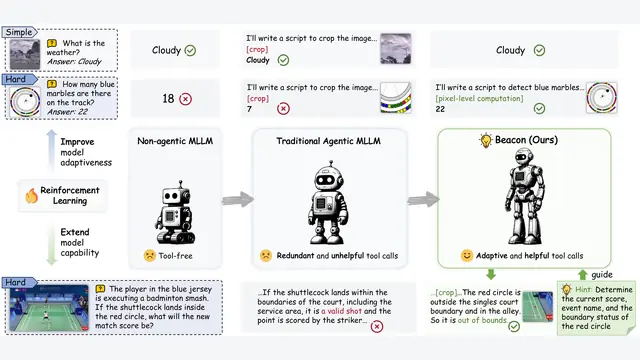
针对这一核心痛点,最新研究提出了多模态推理模型 Beacon 。该研究不仅系统性量化了智能体调用工具的“自适应性”与“真实净收益”,更通过一套包含“必要性感知自适应奖励”与“提示引导能力拓展”的强化学习框架,彻底改变了...
针对这一工程痛点,长鑫存储(CXMT)与中国科学技术大学的研究团队提出了 ZhuLong(烛龙)。该系统取名自中国神话中“开目为昼”的神兽,旨在照亮原本晦涩不透明的商业 EDA API 生态。
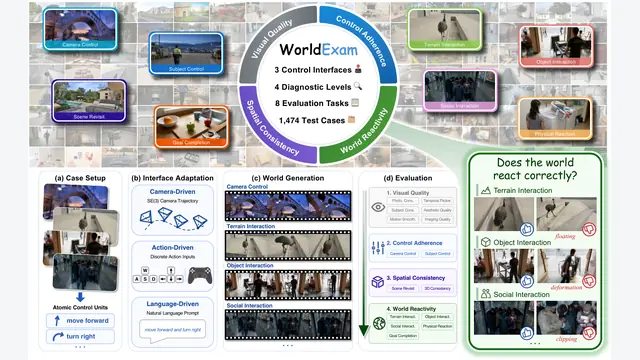
针对这一核心盲区,新基准 WorldExam 提出了从“表象外观(Apparent Appearance)”向“内在反应性(Inherent Reactivity)”跃升的四层诊断体系。
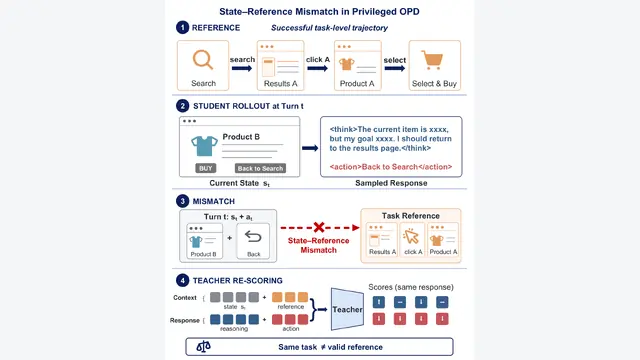
为此,研究团队提出了 SMRC-SD(State-Matched Routing and Contextualized Self-Distillation),通过显式检验执行状态的一致性,决定何时该蒸馏、如何组织上下文。
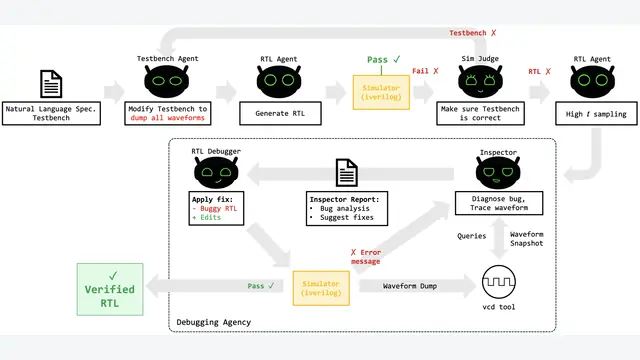
为了打破这一僵局,研究者提出了 VeriTrace 框架,核心是赋予专职排错智能体(Inspector)完全自主的“时序探索能力”(Agentic Temporal Exploration)——它可以像资深验证工程师一...
近期由多位研究者提出的 UrbanAgent ,试图用统一的工具增强 Agent 框架攻克这一瓶颈。它不仅能够调度跨系统的异构城市服务,还引入了“行动前主动澄清、依赖驱动执行、多源证据对齐校验”的完整自适应闭环。
来自腾讯、厦门大学以及中俄数字经济研究中心的研究团队提出了名为 BinaryPC 的全新注意力方案。该方案放弃了“数据无关的随机投影”与“黑盒梯度训练”这两条旧路线,巧妙借助矩阵的二值主成分(Binary Princi...
来自北京航空航天大学的研究团队在最新论文中给出了破局思路,他们提出了名为 ToolLIFT 的通用工具规划框架。该研究的核心洞见在于:对于相似性质的复杂任务,即使底层调用的具体工具千差万别,它们在更高维度的“功能级工作...
为此,来自诺基亚(Nokia)与莱斯大学(Rice University)的研究团队提出了名为 SPECTRA 的全新免微调、即插即用 KV Cache 编解码方案。
Web:残酷的实验结果显示: 没有一种策略能够稳定地优于“无脑固定在最便宜模式”或“固定在综合表现最好的单一模式” 。哪怕在极少数配置下某项策略在数值上微弱跑赢固定基线,经过多重假设检验校正以及噪声带宽比对后,也均落入...
针对这种两难境地,来自北京航空航天大学、华为与香港科技大学的研究团队提出了 Robust-WAM 。这是一种面向基于视频生成的通用后训练(Post-training)方法,其核心思想并非推倒重建潜空间,而是在保留原有 ...
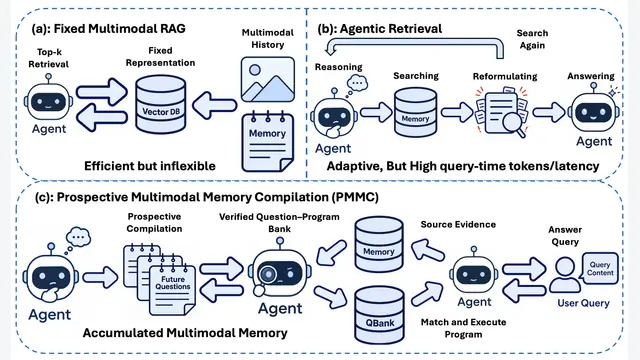
为了打破这一僵局,本文提出了一种全新的解决思路: 前瞻性多模态记忆预编译 (Prospective Multimodal Memory Compilation,简称 PMMC )。其核心理念是将原本在提问时才匆忙进行的...
香港科技大学(HKUST)的研究团队在最新论文中提出了 MCTS-Report 。该方法完全颠覆了预设的线性流水线,将表格生成多模态报告的过程重新形式化为结构化搜索空间中的树构建问题。
针对长视频理解中这种“固定设计难以应对多样化信息分布”的核心痛点,来自阿里巴巴、北京航空航天大学、字节跳动和浙江大学的研究团队提出了一套名为 MetaVideoAgent 的自动化演化框架。
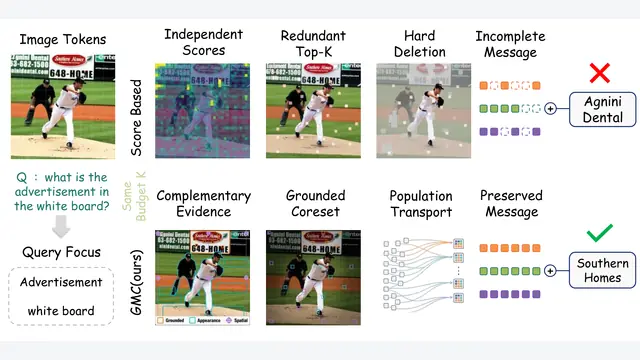
针对这一洞察,作者提出了无需训练的“锚定消息核心集剪枝”方法(Grounded Message Coreset Pruning,简称 GMC )。该方法不再纠结于单个 Token 的孤立打分,而是将视觉压缩重构为解码器...
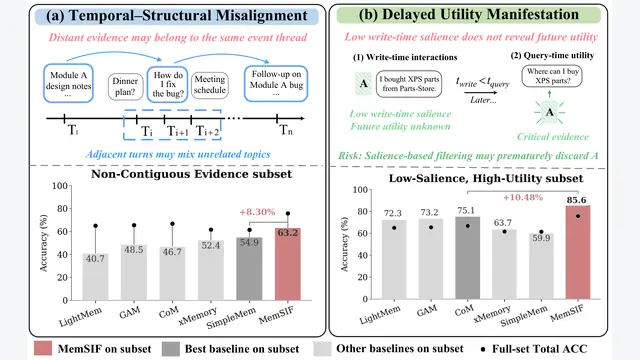
针对这两大结构性痼疾,本文提出了 MemSIF (Memory with Structured Interactions and Facts)框架。该方法抛弃了传统的单轨交互处理方式,将原始对话重塑为保留局部话题连续性...
LLMRouter:为了填补真实落地场景与评测之间的鸿沟,团队构建了包含 4,767 个测试样本的多场景基准 xRouteBench ,并设计了完全自动化的跨模型执行与打分流水线。
来自云知声、自然资源部、深信服、深圳理工大学和天津大学等机构的研究团队提出了 LiLa-WAM (Lightweight Latent Reasoning World-Action Model)。它打破了传统世界模型必...
JoyAI-Video-Edit 提出的 长时程自回归蒸馏(Long-Horizon Autoregressive Distillation, LHAD) ,巧妙地解决了长程稳定性与显存占用的矛盾。LHAD 采用了分段...