SciCodePile:128GB多学科科学代码库与可执行基准,最强模型Pass@1仅12.30%
来自南京大学、新加坡管理大学、中山大学等机构的研究团队推出了 SciCodePile ,构建了迄今为止规模最大的 128GB 多学科科学代码语料库,并配套推出了包含 200 个任务的可执行沙箱评测基准。
AI评测行业应用
AGI FRONTIER
深度解读 AI 论文,追踪 Agent、推理、多模态与具身智能的最新进展。
PAPER INSIGHTS
来自南京大学、新加坡管理大学、中山大学等机构的研究团队推出了 SciCodePile ,构建了迄今为止规模最大的 128GB 多学科科学代码语料库,并配套推出了包含 200 个任务的可执行沙箱评测基准。
腾讯团队针对这一痛点提出了 PIVOT(Proxy Indexing Via One full-prefix Traversal),直接跳出以往在 Token 轴、Head 轴或 Layer 轴做局部裁剪的传统思维,首...
针对这一瓶颈,来自华为、华中科技大学、中山大学与浙江大学的研究团队提出了多智能体修复框架 PhoenixRepair 。该框架重新审视了软件智能体的策略探索机制,通过“多位置采样”与“迭代反思与提炼”两大核心设计,打破...
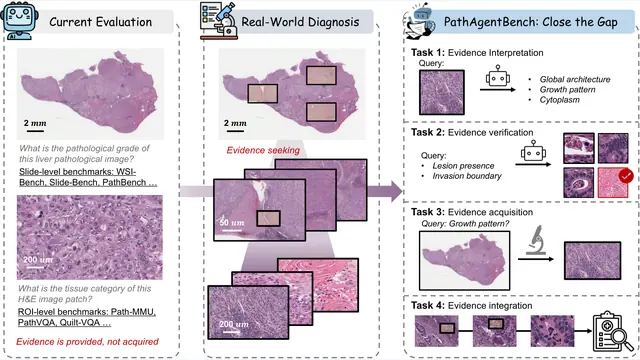
为了打破这一脱离临床现实的评测范式,来自哈尔滨工业大学、新加坡国立大学、北京协和医院以及 PuzzleLogic 的研究团队构建了专门评测多模态模型“主动寻证能力”的基准体系: PathAgentBench 。通过建立...
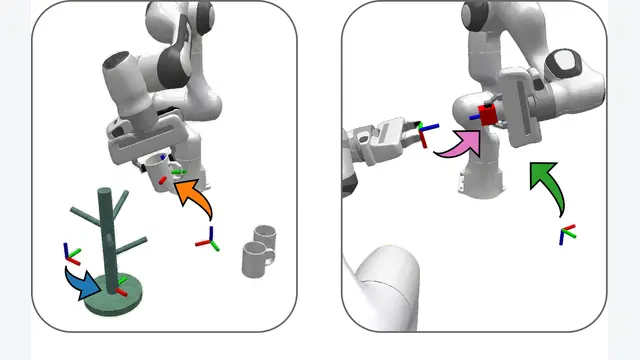
针对这一瓶颈,弗赖堡大学团队提出了一套轻量级且与底层策略无关的全新框架 DynaMAC (Dynamic Multi-Agent Cooperation)。该方法巧妙地将对侧手臂的末端执行器建模为一个动态任务参数(Dy...
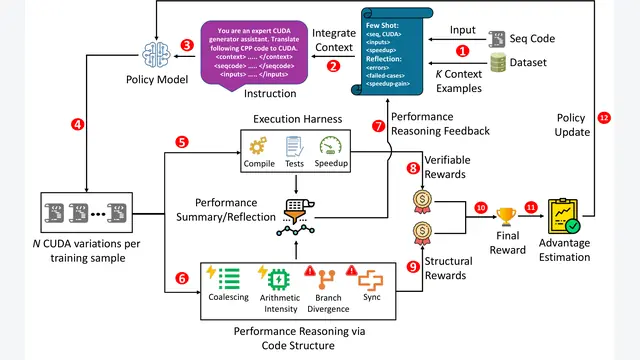
针对这一瓶颈,研究人员提出了 CUDAPerf 框架。该方案打破了仅凭执行耗时做强化学习的传统思路,将访存合并(Memory Coalescing)、算力利用率(Occupancy)、算术强度(Arithmetic I...
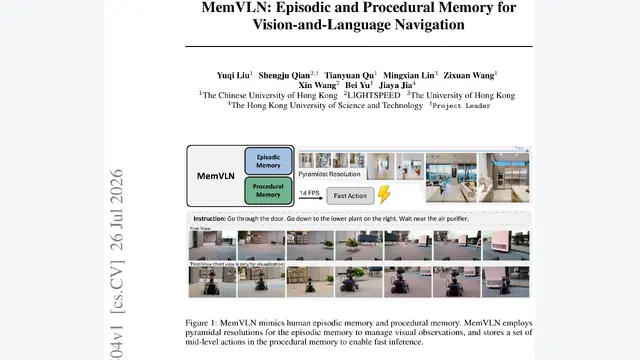
针对这一矛盾,来自香港中文大学、香港科技大学、香港大学以及 Lightspeed 团队的研究人员提出了全新导航框架 MemVLN 。该工作从人类认知系统的双重记忆结构中汲取灵感:一方面引入 金字塔分辨率的情景记忆(Ep...
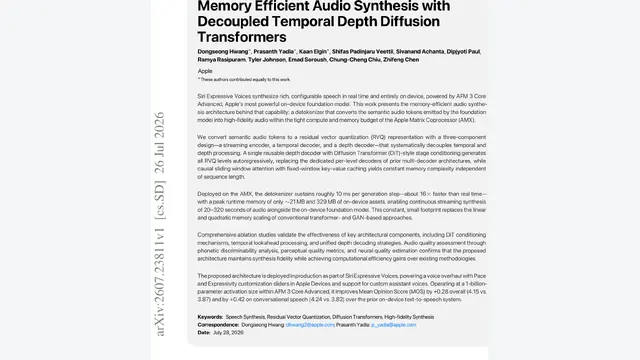
Apple:针对上述痛点,研究团队提出了一种彻底解耦时序维度与深度维度的三组件流水线架构: 流式编码器(Streaming Encoder)、时间解码器(Temporal Decoder)与深度解码器(Depth De...
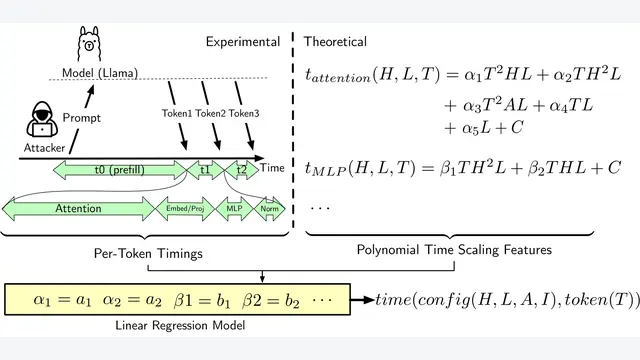
针对这一底层特性,安全研究团队提出了名为 LeakyLMs 的新型侧信道攻击体系。研究表明,攻击者完全无需访问模型权重、激活值或 Logits,仅凭在常规 API 客户端观测连续 Token 之间的到达时间差,就能逆向...
针对这一缺失,开源项目 JarvisHub 给出了一种全新的解题视角:它彻底放弃以线性对话记录为核心的交互范式,提出了一套 以画布为原生载体(Canvas-Native)的开源多模态创作智能体运行底座 。
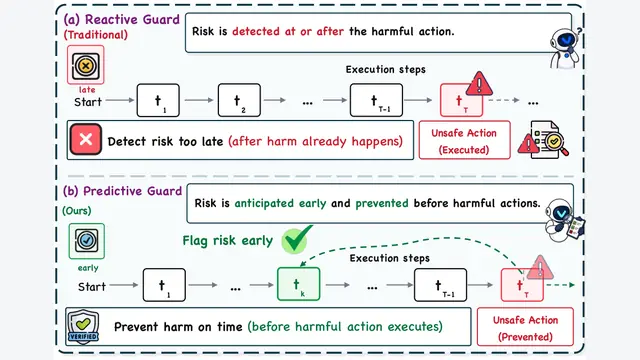
为了打破这种“事后诸葛亮”的困局,新研究提出了名为 JANUS 的前瞻性安全框架,并训练出了专用的预测型护栏模型 Vanguard 。JANUS 的核心思路非常明确:不是等动作发生了再判定违规,而是让护栏模型仅凭已经发...
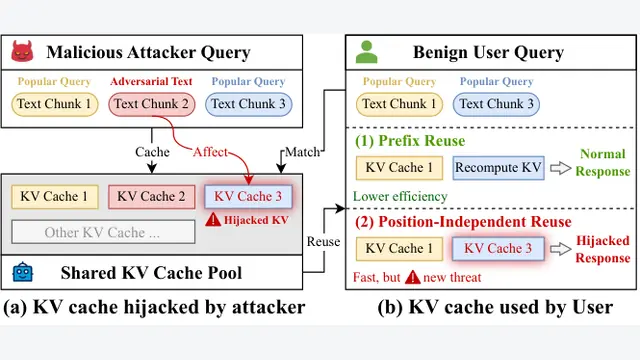
HijackKV:由于传统的严格前缀匹配命中率过低,以 CacheBlend、LMCache 为代表的一批前沿系统优化提出了“位置无关的 KV Cache 复用”(Position-Independent KV Reu...
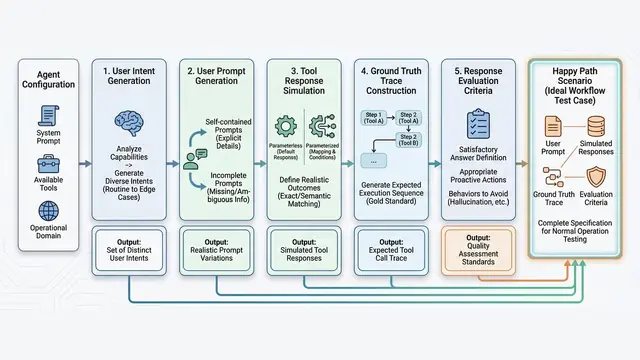
GABench:研究人员在 LangChain、LlamaIndex 以及 Vectara 三大主流生产框架下,构建了包含 580 个场景、跨越 6 大业务领域以及 5 种对抗扰动模式的严苛评测体系。
针对这一痛点,来自北京大学、清华大学、中国科学技术大学等机构的研究团队提出了 MAPD(Multi-Agent Protocol Distillation,多智能体协议蒸馏框架)。
Language:在 Soar 中,问题表征在工作记忆内,各种算子(Operators)被提出作为状态转移候选。当系统面临平局(Tie)、冲突(Conflict)、全盘拒绝或无可用候选时,不会直接抛出异常,而是将其表征...
针对这一顽疾,研究团队提出了 FCPAgent (Falsifiable Commitment Planning Agent)。其核心思想借鉴了认知心理学中的目标导向行为理论——真正鲁棒的行为是具备前瞻预期的,规划不应...
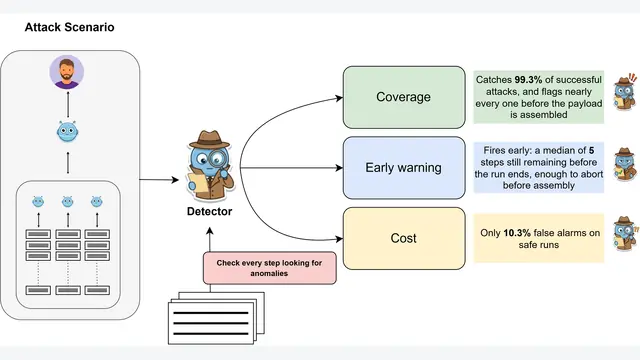
实验结果揭示了现有防御令人担忧的脆性: 一旦消除了信息熵破绽,并封禁了长度特征,分类器的预警时机直接从第 7 步恶化推迟到了第 12 步,中位预警提前量被压缩殆尽;更致命的是,跨任务域的迁移能力发生断崖式暴跌,从数据库...
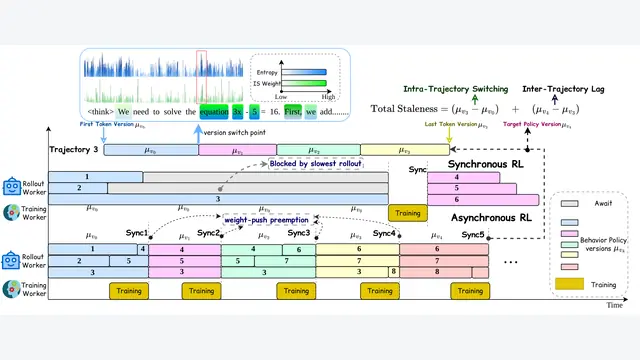
为此,研究者提出了 熵缩放信任域(Entropy-Scaled Trust Region,简称 ESTR) ,根据每个 Token 位置的局部熵自适应地伸缩信任边界。
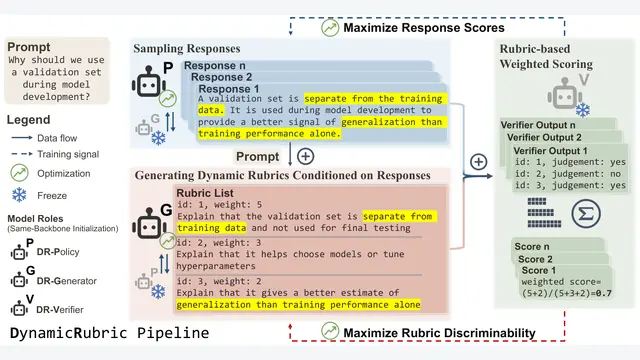
针对这一瓶颈,清华大学联合腾讯团队提出了一种全新的评估器与策略协同进化框架—— DynamicRubric 。该研究从概率分配的理论视角,严格证明了候选回复之间的“相对分差”正是驱动策略概率质量转移的本质信号;并据此设...
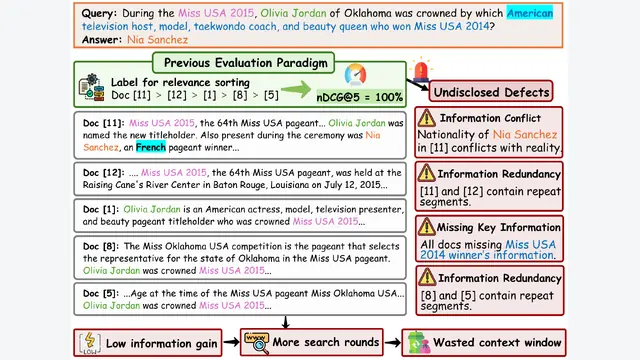
在此诊断基础上,团队进一步提出了免训练的集合选择方法 Rubric4Setwise ,首次将评估准则直接转化为选择信号,在短文本和长文本两套场景中,仅用更少文档和更少搜索轮次便斩获了下游生成性能的 SOTA。要理解这项...
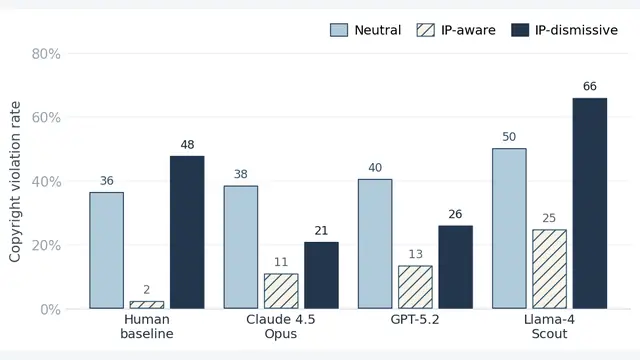
为填补这一盲区,研究者提出了 Copyright-Bench ,这是业内首个专门用于量化评估大模型智能体在商业场景下版权法合规性的基准测试。测试结果展现出一个令人担忧的现实:在任务成功率普遍超过 98% 的背后,主流大...
NUS:评测不仅考察传统的 Recall@k 和 MRR(平均倒数排名),还提出了极具工程参考价值的 BCY@B(Budgeted Context Yield,固定 Token 预算下的上下文产出率) 。
在团队最新构建的化学多样性多肽基准 Riptides 上, Vilya-2 实现了 59.1% 的骨架 RMSD 要理解 Vilya-2 的颠覆性,必须先看清现有共折叠模型在多肽设计中的根本困境。现有的生物大分子预测模...
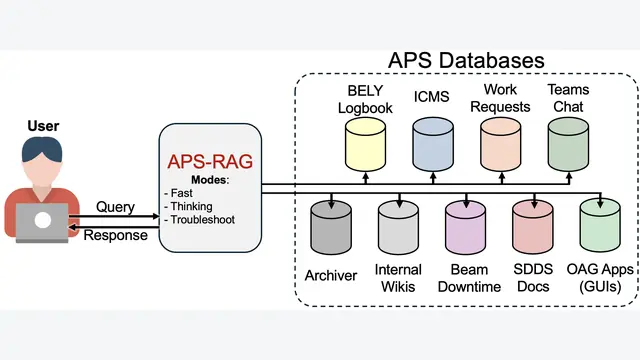
APS-RAG:这项工作为高可靠工程环境下的 RAG 架构设计提供了非常现实的技术参照。大科学装置的运转知识形态与传统企业知识库存在本质差异。在 APS 的日常运行中,数据异构性极高。