SIEVE:不再整页抓取!结构化布尔检索让深度研究Agent减少最高50% Token
Search, Inspect, Fetch: Exploiting Boolean Retrieval for Deep-Research Agents
当前大语言模型驱动的深度研究智能体(Deep-Research Agent)在处理复杂问题时,通常依赖一种经典的迭代循环:根据当前线索生成关键词,调用搜索引擎获取前若干项网页,再将网页的全文抓取并塞入上下文窗口。这种被称为“搜索-访问”(Search–Visit)的标准工作流虽然有效,却存在一个巨大的结构性浪费:现实世界中的网页拥有极其清晰的层次体系——标题、小节、摘要以及各类元数据,但现有的智能体系统往往在抓取阶段直接把整页 HTML 抹平为纯文本或 Markdown,强行灌入模型的长上下文之中。
ArXiv URL:https://arxiv.org/abs/2608.02751
这种“整页吞吐”不仅导致 Token 消耗成倍飙升,更严重的隐患在于信息稀释。一篇数万字的综合报告或维基百科条目中,真正回答用户疑问的可能仅有两三个自然段,其余大量无关内容直接挤占了注意力预算,甚至诱导模型产生幻觉。
为了打破这种粗暴的信息摄入模式,研究团队提出了名为 SIEVE 的全新交互范式。该框架放弃了传统的 Search–Visit 模式,转向“搜索-检视-获取”(Search–Inspect–Fetch)三段式架构,并深度整合了基于字段的布尔查询语言(Boolean Query Language, BQL)。在 HotpotQA、MuSiQue 以及大规模多跳问答基准 BrowseComp-Plus 上的实验显示,SIEVE 在全面超越现有最强基准准确率的同时,将上下文 Token 开销大幅缩减了 $20.7\%$ 至 $50.6\%$。这项工作表明,在长上下文窗口看似充裕的今天,利用经典信息检索技术对网页结构做细粒度控制,依然是提升 Agent 推理质量与运行能效的最优解之一。
为什么整页“Search–Visit”不再适用?
在探讨新方案之前,需要先厘清现有 Deep-Research Agent 的瓶颈根源。
典型的 ReAct 风格研究循环通常把检索与阅读高度耦合。Agent 在搜索工具中输入一个简短查询,检索器(无论是 BM25 还是 Dense 向量模型)基于整篇网页或粗粒度切片计算相关度,输出一个前 $k$ 项列表。紧接着,Agent 选定目标 URL 调用 Visit 工具,将整个网页正文全盘拉取。
这一过程隐藏着两层根本性的错配:
第一层是检索阶段的约束能力缺失。复杂的研究任务往往伴随着明确的布尔逻辑与属性边界。例如,寻找“2020年之后发布、包含学校停课建议、但绝不能属于工伤安全指南的政府热浪应对方案”。在标准向量检索或 BM25 排序下,模型很难保证召回结果严格满足所有硬性条件。排序模型倾向于返回“整体词频高”或“语义余弦相似度接近”的页面,但无法做到绝对排除特定负向概念或精准过滤时间区间。
第二层是阅读阶段的粒度粗放。HTML 文档本身是天然树状结构化的,包含多级标题($H_1, H_2, H_3$)、段落、发布日期和侧边栏元数据。然而现有的 Agent 工具设计直接放弃了这种可寻址性(Addressability),把整个网页拼接成冗长文本。Agent 哪怕只需要看一眼“政策执行细则”这一节,也不得不把前置的背景介绍、组织架构、后置的参考附录全部读进上下文。
很多团队尝试通过引入长上下文大模型或暴力扩容上下文来掩盖这一矛盾,但无论是推理延迟、API 成本还是注意力分散引发的性能衰减,都证明了这种“力大砖飞”路线的局限性。结构信息不应该在进入模型前被丢弃,而应该贯穿于检索、研判到读取的全流程。
SIEVE架构:把网页结构保留到最后一公里
SIEVE 提出的核心设计哲学是:将网页的可寻址结构完整保留在智能体的交互链路中。
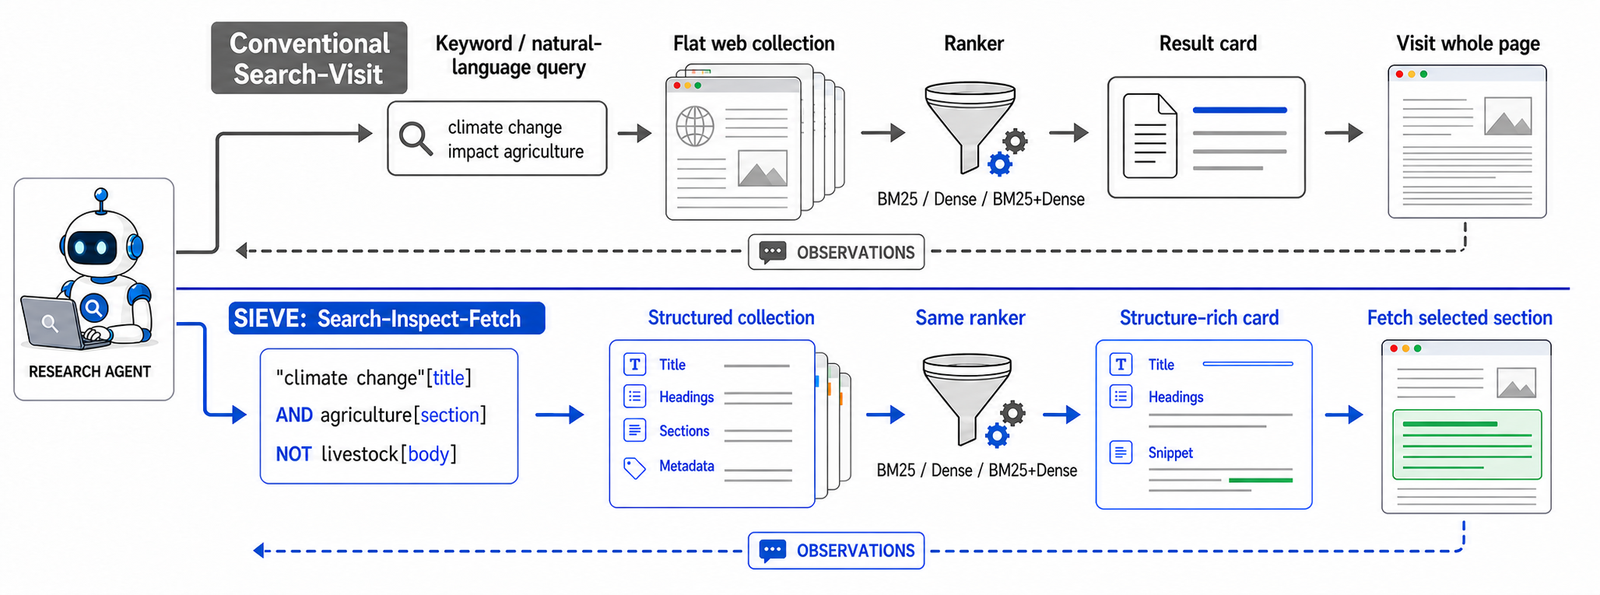
如上图所示,SIEVE 将传统 Search–Visit 模糊揉杂的过程,清晰解构为四个相互独立的决策阶段:确定哪些页面符合硬性资格、候选集内如何排序、Agent 在阅读前能看到什么概览,以及最终究竟抓取哪一部分内容。
1. 结构化源数据表达
在 SIEVE 的体系中,每一个网页文档 $d$ 不再是一长串无差别的纯文本,而是被形式化为一个包含元数据与有序章节序列的元组:
\[d=\left(m_{d},\left\langle(h_{d,j},x_{d,j})\right\rangle_{j=1}^{n_{d}}\right)\]其中 $m_{d}$ 涵盖作者、发布日期等全局元信息,$h_{d,j}$ 与 $x_{d,j}$ 分别代表第 $j$ 个层级标题及其对应的正文块。这种表示方式的关键不在于文本里是否留存了 Markdown 标题符号,而在于底层系统是否向 Agent 暴露了可以直接寻址、过滤和请求这些章节的操作接口。
2. Search:布尔硬性准入与模块化排序解耦
传统检索系统往往强行让一个排序器同时承担“准入筛选”和“优先级排列”两项任务。SIEVE 明确拆分了这两层逻辑:
-
候选集准入(Selection):Agent 使用 BQL(Boolean Query Language)表达严格的逻辑约束,包括字段限定(如限定仅在标题中出现某词)、逻辑组合(AND、OR、NOT)、短语精确匹配以及数值/日期区间。对于目标语料库 $\mathcal{D}$ 与查询 $q$,首先通过布尔逻辑截取绝对合规的子集 $\mathcal{C}_{q} = {d \in \mathcal{D} : d \models q}$。
-
可插拔排序(Ranking):在通过准入测试的严格子集 $\mathcal{C}_{q}$ 内部,再挂载排序模型 $R$(可以是 BM25、Dense 稠密向量检索器,或是基于 Reciprocal Rank Fusion 的 BM25+Dense 混合检索)来决定展示优先级,提取前 $k$ 个最有价值的候选对象。
为了避免智能体因给出的布尔条件过于严苛而面临“零召回”死局,SIEVE 设计了分级回退机制(Relaxation Fallback)。当某个多约束 BQL 表达式筛出的结果为空时,系统会自动放宽限制,优先返回满足部分约束的文档层级;若依然完全无法匹配,则自动退化为全库范围内的 BM25 正向词相关度检索。这一机制保障了 Agent 既能大胆尝试复杂的硬性假设,又不会因为单次语法或条件过紧而导致探索链路中断。
3. Inspect:富结构化卡片与微摘要检视
筛选出 Top-$k$ 候选页面后,系统并不急于把正文推给 Agent,而是将其渲染为一张极度紧凑的“结果卡片”。卡片包含三项核心信息:
-
文档的标题与元数据属性;
-
该页面实际包含的全部可抓取章节标题列表(Heading list);
-
一段严格限制在 25 个 Token 的查询聚焦微摘要(Query-Focused Snippet)。
这个 25-token 的微摘要设计极为关键。系统剥离了布尔语法,计算候选文本段落与查询正向关键词的词法重叠度,抽取最匹配的核心句段。它向 Agent 提供了即时的局部上下文线索,让模型不必盲猜章节内容,仅凭标题和这句极短的线索就能精准研判:究竟该页面的哪一个章节值得深入调取。
4. Fetch:章节级精准按需抓取
在看清卡片结构后,Agent 进入 Fetch 阶段。此时它不需要也不应该发出“访问整页”的指令,而是直接指定目标文档 ID 及其特定章节名称。系统只返回对应的章节切片 $x_{d,j}$。
整套交互流程形成了一个精细的负反馈调节环路:Agent 先用布尔逻辑锁死候选池,通过卡片检视结构布局,随后精准调阅关键段落;段落释放的新线索再指导下一轮 BQL 构造。多余的无关信息被层层过滤,自始至终无法进入主干对话上下文。
实验评测:更高准确率与断崖式 Token 缩减
为了在公平的基准下验证结构化交互的价值,研究团队做了一项非常严谨的基准重构。现有的问答评测集通常只提供平铺的文本块,无法支持细粒度结构测试。作者为此构建了成对的“平铺版”(Flat)与“结构化版”(Structured)基准集合,涵盖多跳推理基准 HotpotQA、MuSiQue 以及基于大规模网页的开放域问答集 BrowseComp-Plus(BCP-S)。在这两类版本中,测试问题、底层语料库包含的文本内容完全一致,唯一的区别在于结构化版本将标题、元数据和小节开放为可被程序直接寻址的结构字段。
主干模型采用开源领域表现强劲的 Tongyi-DeepResearch-30B-A3B,并在统一的 ReAct 动作预算限制下展开对比。实验核心结论展现出惊人的一致性。
在准确率指标上,基于 BM25+Dense 默认配置的 SIEVE 在所有三套数据集上均压制了对应基准下的最强传统 Search–Visit 系统:
-
在 HotpotQA 上,准确率绝对提升 1.6 个百分点;
-
在 MuSiQue 上,准确率绝对提升 3.1 个百分点;
-
在极具挑战性的 BrowseComp-Plus (BCP-S) 网页基准上,大模型裁判给出的准确率与严格的精确匹配(Exact Match)均展现出明确优势,相比标准 BM25 Search–Visit 分别拉升了 2.5 和 3.4 个百分点。
比准确率提升更引人注目的是 Token 消耗的断崖式下降。统计 Agent 回答单个问题引入的不重复 Token 总量,SIEVE 展现出了压倒性的能效比:
-
在 HotpotQA 上减少了 30.4% 的 Token 消耗;
-
在推理跳数更多、阅读量更大的 MuSiQue 上,Token 消耗急剧缩减了 50.6%;
-
在异构网页构成的 BCP-S 上,Token 占用同样下降了 20.7%。
同时,论文还统计了计入多轮历史累积上下文的“步数求和 Token 量”(Step-summed tokens),该指标在真实 API 调用与私有化部署服务中直接映射为显卡算力和推理账单。数据表明,哪怕计算多轮交互的历史展开,SIEVE 的算力节省幅度依旧稳定成立,彻底排除了“单步省 Token 但靠拉长交互轮数凑数”的统计假象。
深度消融:性能增益的底层逻辑到底是什么?
为了探究 SIEVE 为什么能同时实现“更准”与“更省”,研究者进行了一系列具有说服力的对照实验(Ablation Studies),揭示了三个深层机制。
1. 布尔准入控制(BQL)对所有检索排序器均具备普遍增益
有人可能会怀疑:性能提升会不会只是因为选用了更好的稠密检索器,或者是章节抓取(Fetch)本身的天然红利?
为了剔除干扰,研究团队设立了严格的消融对照组:Search–Fetch。在该设定下,Agent 同样拥有章节级别的 Fetch 抓取能力和结构化卡片,但被剥夺了 BQL 语法,只能使用常规的文本查询与全库排名。
实验结果给出了极具穿透力的结论:在涵盖三套数据集与三种主流排序算法(BM25、Dense、BM25+Dense)的全部 9 组配对测试中,加入 BQL 布尔准入控制的 SIEVE 在每一组中都取得了更高的准确率。
这强有力地证明了“准入筛选”与“相关度排序”分工的必要性。布尔约束负责把守边界,将那些看似关键词高频出现、实则完全偏离特定属性限制(如时间、负向排除词、特定字段限定)的噪声网页硬性拦截在候选池之外;排序模型则在此纯净后的池子内部施展语义相关度排序。两者不是替代关系,而是互补共生。
2. 微摘要(Query-Focused Snippet)是结构化检视的生命线
在 Inspect 阶段,如果不提供那句 25-token 的微摘要,仅仅把网页各级章节的标题展示给 Agent,会发生什么?
消融结果显示,一旦移除微摘要,系统在三大基准上的准确率全面大跌 2.9 至 6.8 个百分点。失去微摘要后,Agent 只能对着冰冷抽象的章节标题进行盲目揣测。为了确认某节是否真的包含答案,Agent 往往被迫发起更多轮次的试探性 Fetch 动作,大模型调用次数显著攀升,但盲目抓取引入的上下文噪声反而彻底破坏了最终的回答质量。
这表明,单独暴露文档树状目录是不够的。必须将“宏观目录导航”与“局部相关线索”以极低成本压缩在单张卡片内,Agent 才能具备真正高效的研判决策能力。
3. 泛化性验证:跨越模型基座与检索内核的鲁棒性
为了验证该交互范式是否依赖特定的模型调优偏好,作者进一步展开了横向扩展验证:
-
稠密检索模型替换:在 BCP-S 数据集上,将 SIEVE 内部的 Dense 模块从默认的 BAAI/bge-base-en-v1.5 替换为参数量覆盖 0.6B 到 8B 的 Qwen3-Embedding 系列以及 bge 的 small/large 版本。实验表明,无论使用何种稠密表征内核,BQL 带来的准入筛选优势和上下文节约特性都保持恒定。
-
Agent 基座模型迁移:除了核心的 Tongyi-DeepResearch-30B,团队还在 Qwen-AgentWorld-35B 与 OpenResearcher-30B 上复现了完整的系统对比。在全部 9 组基座模型与数据集的交叉组合中,SIEVE 始终保持着相较于传统 Search–Visit 模式的能效与准确率优势。这证明 search–inspect–fetch 的工程思想具备高度普适性,它构筑的是一套更符合人类专家信息搜集逻辑的通用交互协议,而非偶发性的超参数过拟合。
工业启示:重塑下一代 Agent 基础设施
长期以来,自然语言处理领域沉浸在“端到端向量化”与“扩大上下文窗口”的技术惯性中。很多工程师倾向于认为,只要给模型外挂一个支持百万 Token 的输入框和一个向量数据库,就能自动解决所有复杂的专业搜索问题。
SIEVE 的实验结果为这种思维定势提供了一剂清凉的解毒剂。它清晰地表明,工业界和学术界过去的两个直觉假设并不完全成立:
其一,“有了向量检索,布尔检索就已经过时”。事实上,布尔检索在专家系统和系统综述中经久不衰是有数学必然性的——它提供了确定性的逻辑排他与字段约束。布尔检索在过去难以普适的真正痛点是“人工编写复杂布尔查询语法门槛过高”,且极易导致零召回。然而在大模型时代,LLM 恰恰是编写、调试和动态修改结构化逻辑查询的最强引擎。让 LLM 充当高级语法操作员,配合确定性的布尔引擎做硬准入,是比单纯依赖向量模糊相似度更为严谨的架构范式。
其二,“长文本时代,数据清洗与分段已不再关键”。现实是残酷的:过载的非相关文本不仅在按 Token 计费的基础设施账单上极度昂贵,还会实质性降低长上下文大模型的推理聚焦能力。网页解析不应该把整页洗成一段巨大的扁平文本。在数据入库和抓取阶段,尽可能保留 HTML 原始的语义块(Block)、层级标题与元数据,并向 Agent 开放按需调取的精细化 API,是用极低计算代价置换极高准确率的典型范例。
从“搜索并暴力抓取网页”,到“搜索硬准入、检视微摘要卡片、按需调阅目标小节”,SIEVE 演示了一条兼具经典信息检索严谨性与现代生成式智能体自主性的融合路径。对于正在构建深度研究应用、企业级知识库分析以及复杂合规审查系统的工程师而言,这种让结构贯穿检索全生命周期的思路,无疑具有极其直接的落地指导意义。