Mendel Gödel Machine:用比较进化自我重构,智能体准确率达93.3%
Mendel Gödel Machine: Recursive Self-Improving Coding Agents via Comparative Evolution
让大语言模型(LLM)驱动的软件工程智能体通过递归修改自身源码实现“自我进化”,是近年来 AI 研究中最具野心的方向之一。然而,现有自进化智能体在代码自修改(self-modification)环节普遍存在一个关键盲区:系统通常只根据单次任务失败的执行轨迹(single-trajectory failure)来提示模型反思并重写脚手架代码。这种机制就如同让程序员只看一个偶发 Bug 的报错日志去重构整套软件架构,极易把偶发的环境干扰误当成系统缺陷,或者为了迎合单个用例而引入灾难性的过拟合。
ArXiv URL:https://arxiv.org/abs/2608.07645v1
针对这一瓶颈,来自慕尼黑大学(LMU Munich)、慕尼黑机器学习中心(MCML)与电子科技大学的研究团队提出了 Mendel Gödel Machine(MGM)。这项工作借鉴孟德尔遗传学通过对照实验分离可遗传性状的思想,彻底打破了以往仅靠单一失败轨迹盲目修补代码的模式,转而系统化利用历史评估档案中沉淀的比较证据(comparative evidence)。
实验结果显示,在不更新底层模型权重、仅演化智能体 Python 脚手架代码的前提下,以 Qwen3.6-35B-A3B 为基座的智能体在 Polyglot 基准上的解决率从基线的 50.8% 提升到了 93.3%,超越了参数量约为其 117 倍的闭源旗舰模型 GPT-5。更为重要的是,演化生成的代码脚手架在迁移到完全未见过的 SWE-bench 变体以及 DeepSeek-V4 系列模型时依然保持了显著优势,验证了比较进化策略提炼出的工作流改进具备极强的跨模型通用性。
从单轨迹盲改到孟德尔式比较进化
在哥德尔机(Gödel Machine)的经典设想中,机器通过自指(self-referential)式的形式化重构不断提升效能。在当前基于大模型的代码智能体语境下,智能体的可执行代码与其辅助脚手架(scaffold)被视为“基因型”(genotype),而智能体在具体软件工程任务上的执行轨迹与测试结果(成功或失败)则构成了“表型”(phenotype)。以往自进化框架(如 HGM 等)维护一个不断膨胀的代码变体档案库,其演化树只负责记录各版本的得分并决定下一轮抽取谁来迭代,但每次迭代真正触发自修改时,却把丰富的历史档案完全抛在脑后,只把当前节点刚遇挫的一个任务轨迹塞给模型。
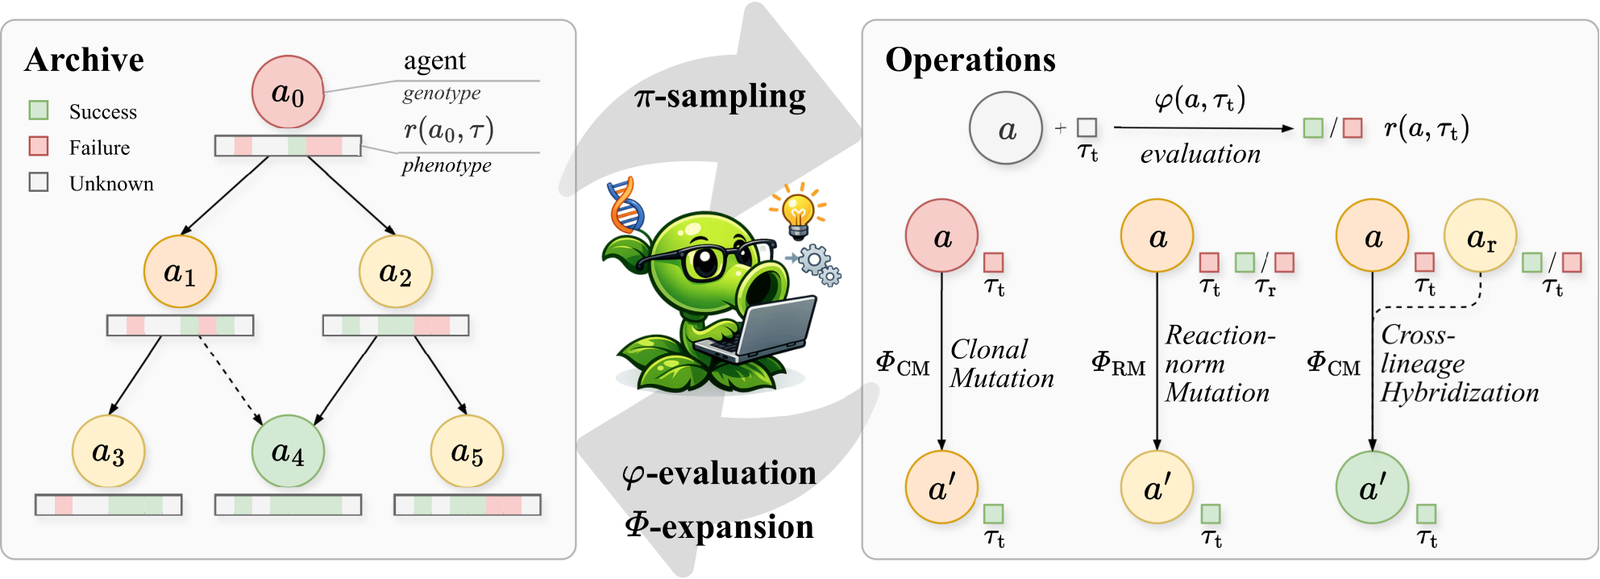
MGM 的核心突破在于:它把历史档案库从一个单纯的“记分榜”,重构为蕴含丰富因果对照线索的“诊断数据库”。如图 1 所示,MGM 将代码自修改操作符根据可用证据的维度拆解为三类,从而在不增加任何额外任务执行开销的前提下,从现有执行轨迹中压榨出更高密度的诊断信号。
第一种是传统的克隆突变(Clonal Mutation,$\varPhi_{\mathrm{CM}}$)。在系统初期档案库较为匮乏、缺乏可比对象时,MGM 依然保留基于单任务单轨迹的反馈修改。这保证了演化在冷启动阶段的探索能力。
第二种是反应规范突变(Reaction-norm Mutation,$\varPhi_{\mathrm{RM}}$)。生物学中的“反应规范”(reaction norm)描述同一个基因型在不同环境条件下的表型分布。将这一概念映射到代码智能体中:同一个智能体版本在面对多个不同软件任务时,若在某些共性环节(如代码定位、补丁后回归测试验证)频繁出现同类故障,这种跨任务的反复失效就绝非偶发事故,而是深植于其脚手架设计中的结构性缺陷。$\varPhi_{\mathrm{RM}}$ 会同时把该智能体在目标任务和参考任务上的多条轨迹输入给编辑器,促使其提炼跨场景的通用缺陷,实施面向工作流全局的代码重构。
第三种是跨血统杂交(Cross-lineage Hybridization,$\varPhi_{\mathrm{CH}}$)。这里的杂交并非死板地将两个智能体 Python 源码拼贴剪切,而是一种高阶的行为性状迁移。当来自不同演化分支的两个智能体曾经尝试过同一个任务,且二者表现存在差异(例如参考智能体成功、目标智能体失败)时,$\varPhi_{\mathrm{CH}}$ 会让目标智能体对比两者的执行轨迹。参考轨迹扮演了严格的对照组角色,能够帮目标智能体迅速滤除任务本身的复杂噪声,精确定位出“到底哪一步决策差异导致了成败之分”,进而把胜者的行为模式吸收并转化写进自己的代码逻辑中。
为了持续为上述比较操作符提供素材,MGM 在全局维护了一个历史失败任务池。在调度评估新任务时,系统会以设定的概率权重优先让不同智能体去尝试其他血统曾经失败过的任务。这种调度策略不仅没有增加额外的评估开销,反而在档案树的自然生长过程中源源不断地创造了同任务横向对照与同智能体跨任务纵向对照的机会。
理论与仿真:比较证据如何实现“诊断压缩”
为了从数学本质上解释为什么比较操作符比单轨迹修补更有效,作者建立了一套严格的加性适应度地形(Additive Fitness Landscape)模型,并进行了控制变量的蒙特卡洛仿真实验。
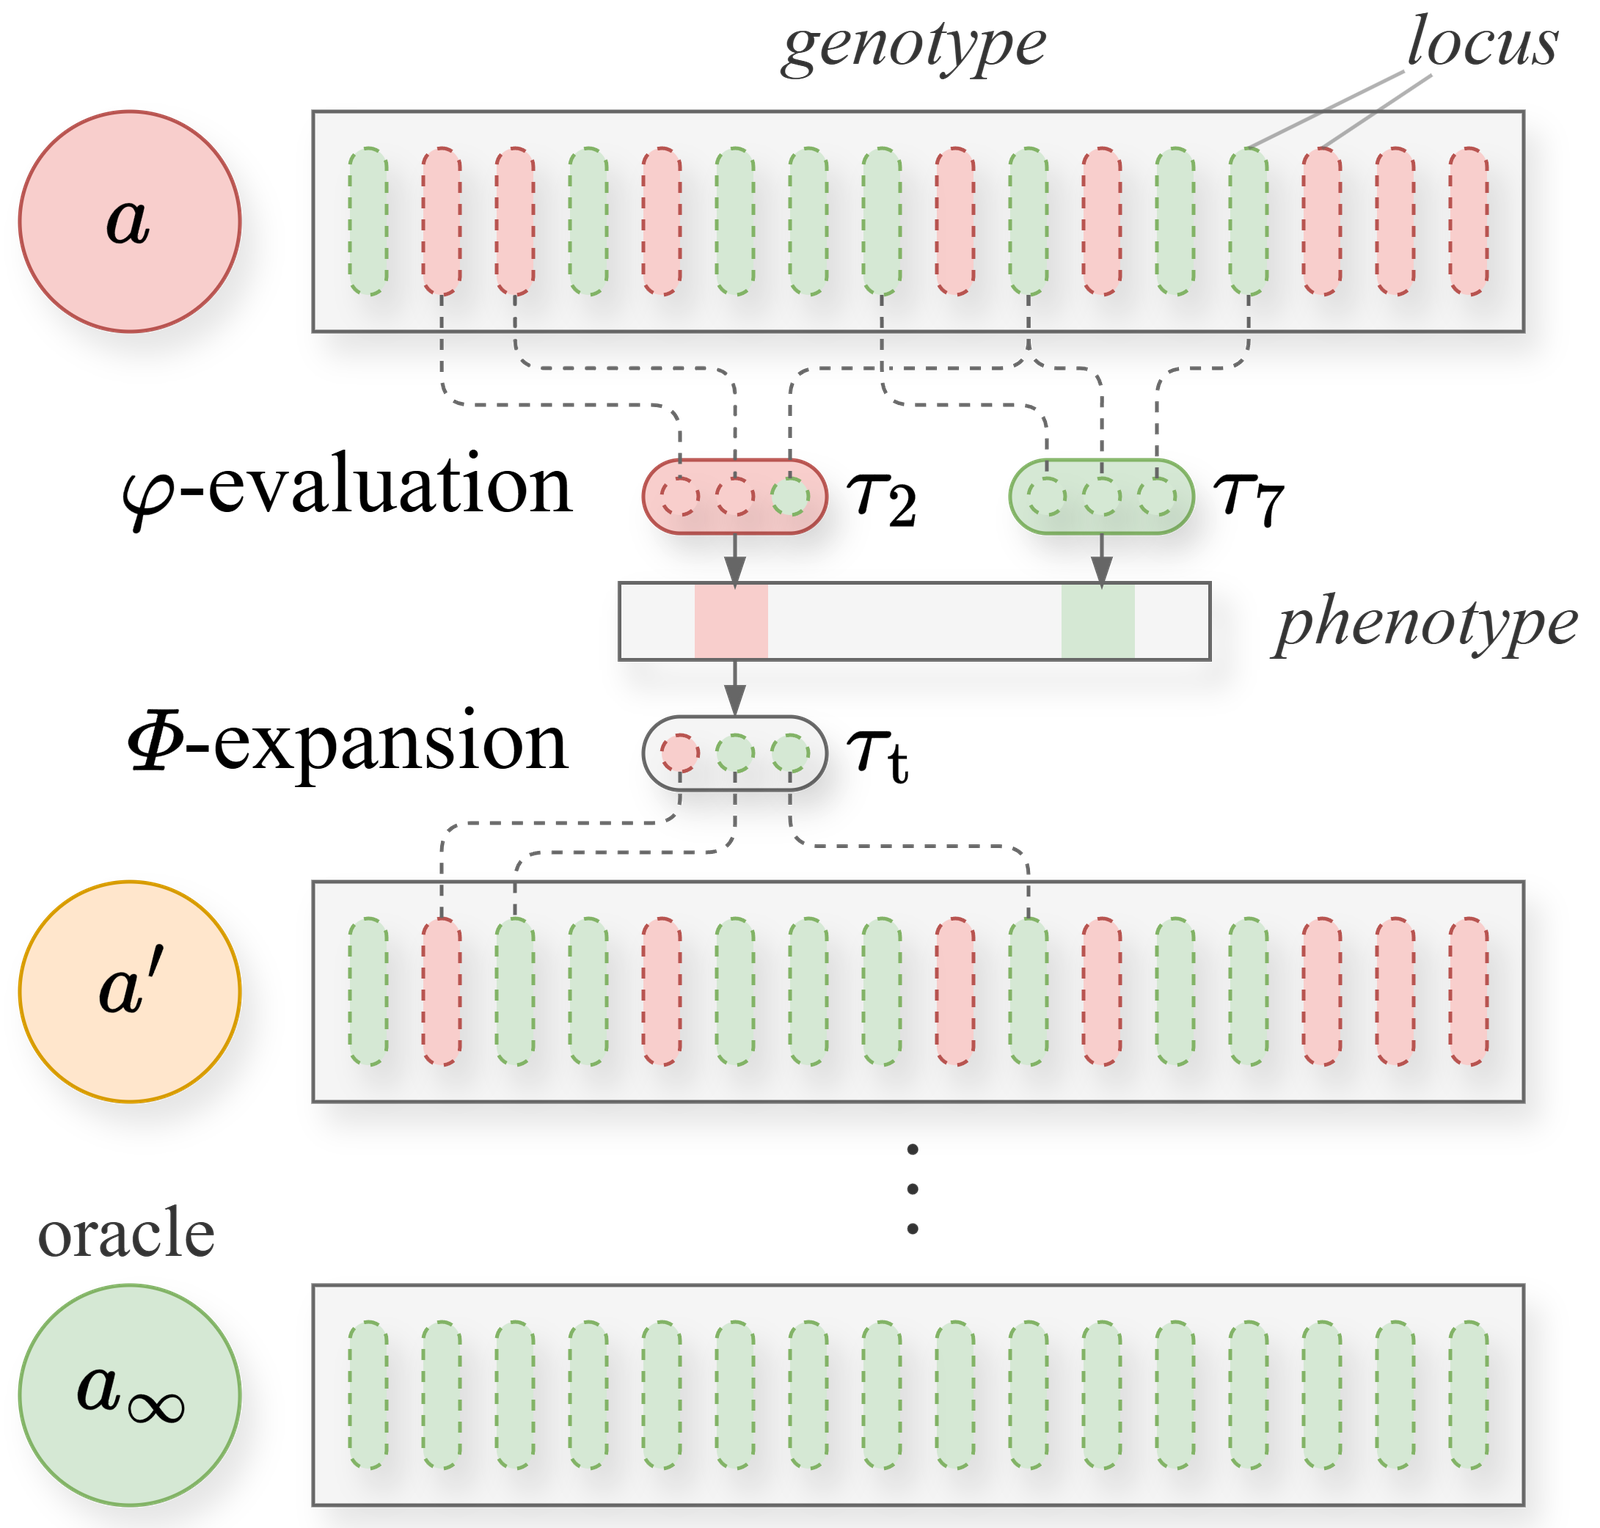
如图 2 所示,每个智能体的脚手架代码被抽象为一个长度为 $L$ 的二进制基因型向量 $\mathbf{g} \in {0,1}^{L}$,其中每个位点(locus)代表一项最小脚手架功能单元(例如文件定位机制、上下文截断策略、语法树解析、补丁验证流程等)。全局存在一个最优神谕基因型 $\mathbf{g}^* = \mathbf{1}$,智能体的改进过程即不断缩小其与神谕的汉明距离 $d(\mathbf{g})$。一个具体的编程任务 $\tau$ 往往需要智能体同时具备 $k$ 项关键能力才能解决,只有当该任务所需的位点子集 $R_{\tau}$ 中不包含任何错误位点时,任务表型才判定为成功($r=1$)。
在自修改过程中,智能体的大模型编辑器并不能直接看见底层哪些位点出错了,它只能根据拿到的诊断证据 $E$ 临时构建一个可疑位点候选集合 $C_{\sigma}(E)$。如果编辑器击中真正缺陷位点的概率为 $s$,那么自修改的有效修复概率(effective fix probability)可表示为:
\[p_{f}^{\sigma} = s \cdot \Pr_{\ell \sim C_{\sigma}(E)} [\ell \in M(a)]\]这意味着,谁能把候选集合 $C_{\sigma}(E)$ 压缩得越紧凑、剔除越多无辜位点,其修复成功的概率就越高。
在这一理论视角下,单轨迹突变 $\varPhi_{\mathrm{CM}}$ 只能观察到目标任务失败,因此它唯一的候选集合就是该任务涉及的所有位点 $C_{\mathrm{CM}} = R_{\tau_{t}}$,其间夹杂着大量实际上已经写对但被误伤的代码模块。相反,反应规范突变 $\varPhi_{\mathrm{RM}}$ 找到了两个失败任务位点集合的交集 $C_{\mathrm{RM}} = R_{\tau_{t}} \cap R_{\tau_{r}}$,由于公共交集期望尺寸更小且富集了真正的系统性缺陷,错误位点的密度大幅提高。跨血统杂交 $\varPhi_{\mathrm{CH}}$ 则利用成功智能体的轨迹剔除了任务固有的非因果位点,同样实现了候选空间的收缩。
由此,论文从理论上证明了在良性比较证据下,存在严格的不等式关系:$p_{f}^{\mathrm{RM}} > p_{f}^{\mathrm{CM}}$ 且 $p_{f}^{\mathrm{CH}} > p_{f}^{\mathrm{CM}}$。
通过参数化两类比较操作符相对于单轨迹基准的优势比值 $\rho = p_{f}^{\mathrm{RM}} / p_{f}^{\mathrm{CM}}$,作者在合成环境中开展了大量蒙特卡洛仿真。仿真结果清晰表明,在完全相同的总修改步数预算下,只要引入比较优势($\rho > 1.0$),系统收敛到低汉明距离的速度和最终分布均显著优于传统方法。这在机理层面证实了:比较证据提升智能体进化能力的核心机制不是依靠把编辑大模型换得更大更强,而是通过“诊断信息压缩”(diagnostic compression),实质性降低了自修改过程中的搜索不确定性。
从 SWE-bench 到 Polyglot 的全面实证
理论优势最终需要在复杂的真实软件工程代码库中接受检验。研究团队在业界公认最具挑战性的两套基准——专注于真实 GitHub Issue 修复的 SWE-bench Verified 和涵盖多种现代编程语言的 Polyglot 上展开了实操对比。所有测试均严格遵循演化安全规范,智能体运行在无外网访问权限的沙箱容器中,且自修改期间绝不能接触被测私有测试用例。
在以开源 Qwen3.6-35B-A3B 为统一基座、严格对齐 200 次评估计算预算的前提下,MGM 展现出了压倒性的性能跃迁。在 Polyglot-60 子集上,同一起点祖先智能体的初版解决率仅为 50.8%,经过标准 HGM 迭代后升至 75.8%,而 MGM 则进一步推进到了 93.3%;在由真实 Python 知名开源库组成的 SWE-bench Verified-60 上,MGM 将解决率从祖先的 38.3% 提升到了 63.3%,同样大幅拉开了与 HGM(45.0%)的差距。
这种性能攀升并非来自于调用模型时挥霍更多 Token。对每一步编辑调用的上下文消耗统计显示,MGM 与基线方法单步平均消耗的 Token 处于相同量级。其效能的倍增完全来源于代码修改方向的精准度,避免了传统演化中大量无效修改导致的试错算力浪费。
更值得关注的是其泛化能力测试。自进化领域最常遭受的质疑在于:智能体在演化集上改出的 Python 逻辑,是否只是针对特定题目特征拟合出来的特化“作弊插件”?为此,研究团队设计了两套极为苛刻的泛化检验协议:
-
跨基准测试(Cross-benchmark Generalization):将仅在 Polyglot-60 数据上进化出来的最优脚手架彻底冻结,不给任何自适应微调机会,直接拉去跑工程复杂度极高的大型企业级基准 SWE-bench Pro 以及覆盖多语言环境的 SWE-bench Multilingual。测试显示,MGM 演化出的脚手架在这些完全未见的分布外软件工程任务上依然取得了显著的净增益。这证明 MGM 沉淀出的是诸如“更合理的异常重试机制”“更严谨的 AST 依赖分析流程”这类具备普适价值的软件工程工作流,而非题库补丁。
-
跨基座模型迁移(Cross-model Generalization):这是检验代码脚手架通用性的终极试金石。研究者将在 SWE-bench Verified-60 上使用 Qwen3.6-35B-A3B 演化出来的脚手架代码冻结,仅将其中的模型推理接口直接热拔插替换为 DeepSeek-V4-Flash 和 DeepSeek-V4-Pro。测试显示,即使底层基座模型的设计哲学、能力分布完全不同,MGM 优化出的脚手架在换上 DeepSeek-V4-Pro 后依然爆发出惊人战力,在 Polyglot 完整集上斩获了高达 96.9% 的惊人表现。这充分证明,脚手架级进化找到的“最优元认知工作流”能够完美泛化给其他高级模型享用。
消融实验进一步厘清了系统内部的驱动机制。当在演化调度中分别剔除反应规范突变 $\varPhi_{\mathrm{RM}}$ 与跨血统杂交 $\varPhi_{\mathrm{CH}}$ 时,系统的进化天花板都出现了明显下滑。其中,去掉跨血统杂交对最终性能的打击尤为致命。这一现象表明,在树状演化搜索中,各分支独立摸索出的优势表型如果不能被其他支系反思借鉴,演化树就会迅速沦为信息孤岛,最终陷入局部最优;而跨血统杂交恰恰扮演了将碎片化局部突破拼装为全局突破的关键桥梁。
迈向低成本、高复用的智能体元进化
Mendel Gödel Machine 的研究价值不仅在于刷榜,更在于为自进化智能体的演进路线提供了一个低成本且可扩展的新范式。以往业界提升智能体表现,要么依赖昂贵的强化学习(RL)去端到端微调上百亿参数的模型权重,要么依赖人类工程师手动编写复杂的 Prompt 管道。MGM 证明,将智能体工程脚手架本身作为可搜索的代码程序空间,利用大模型自身来反思和重写这套程序,是一条完全走得通的道路。
更具实用价值的发现是“在廉价模型上进化,部署到顶尖模型上收割”。由于 MGM 提取的工作流属于模型无关的通用工程解法,开发者未来完全可以在参数量适中、推理成本极低的开源小模型上进行大规模多轮比较进化,淬炼出极致鲁棒的 Agent 调度中枢和反思流,随后将其零样本迁移至最顶尖的大模型或生产集群中运行。
当然,正如作者在局限性与伦理讨论中所指出的,具有自修改能力的系统天然存在安全防线的考验。允许系统持久化重写自身代码,意味着任何恶意逻辑或隐藏 Bug 都有可能随演化树蔓延并固化给所有后代版本。因此,严格的无网络访问沙箱、只读文件系统挂载以及边界完备的自动化集成测试,依然是自进化机器得以安全野蛮生长的不可逾越的底线。从孟德尔定律中汲取的因果对照智慧,不仅使机器看清了自己的系统缺陷,也让真正意义上自主递归重构的 AI 往工程化落地迈出了坚实的一步。