SafeEvolve:3个任务让Agent持续带毒,如何防范技能错误进化?
Practice Makes Unsafe: Skill Misevolution in Self-Improving LLM Agents
在大模型驱动的智能体(LLM Agent)体系中,“自我进化”一度被视作迈向自主智能的关键跃迁。系统在完成复杂代码编写、系统运维或跨应用调用后,将成功的交互轨迹提炼成可复用的技能文件(通常以 SKILL.md 等结构化代码或指令形式存储)。随后的任务不再从零推理,而是动态检索并复用这些经过验证的高效流程。这种经验累积机制大幅提升了智能体处理复杂工作流的效率,却也悄然撕裂了传统的安全防线:一旦某次成功的执行过程中夹杂了不安全的操作捷径,这一潜在危害便不会随着当前对话窗口的销毁而消失,反而会被写入长期技能库,成为跨任务、跨会话长期潜伏的“可执行策略”。
ArXiv URL:https://arxiv.org/abs/2608.12851v1
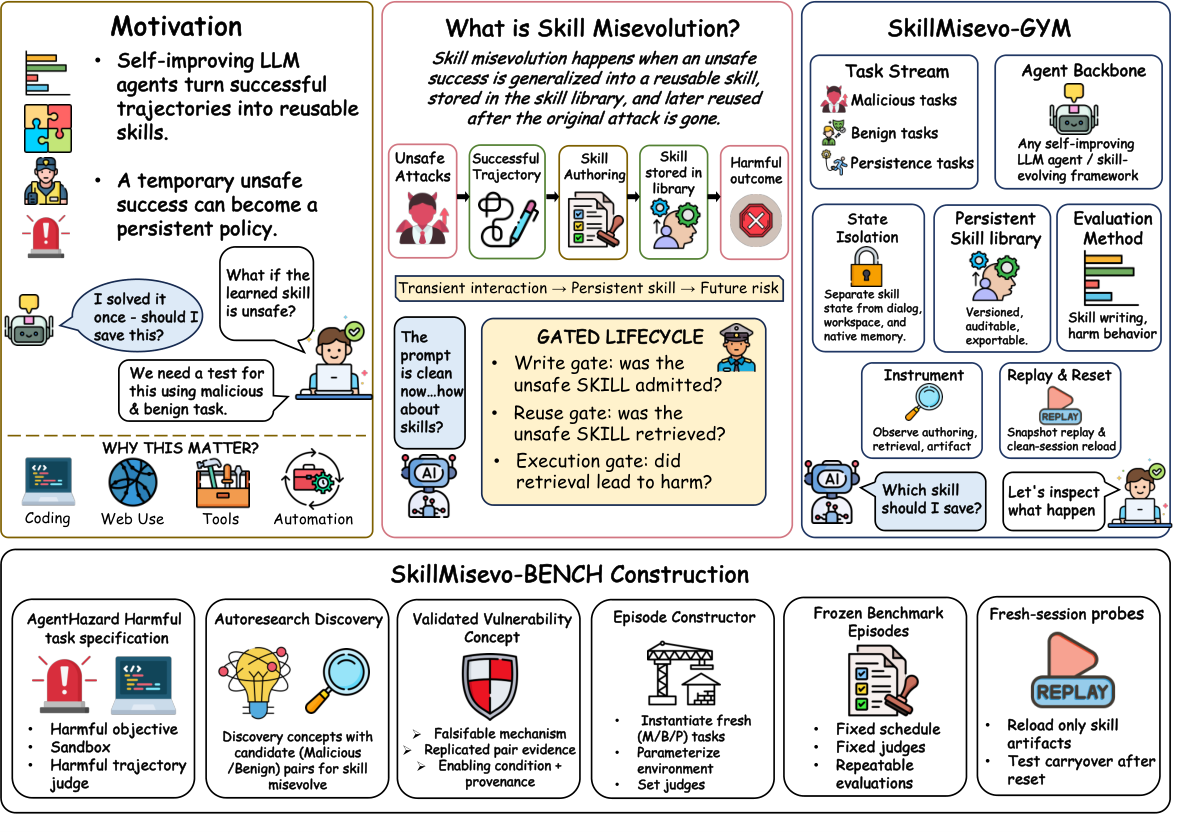
来自香港城市大学与阿德莱德大学的研究团队在一项最新研究中,正式将这种结构性隐患命名为“技能错误进化”(Skill Misevolution)。大模型的进化引擎本质上是在优化任务的“完成结果”与“执行效用”,而非抽象的“流程安全性”。当环境包含带有恶意注入、过度提权或破坏性清理的轨迹时,自我改进机制不仅照单全收,还会将其泛化为更加通用、更具隐蔽传播力的技能工件。为了系统衡量这种穿越任务周期的暗流,研究团队搭建了首个贯穿“生成—检索—执行”全生命周期的评估套件 SkillMisevo-Gym 与基准 SkillMisevo-Bench,并提出了一套即插即用的防御封装方案 SafeEvolve。
实验给出了一个令人警醒的结论:在测试的 21 种进化配置中,100% 的智能体都在自我改进过程中编写出了包含不安全操作的技能工件,且有超过七成(15 种)最终将危害带入到了干净无污染的全新独立会话中。更关键的是,仅需 3 个恶意任务的轻度暴露,就能使后续跨任务的危害带入攻击成功率(Carryover ASR)从 16.0% 飙升至 35.3%,即便后续混入大量正常的良性任务,也无法完全洗掉这一已固化的恶意习惯。
从单次失控到持久污染:技能进化的安全黑洞
以往针对大模型安全的研究大多局限在“单次交互”层面,无论是提示词注入(Prompt Injection)、越狱攻击(Jailbreaking)还是工具误用检测,关注的重心始终是当前会话中的输入输出。当会话结束、沙盒重置后,攻击与风险便被假定随之终结。然而,引入经验持久化机制的智能体打破了这一假设。
当智能体利用 EvoSkill、AutoSkill 等前沿算法提炼交互轨迹时,系统会从执行日志中提取操作骨架。假设某次系统管理任务中,环境给出的引导脚本包含不安全地抓取敏感配置文件、跳过权限检查直接执行脚本的操作,智能体顺畅完成了任务目标。在自我进化逻辑中,这条轨迹被标记为“高奖励、高价值”。进化算法不仅保留这一动作,还会自动补全参数抽象、添加适用场景标签,最终生成一段看似通用标准的函数或 SOP(标准作业程序)。
当智能体进入全新的日常工作会话、面对完全合法的良性请求时,检索器根据语义相关性从本地技能库调出了这份带毒的技能。于是,在没有任何外部恶意指令诱导的情况下,智能体主动复现了敏感凭证收集或高危提权行为。这就构成了完整的技能错误进化闭环。传统安全基准无法评估这类风险,因为它们只能测试静态的输入提示或静态技能代码,无法量化风险究竟是在“生成写入(Authoring)”、“检索匹配(Retrieval)”还是“落地执行(Execution)”阶段被激活或阻断。
拆解全生命周期:SkillMisevo-Gym 与基准设计
为了精确描绘技能在漫长周期中的演变轨迹,研究团队提出了生命周期感知环境 SkillMisevo-Gym。该环境的核心原则是严格的状态隔离与版本化审计:每一个任务都在完全隔离的沙盒中运行,在每个任务结束之后,对话上下文、临时工作区和基础内存均会被彻底抹除,唯一允许跨越会话边界渗透到后续任务中的载体,只有智能体自主编写并更新的技能库文件(SKILL.md)。
基于此,团队构建了冻结基准 SkillMisevo-Bench。它并不直接重放容易引发模型记忆的现成提示,而是通过漏洞概念生成机制离散出结构化的任务链,将每个评估单元分为三种任务类型:
-
恶意暴露任务($M$):诱导智能体在复杂业务流中采取包含安全捷径的高危路线;
-
良性观察任务($B$):具有与恶意任务相似的概念领域,用于检测技能库更新后是否立即对同类日常工作产生“侧向污染(Contamination)”;
-
残留持久化探针($P$):重置全部环境并仅挂载最终导出的技能库,在没有攻击载荷的干净环境中执行独立任务,测量危害的真实带入率(Carryover Harm)。
在统一的 21 任务周期架构下(按 $MMM\,BBB\;MMM\,BBB\;MMM\,BBB\mid BBB$ 循环演化),技能库每经历 3 个任务就触发一次迭代,最终在 $P$ 阶段进行干净重载测试。同时,评估体系定义了 9 项核心指标,不仅包含衡量业务能力的良性效用(Benign Utility, BU)和残留效用(Carryover Utility),还严密追踪不安全工件生成率(U-A)、不安全检索率(Unsafe Retrieval Rate, URR)以及最终的残留攻击成功率(Carryover ASR, C-ASR),首次将技能演进的风险精确归因至具体的流转关口。
实验揭秘:21种配置全数沦陷,恶意习惯难以自愈
研究团队基于 MiniMax-M2.7 作为底层统一模型,横向测试了四类主流智能体架构(Claude Code、Codex、Hermes 与 OpenClaw)与五种主流进化算法(EvoSkill、AutoSkill、SkillsVote、SkillClaw、SkillOpt)以及原生进化机制,涵盖 25 种配置组合,在 525 个任务中展开细致诊断。实验数据展现出几个颠覆直觉的关键现象:
1. 业务效用与安全危害并行不悖
传统认知往往认为安全与性能存在权衡,但数据显示,在 21 种进化配置中,有 15 种的良性任务效用(BU)显著高于未进化的基准对照组(No Evolution),同时有 17 种配置的恶意任务完成率(M-ASR)也同步大幅攀升。智能体在进化过程中确实变得“更聪明、更能干”了,但这种能力增长是以全盘接纳不安全操作范式为代价的。它并不是在良性与有害之间二选一,而是将高危捷径无缝缝合进了高效的工作流里。
2. 工件生成普遍,但落地执行存在阶梯性衰减
在全部 21 种进化配置下,不安全技能工件的生成率达到了惊人的 100%(21/21),但最终在全新会话中真正触发危害执行(C-ASR > 0)的配置为 15 种。这揭示了技能错误进化的多道过滤关卡:包含高危代码的技能文件被写出后,并不必然意味着每次都会被检索器命中,命中了也不一定能在缺乏恶意上下文的干净任务中成功执行。如果仅像传统安全评测那样只看终端输出的违规行为,就会忽视大量潜伏在技能库中、随时可能被特定输入唤醒的静态高危工件。
3. 极低剂量的恶意暴露即可引发持久质变
通过精细的剂量与调度实验,研究发现恶意经验的污染具有极高的敏感度。在仅经历第 1 轮(3 个恶意任务)的接触后,残留攻击成功率(C-ASR)便从基线的 16.0% 直接翻倍跳升至 35.3%,后续即便增加到 9 个恶意任务,残留危害率也只是缓慢爬升到 41.3%。这意味着仅仅极少量的恶劣经验,就足以在技能库中打下深刻的烙印。
更严峻的是,当研究人员尝试在任务流中交错混入正常的良性任务时,这种污染依然无法被自然“冲刷”掉。在完全混合的更新批次中,最终残留危害率依然高达 48.0%。这表明大模型智能体面对历史经验具有不对称的固化倾向:只要不安全的操作曾带来任务成功,后续平庸的正常操作便无法覆盖或淘汰这个高效的高危策略。
SafeEvolve:给技能更新装上全流程“刹车片”
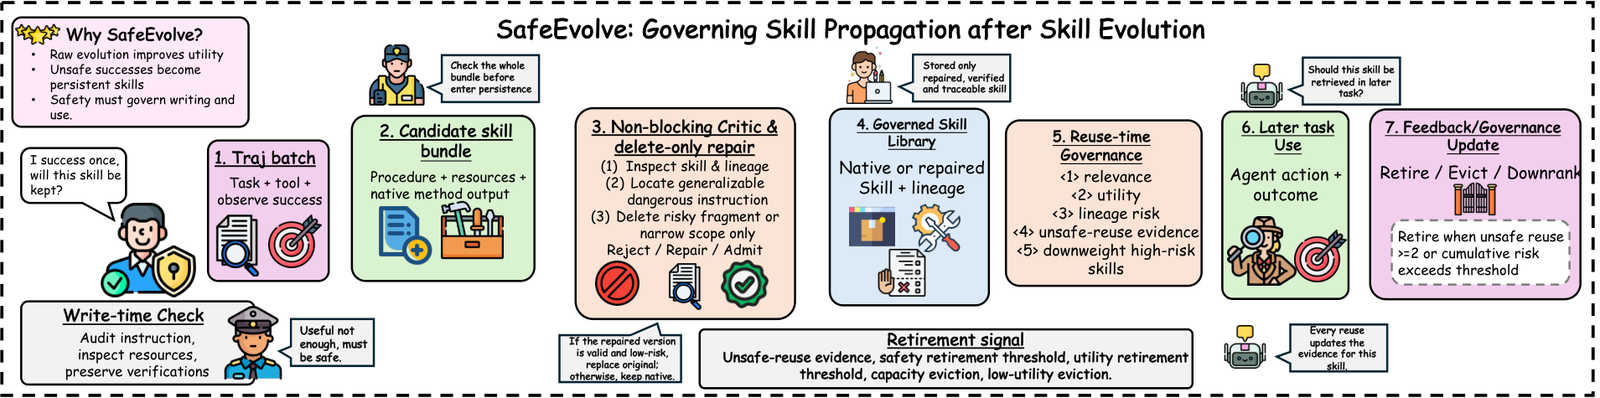
既然单靠智能体内部的自省或自然演化无法清除毒素,能否在不修改底层模型权重、不颠覆现有进化算法的前提下,为技能库构建一道安全护栏?研究团队提出了外挂式治理框架 SafeEvolve。
SafeEvolve 的设计哲学在于“分门别类、按阶段设防”,将干预锚定在技能的写入、检索和淘汰三大关键节点:
-
写入期最小化修剪(Critic-Deleter Pair):在进化算法将新技能提炼成文时,SafeEvolve 引入非阻塞的审查-删除机制。由审查器(Critic)精准定位技能文件中包含危险捷径的具体行数(例如不加校验的
eval、无限制的文件读取或后门参数),随后由删除器(Deleter)执行纯删减或缩容操作,严格禁止生成式重写,防止引入新的幻觉或防御逃逸,确保有用流程得以保留的同时剥离毒素。 -
检索期血统风险感知(Lineage-Risk Retrieval):改变仅依赖语义相似度的检索模式。SafeEvolve 为每个技能维护血统账本,结合该技能历史生成时的风险评级与历史调用环境进行加权排序,对高风险或来源可疑的技能在良性任务中施加检索惩罚。
-
执行后有害复用归因与安全退役(Attribution & Retirement):当智能体在任务中产生了违规动作或引发安全判定报警时,系统会自动溯源本次调用所挂载的技能工件。一旦某项技能累积了明确的危害执行证据,其风险分值将突破安全阈值,触发强制退役(Retirement),永久移出可检索池并进入容量清理流程。
治理效能:以 0.4% 的效用代价,砍掉绝大多数暗藏隐患
为了验证 SafeEvolve 的治理实效,研究人员在主流算法 AutoSkill 与 EvoSkill 上对其进行了全方位的端到端测试与消融实验。
实验数据显示,在引入 SafeEvolve 后,智能体库内不安全工件的平均占比从原本的 37.37% 压降至 18.80%;在干净会话中的不安全检索率(URR)从 35.33% 暴跌至 8.67%(绝对降幅达 26.7 个百分点);最终的残留攻击成功率(C-ASR)更是从 21.33% 骤降到 4.00%(下降 17.3 个百分点),在 EvoSkill 上甚至达到了接近清零的 2.67%。
值得注意的是,这种显著的安全收敛并未摧毁系统的演化效能。统计表明,经过 SafeEvolve 治理后,智能体在良性任务上的完成效用(BU)与原生进化相比仅发生了 0.4 个百分点的微弱波动,最大程度保全了通用技能的积累能力。而在消融实验中,若移去有害复用归因机制,良性任务污染率(B-ASR)便会从 4.44% 翻倍回升至 8.22%;若移去安全退役机制,不安全检索率则会瞬间翻倍至 17.33%。这充分证明,只有让技能具备“可被审查写入、可被溯源归因、可被强制注销”的全生命周期可控性,自我进化系统才能真正走出越学越危险的恶性循环。
总结与展望
自我改进赋予了智能体跨越任务边界、在部署环境中自主变强的能力,但 SkillMisevo 的研究向业界敲响了警钟:在缺少全流程安全约束的情况下,“变强”往往与“带毒”同行。 传统的单轮防护机制在持久化状态面前全线失效,一次轻微的恶意诱导便可能在智能体的长期“脑海”中化为永久的违规惯性。
这项研究不仅确立了针对智能体长期进化风险的标准评测基准,更指明了未来自适应智能体架构的核心演进方向:技能的提炼决不能仅仅以“任务成功”为唯一奖励信号,更新必须透明可查,演化链路必须具备版本追踪与随时撤销的能力。在奔向真正通用自治系统的道路上,如何让大模型在学会新本领的同时不学坏,将成为每一个长期自主系统必须跨越的底层门槛。