ReCache:解耦跨工具注意力,KV显存缩减92.4%且首字提速3.6倍
ReCache: Efficient KV Cache Reuse and Compression for Tool-Augmented LLM Agents
在构建大模型智能体(LLM Agent)的过程中,工具调用(Tool Use)与技能调用(Skill Invocation)几乎是系统的核心生命线。随着系统能力扩展,开发者往往会为 Agent 接入几十甚至上百个 API 接口。受限于上下文窗口与推理成本,业界普遍采用“渐进式披露”策略,即先通过检索模块筛选出与当前用户 Query 相关的工具 Schema,再将其动态拼入 Prompt 中。
ArXiv URL:https://arxiv.org/abs/2608.19662v1
这种做法虽然有效压减了单次请求的上下文长度,却在底层推理引擎中埋下了一个长期被忽视的性能泥潭:动态组合的工具 Schema 正在彻底摧毁大模型的 KV Cache 复用能力。
在常规的对话场景中,系统级 Prompt 往往充当固定前缀,推理引擎(如 vLLM、SGLang)可以通过前缀缓存(Prefix Caching)直接跳过重复的 Prefill 编码计算。然而在 Agent 系统中,不同请求检索出的工具集合千差万别,即使调用相同的两个工具,它们的排列顺序也可能完全不同。在因果自注意力机制(Causal Attention)与绝对/旋转位置编码的共同约束下,哪怕工具内容一字未改,只要其排列位置或前后上下文稍有变动,其对应的 Key-Value 向量便无法直接复用,系统被迫一次又一次地对相同的工具 Schema 执行昂贵的 Prefill 编码。
针对这一瓶颈,来自东方理工大学、上海交通大学与西安交通大学的研究团队提出了 ReCache。该框架通过三大递进机制打破了工具调用的缓存困局:用“资源级注意力”切断不同工具之间的横向交互,赋予每个工具完全独立的局部坐标,使其 KV 块具备天然的组合不变性;随后结合“贡献度引导的结构剪枝”与“字段感知的语义剪枝”,将工具 KV Cache 的显存占用直接缩减 92.43%,并在注意力计算上取得 1.423 倍加速。更重要的是,在首字延迟(TTFT)缩减 3.655 倍的同时,其端到端工具调用成功率与全注意力基线仅相差 0.1 个百分点。
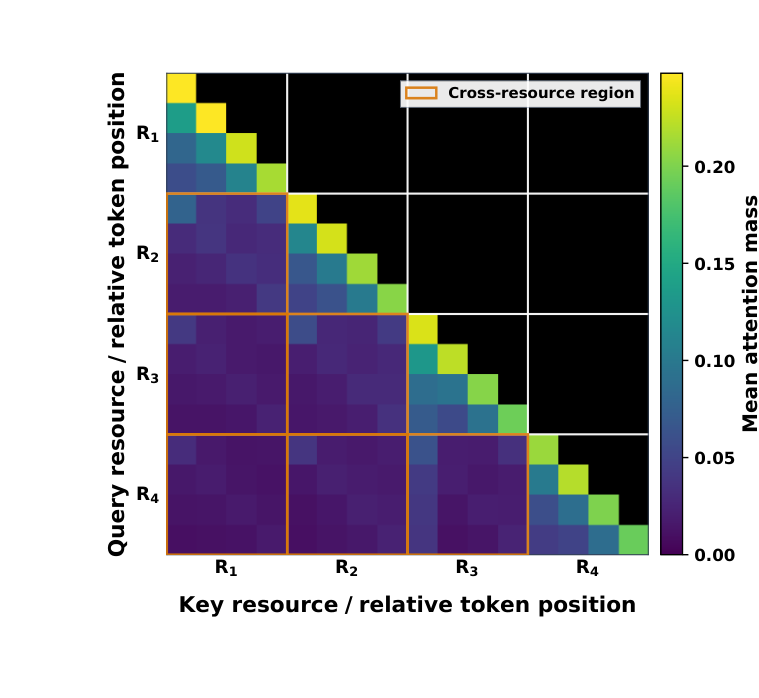
(a) Qwen3-4B 上跨资源的因果注意力分布(橙色方框代表跨资源注意力块)
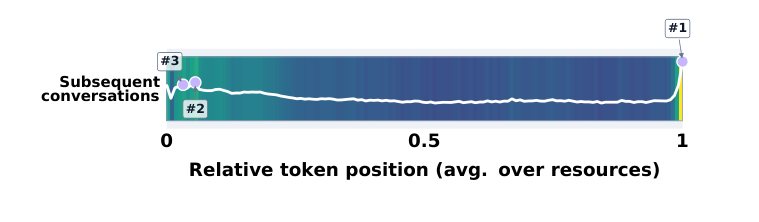
(b) 对话后续 Token 在工具内部不同相对位置上的注意力聚合(结尾 Token 权重最高)
核心发现:工具之间真的需要“互相关注”吗?
要理解 ReCache 的改造逻辑,首先要回到因果自注意力的本质。在标准的 Transformer 解码器中,模型会对整个上下文执行全向或因果注意力。当 Prompt 中包含 Tool A 和 Tool B 时,Tool B 必须 Attend 到 Tool A。这种设计建立在一个传统假设之上:模型需要理解不同工具在上下文中的相对顺序与全局依赖。
但事实真的如此吗?作者在 Qwen3-4B 上对注意力权重进行了可视化探测,得到了两项极具启发性的实验现象。
第一项现象反映在上方图 (a) 中。分析显示,绝大部分注意力权重高度集中在单个工具内部的局部 Token 上;而跨工具之间的注意力分数(图中被橙色线框圈出的非对角区域)极其微弱。从逻辑上看,这非常符合人类使用 API 的认知:一个地图搜索 API 的参数规则,在语义上完全不需要依赖一个天气查询 API 的定义。工具的语义自成一体,强行让它们在 Prefill 阶段进行全向交互,不仅引入了巨大的冗余计算,还带来了毁灭性的负面后果——让原本独立的工具表征与它在上下文中的“邻居”绑定在了一起。
第二项现象反映在图 (b) 中。作者统计了对话后续生成的文本(如 User Query、CoT 推理过程)在回看工具定义时的注意力分布。结果发现,绝大部分注意力集中在工具定义的起始部分以及最末尾的 Suffix Token。这表明,语言模型在阅读一个结构化的工具定义时,尾部 Token 天然承担了信息汇聚池的角色,将该工具的前置定义压缩并传导至后续推理阶段。
这两项发现构成了 ReCache 的理论基石:工具之间的前缀交互纯属多余,工具内部的全局绝对位置也可被替代。只要解决工具表示的自包含性与组合不变性,工具级 KV 缓存的独立复用就成为了可能。
机制一:资源级注意力,构建独立拼装的积木式 KV
为了彻底实现即插即用的缓存复用,ReCache 提出了资源级注意力(Resource-Wise Attention)。在这里,每一个独立的工具或技能 Schema 被抽象为一个“资源(Resource)” $R_i = (t_{i,1}, \ldots, t_{i,D_i})$。
常规注意力要求 $R_j$ 在 $R_i$ 之后时,$R_j$ 必须对 $R_i$ 进行因果掩码注意力计算。而 ReCache 直接修改了 Prefill 阶段的注意力掩码矩阵:
-
隔绝跨资源交互:任何资源 $R_j$ 的内部 Token 只能 Attend 到其自身包含的 Token,不同资源之间在注意力掩码中被完全阻断。
-
重置资源局部位置:为了消除全局绝对位置或相对距离对 RoPE 等位置编码的破坏,ReCache 为每一个资源分配完全相同的局部位置索引,即令 $pos(t_{i,j}) = j$。无论该工具在实际 Prompt 中排在第 1 位还是第 10 位,其内部 Token 接收到的位置编码永远从 0 开始递增。
这种设计使得每一个工具在离线预热或首次编码时,生成的 KV 状态只取决于工具自身的文本内容,与 Prompt 中的其他任何上下文完全解耦。
在实际推理时,系统一旦检索出需要使用的 $N$ 个工具,无需重新跑一遍庞大的拼接 Prefill,而是直接从内存或显存池中取出这些预先生成的独立 KV 块,像积木一样拼接在对话历史之后。由于此前消除了解耦阻碍,这种拼接不仅不损失局部语义,还直接跳过了重复计算。实验表明,仅仅引入资源级注意力,模型在保持与 Dense 全注意力 baseline 相当的调用准确率(82.3% vs 82.4% Inv-F1)的同时,实现了 3.655 倍的时间至首字(TTFT)加速。
机制二:贡献度引导的结构剪枝,只给关键路由“看”工具
独立缓存虽然解决了 Prefill 阶段的计算重复问题,但面对长达数千 Token 的庞大工具库,在随后的解码(Decoding)生成阶段,显存占用与注意力计算依然会随着并发量线性膨胀。
传统的 KV 压缩往往采用统一的层级截断(如 DepthKV)或基于注意力权重的筛选(如 H2O)。然而,注意力权重高并不等价于该参数对最终的“工具调用决策”有直接贡献。为了更精准地剔除冗余,ReCache 将剪枝视角推进到了两维:Transformer 层(Layer)与 KV 头分组(KV Head Group)构成的访问路由。
在大语言模型中,前馈网络(FFN)与多头注意力(MHA/GQA)分工各异,深浅层对信息的利用呈现明显的异质性。ReCache 提出了基于边际损失贡献(Marginal Contribution)的评估方法。其核心思想被称为“Leave-One-In”(独留打分法):
给定微调训练集,首先评估一个完全不暴露工具 KV 状态的极简基线损失 $\mathcal{J}(\emptyset)$;接着,仅在第 $l$ 层或第 $g$ 个 KV 头分组上暴露工具 KV 状态,其余部分遮蔽,计算此时的模型负对数似然损失 $\mathcal{J}(\Omega_l)$。该层或头组的边际贡献分数定义为:
\[s_l = \mathcal{J}(\emptyset) - \mathcal{J}(\Omega_l)\] \[w_l = \frac{\max(s_l, 0)}{\sum_j \max(s_j, 0)}\]分数 $w$ 越大,说明仅凭该层或该头组介入工具信息,就能为模型的调用预测带来越显著的损失下降。随后,ReCache 分别在层维度和 KV 头维度选出排名前 $K_L$ 和 $K_G$ 的子集,构成最优路由集合 $\Omega^\star = \mathcal{L}^\star \times \mathcal{G}^\star$。
在解码推理阶段,只有属于 $\Omega^\star$ 的层和头,对话文本才能跨越掩码去访问工具的 KV Cache;对于其余大部分路由,工具的 KV 状态直接被隐蔽。这种结构剪枝直接斩断了不必要的访存和计算路径,而且这种客观度量远比单纯统计 Attention 权重的启发式策略更加稳定。
在 Qwen3-4B 模型上的分析表明,层贡献度极其集中,仅保留前 20 层(占总层数的很大比例但裁剪掉了边缘层)就已覆盖了 97.7% 的累积贡献;而在 KV 头分组上,甚至只需要激活 3 个组,便能维持完整的工具调用判别力。这表明语言模型内部存在极强的工具表征替代性,大部分注意力通道在推理工具时都在进行无意义的空转。
机制三:字段感知的语义剪枝,剔除 Schema 的语法外壳
经过结构剪枝后,被激活的路由虽然变少了,但每个保留下来的路由仍然要加载工具 Schema 内部的所有 Token。
工具的 Schema 与常规自然语言有本质不同。普通文本的压缩方法(如 LLMLingua 等)通常基于信息熵或困惑度来删减词汇,往往会导致接口参数名或类型约束被切碎。然而在实际调用中,工具调用最致命的错误恰恰是工具名拼写错误(Hallucination)或参数名缺损。
结合前述的注意力分布特征,ReCache 制定了字段感知(Field-Aware)的语义剪枝策略:
-
保留可执行标识符:包括工具名称(Resource Name)、参数名称(Argument Name);
-
保留必要语义描述:参数的功能说明与类型约束;
-
保留末尾锚点:保留每个工具 Schema 的最后一个 Token(Suffix Token),利用其在 Prefill 阶段聚合好的整体语义;
-
剔除语法冗余:将 JSON/YAML 等接口描述规范中大量的标点、占位符、冗余格式标签等非关键 Token 从缓存中直接剥离。
最终,对话文本在属于 $\Omega^\star$ 的路由中回看工具缓存时,面对的不再是一个冗长杂乱的原始 Schema,而是一个经过结构与语义双重压缩的微型 KV 集合。
实验评测:在分布外测试中验证泛化极限
为了彻底检验 ReCache 的通用性,研究团队整合了 ToolACE、APIGEN、ToolMind、Toucan 等 7 个开源工具与技能数据集,构建了一套包含近 5 万条样本的综合评测基准。测试集严格划分为两大板块:
-
分布内测试($\mathcal{T}_{\mathrm{IND}}$):测试集中出现的工具在训练期曾被模型见过;
-
分布外测试($\mathcal{T}_{\mathrm{OOD}}$):测试集所使用的工具和 API 完全独立,在训练期彻底未见(Resource-Disjoint),用以考量解耦缓存机制是否损害了模型对未知 API 的零样本泛化调用能力。
评测指标涵盖了端到端调用 F1(Inv-F1,要求工具名及所有参数值必须完全正确)、工具识别精度与召回率(ID-P、ID-R),以及反映虚构 API 倾向的幻觉率(Halluc.)。
在 Qwen3-4B 主干模型上的评测呈现出了极具说服力的数据对比。在 $\mathcal{T}_{\mathrm{IND}}$ 分布内评测中:
-
传统标准全因果注意力(Dense)的端到端 Inv-F1 为 82.4%,工具识别 F1 为 92.5%;
-
仅采用资源级注意力的全尺寸独立缓存($\Omega_{\mathrm{full}}$),Inv-F1 达到 82.3%,二者差异仅为 0.1 个百分点,且工具幻觉率完全持平(0.4%);
-
在叠加了结构剪枝与语义剪枝后,完整的 ReCache 方案在保持 80.3% 的高水平 Inv-F1(保留了 Dense 性能的 97.5%)的前提下,将已分配的 KV-Tensor 显存开销暴减 92.43%,解码阶段的纯注意力计算延迟降低 29.7%(加速比达 1.423 倍)。
更为严苛的考验发生在 $\mathcal{T}_{\mathrm{OOD}}$ 分布外测试上。很多激进的上下文压缩技术往往在见过的分布里表现优异,但在面对全新接口时会因关键信息缺失而性能崩塌。实验显示,ReCache 在完全未见过的工具集上取得了 60.8% 的 Inv-F1,达到了 Dense 基线(66.2%)的 91.8%,且工具识别召回率依然保持在 84.7%。这证明字段感知的语义剪枝并没有扼杀模型的上下文理解,它精准锁定了工具接口的核心骨架,即使面对新工具,模型依然能准确解析参数。
在长上下文与多工具数量的极端扩展性测试中,随着提示词内挂载的工具长度不断延伸,Dense 模式与传统前缀缓存的 KV 显存开销迅速逼近 8 GiB;而 ReCache 凭借路由阻断与语义裁剪,将显存常驻开销死死锚定在 0.03 GiB 的极低水位,同时让解码期间的 TTFT 与 TPOT(每输出 Token 延迟)几乎呈现一条水平直线。
智能体底层推理栈的未来走向
回顾 ReCache 的整体架构,它的价值不仅在于提出了几个精巧的剪枝公式,更在于它向业界展示了一种全新维度的“模型-系统联合设计”范式。
长期以来,推理引擎开发者一直在被动适应大语言模型的自注意力机制,为了复用缓存不得不发明复杂的基数树(Radix Tree)或位置补偿算子(如 CacheBlend、KVLink)。而 ReCache 证明了一件事:在诸如 Agent 工具调用的特定垂直任务中,全向注意力本身就是一种归纳偏置的浪费。
通过显式剥离工具之间的交互、重置局部坐标系,我们不仅没有损伤模型的能力,反而将原本紧耦合的连续状态拆解成了完全自包含的微型状态算子。一旦这些算子具备了独立性,结合针对模型参数敏感度的精确路由,KV 缓存的复用粒度便真正下沉到了“组件级”。
当前,ReCache 仍需要在全参数微调阶段使模型适应局部的注意力掩码与坐标布局,这对于许多调用闭源商业 API 或希望在冻结开源权重上零开销部署的工程团队而言,仍存在一定的落地门槛。但随着开源小尺寸模型在端侧与私有化 Agent 场景的大规模普及,这种将“架构注意力重构”与“底层存储感知”紧密咬合的技术路径,正在为高并发、低延迟的自主智能体系统指引一条极具商业前景的演进道路。