PlayWorld:用Agent玩家测9大世界模型,揭示长程演化致命短板
PlayWorld: Benchmarking World Models with Agent Players over Long-Horizon Objectives
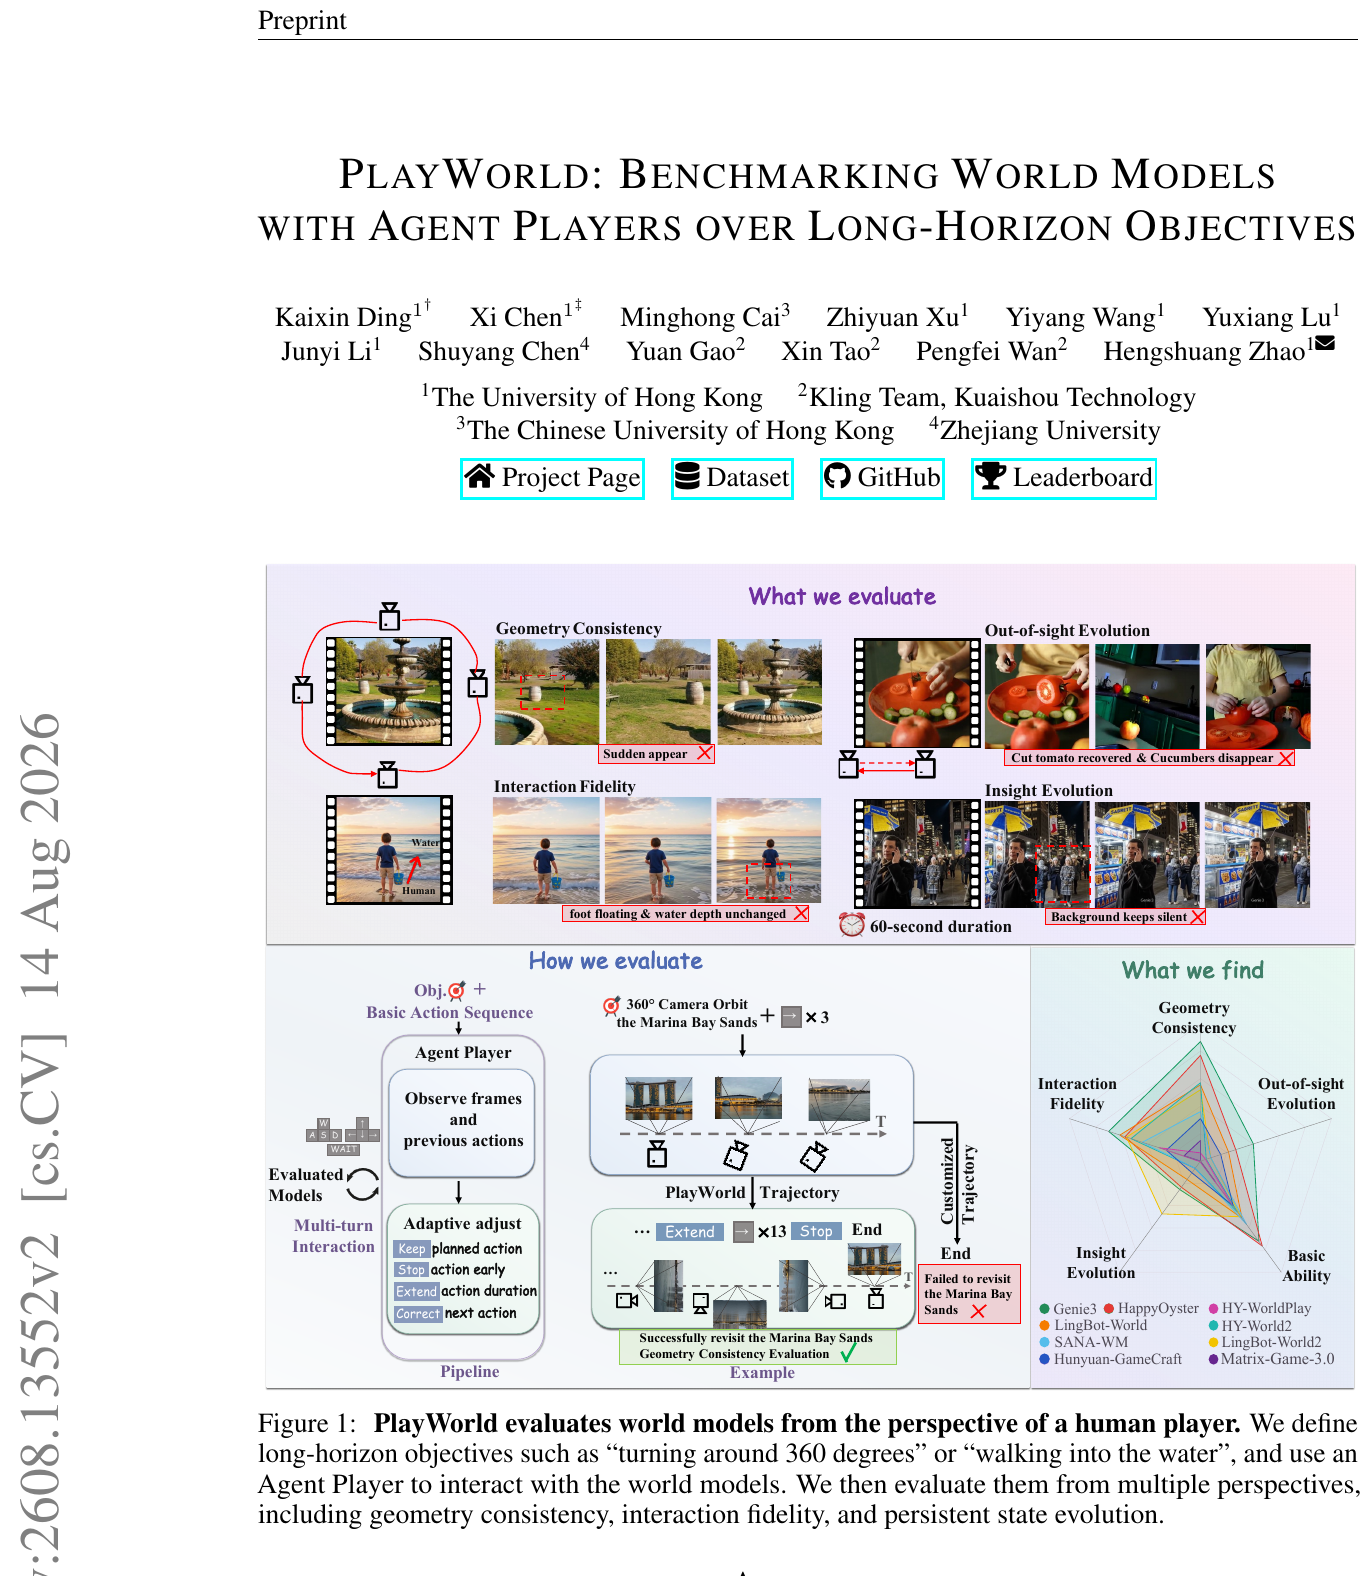
在过去一年多里,视频生成领域的研究重心正在经历一场明显的迁移:从单纯追求高画质、写实感的“单向视频生成”,走向允许用户实时输入控制信号、环境能够因果响应的“可交互视频世界模型(Video World Models)”。从能够随按键漫游的虚拟场景,到能够即时响应移动、碰撞与视点变换的交互系统,世界模型被普遍视为迈向通用具身智能与下一代虚拟仿真引擎的关键底座。
ArXiv URL:https://arxiv.org/abs/2608.13552v2
但繁荣背后潜藏着一个长期被忽视的技术瓶颈:我们究竟该如何客观、公平地评估一个世界模型?
现有的世界模型评测体系,大多沿袭了传统视频生成的离线逻辑,或者依赖一套预先写死的动作脚本(例如机械地执行“连续输入三次向右转”)。来自快手可灵团队(Kling Team)、香港中文大学、香港大学与浙江大学的研究团队在一项新工作中指出,这种僵化的静态评估方案,无法真实反映世界模型的实际能力。因为不同模型的控制粒度、响应速率与空间步长千差万别,同一套动作指令在模型 A 中可能刚好完成转体,在模型 B 中却可能严重欠调或穿模,最终导致空间一致性评测彻底失真。
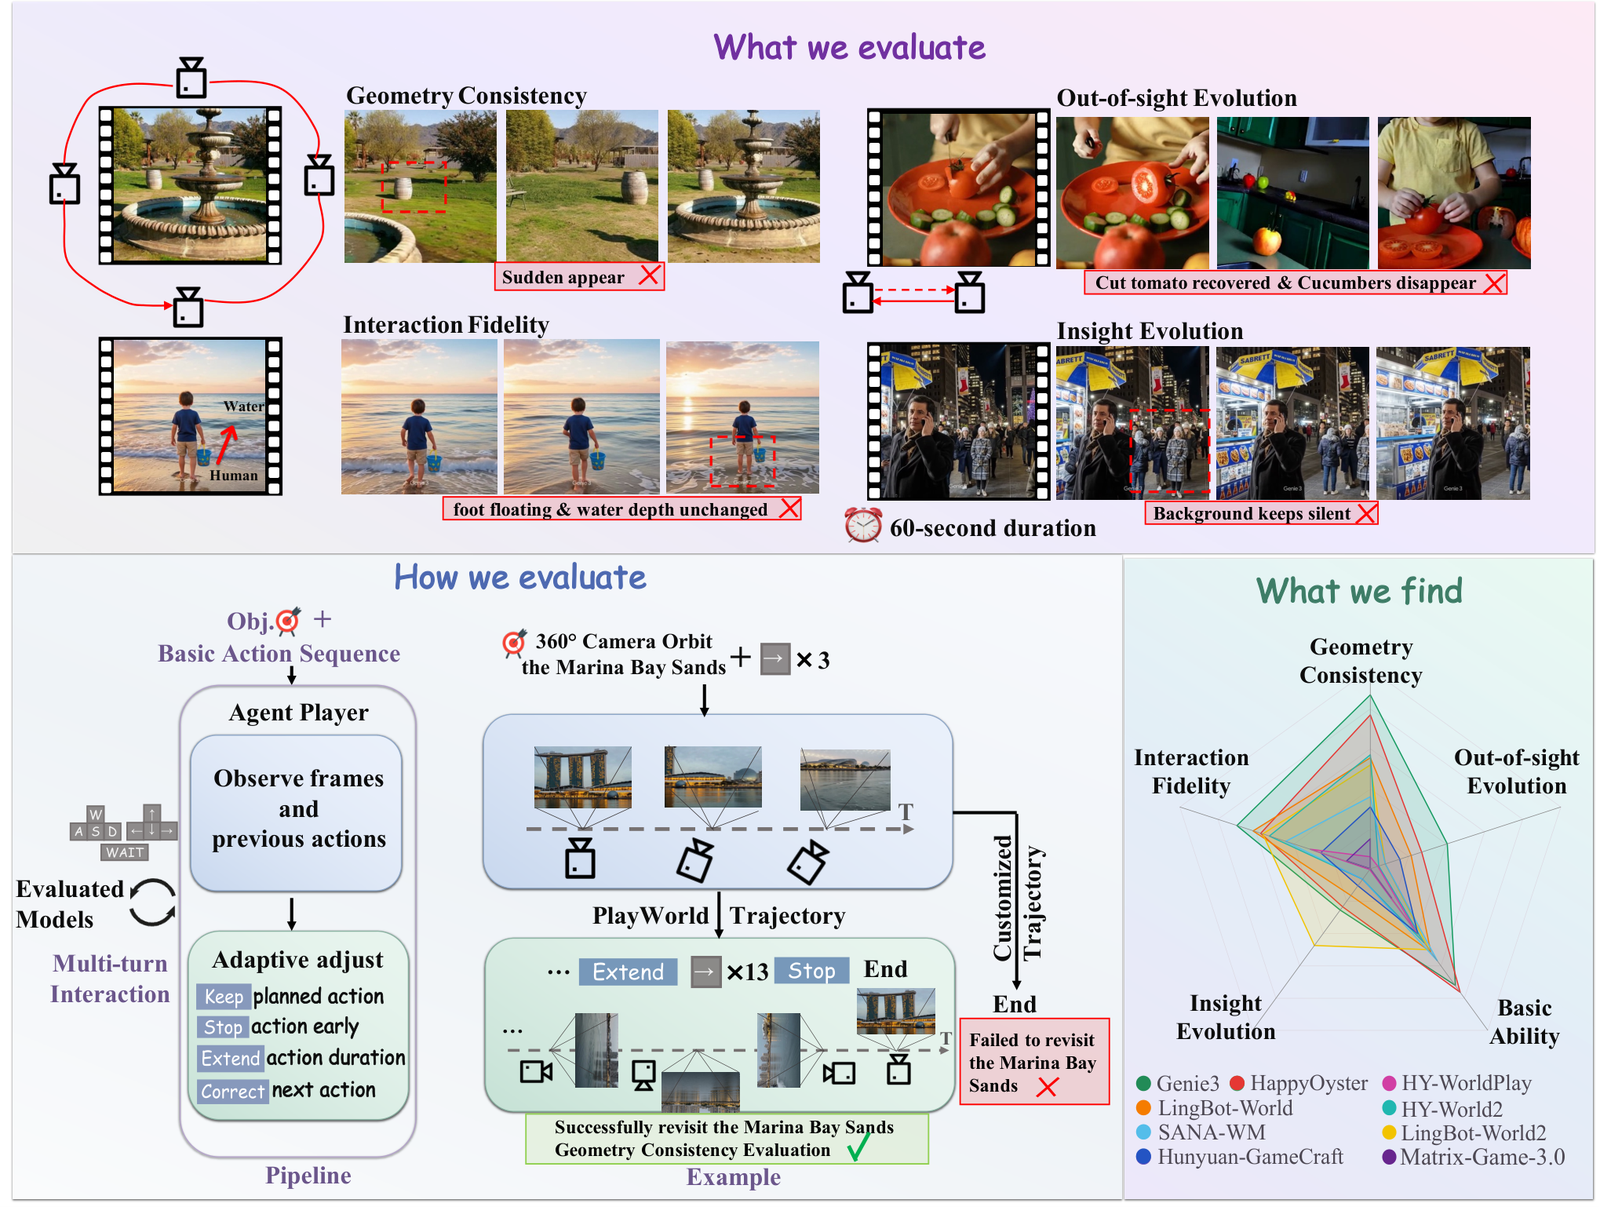
针对这一困境,研究团队提出了首个以智能体玩家模拟人类闭环交互的世界模型评测基准——PlayWorld。该基准构建了 171 个带有明确长程目标的交互场景,引入具备多模态感知能力的 Agent Player 实时调整控制策略,并设立了多维度的视觉问答打分规程(VQA Rubric Verifier)。在这套更加贴近人类真实体验的测试框架下,研究团队对包括 Google 的 Genie 3 在内的 9 款代表性世界模型展开了深度评测。实验不仅精准刻画了各大模型的真实分水岭,更揭示出当下世界模型的一个共性命门:当面对需要长程维持物理状态、因果连贯演化的任务时,现有系统依然极其脆弱。
静态脚本失效:世界模型为何不能用固定动作来测?
当一个真实人类坐在屏幕前体验世界模型时,评判标准绝不是“模型有没有在第 3 帧向右平移 20 个像素”,而是带着明确的高阶认知目标去探索世界。例如,玩家会转动视角 360 度,看刚才路过的地标建筑是否原封不动地出现在身后;或者主动操控角色走向水洼,观察水面是否会泛起真实的涟漪与倒影。
过去的基准测试(如 WorldScore、WorldMark、MemoBench 等)普遍采用预设轨迹策略。评测者预先录制好一段固定的按键序列,再把这段序列分别喂给不同的世界模型,最后通过重投影误差或特征相似度来判定几何与物理一致性。然而,这种评估方式在面对异构的世界模型时几乎必然失效。
这一缺陷的核心原因在于“控制粒度不匹配(Granularity Mismatch)”。在不同的模型架构中,单位动作所对应的物理量根本没有统一标准。比如同样输入一个“持续向右转向”指令,在以高质量见长的 Genie 3 中可能完成了一次大范围的平滑转角,但在另一个局部微调的本地模型中,可能仅仅微移了几个视场角度;又或者在第三个模型中,动作灵敏度过高导致视角瞬间漂移过头。
这就引发了严重的评测偏差:如果目标是“转体一周重新注视滨海湾金沙酒店”,一个预设的“向右三次”指令可能导致某些模型根本没能让目标建筑物重回视野。此时如果仅仅依据“当前视野内没有还原目标”而判定该模型几何一致性崩溃,显然是不公正的——因为系统崩溃的根源是动作执行的尺度差异,而非模型的空间记忆缺失。对于围绕雕塑环形绕行、在复杂障碍物间穿梭这类高阶动态模式,固定脚本甚至无法保证基本的轨迹闭环。此外,目前性能最顶尖的一批世界模型(如 Genie 3、HappyOyster 等)多部署在 Web 端,缺乏低级特征的直接访问接口,全靠人手手动测试既不可扩展又容易引入主观偏见。
世界模型的评估必须从“开环固定测试”升级为“闭环自适应交互”。评测系统必须像真正的人类玩家一样,边看边玩,边根据画面反馈修正接下来的按键,直至验证高阶目标是否达成。
Agent Player:让大模型充当动态试玩员
为了实现逼真、公正的闭环评测,PlayWorld 的核心机制是引入了一套由多模态大模型驱动的“智能体玩家”(Agent Player)。
Agent Player 并非漫无目的地在场景中乱逛,而是工作在一种双层架构之下:底层是面向被测模型的接口适配器,顶层则是具备视觉推理能力的 Agent。在评测启动时,人类专家为每个测试用例提供一个基准动作序列(Basic Action Sequence)作为动作先验,同时下达一个明确的场景目标(例如“向右绕行喷泉一圈并回到起点”)。
在运行过程中,Agent Player 采取了“参考轨迹引导 + 动态在线微调(Preset + Agent)”的混合控制策略。这是研究团队在大量消融实验后确立的最优平衡点。如果仅仅采用预设动作(Preset Only),就会退化为前文所述的僵化脚本,无法处理过冲或欠调;如果完全舍弃预设动作、让 Agent 从零开始单步决策(Agent Only),则会给多模态大模型带来极高的顺序推理延迟,并且 Agent 很容易在长序列推理中迷失长期规划,导致探索偏航。
通过将基础轨迹作为初始参考,Agent Player 能够在每个交互步长内观察世界模型实时生成的最新画面,结合历史操作记忆,灵活做出五种元决策之一:维持当前动作(Keep)、立即停止(Stop)、延长动作时长以弥补旋转不足(Extend)、改变按键方向修正漂移(Correct),或者判定目标达成而终止交互(End)。这种机制抹平了各大底层模型动作粒度的物理差异,确保所有模型都是在“竭尽全力去完成同一个长程任务”的前提下接受检验。
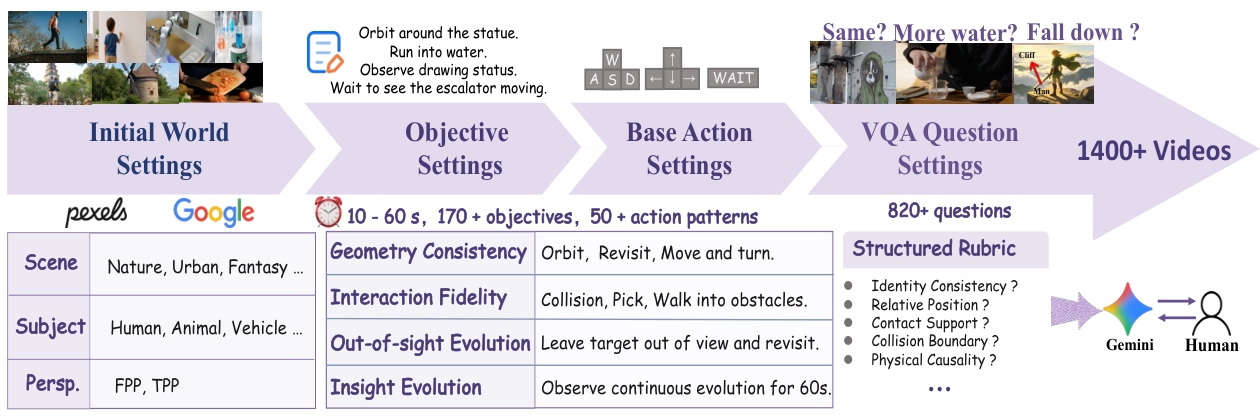
为了支撑严谨的实验,研究团队构建了一个高质量的基准库。整个流程涵盖图像筛选、多模态语义扩写、人工目标定义与动作序列标定,最终沉淀出 171 个精心设计的交互测试用例。这套数据集覆盖了自然景观、现代都市、奇幻世界等丰富环境,支持第一人称漫游与第三人称操控,单次交互视频的生成时长在 10 秒至 60 秒之间,包含超过 50 种高阶动作组合模式,全面覆盖了 W/A/S/D、方向键及停留等待(WAIT)等连续交互指令。
四大评测维度与多模态规程校验
在 Agent 驱动交互生成 10 到 60 秒的交互视频后,如何评判生成内容是否符合物理世界规律?传统的像素级指标(如 PSNR、SSIM 或单纯的 FVD)根本无法衡量语义连贯性,也不能判断交互行为是否因果自洽。为此,PlayWorld 构建了一套基于结构化题库的视觉问答验证器(VQA Rubric Verifier),联合使用前沿多模态大模型(如 Gemini 3.1 Pro)作为裁判。
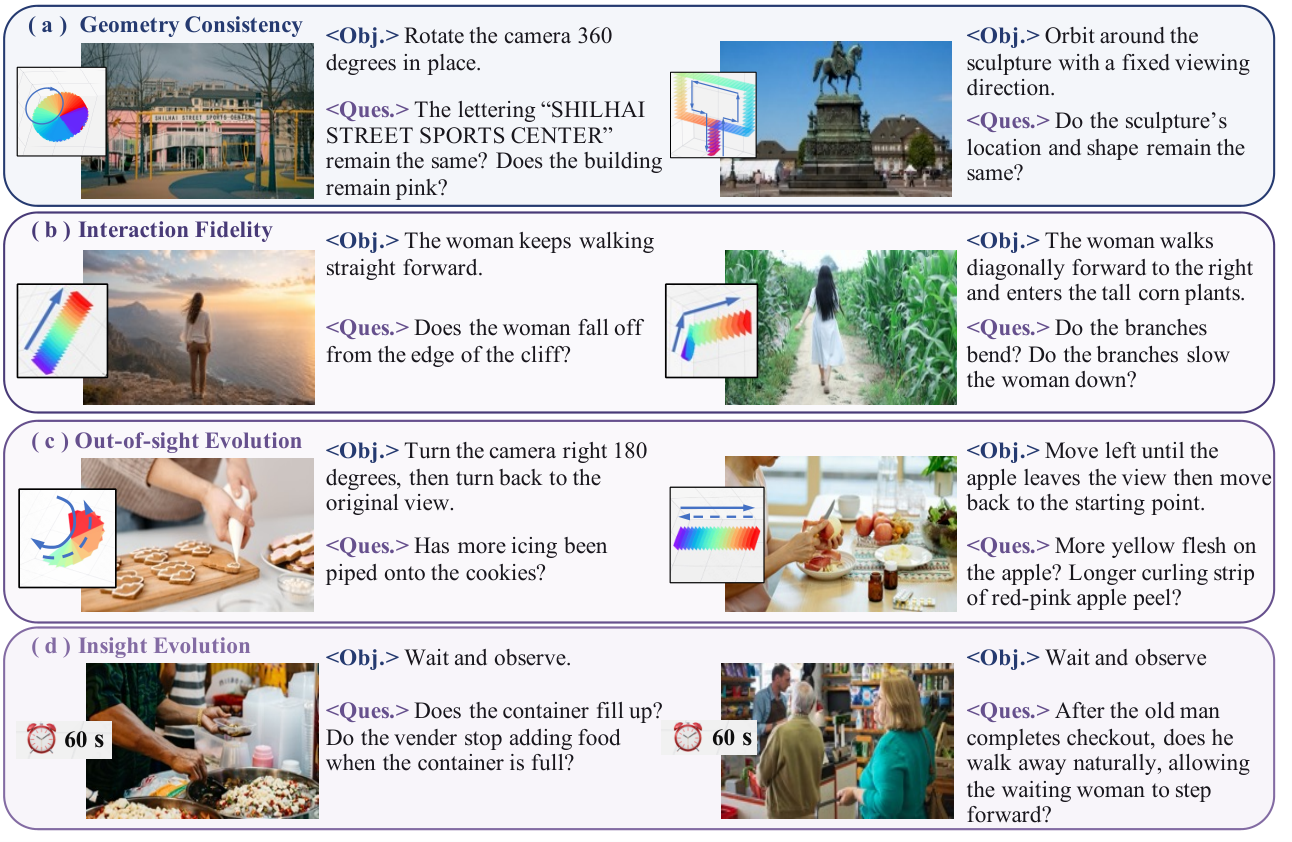
整个评测体系将世界模型的核心交互能力解构为四个互不重叠的关键维度:
其一是几何一致性(Geometry Consistency)。这一维度重点考察视点经历大尺度变换(如大角度旋转、环绕拍摄、走动后原路折返)时,场景中物体的三维空间相对位置、结构几何形态是否发生突变或错位,检验模型是否在潜在隐空间中真正维持了稳定的三维世界坐标。
其二是交互保真度(Interaction Fidelity)。重点考察输入特定控制命令后,主体与环境的物理解析是否符合常理。例如向前走向水池是否激起水花、推动物体是否发生合理的位移与遮挡形变、碰撞边界时是否发生穿模穿墙等。
其三是视野外状态演化(Out-of-Sight Evolution)。这一维度极具考验性:当一个动态实体(例如一辆正在行驶的汽车、一只奔跑的动物)从玩家的摄像机视场中移出一段时间后,玩家重新转动视角将其纳入视线时,该实体是否按照常理继续向前运动了对应的物理距离?还是直接被模型遗忘、原地冻结、甚至突变成另一件完全不相干的物品?
其四是视野内持续演化(Insight Evolution)。与前三项需要剧烈移动相异,该维度要求镜头保持绝对静止并持续观察 60 秒。此时考验的是静态画面内部自发物理过程的持续性:例如倒下的多米诺骨牌是否按因果时序逐一倒下,燃烧的火焰是否随时间消耗木柴,还是在几秒钟后由于自回归误差累积而陷入静态死锁或荒诞的画面崩溃。
为了防止多模态大语言模型在评测时产生虚假打分,PlayWorld 引入了“前置门控验证(Dimension-specific Validation)”机制。在评估几何一致性或视野外演化之前,验证器首先会严格审查 Agent 生成的视频是否真正完成了指定的轨迹要求;在评估交互保真度时,也会预先确认目标主体是否在画面中被成功触达。如果视频由于模型响应完全失效而连基本的轨迹门槛都未跨过,该项得分将被直接置为最低基准分 1 分。只有通过前置门控的有效样本,才会进入针对细分题目的加权打分流程,最终汇总为 1 到 5 分的综合等级。此外,系统同步集成了基于 VGGT 的摄像机位姿估计,以平移通过率和旋转通过率来对基础动作可控性进行辅助定量。
实验结果与评测洞察:谁是真正的世界模型?
在由快手联合多所高校开展的这场横跨 9 款顶尖世界模型的全面摸底中,测试对象既包括运行于云端 Web 交互界面的系统(Genie 3、LingBot-World、LingBot-World2、HY-World2、HappyOyster),也涵盖通过分块生成机制在本地执行的开源与半开源方案(SANA-WM、Hunyuan-GameCraft、HY-WorldPlay、Matrix-Game-3.0)。所有的模型都面对着完全一致的初始帧、相同的任务目标,并由配置相同的 Agent Player 实施控制。
从整体综合评分来看,Google 的 Genie 3 在大多数评测指标上展现出了显著的技术壁垒,其在几何一致性、交互保真度、视野外演化以及总分上均位居前列;HappyOyster 紧随其后位列综合第二;而在视野内静态长程演化方面,LingBot-World2 则取得了第一名的成绩。这一梯队与本地部署的中小型模型之间拉开了较为明显的断层,证明在大规模自回归生成与三维潜空间先验建模上,头部闭源大模型依旧具有规模化红利。
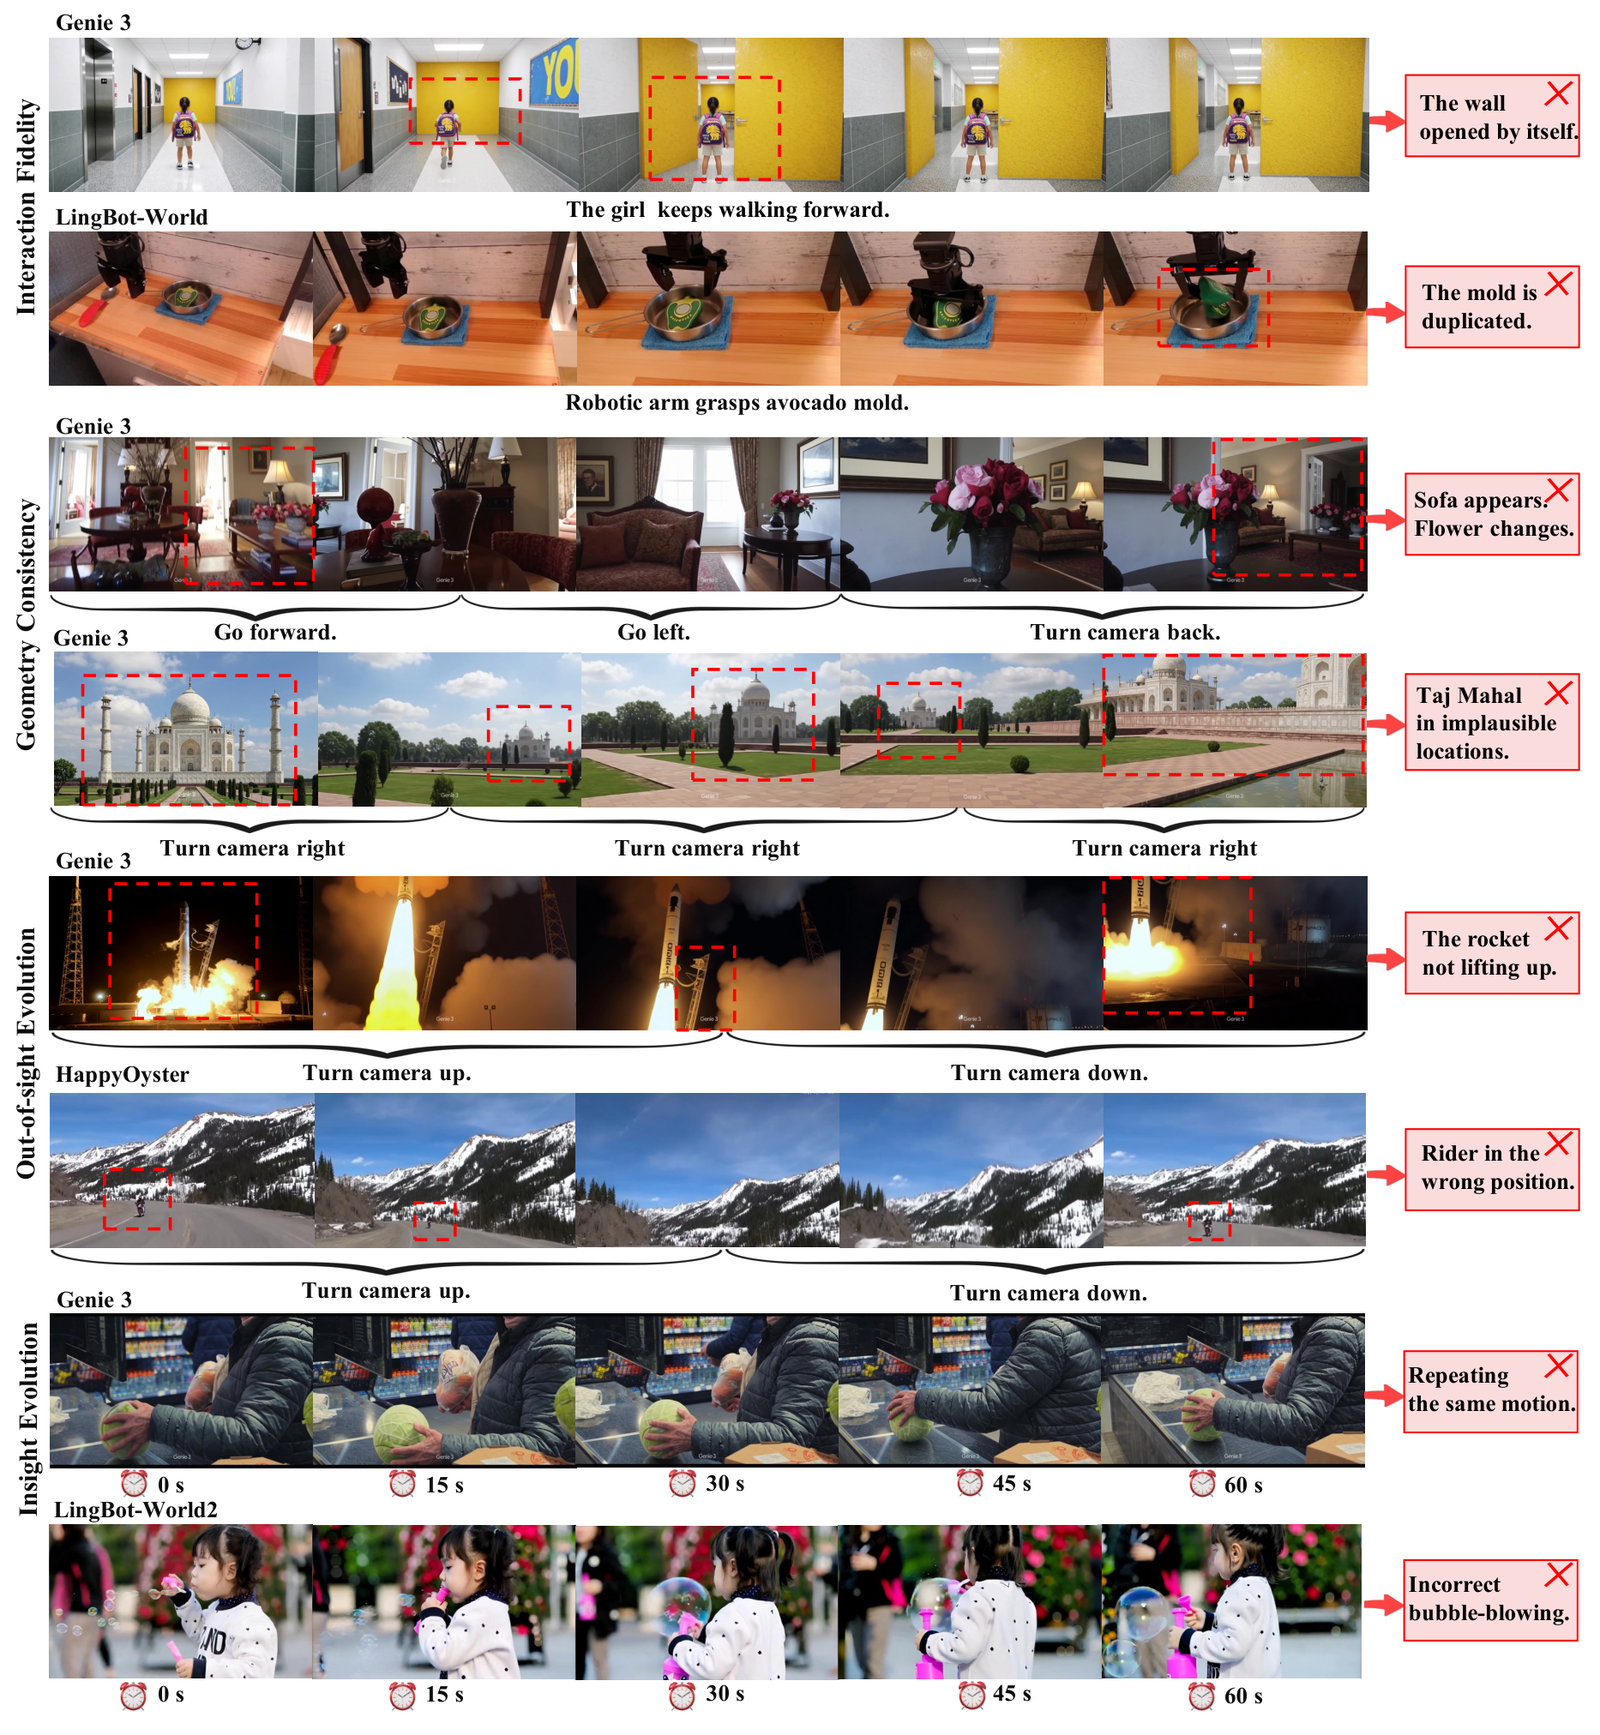
然而,将实验数据按能力维度切开分析时,一个跨越所有模型的严峻技术现实浮出水面:长程动态演化的持久维持能力,是当下所有世界模型的集体死穴。
数据表明,无论是排名顶尖的 Genie 3 还是其他跟进模型,在几何一致性(即空间视差下的静态重投影保真)上普遍拿到了相对可观的分数,但在“视野外演化”与“视野内持续演化”两个维度上,全行业的分数都遭遇了大幅下跌。
定性分析这些生成视频,会发现极为典型的模型退化模式:
-
记忆抹除与主体突变:当特定主体(如前方的骑车人)脱离当前视野数秒后,若 Agent 操纵视角追赶过去,模型往往无法在其对应的时间坐标处还原该主体,要么原本存在的角色凭空蒸发,要么同一坐标上凭空“幻觉”出一辆静止汽车或一条狗,展现出对非可见区域缺乏全局记忆图谱支撑的本质缺陷。
-
时间流逝停滞与伪循环:在长达 60 秒的静止观测实验中,绝大多数模型在前 5 到 10 秒能够展现合理的物理流动(如水流、落叶),但在随后的时间里,画面的物理因果链条开始断裂。很多模型会进入局部高频闪烁状态,或是自发将物理过程“重置回初始帧”,甚至物体运动彻底静止,这暴露出扩散模型或自回归网络在长序列外推时无法抵御误差累积、难以维持持续单向时间箭头的理论缺陷。
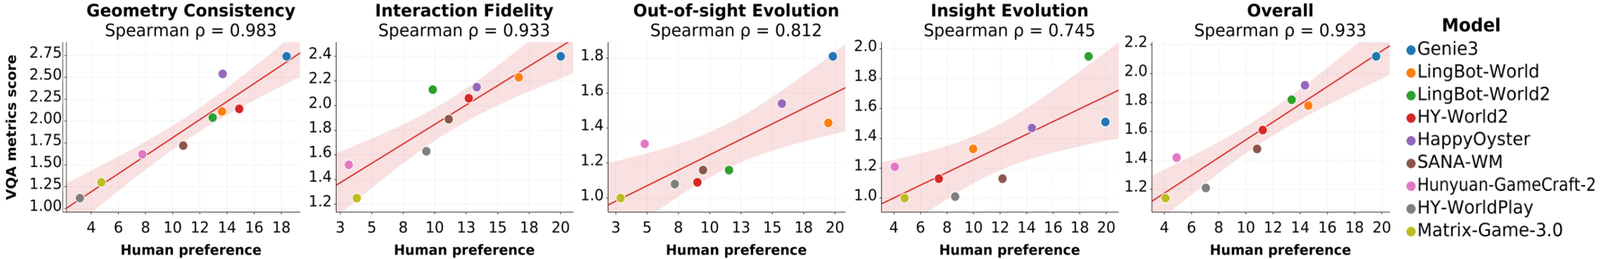
为了验证 PlayWorld 这套 VQA 自动化裁判机制的权威性,研究团队组织了大规模的人类盲测,收集了跨四个维度的 600 份有效成对主观判断。统计结果显示,PlayWorld 自动化评分产生的模型相对排序,与人类主观打分的胜率排序展现出极高的一致性(斯皮尔曼等级相关系数 Spearman’s $\rho$ 均处于显著强正相关区间)。这证实了利用“Agent Player 闭环交互 + 细粒度 VQA Rubric”的自动化流程,能够高度逼真地复现人类玩家对世界模型的客观评判。
而在 Agent Player 选型上,团队通过消融实验证实,作为裁判员的 Agent 模型不需要追求参数量最庞大、调用成本昂贵的顶级大模型。轻量级且具备敏锐视觉感知能力的模型(如 Claude Haiku)在响应延迟、动作纠偏执行率和成本效益上达到了最佳平衡,完全足以胜任自动化玩家的角色。
结论与行业启示
PlayWorld 的核心价值在于重新定义了世界模型的评测哲学:世界模型不是用来“播放”的,而是用来“玩”的。通过引入多模态 Agent Player 替代机械僵硬的硬编码轨迹,PlayWorld 成功化解了不同模型动作粒度不一致导致的评测失真难题,使得对 Web 端黑盒系统与本地白盒模型进行大规模、标准化的公平对比成为可能。
这项研究给整个 AI 社区带来的启示是清醒且深刻的。当前许多交互视频生成演示给人以“通用物理模拟器已经近在眼前”的错觉,但一旦置身于 10 到 60 秒的长程连续交互与受控目标之中,哪怕是目前最先进的模型也会在三维持久性和时间演化因果性上频繁暴露短板。
这表明,仅凭在大量视频数据上暴力增加规模、进行下一帧预测,或许并不能天然让模型习得真正具备因果外推能力的三维世界表征。未来的世界模型要想真正成为可用于仿真测试、具身强化学习乃至替代图形渲染引擎的下一代基础设施,必须在架构层面显式引入三维时空记忆库、持久状态跟踪机制以及对物理规律的硬约束模块。而 PlayWorld 所建立的这套交互式评测体系,正是检验这些未来架构能否真正跨越虚拟与现实边界的试金石。