不是 JSON 而是 Python:大模型工具调用范式转变,新模型最高提升10.6%
The Bitter Lesson of Tool Calling
在构建大模型 Agent 时,让模型调用外部工具几乎成了工业界的标准动作。目前绝大多数落地框架默认都遵循同一套规范:将可用工具定义成一套严格的 JSON Schema 塞进 API,模型在需要调用时吐出一个格式化的 JSON 字符串,运行环境解析参数后再把结果返回给模型。
ArXiv URL:https://arxiv.org/abs/2608.06370v1
然而,大模型本质上早已具备了强大的代码生成能力。既然模型本身就会写代码,为什么还要强迫它通过僵硬的结构化 JSON 进行多轮单步调用,而不是直接写一段 Python 脚本一次性完成编排?
来自普华永道商业技术与创新办公室(PricewaterhouseCoopers CTO Office)的研究团队在论文《The Bitter Lesson of Tool Calling》中直面了这一核心分歧。研究通过在主流工具调用基准 BFCL v4 上对 14 款跨越近两年的大语言模型展开严谨对比,系统评估了以 Python 脚本为载体的程序化工具调用(Programmatic Tool Calling, PTC)与原生 JSON 工具调用(JSON Tool Calling)的优劣。
研究给出了一个极为明确的信号:工具调用的范式正在向代码倾斜。在测试的 14 款模型中,程序化工具调用在 11 款模型上的表现追平甚至超过了传统的 JSON 模式,其中 GPT-5.6 系列取得了最高 10.6% 的绝对准确率提升。这篇工作清晰揭示了原生 JSON 调用在长链条、高并发和抗干扰场景下的结构性缺陷。
范式之争:从 JSON 往返到代码级单轮执行
长期以来,JSON 工具调用的工作流是一个典型的多轮交互回路。如果一个任务需要调用两个有依赖关系的工具,模型必须先在第一轮吐出 $f_1$ 的 JSON 规范,外部系统解析执行并将结果返回到上下文,模型在第二轮基于新上下文再生成 $f_2$ 的调用参数。
程序化工具调用(PTC)彻底颠覆了这种模式。在 PTC 范式下,所有工具函数都被编译成带类型标注的 Python 存根(Typed Python Stubs)直接内嵌在 System Prompt 中。模型面对复杂任务时,不需要多轮试探,而是直接编写一段标准的 Python 脚本,以纯代码的形式完成多函数的串联、循环或并发调用。
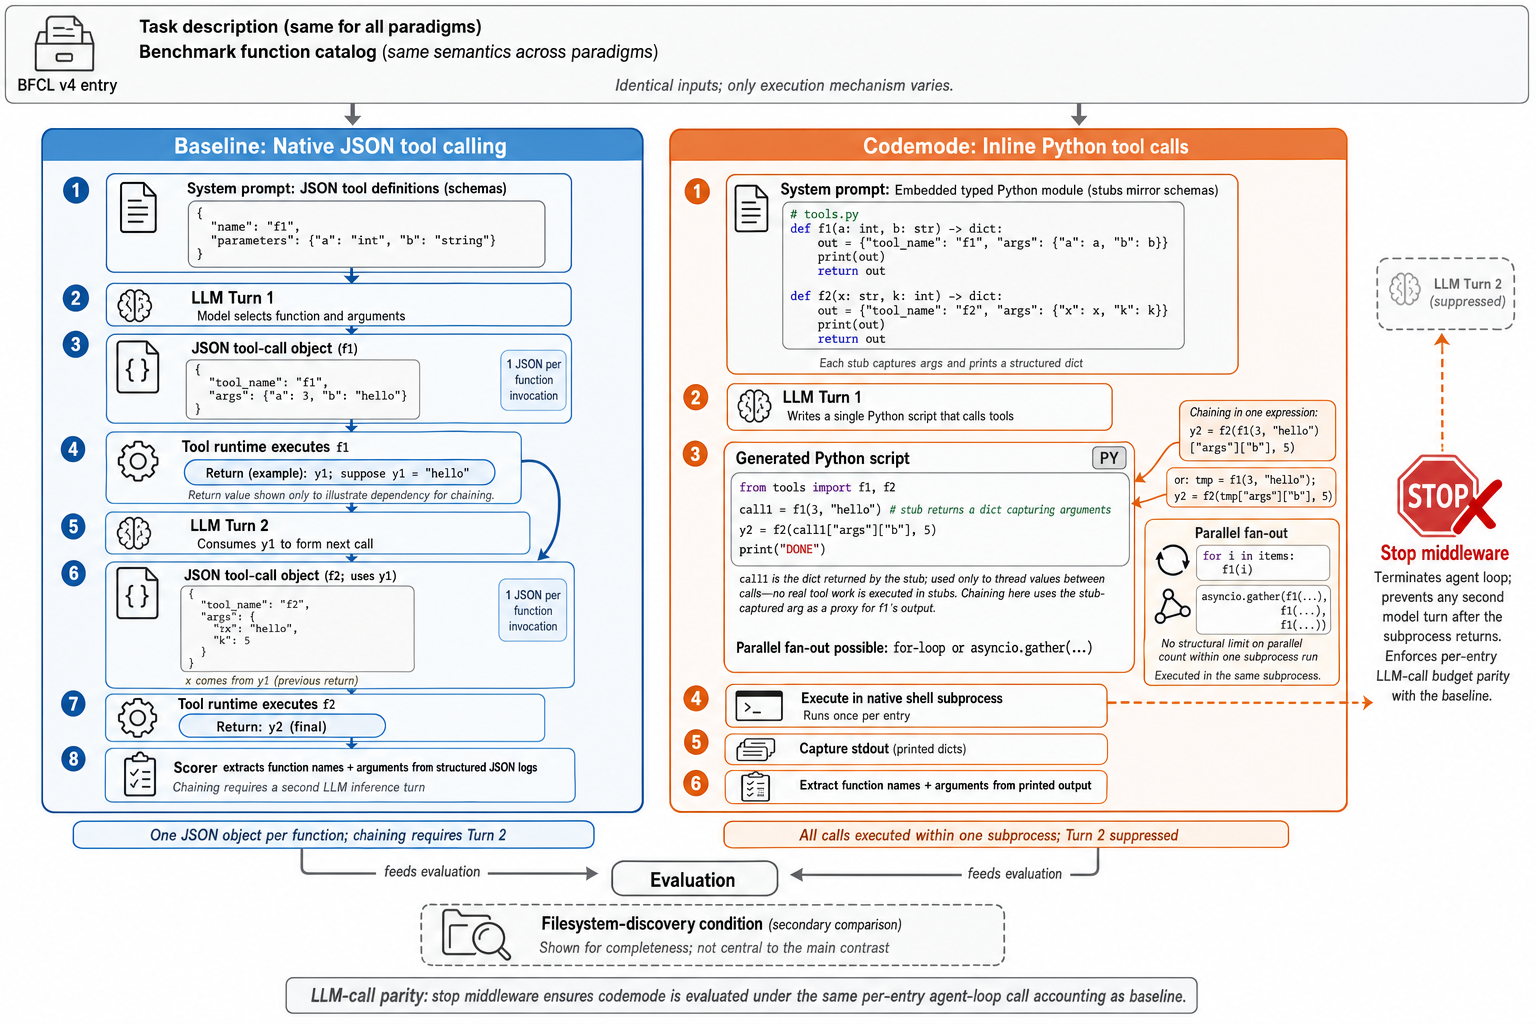
如上图所示,PTC 架构中宿主环境只需在独立的 Shell 子进程中直接执行模型生成的脚本,截取标准输出即可完成评分和动作执行。这一设计使原本需要多次往返的 Agent 循环被压缩进单次模型推理中,从根本上改变了交互的拓扑结构。
谁胜谁负?能力分水岭取决于模型代际而非家族
在 BFCL v4 覆盖 8 个维度的 309 项代表性任务评测中,两类范式的表现没有呈现出 Anthropic 与 OpenAI 两大阵营的割裂,而是呈现出极其规整的“代际递进”特征。
Anthropic 家族表现出惊人的连续性。从 Claude Haiku 4.5 到 Sonnet 5,全部 5 款 Anthropic 模型在 PTC 模式下的准确率均追平或超越了原生 JSON 基线,绝对提升幅度在 0.0% 到 6.5% 不等。OpenAI 阵营则出现了显著的技术代差:最新的 GPT-5.6 变体全面转向正向收益,相比基线提升了 4.2% 至 10.6%;而较早期的 GPT-4o、GPT-4.1 以及 GPT-5.4-mini 在 PTC 模式下的表现则遭遇了 19.7% 到 26.9% 的大幅下滑。
深入排查这些较早模型的失败日志后,研究人员发现了一个高度一致的低级失误:旧版模型在生成多行 Python 脚本时,倾向于输出字面意义上的转义字符 \n,而不是真正的换行符。这导致子进程在执行脚本时直接触发了语法解析错误(Syntax Error)。而与 GPT-5 同期发布的 GPT-5-nano 则完全修复了这一问题,说明代码格式生成的稳健性在这一代际的训练数据中得到了底层修复。只要底层代码生成能力过关,代码调用的表现就会对 JSON 形成压制。
三大极端工况消融:彻底击穿 JSON 调用的硬限制
为了摸清代码范式究竟赢在哪里,本文设计了针对链式调用(Chaining)、并发调用(Parallelism)和上下文干扰(Context Rot)的三项严苛消融实验。
第一项挑战是长链路的顺序调用。当链条长度较短时,JSON 与代码的准确率差距并不明显;但随着依赖调用次数增加,JSON 模式的累积失误率迅速抬升。在链长大于等于 12 步的极长任务中,PTC 模式的准确率直接拉开了 18.8% 的绝对差距。核心原因在于,JSON 模式每推进一步就必须消耗一次新的推理轮次,误差在多轮迭代中被不断放大;而 PTC 依靠模型内部的参数化推导,在一次代码编写中直达终点。除 GPT-5 因超长思考时间拉长了单轮耗时外,其余 13 款模型在 PTC 模式下的端到端耗时均降至 JSON 基线的 0.32 到 0.96 倍,几乎节省了一半的墙钟时间。
第二项挑战是高并发分支调用。在需要一次性派发海量请求时,原生 JSON 调用遇到了明显的“注意力天花板”。当并发调用数增加时,模型必须在单次响应中逐一输出长串的 JSON 结构体,极易发生截断与遗漏。针对 Claude Sonnet 5 的极限探针测试显示:
-
当并发数 $N \leq 70$ 时,原生 JSON 调用的枚举完整率保持在 100%;
-
当并发数提升至 $N = 72$ 时,枚举完整率断崖式跌落至 75%;
-
当并发数达到 $N = 100$ 时,原生 JSON 调用彻底崩溃,准确率直接清零;
-
相比之下,PTC 模式借助 Python 的循环结构和并发语法,在 $N = 72$ 和 $N = 100$ 下全部稳定保持 100% 的准确调用。
这种优势不仅体现在稳定性上,还直接反映在推理成本的倒挂上。在小并发下,PTC 因为 Prompt 中嵌入了 Python 模块定义,固定输入 Token 略高于 JSON 模式;但当并发数越过 $N \approx 26$ 的临界点后,JSON 必须机械枚举所有参数对象,导致输出 Token 发生膨胀。在 $N = 48$ 的场景下,JSON 模式消耗了 5,097 个 Token,而 PTC 脚本仅消耗 3,535 个 Token,代码的表达密度显现出巨大优势。
第三项挑战是恶劣的上下文污染。在真实应用中,环境里往往充斥着无关的 API 接口。评测设置了 Filtered(仅提供任务相关接口)和 Flood(混入无关接口直至 128 个 Schema)两组对比。结果显示,在面对 128 个复杂干扰 Schema 的极端压迫下,原生 JSON 调用的准确率平均下滑了 2.3%,而内部参照的“文件系统动态发现模式”更是直接跳水 32.0%;反观 PTC 模式,整体准确率不仅未发生衰退,反而逆势取得了平均 5.5% 的绝对正向提升。类型化的 Python 代码结构天然为模型提供了更具抗干扰能力的语义骨架。
范式迁移已成必然
这项研究之所以冠以“苦涩的教训”(The Bitter Lesson),正是因为它指出了工具调用工程中的一个执念:业界花费了大量精力去设计专门的 Function Calling API、结构化约束解码和 JSON 解析容错方案,试图以此驯化大模型;然而最普适、最高效的界面,其实一直是模型在预训练阶段就掌握得最熟练的语言——代码。
代码本身具备可执行、可内省、状态天然留存的高密度表达能力。随着大模型在推理与编程能力上的持续提升,继续把工具调用局限在死板的 JSON 数据交换协议中,已经成为制约复杂 Agent 进化的性能枷锁。从专门协议回归通用代码,不仅简化了工具调用的交互架构,也为构建支持复杂计算、长链条规划与高并发调度的新一代 Agent 铺平了道路。