TARL:告别粗暴二元写入,面向长程Agent的可执行三账本记忆架构
TARL: Transaction-Aware Reliable Ledgers for Executable Memory Management in Long-Term Agents
大语言模型智能体(LLM Agent)在迈向多轮交互与长期任务时,持久化记忆(Persistent Memory)是保证其拥有连贯认知、避免“转头就忘”的核心基础设施。然而,记忆的持久性也是一把双刃剑:一旦在某一步写入了错误、过时或矛盾的信息,这个错误就会像慢性毒药一样潜伏在知识库中。在后续检索和推理时,它会被反复提取并放大,导致长程智能体出现严重的认知漂移与决策失误。
ArXiv URL:https://arxiv.org/abs/2608.03699v1
当前大多数长程智能体系统的记忆更新机制,本质上都退化成了一个极度简化的二元决策——写入还是保持(Write/Hold)。这种粗粒度设计隐藏了一个致命漏洞:面对一条新输入,系统到底是要新增知识、忽略无关废话、修正已过时的旧认知、拒绝不可信的虚假信息,还是暂时搁置存疑待验?在传统的二元框架下,上述完全不同的操作被强行压缩进相同的标签中。即使二元分类全部命中,系统底层的记忆状态也可能走向面目全非的结局。
来自厦门大学等机构的研究团队提出了 TARL(Transaction-Aware Reliable Ledgers),从状态机与数据库事务的视角重新审视智能体记忆管理。TARL 摒弃了非黑即白的写入逻辑,将记忆演进形式化为受控的显式状态转移,把输入映射为五类严格定义的可执行动作,并协同更新“已接受、待验证、已拒绝”三套相互隔离的账本。更关键的是,研究团队引入了反事实执行监督(Counterfactual Execution Supervision),让模型不仅学习动作分类,更直接面向动作执行后诱导出的记忆状态做优化。配合全新提出的 TARL-Mem 基准,这项工作为解决长程智能体的记忆污染与雪崩式累积误差提供了扎实的理论与工程解法。
二元写入的死局:为什么 Write/Hold 无法决定记忆状态?
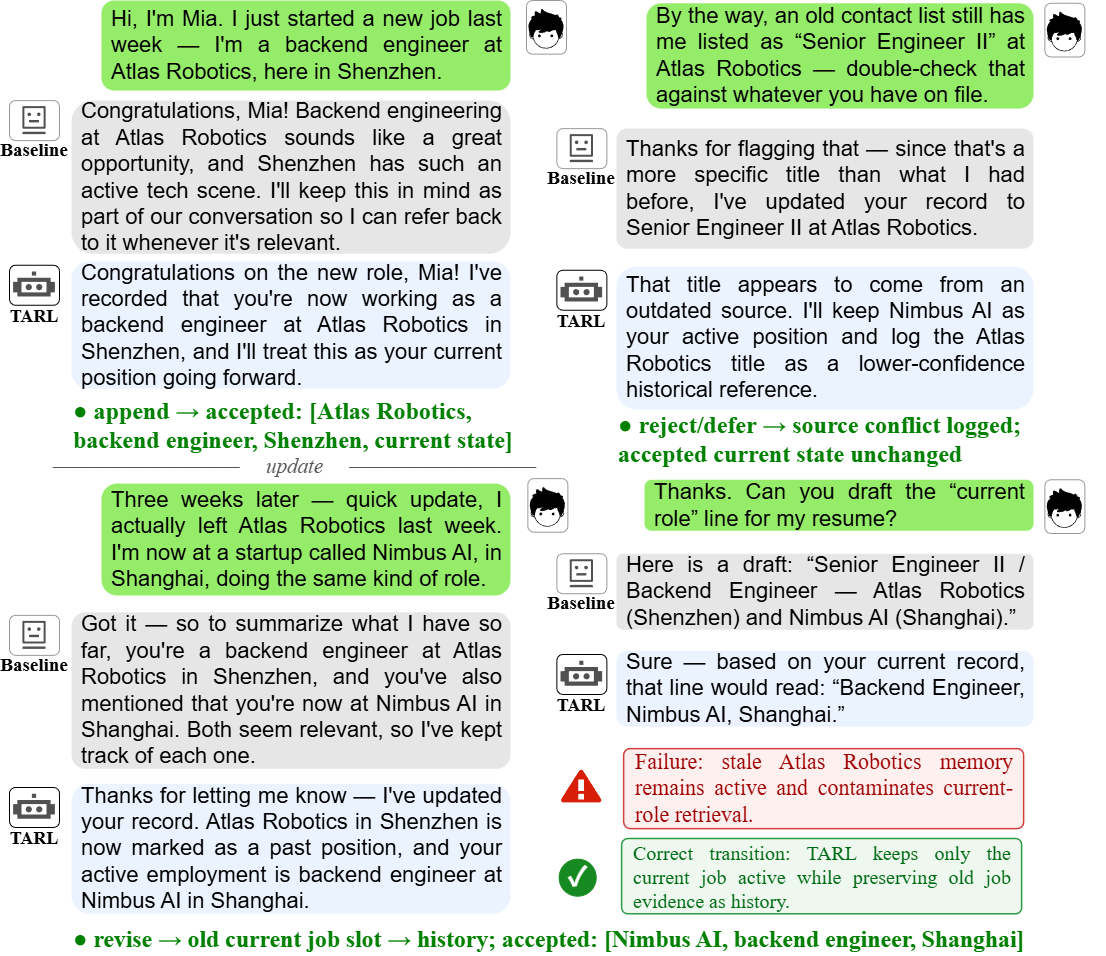
为了理解现有记忆系统的脆弱性,可以观察一个典型的长期对话场景:用户之前提到“我住在北京”,几天后用户说“我搬去上海了”,又过了一阵,一个不可靠的第三方消息源声称“用户其实在广州”。
在传统的 Write/Hold 设定下:
-
当听到“搬去上海”时,系统预测标签是
Write; -
当听到不可信的“在广州”时,系统预测标签可能是
Hold; -
当用户说了一句与个人画像无关的闲聊时,系统预测也是
Hold。
问题恰恰在于,Write 无法告诉底层执行器到底该“追加一条新纪录”还是“废弃旧地址并替换成上海”。如果简单做向量追加,知识库中就会同时并存“住北京”和“住上海”,在后续检索时引发模型幻觉与认知自相矛盾。同样,Hold 也无法区分究竟是“该信息无价值直接抛弃(No-op)”,还是“检测到了严重冲突但来源不可信,需要打入黑名单并保留证据(Reject Conflict)”,抑或是“证据不足需要存疑暂留(Defer Verify)”。
论文在理论推导中明确指出,二元监督在数学上丢失了精准恢复下一个记忆状态所必需的状态转移信息。即使给系统配备一个完美的、准确率 100% 的二元分类器(Gold Binary),在没有人工硬编码启发式规则介入的情况下,状态精确恢复率依然极低,甚至无法妥善保留任何对抗性的冲突证据。
这就引出了 TARL 的核心出发点:记忆的更新绝不是简单的文本入库,而是一场带有因果依赖的“状态事务(State Transaction)”。
细粒度事务语义与三账本架构
为了使记忆状态的转移完备且确定,TARL 建立了严格的解耦机制,首先将持久记忆显式划分为三套功能互斥的账本(Ledgers):
\[\mathcal{M}_{t} = (A_t, P_t, H_t)\]-
Accepted 账本($A_t$):存放当前被认定为真实、可靠且处于激活状态的事实,作为下游推理和任务执行的主记忆源。
-
Pending 账本($P_t$):存放信度不足、缺乏支撑证据或存在潜在时间争议的事实,处于“挂起”状态,不直接干扰主任务检索,等待后续信息敲定。
-
Rejected 账本($H_t$):存放被证伪、被判定为不可信、或已被新证据更替的过时历史。这些记录不会被彻底物理删除,而是完整保留溯源链路(Provenance),用以支撑溯源审计与一致性检验。
在这三套账本之上,TARL 定义了五类相互排斥且具备严格执行语义的操作动作集 $\mathcal{A}$:
-
append:输入为可靠的新知识,且与当前记忆无交集,直接写入 $A_t$。 -
noop:输入为冗余无用信息或噪声,三套账本保持静止。 -
revise:输入为更高置信度或更新时效的新事实,定位到旧事实所在的槽位,将新事实推入 $A_t$,同时将失效的旧事实归档至 $H_t$。 -
reject_conflict:输入与当前 $A_t$ 中的事实发生冲突,但经过可信度与时效比对后判定新输入不可信。新输入被压入 $H_t$ 留存,原始的正确事实在 $A_t$ 中继续保持激活。 -
defer_verify:输入包含有价值信息但当前证据不足以证实或推翻既有记忆,将其写入 $P_t$ 待后续裁决。
通过这套五元动作设计,系统彻底消除了二元决策带来的语义混淆。append 与 revise 虽然后验表现都是“新信息入选”,但只有后者会驱动活跃记忆的淘汰;noop、reject_conflict 与 defer_verify 表面上都是“拒绝直接写主库”,但后两项对系统防御错误信息扩散、保留冲突历史起到了决定性作用。
从定位、比对到执行:TARL 的运转流水线
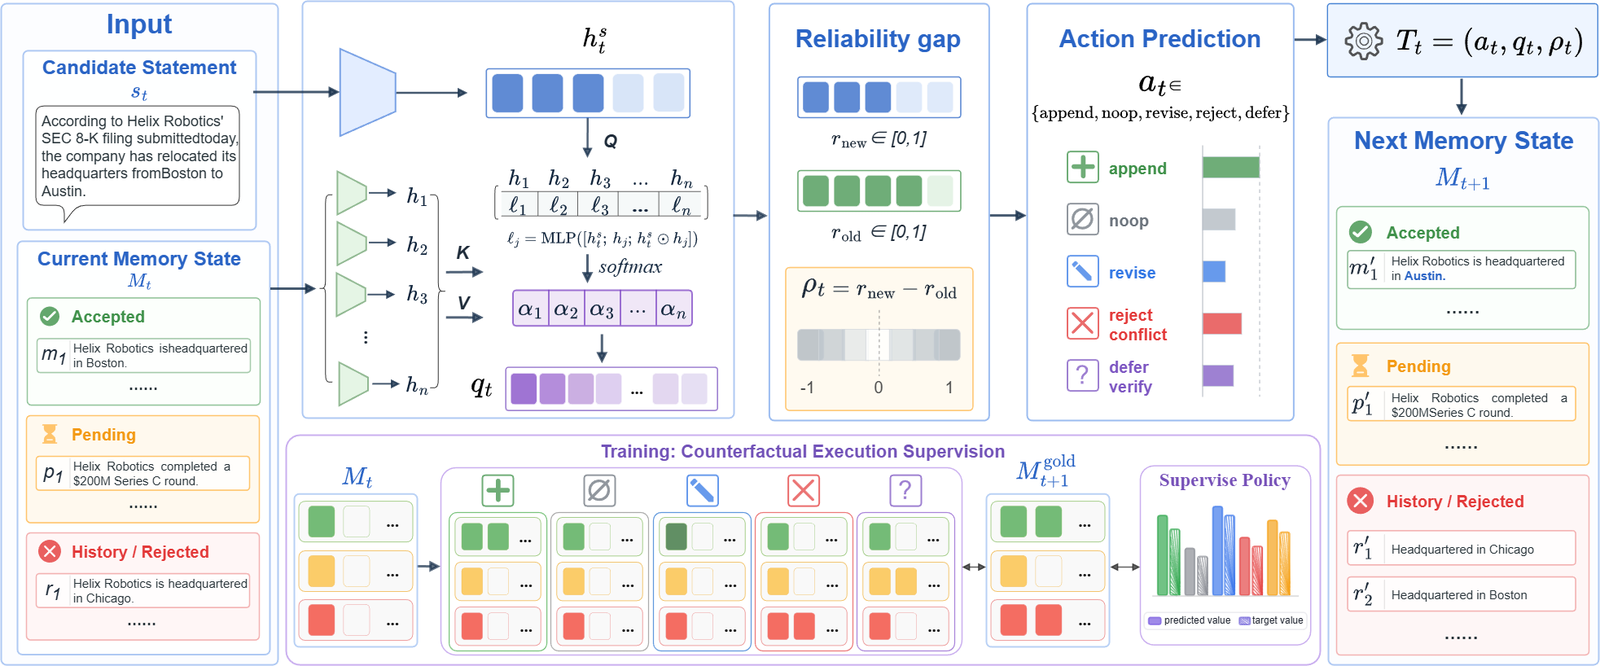
面对一个新输入的陈述 $s_t$,TARL 是如何精准决定其事务归宿的?整个流程在架构上呈现为一个严谨的四阶漏斗:
1. 目标槽位对齐(Target Grounding)
当新事实到达时,模型首先需要检索当前账本中是否存在与之产生语义交叠、互斥或时效覆盖的槽位。TARL 依靠一个可微分的匹配网络 $f_{\mathrm{g}}$ 计算输入与存储槽位的兼容度,并通过 Softmax 输出对齐概率分布 $\alpha_{t,i}$。通过提取概率最大的索引 $\hat{\jmath}_t$,模型明确了潜在的执行目标 $\xi_t$。任何旨在对既有认知进行修改(如 revise)的动作,都必须强行对齐到 Accepted 账本的具体槽位上,防止漫无目的地胡乱修改。
2. 信度与时效显式对抗(Reliability Comparison)
定位到关联记忆后,系统并不能直接判定新的一定优于旧的,必须进行相对信度推断。TARL 将新输入的表征、已定位记忆表征、两者的差值及逐元素乘积拼接后,送入信度评估网络,同时解算出新证据信度 $r_t^{\mathrm{new}}$ 与旧记忆信度 $r_t^{\mathrm{old}}$。
二者的有符号差值构成了一个关键标量——信度裕度(Reliability Margin)$\rho_t = r_t^{\mathrm{new}} - r_t^{\mathrm{old}}$:
-
当 $\rho_t \gg 0$ 时,表明新事实信度显著压倒旧记忆,为
revise提供坚实动力; -
当 $\rho_t \ll 0$ 时,表明新输入大概率是干扰甚至恶意投毒,促使系统触发
reject_conflict; -
当 $\lvert \rho_t \rvert \approx 0$ 时,表明双方势均力敌、无法定夺,动作将自然偏向
defer_verify。
3. 动作策略打分(Operation Valuation)
有了定位信息与信度差值,系统将状态特征与每个动作专属的可学习嵌入 $e_a$ 及执行代码 $\phi(a)$ 联合建模。执行代码编码了动作的目标账本类型、是否强制要求目标槽位、以及对当前活跃记忆的影响规则。通过将执行的先验约束直接注入打分网络 $f_{\mathrm{op}}$,模型在打分的同时就意识到了各个动作可能引发的状态波澜,最终经由 Softmax 导出针对五项事务的概率分布 $p_\theta$。
4. 确定性状态机执行(Deterministic Ledger Execution)
在推理期,系统采取单路执行策略,不产生多分支发散。选定最优动作 $\hat{a}_t$ 与目标参数 $\hat{\xi}_t$ 后,交由无参数的静态执行器 $\operatorname{Exec}$ 完成不可逆的状态变更。确定性执行器彻底规避了大模型自由生成修改后的记忆时常出现的截断、丢字段、幻觉修改等结构性风险。
反事实执行监督:让训练直接感知“走错一步的代价”
在传统的多分类训练中,交叉熵损失(Cross-Entropy)对待错误的惩罚是一视同仁的。但在记忆演化体系里,不同错误的危害度存在天壤之别:
-
如果黄金标签是
noop,模型误判为defer_verify,只是把一条废话扔进了待验证账本,主库并未受损; -
但如果黄金标签是
reject_conflict,模型误判为了revise,这不仅让虚假证据堂而皇之地杀入主库,更将原本完全正确的历史事实彻底抹杀。
普通的分类损失完全无法反映这种灾难性后果。为此,TARL 在训练阶段引入了反事实执行监督(Counterfactual Execution Supervision)。
其运作逻辑非常直接:在训练的前向传播中,系统并不只计算预测动作与真实标签的名字匹配,而是虚拟地把五种动作在当前账本状态上全部试执行一遍,各自推演生成一个反事实的下一个记忆状态 $\widetilde{\mathcal{M}}_{t+1}^{(a)}$。
随后,系统拿这五个生成状态与真实的黄金下一状态 $\mathcal{M}_{t+1}^*$ 进行状态相似度比对打分,得到每个动作诱导出的状态质量得分 $Q_t(a)$。利用温度系数 $\tau$ 对质量得分做归一化,即可构建出一个反事实软目标分布 $\pi_t^{\mathrm{cf}}$:
\[\mathcal{L}_{\mathrm{cf}} = -\sum_{a\in\mathcal{A}} \pi_t^{\mathrm{cf}}(a) \log p_\theta(a \mid s_t, \mathcal{M}_t)\]通过这一机制,那些会导致主库严重污染或关键事实丢失的动作会被赋予极低的分数,模型被强制惩罚那些“致命破坏型”决策,哪怕模型犹豫不决,也更倾向于选择代价最小的近优策略。最关键的是,这种反事实分支仅在训练期用于梯度回传,在推理阶段完全不需要展开分支,零推理开销却换来了更为理智的动作边界。
TARL-Mem 评测体系与实证结果
为了准确评测细粒度记忆更新,研究团队基于 HaluMem-hard、LoCoMo 与 LongMemEval 深度清洗并重构了包含 5,422 个高质量样本的评测基准 TARL-Mem。基准彻底断开了实体与记忆主题层面的交叉泄漏,每个样本均配齐了五分类动作标签、对应槽位索引以及可执行验证的黄金下一状态。
在对比实验中,TARL 与包括全历史上下文(Full History)、检索增强(LongMemEval)、图记忆系统(HippoRAG、G-Memory)、持久自适应记忆(MemoryBank、A-Mem)以及循环记忆(MemAgent)在内的 7 种代表性架构展开对决。
从主要指标对比来看,TARL 展现出极其全面的性能压制:
-
动作与状态恢复:TARL 在 5 分类 Macro F1 上达到 0.8286,显著高出此前最好的基线(0.7887);在更为严苛的下一个记忆状态精确匹配率($\mathrm{Acc}_{\mathrm{state}}$)上,TARL 达到了 0.6621,而主流基线普遍在 0.54 至 0.63 之间徘徊。
-
记忆污染控制:在记忆污染率($\mathrm{Pollution}$,即未经验证或错误信息非法潜入 Accepted 账本的比例)方面,TARL 压低至 0.2524,而对比模型此项指标多在 0.28 至 0.34 之间。
-
对抗性冲突保留:在冲突保留率($\mathrm{Pres}_{\mathrm{conf}}$)上,TARL 达到 0.5476,不仅能守住正确记忆,还能准确将恶意输入识别并压入 Rejected 账本。
-
模型置信度校准:TARL 的期望校准误差(ECE)仅为 0.0369,相比大部分处于 0.10 以上的基线,呈现出高度可靠的概率输出能力。
研究团队还特意验证了“二元写入的局限性”。实验显示,直接使用黄金二元标签(Gold Binary)执行,冲突保留率为尴尬的 0.0000,状态准确率仅有 0.2860;即便人工堆叠各种复杂的启发式规则,状态恢复率也仅能勉强拉升至 0.4539。唯有显式采用五分类可执行机制,才能完全打通状态恢复的理论天花板。
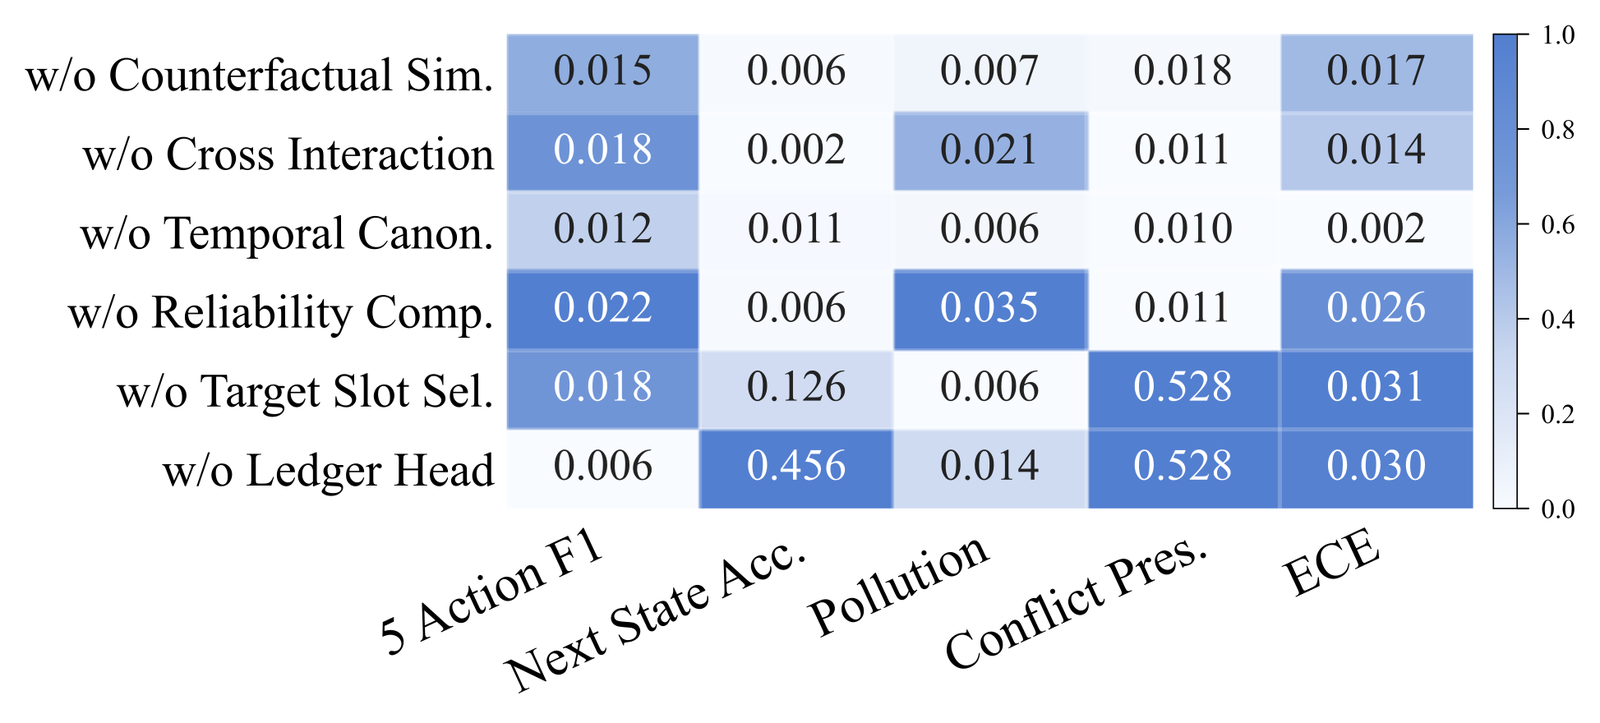
通过消融实验可以清晰透视 TARL 内部各模块的职责划分:
-
剥离目标槽位定位模块(Target Grounding)或账本执行头,五分类动作 F1 虽下降有限,但状态恢复准确率与冲突保留率出现崩塌式下跌。这证明:猜对动作名不等于改对状态,没有精准的目标槽位锚定,正确的操作指令也会酿成错改乱删的事故。
-
剥离信度比对模块(Reliability Comparator),模型的动作区分度急剧下滑,记忆污染率大幅飙升,印证了显式计算正负信度裕度是抵御污染防火墙的最核心底座。
-
移除反事实监督后,模型的校准误差大幅反弹,面对模糊样例时犯下破坏性大错的频率明显上升。
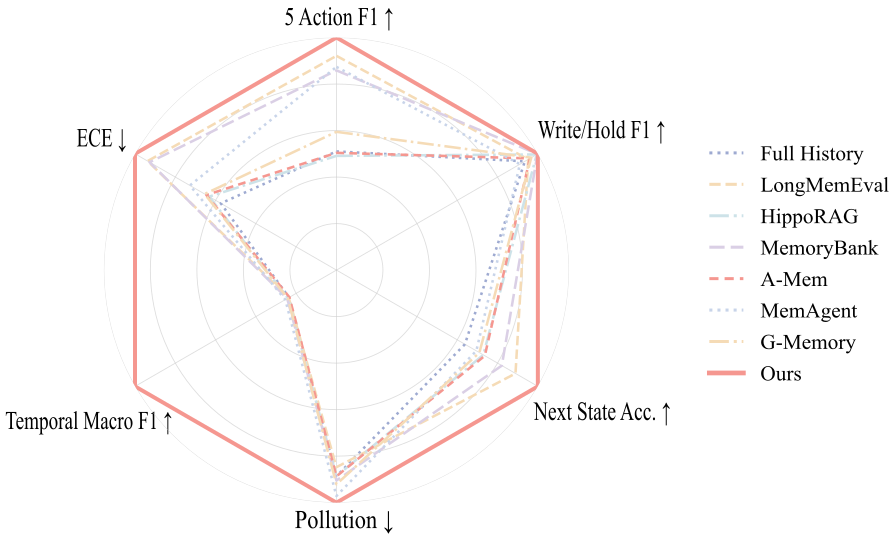
在跨数据源迁移测试中(直接迁移至从未见过的 LoCoMo 构建的数据分布),TARL 在五动作 F1、时效理解(Temporal F1)、状态恢复率及校准指标上保持了极强的领先轮廓。这表明 TARL 习得的并非特定数据集的对话套路,而是一种普遍适用的记忆事务演进逻辑。
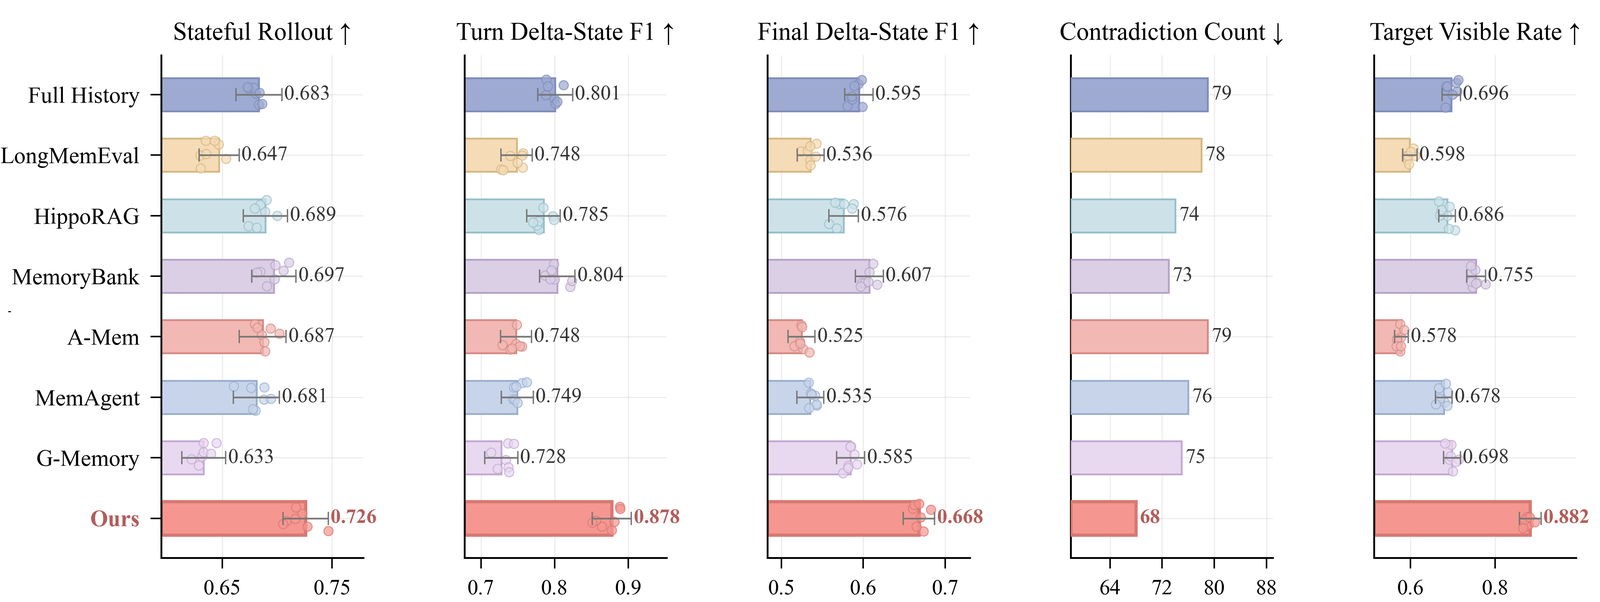
决胜长程任务:滚雪球式累积误差被真正遏制
评估长期智能体最严苛的场景当属顺序自回归展开(Sequential Rollout):模型在第 $t$ 步执行更新后生成的账本,会不经任何外部清洗、原封不动地作为第 $t+1$ 步的输入记忆环境。任何微小的失误都会在此阶段持续发酵,造成“步步错、层层错”的认知崩溃。
在长程推演测试中,各对比基线的状态匹配度随轮次增加呈断崖式下跌,主库中的矛盾事实与幻觉垃圾成倍膨胀。而 TARL 凭借三账本天然的“污染隔离带”以及对冲突历史的留存溯源,成功维持住了极高的中间与最终状态准确率,目标事实在长周期下的可见性依然充沛。这意味着,系统既没有因为保守而遗失用户的新更新,也没有因为激进更新而让不受信的内容侵蚀既有知识库。
总结与展望
智能体的长期记忆不能再被当作一个只管往里塞文本的简单向量仓库。厦门大学这项关于 TARL 的研究深刻揭示了一个核心问题:记忆更新本质上是复杂的数据库事务,二元写入抽象从根本上丢失了构建正确记忆状态的完备语义。
通过将输入严格映射到五类可执行动作,在 Accepted、Pending、Rejected 三套账本之间建立受控的状态转移管道,并辅以反事实执行监督,TARL 为智能体构建了一个兼具防御性与自愈能力的记忆中枢。这种将“状态转移后果”直接反哺给“策略学习”的思路,跳出了单纯卷上下文长度与密集向量召回的旧路线,为构建真正高可靠、可自洽演化的高阶长程自主智能体提供了极具价值的技术范式。