PRECOG:端侧RAG延迟从27秒降至6毫秒,O(1)状态注入实现4500倍提速
Structured Memory for Edge Language Models: Persistent Context and Corpus Retrieval via O(1) SSM State Injection
在大语言模型落地端侧设备(如手机、PC、机器人以及各类智能硬件)的过程中,检索增强生成(RAG)始终面临一个尴尬的物理瓶颈:预填充(Prefill)阶段的吞吐受限与能耗爆炸。当系统从外部知识库中检索出数百甚至数千 Token 的文档上下文时,端侧芯片必须将整段上下文重新逐字读入模型,这一过程的计算开销与检索上下文长度 $L_{\text{context}}$ 呈线性关系。在算力受限的边缘硬件上,仅仅为了“读完”一篇 512 Token 的召回文档,用户就要对着空白屏幕等待近半分钟。
ArXiv URL:https://arxiv.org/abs/2608.02560
这一瓶颈在 Transformer 架构中几乎无解,因为其注意力机制深度依赖随长度线性膨胀且与绝对位置绑定的键值缓存(KV-Cache)。这项来自神经形态硬件与边缘 AI 领域的研究,提出了名为 PRECOG(Pre-Computed Context Injection,预计算上下文注入)的检索机制,以及面向长期设备记忆的 SMC(Structured Memory Consolidation,结构化记忆整合)架构,彻底跳出了 Transformer 的思维定势。
PRECOG 利用了状态空间模型(State-Space Models, SSM)所独有的“定长且位置无关”的循环隐状态特性,将 RAG 的上下文灌入成本从 $O(L_{\text{context}})$ 直接压缩至 $O(1)$。在 1.2B 参数的门控状态空间模型 TENNs-LLM 上,该方案在数学上严格等价于标准上下文 RAG,同时将边缘端设备的首字延迟从约 27 秒降低到 6 毫秒以内,实现了约 4500 倍的提速。这不仅是一次单纯的工程优化,更指出了非注意力架构在边缘智能与终身记忆系统中的独特代数优势。
端侧 RAG 的困境与 Transformer 的结构死结
传统 RAG 系统的标准链路是:针对用户提问检索相关文档切片,将文档拼接到 Prompt 中,再由模型完成两步推理——先对整个超长上下文进行前向预填充,再逐字生成回答。在云端高端 GPU 上,极高的显存带宽掩盖了预填充的耗时;但在计算资源、内存带宽和能耗受到严格限制的端侧芯片上,情况截然不同。对于一个 1.2B 参数的模型,在边缘硬件的处理吞吐下,仅消化一个 512 Token 的段落就需要耗费约 27 秒,这直接让端侧交互体验处于完全不可用的状态。
有人曾设想过类似云端的方案:能否在离线阶段把文档预先跑一遍,将其内部表征缓存起来,查询时直接复用?对于基于 Transformer 架构的模型而言,这在数学上是行不通的。
主流 Transformer 依赖旋转位置编码(RoPE)或绝对位置编码。每一层生成的 Key 和 Value 向量都打上了与绝对时间步 $t$ 绑定的旋转因子,即 $K_t = R(t) W_K x_t$。这意味着在位置 $0$ 到 $L-1$ 处离线计算好的 KV-Cache,根本无法被直接嫁接到位于不同上下文偏移量的查询前面。如果要把离线缓存的位置转变为当前会话的位置,本质上就必须重新执行前向计算,预填充的时间根本无法省去。
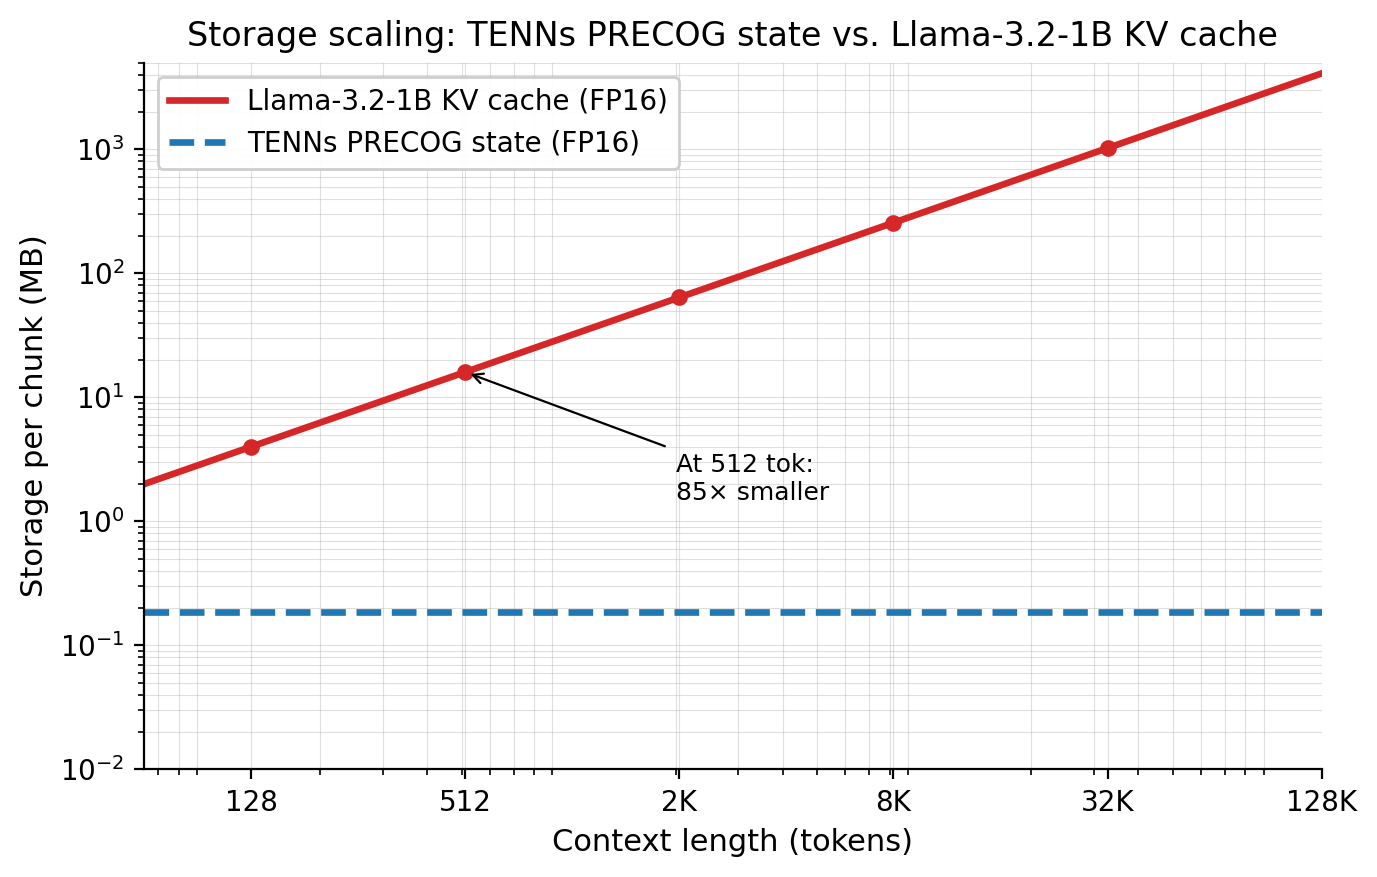
更致命的是存储开销。Transformer 的 KV-Cache 大小与文档长度成正比。以一个标准的 24 层模型为例,仅仅存储一个 512 Token 的切片,其 KV-Cache 就需要消耗约 16 MB 显存;若上下文达到 3000 Token,单切片的存储量将飙升至数百兆字节。在一个包含 10000 个文档切片的边缘知识库中,仅存储预计算的 KV-Cache 就需要 160 GB 的闪存空间,这在手机或嵌入式硬件上毫无可行性。
核心机制:时间平移不变性与 O(1) 隐状态注入
与注意力机制不同,状态空间模型(以 S4、Mamba、RWKV 以及本研究采用的 TENNs-LLM 为代表)采用了循环神经网络式的时域演化形式。在离散化后,SSM 的隐状态演化可以抽象表示为:
\[\bar{h}_t = \bar{h}_{t-1} \cdot \exp(-\Delta t_t \cdot A) + B_t \cdot x_t \cdot \Delta t_t\]这表明隐状态的转移映射 $\Phi(h, x) := h \odot \alpha(x) + \beta(x)$ 仅取决于当前的隐状态 $h$ 和输入的当前 Token $x$,其中完全没有任何对绝对时间位置 $t$ 的显式依赖。隐状态 $\bar{h}$ 是一个固定大小、与位置无关的紧凑向量。它编码的是模型“读过了什么”,而不是“在哪个具体位置读的”。
PRECOG 的构想正是基于这一数学特性:既然读完一段文档后的隐状态是对该文本的完整充分统计,那为什么不直接在离线阶段将文档压缩成这个隐状态,在线检索时直接灌入模型的寄存器中?
PRECOG 的具体运行流程分为两步:
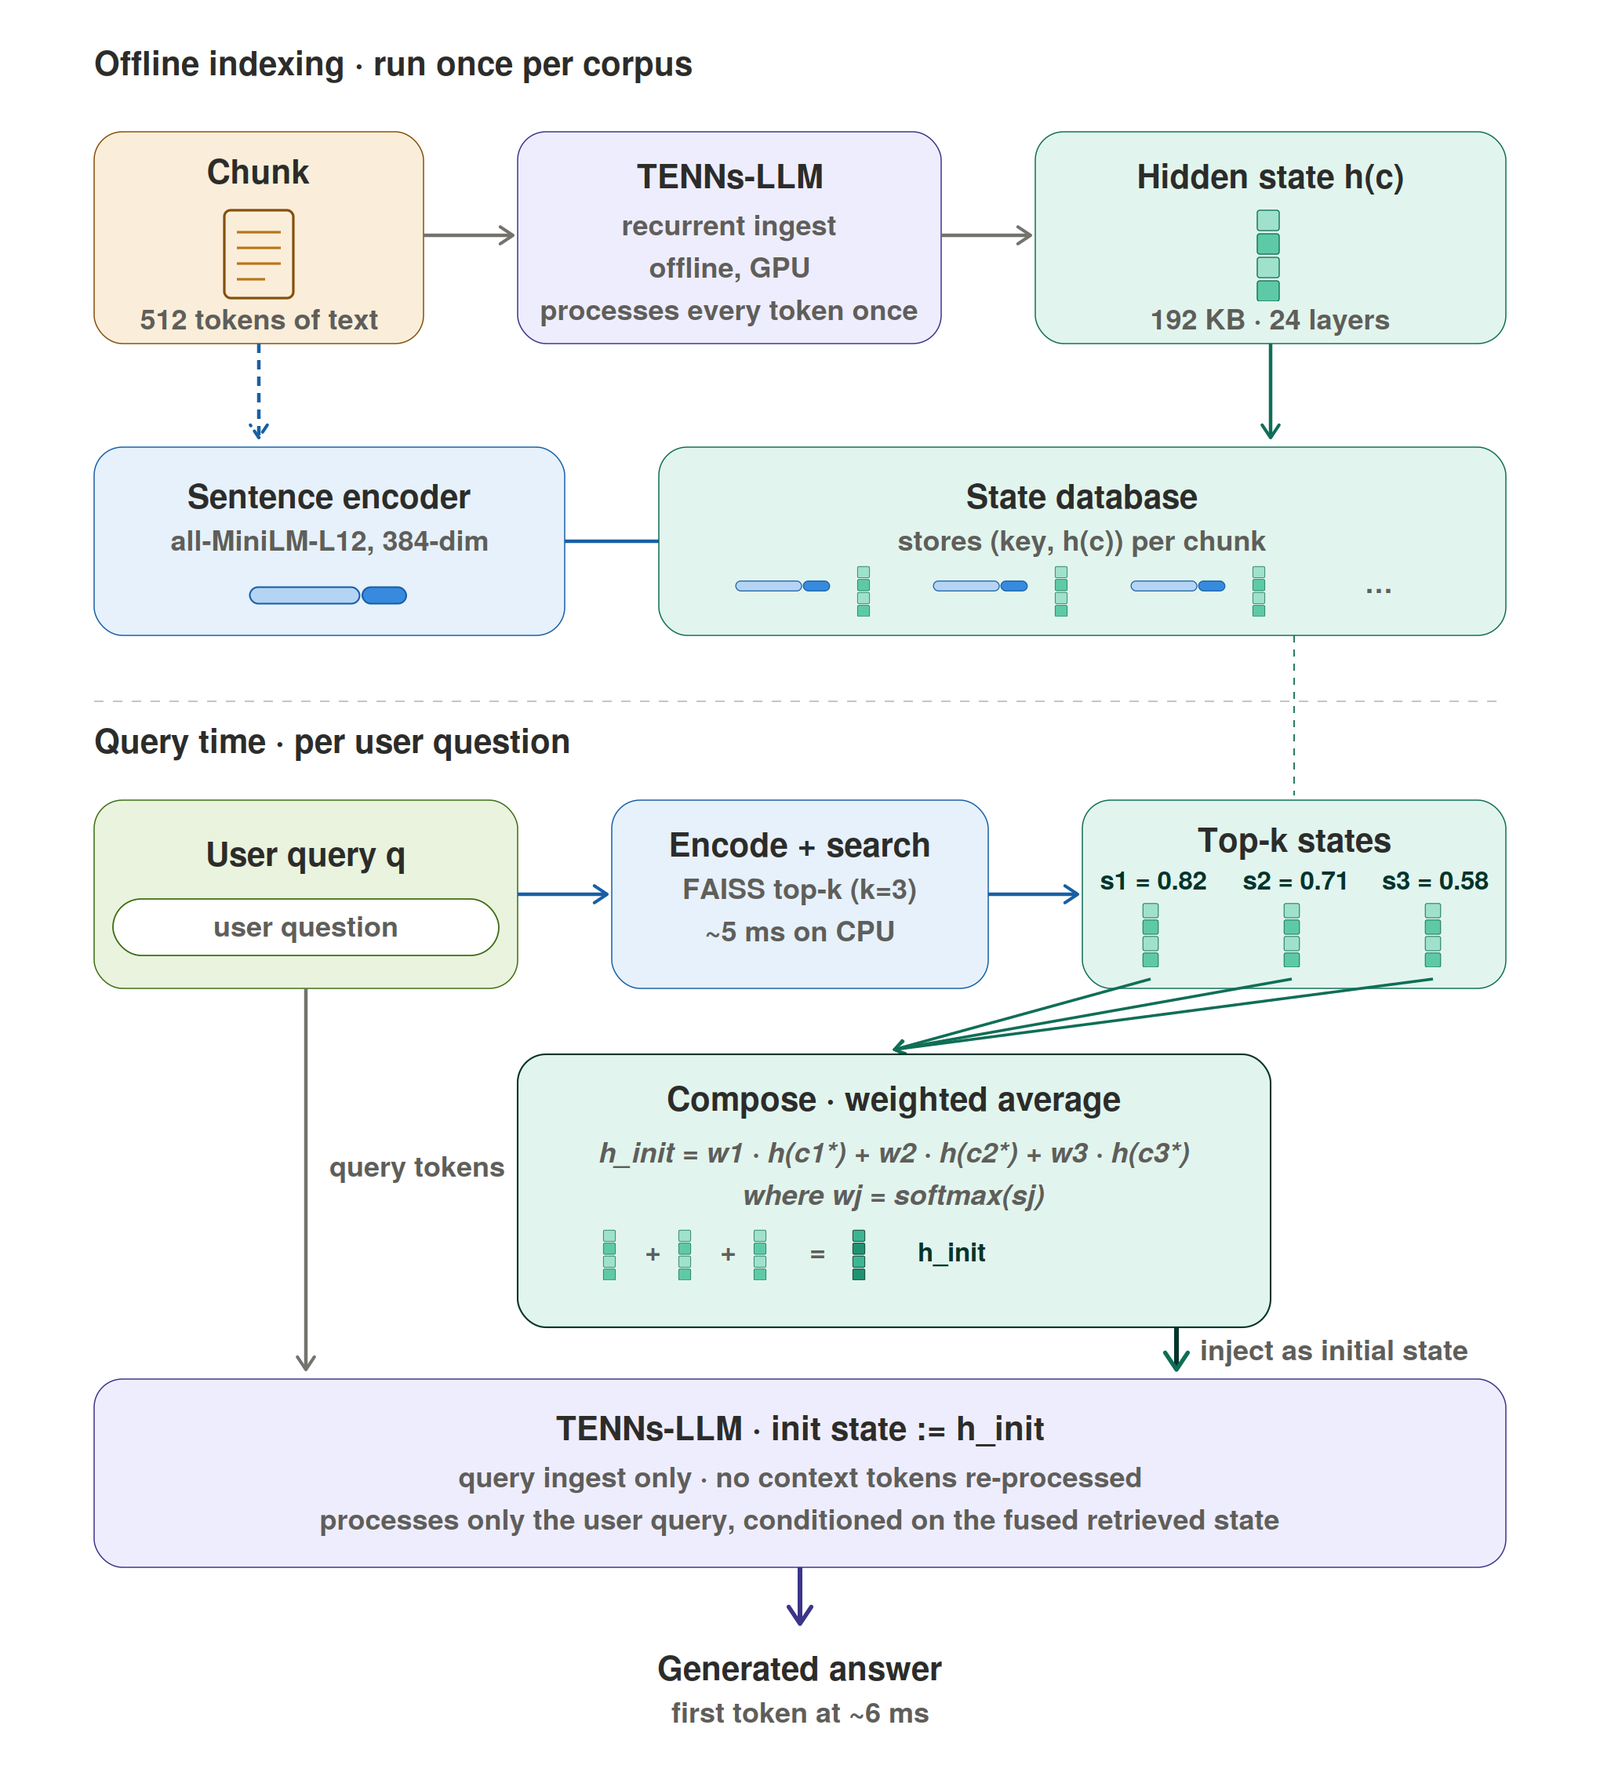
在离线索引阶段,系统将文档切分为若干片段,将每个片段独立输入 SSM 运行一次推理,直接抓取最后一层演化完成的全局循环隐状态。在 1.2B 参数的 TENNs-LLM 中,24 层模型在 FP16 精度下的总隐状态体积仅有 192 KB。同时,使用轻量级句子编码器(如 all-MiniLM-L12-v2)提取切片的 384 维语义向量作为检索键。语义键驻留在内存中并构建 FAISS 索引,而 192 KB 的隐状态则直接序列化保存在闪存中。
在线查询阶段,系统在收到用户提问 $q$ 后,先用句子编码器提取查询向量,在内存中完成极速检索,锁定最匹配的切片;随后仅需将该切片对应的 192 KB 隐状态直接从闪存映射并拷贝至模型的循环缓冲区中,将其作为初始状态:
\[\bar{h}^{\text{init}}_\ell \leftarrow \bar{h}^{(i^\star)}_\ell, \quad \ell = 1, \dots, 24\]此时,模型完全跳过了对文档切片的逐字读取,而是直接以该上下文隐状态为起点,仅计算用户 Query 的前向过程。从检索完成到吐出第一个 Token,全流程仅包含编码器推理(约 5 ms)、向量检索($<1$ ms)、闪存传输(约 50 $\mu$s)以及状态缓冲区的向量复制($<1$ ms),总耗时控制在 6 毫秒以内。
更关键的是,研究团队证明了 PRECOG 与传统上下文 RAG 的严格代数等价性(Theorem 1)。由于 SSM 演化算子具备时间平移不变性,对于任意初始状态 $h_0$、上下文 $c$ 与查询 $q$,满足:
\[\mathcal{S}(h_0, \; c \oplus q) = \mathcal{S}\bigl(\mathcal{S}(h_0, c), \; q\bigr)\]其中 $\oplus$ 代表文本拼接。这意味着,离线跑完文档再以该状态接入提问,其内部产生的状态轨迹与在线一口气读完“文档+提问”的状态轨迹在数值上是完全恒等的(仅受限于极微小的浮点量化误差)。PRECOG 匹配标准 RAG 的回答质量不是经验性的拟合结果,而是由模型底层的代数结构直接保证的数学必然。
从 27 秒到 6 毫秒:边缘硬件上的真实表现
这种代数层面的重构,在实际边缘硬件上转化成了颠覆性的性能跃迁。针对存储与计算开销,论文对比了传统 Transformer KV 缓存方案与基于 SSM 状态注入的 PRECOG 方案。
从存储体积来看,无论文档片段包含 512 Token 还是 3000 Token,PRECOG 产生的隐状态都严格锚定在 192 KB。面对一个拥有 1 万个切片的本地知识库,PRECOG 占用的磁盘总空间仅为 1.9 GB,这对于普通智能手机的闪存而言轻而易举;而即便是 512 Token 的 Transformer KV 缓存,在同样规模下也需要消耗 160 GB,如果上下文放宽到 3000 Token,存储更会膨胀到近 1 TB,彻底封死了在本地端侧预存知识的可能性。
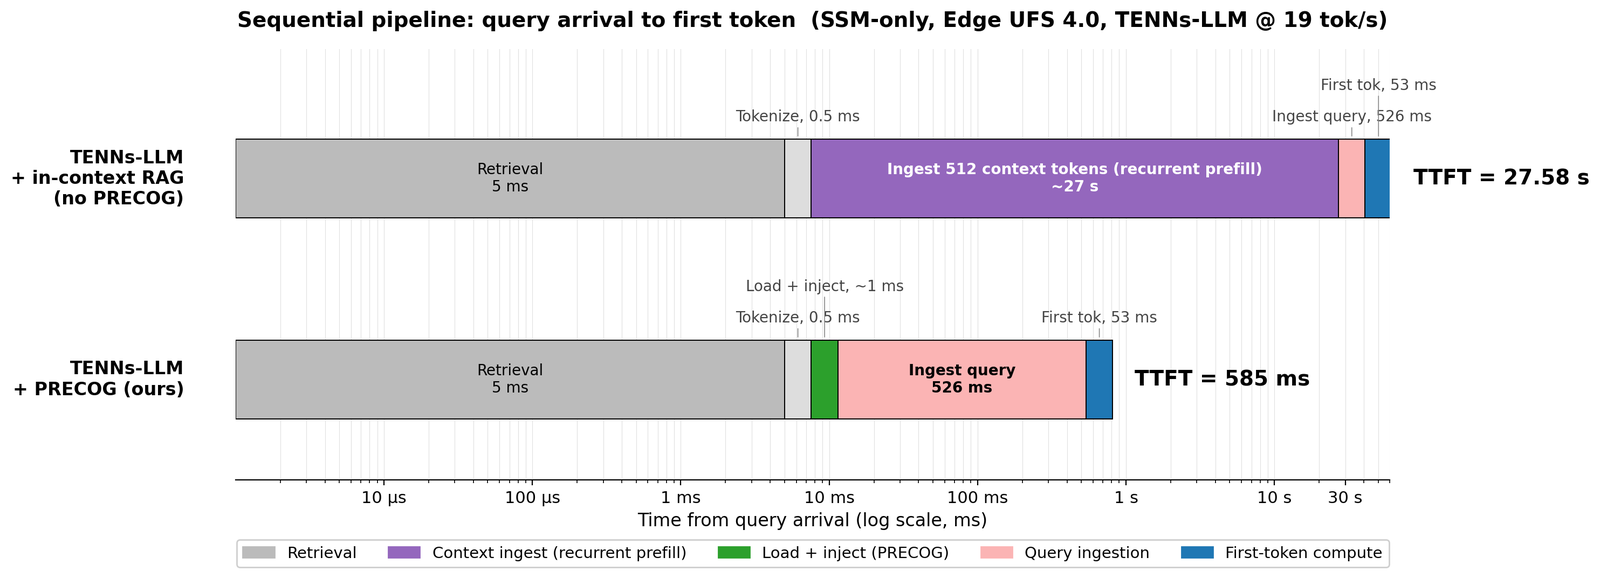
在时延方面,上图展示了模型在处理查询时各环节的耗时对比。传统方案必须经历漫长的上下文读取阶段,随着上下文 Token 数量从几十增加到几千,预填充耗时一路攀升至数十秒级别;而在 PRECOG 体系下,无论检索到的切片篇幅有多长,预填充过程被一步到位的状态覆写所取代。实际测量显示,系统从接收到输入到发出首个 Token 的时间开销恒定在 6 毫秒左右,将端侧原本停滞在 27 秒的无响应等待直接拉进了实时对话区间。
对于多文档召回的场景,作者还探索了 Top-$k$ 状态融合扩展。当检索出多个相关切片时,系统通过检索打分的 Softmax 权重,对多个 192 KB 的隐状态进行线性加权平均:
\[\bar{h}^{\text{init}} = \sum_{j=1}^k w_j \bar{h}^{(j)}\]虽然非线性门控的存在使得多切片加权不再具备定理 1 的严格位等价性,但在实测中,这种启发式融合不仅没有破坏模型的生成能力,反而展现出了良好的多源信息综合表征效果。
扩展应用:结构化记忆整合(SMC)与终身设备智能
如果状态注入仅仅用于静态文档检索,它的潜力还远未被挖掘完全。对于手机操作系统、车载车机或智能家居等边缘设备而言,模型更迫切的需求是构建一套长期演进的设备记忆(Persistent Context)——记录用户的操作习惯、偏好设定、历史对话以及系统日志。
基于同一套状态注入机制,论文进一步提出了 SMC(Structured Memory Consolidation,结构化记忆整合)。既然过去交互产生的最终隐状态可以完整沉淀上下文,那么会话的演进本质上就是隐状态的沉淀与演变过程。SMC 构建了一套分层的长期记忆管理系统,包含三项核心设计:
-
认知域聚类路由(Hierarchical Cluster Routing):系统建立了两级聚类树,第一级识别认知大类,第二级识别细分模式。会话切片在推理后,根据语义键路由到特定的子簇中。子簇被区分为强调精准细节回忆的 Type-A(事件型)与强调宏观背景稳定的 Type-B(语义型)。
-
保真度与存储权衡滑钮(Fidelity-vs-Storage Dial):模型在处理会话时会产生一段状态演化轨迹 $\bar{H}(c) = (\bar{h}1, \dots, \bar{h}{N_c})$。为了避免长期存储爆满,SMC 引入参数 $K$ 来灵活调节保留策略。在无损情境下可保留全部状态;在常规场景下以采样步长 $k$ 间隔保留;在高度抽象的语义场景下,仅保留切片结束时的单个最终状态($K=1$),此时单切片占用仅为 192 KB。
-
语义整合与 $O(1)$ 会话初始化:每个子簇通过指数移动平均(EMA)维护一个全局的语义状态向量 $s_{m, j}$。当新切片进入时,其最终状态会被平滑吸纳进全局语义中:
\[s_{m, j} \leftarrow (1-\alpha) s_{m, j} + \alpha \bar{h}^{(c)}\]当设备开启新会话或用户输入开场白时,系统通过语义匹配快速定位主导子簇,将沉淀了该领域长期历史的 $s_{m, j}$ 一键注入 SSM 寄存器,实现真正的 $O(1)$ 会话初始化。长期记忆与临时检索到的文档状态甚至可以在输入层直接进行线性融合,使边缘模型在完全没有上下文重新加载开销的前提下,同时拥有长期个性化记忆与外挂精准知识。
架构取舍与深层启示
必须客观指出,PRECOG 和 SMC 机制能够成立,存在一个前提约束:模型的记忆衰减曲线。在理论分析中,研究者指出 SSM 的展开形式决定了早期上下文 Token 对最终隐状态的贡献遵循指数级衰减。如果一个文档切片过长,超出模型的有效记忆长度 $L_{\text{mem}}$,位于切片最前端的信息在隐状态中的信噪比就会下降。但正如作者所强调的,这一衰减是底层 SSM 模型固有的物理属性,即使使用标准的上下文拼接 RAG,模型在读到末尾时同样会遗忘最前端的细节。PRECOG 既没有创造额外的信息损失,也没有凭空增强长程记忆,而是精确地继承了模型原生的信息承载能力。
这项研究为端侧大模型的落地路径提供了极为重要的启示。长久以来,工业界普遍陷入了“云端使用 Transformer,边缘端也只能用剪枝量化版 Transformer”的思维定势,导致端侧系统为了维持庞大而低效的 KV-Cache 疲于奔命。
PRECOG 与 SMC 证明了:非注意力架构的价值不仅在于更低的推理复杂度,更在于其代数性质所带来的全新系统范式。定长、位置无关的循环隐状态,打破了上下文必须在推理时按顺序实时解构的教条。当一段知识被读过一次后,它可以被物化为模型内部的一个静态状态切片,随时在毫秒内唤醒与热插拔。随着具备选择性状态空间的线性循环模型不断演进,这种将检索、长期记忆与生成计算完全统一在隐状态空间内的设计,很可能成为未来端侧智能设备与自主 Agent 的标准系统底座。