零阶优化破解智能体自进化瓶颈:困难样本成功率从22%跃升至54%
Beyond the Capability Boundary: Zeroth-Order Optimization for Self-Evolving LLM Agents
在大模型智能体(LLM Agent)的研究中,“自进化”(Self-Evolution)一直被寄予厚望。研究者普遍希望智能体能够像人类一样,在没有海量昂贵中间推理标注的前提下,通过与环境交互自我采样、自我反思,再利用有监督微调(SFT)或强化学习(RL)实现能力的闭环迭代。然而,这条看似优美的路线很快在实际落地中撞上了死胡同:智能体根本无法突破其原生的能力边界。
ArXiv URL:https://arxiv.org/abs/2608.09292v1
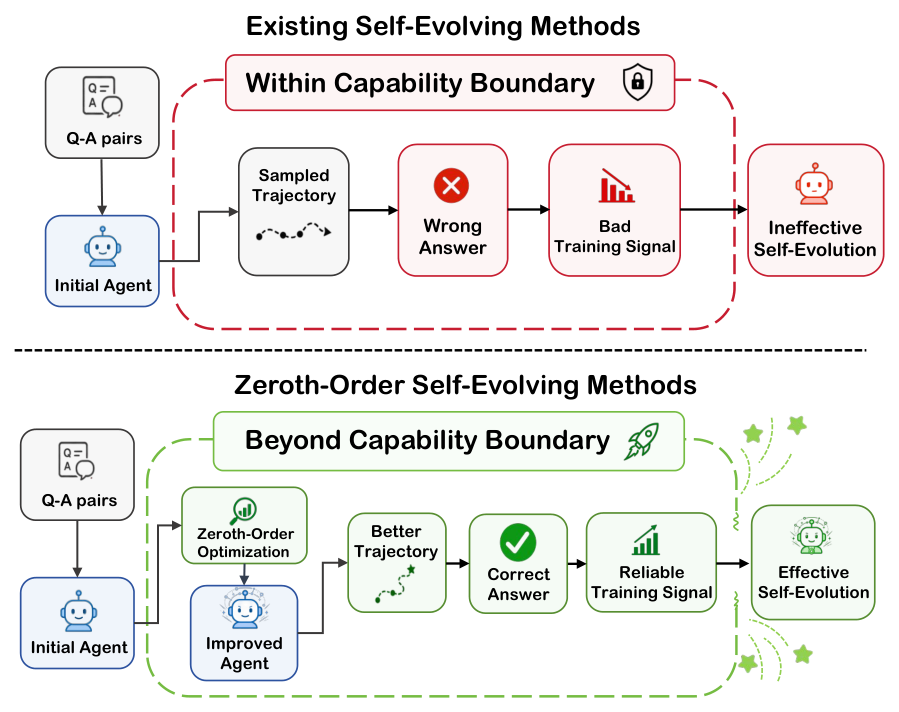
在复杂的信息检索与深度推理任务中,面对真正困难的样本,当前的智能体往往无论采样多少次,输出的全都是失败轨迹。如果强行用失败轨迹做有监督训练,只会固化错误的工具调用与荒谬的幻觉;而强化学习在所有采样全部失败、奖励全为零或 baseline 的情况下,策略梯度直接塌缩为零向量,进化就此陷入死锁。
为了打破这一“能力天花板”,来自北京理工大学和深圳北理莫斯科大学的研究团队提出了一种全新的零阶自进化框架。该方法彻底跳出了“必须先采出正确轨迹才能训练”的传统思维,而是对大模型的 LoRA 参数施加微小扰动,仅依据最终答案计算连续的困惑度损失差,利用零阶优化(Zeroth-Order Optimization)直接估计参数梯度并更新特定样本的模型权重。通过这种方式,智能体被主动“推”出了原有的行为边界,成功在原本无法解决的困难样本上探索出高质量的解题轨迹,再反哺全局模型。实验表明,该方法在困难样本上的求解成功率从 22.0% 飙升至 53.9%,实现了 31.9 个百分点的实质性突破。
自进化的死锁:为什么传统 RL 和 SFT 救不了困难样本?
要理解这项工作的切入点,必须先剖析现有自进化智能体在数学上的硬伤。
在一个多轮交互的环境 $\mathcal{T}$ 中,智能体策略 $\boldsymbol{\pi_\theta}$ 针对查询 $q$ 生成包含思考、动作和环境反馈的完整轨迹 $\tau = (r_1, a_1, o_1, \ldots, r_T, a_T, o_T, \hat{y})$。在只有最终问答对 $(q, y)$、没有中间标准轨迹的无监督自进化设定下,系统的优化目标本质上是期望损失最小化:
\[F(\boldsymbol{\theta})=\mathbb{E}_{(q,y)\sim\mathcal{D}}\mathbb{E}_{\tau\sim p_{\boldsymbol{\theta}}(\cdot\mid q,\mathcal{T})}\left[\ell(\boldsymbol{\theta};q,\tau,y)\right]\]对该目标求导后,总梯度可以拆解为两项:
\[\nabla_{\boldsymbol{\theta}}F(\boldsymbol{\theta}) = \boldsymbol{g}_{\mathrm{fixed}} + \boldsymbol{g}_{\mathrm{traj}}\]其中,$\boldsymbol{g}{\mathrm{fixed}} = \mathbb{E}{\tau}\left[\nabla_{\boldsymbol{\theta}}\ell(\boldsymbol{\theta};q,\tau,y)\right]$ 代表轨迹固定时、针对模型在这些 token 上计算损失的反向传播项;而 $\boldsymbol{g}{\mathrm{traj}} = \mathbb{E}{\tau}\left[\ell(\boldsymbol{\theta};q,\tau,y) \cdot \nabla_{\boldsymbol{\theta}}\log p_{\boldsymbol{\theta}}(\tau\mid q,\mathcal{T})\right]$ 则是由于参数改变引起采样分布偏移而产生的策略梯度项。
在传统做法中,如果使用固定轨迹的一阶优化(First-Order, FO),系统只能拿着模型自己采出的错误轨迹 $\tau^-$ 去对参考答案做计算。然而,这会导致严重的逻辑断层:轨迹里的网页查询、数据筛选全都是错的,强行让模型在错误上下文后预测正确答案,梯度只会把模型带偏。
那么转向强化学习(RL)呢?强化学习通常用轨迹级奖励 $R(\tau_i)$ 与 baseline $b$ 的差值来更新策略:
\[\widehat{\boldsymbol{g}}_{\mathrm{RL}}=\frac{1}{M}\sum_{i=1}^{M}\left(R(\tau_{i})-b\right)\nabla_{\boldsymbol{\theta}}\log p_{\boldsymbol{\theta}}(\tau_{i}\mid q,\mathcal{T})\]问题恰恰在于困难样本的采样空间中完全没有正向信号。当基线模型在某个复杂问题上面对庞大搜索空间时,连续采样数十次的结果全部失败,所有轨迹的奖励 $R(\tau_i)$ 全部等于保底常数 $b$。此时,$R(\tau_i) - b = 0$,策略梯度 $\widehat{\boldsymbol{g}}_{\mathrm{RL}}$ 直接退化为零向量。智能体在最需要学习的地方,反而失去了任何优化推力。
换句话说,现有方法只能在模型“已经能够偶尔撞对”的区域内做胜率增强,而无法跨越到“当前完全做不对”的未知疆界。
零阶优化如何实现“盲探破局”?
由于环境交互是离散且不可微的黑盒过程,无法直接对轨迹生成求导,作者团队将视角转向了零阶优化(Zeroth-Order Optimization)。
零阶优化的核心哲学在于:不需要反向传播,仅通过观测输入微小扰动引起的输出标量函数值变化,利用有限差分来重构梯度。在经典优化理论中,双边或单边差分能够以极小代价逼近真实梯度:
\[\hat{g}(\boldsymbol{\theta})=\frac{F(\boldsymbol{\theta}+\mu\boldsymbol{u})-F(\boldsymbol{\theta})}{\mu}\boldsymbol{u}\]但在大模型智能体上直接套用零阶优化,面临着巨大的参数维度灾难——全量参数的扰动空间过大,方差会导致梯度估计彻底失效。为此,本文提出为每个困难样本单独挂载一个特定样本的 LoRA 模块(由低秩矩阵 $\boldsymbol{A}_i$ 与 $\boldsymbol{B}_i$ 组成),只在极小的参数子空间内施加高斯随机扰动:
\[\boldsymbol{\theta}_{i,k}^{p}=\boldsymbol{\theta}+(\boldsymbol{B}_{i}+\sigma\boldsymbol{\epsilon}^{B}_{i,k})(\boldsymbol{A}_{i}+\sigma\boldsymbol{\epsilon}^{A}_{i,k})\]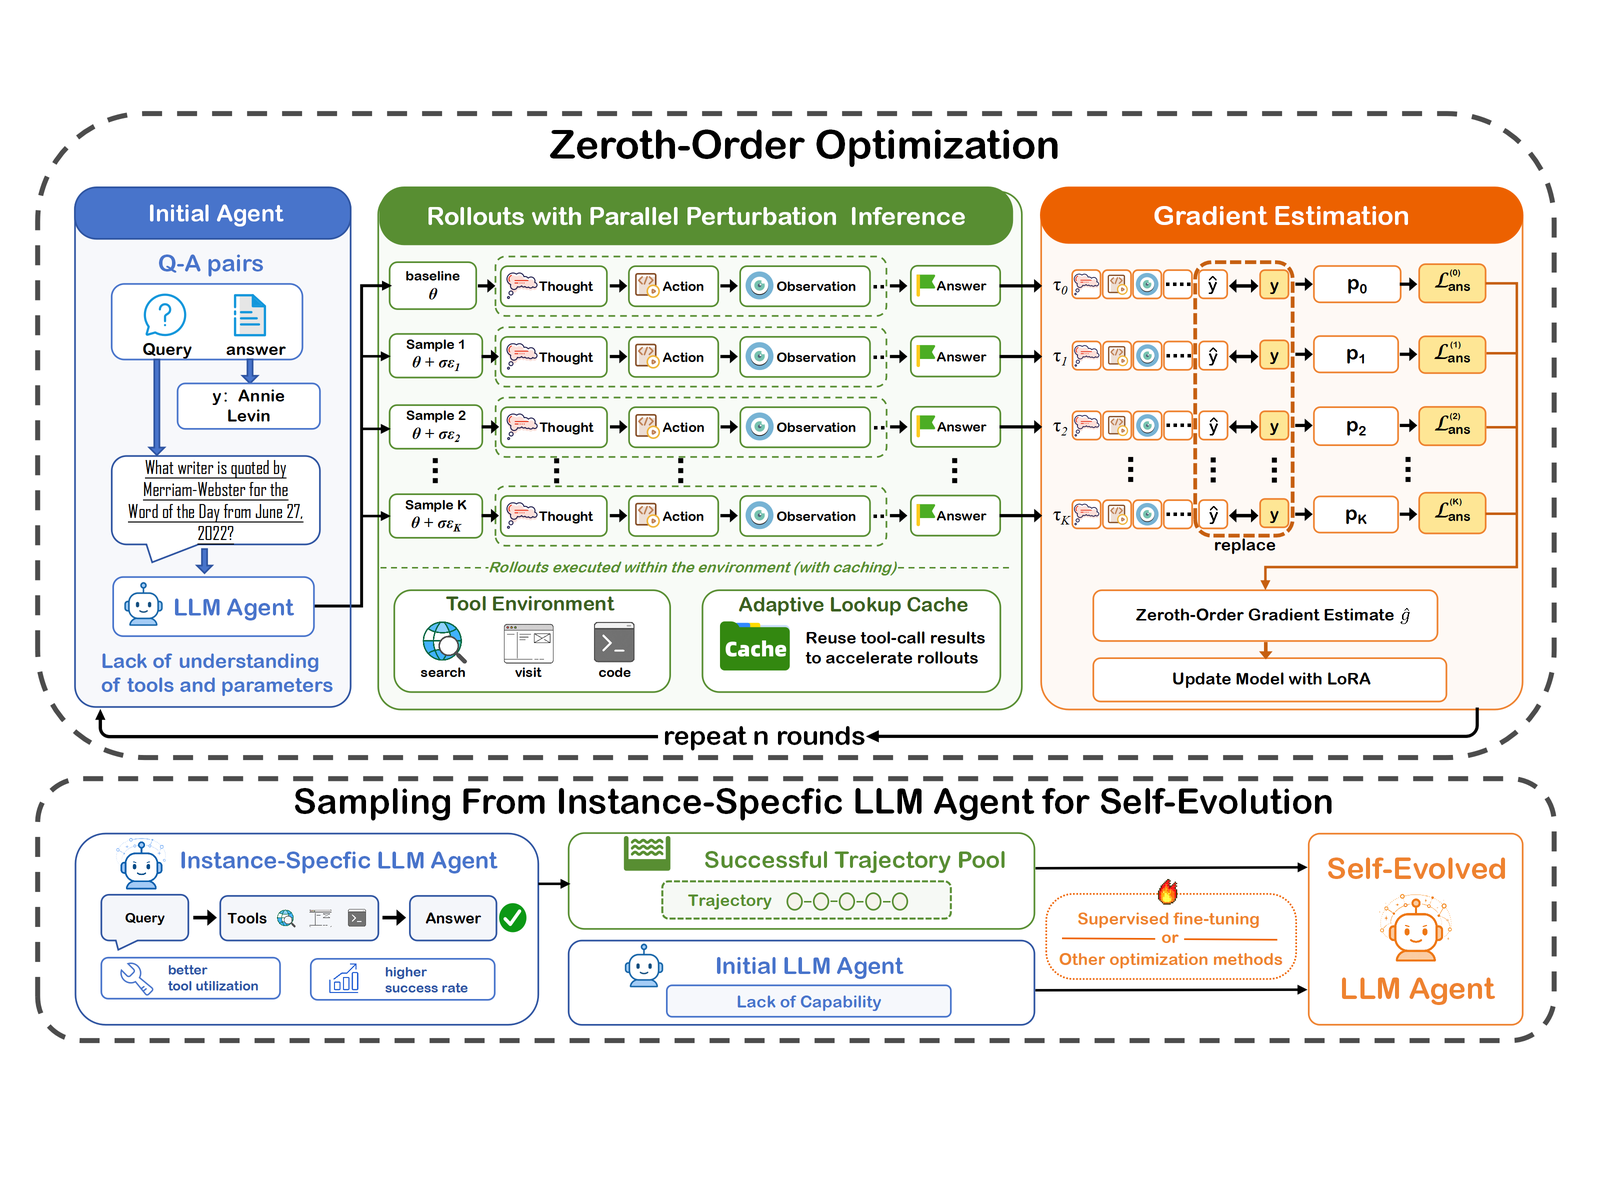
整体流程形成了一个精妙的闭环:
-
参数扰动与前向探索:对于困难样本 $q_i$,生成 $K$ 个不同的微小扰动方向,得到扰动后的策略模型,并在非可微的工具环境中分别自主运行智能体,获得各自的完整交互轨迹 $\tau_{i,k}^+$。
-
零阶梯度重构:计算扰动模型与原始未扰动模型在参考答案上的标量损失差异($\ell_{i,k}^+ - \ell_i^0$),并据此构建梯度估计值:
\[\hat{g}(\boldsymbol{A}_i)=\frac{1}{K}\sum_{k=1}^{K}\frac{\ell_{i,k}^{+}-\ell_{i}^{0}}{\sigma}\boldsymbol{\epsilon}_{i,k}^{A}, \quad \hat{g}(\boldsymbol{B}_i)=\frac{1}{K}\sum_{k=1}^{K}\frac{\ell_{i,k}^{+}-\ell_{i}^{0}}{\sigma}\boldsymbol{\epsilon}_{i,k}^{B}\] -
定向更新与轨迹入库:利用 Adam 优化器更新针对该题目的 LoRA 参数。当某个扰动方向降低了答案损失,优化器便沿着该方向演进,促使模型改变其思维链与工具调用动作。
-
高质量轨迹沉淀:一旦优化后的模型成功求解该问题,这条突破能力边界的新轨迹就会被存入经验池,供全局模型进行后续的通用 SFT 训练。
这一机制彻底绕开了强化学习在困难样本上奖励全为零的冷启动难题。即便当前的轨迹并没有完全做对,只要某种参数扰动促使智能体搜出了更具关联性的线索、使得模型对正确答案感到“不再那么意外”,损失差就会敏锐地捕捉到这丝微光,并沿着该方向持续推进。
破解落地瓶颈:并行推理与自适应缓存
零阶优化理论虽好,但在工程实践中往往因为“需要成倍增加前向评估次数”而备受诟病。如果每个扰动分支都要让大模型从头完整推理一遍,外加数十次真实的网络搜索和网页抓取,整个流程的时间消耗与 API 成本将不可承受。
论文针对这一瓶颈提出了两项关键优化机制,极大压缩了计算与时间开销。
首先是并行扰动推理机制(Parallel Perturbation Inference)。在多分支扰动评估时,模型骨干(Backbone)参数始终是冻结的,仅有低秩的 LoRA 参数发生变化。研究团队重构了推理计算图,让不同的扰动分支共享同一个冻结骨干的前向隐藏状态输出:
\[\boldsymbol{h}_{k}=\boldsymbol{\theta x}+(\boldsymbol{B}+\boldsymbol{\epsilon}_{k}^{B})(\boldsymbol{A}+\boldsymbol{\epsilon}_{k}^{A})\boldsymbol{x}\]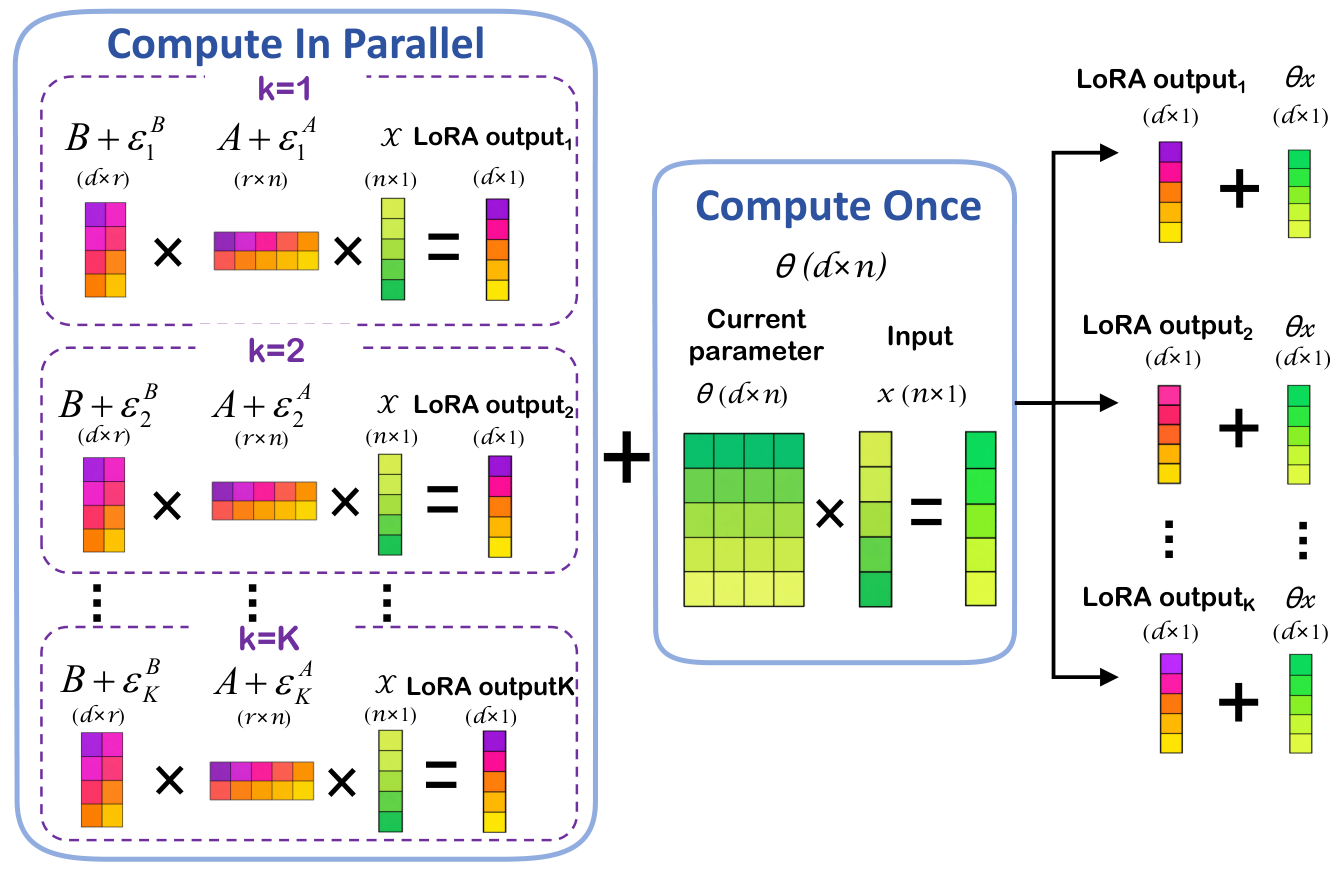
如此一来,最耗费算力的大模型主干前向计算只需要执行一次,多个轻量级的 LoRA 扰动分支可以在同一个 Batch 内并行计算完成。这一设计以极小的显存增量,换取了数倍的推理加速。
其次是自适应查找机制(Adaptive Lookup Mechanism)。智能体在针对同一问题展开多次扰动探索时,往往会发出相同或高度相近的工具调用(例如检索相同的关键词、打开相同的百科页面)。研究团队构建了一个全局调用缓存池,根据查询动作类型自适应选择匹配策略:对精确度要求极高的操作(如代码执行环境、确定性数据库查询)使用严格匹配,而对网页搜索等开放式文本检索引入语义相似度匹配。命中缓存时直接复用环境反馈,大幅减少了对外部真实网络环境的重复交互,将整个采样周期压缩到可行范围内。
为什么是“答案困惑度”?平滑监督击败离散二值
零阶优化的收敛性高度依赖于损失曲面的平滑程度。如果损失值是离散跳变的,有限差分估计出的“梯度”就会变成剧烈震荡的纯噪声。
早期的智能体反馈多采用两类信号:一是简单的 0/1 正确性二值奖励,二是利用 BERT 等模型计算的语义相似度,或者直接调用“LLM-as-a-Judge”给出评分。但实验发现,这几类信号在零阶优化中表现极差。二值信号在解题失败时是一片死寂的平地,导数为零;而大模型裁判或语义相似度在细微文本变化时会出现阶跃和不一致性,导致优化剧烈抖动、无法收敛。
为此,论文专门设计了答案困惑度损失(Answer Perplexity Loss):
\[\ell_{\mathrm{ans}}(\boldsymbol{\theta};q,\tau,y)=-\frac{1}{M}\sum_{j=1}^{M}\log\boldsymbol{\pi_{\theta}}\left(y_{j}\mid q,\tau_{\setminus\mathrm{ans}},y_{<j}\right)\]该损失的本质是在智能体经历了一整条交互轨迹 $\tau$(包含其所有的搜索、阅读与推理动作)之后,把轨迹作为前置上下文,计算模型生成真实参考答案 $y$ 的负对数似然。
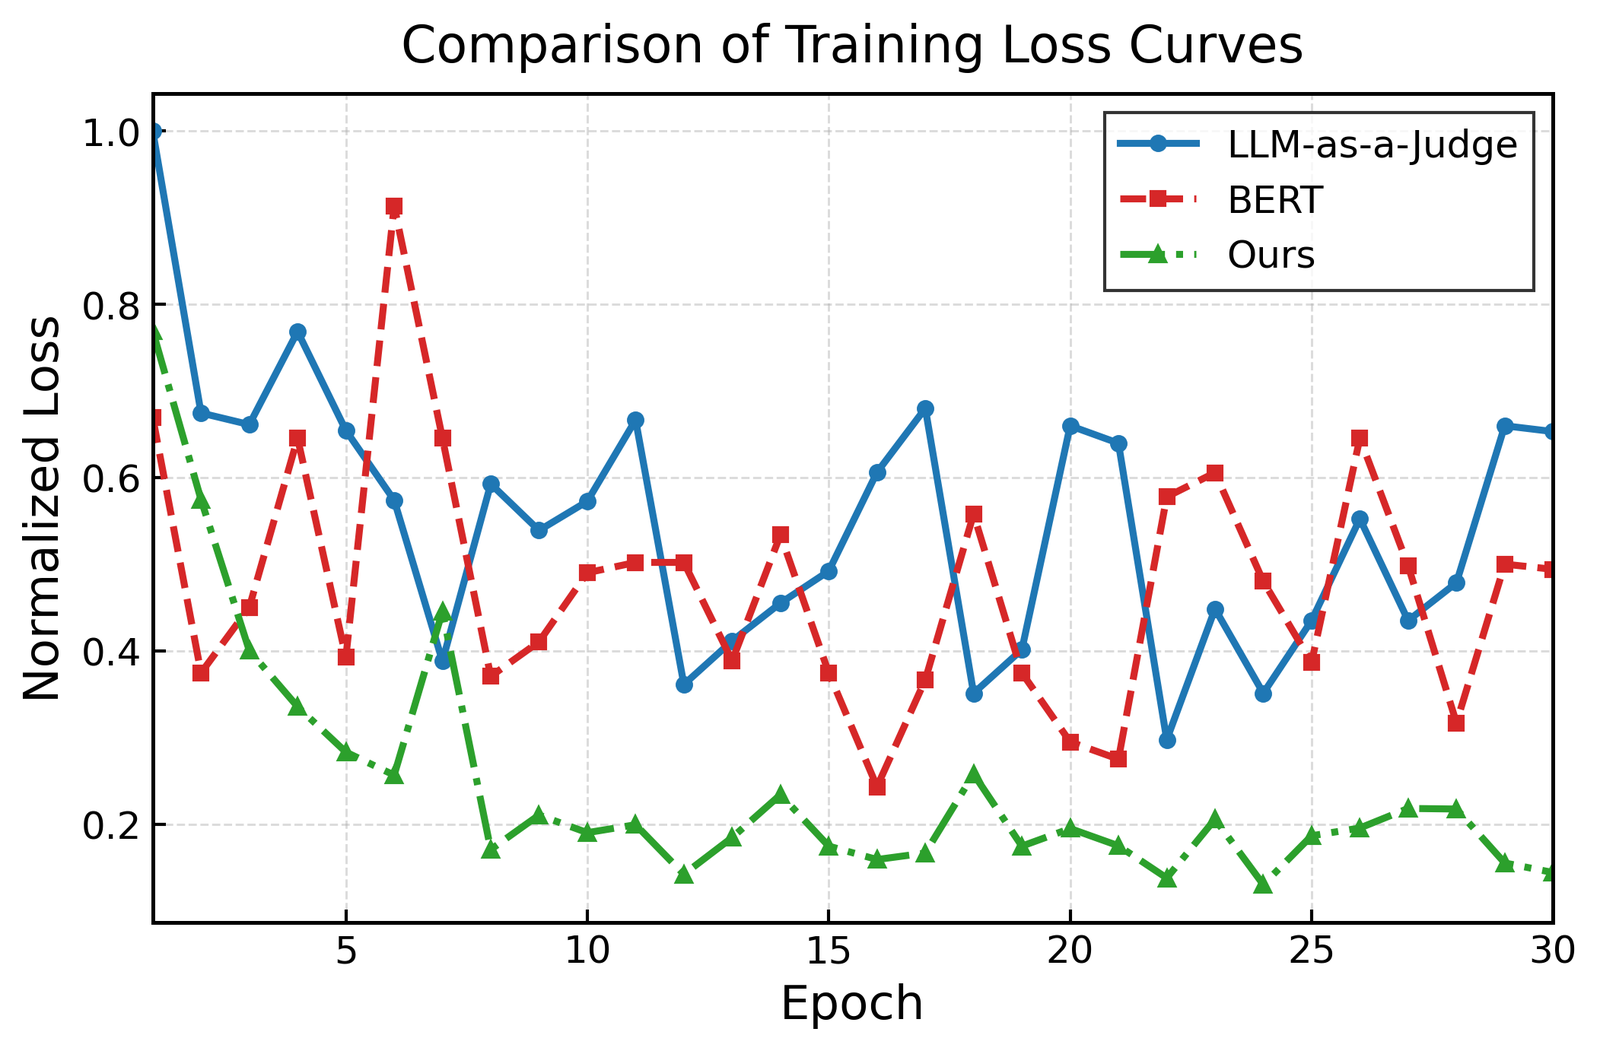
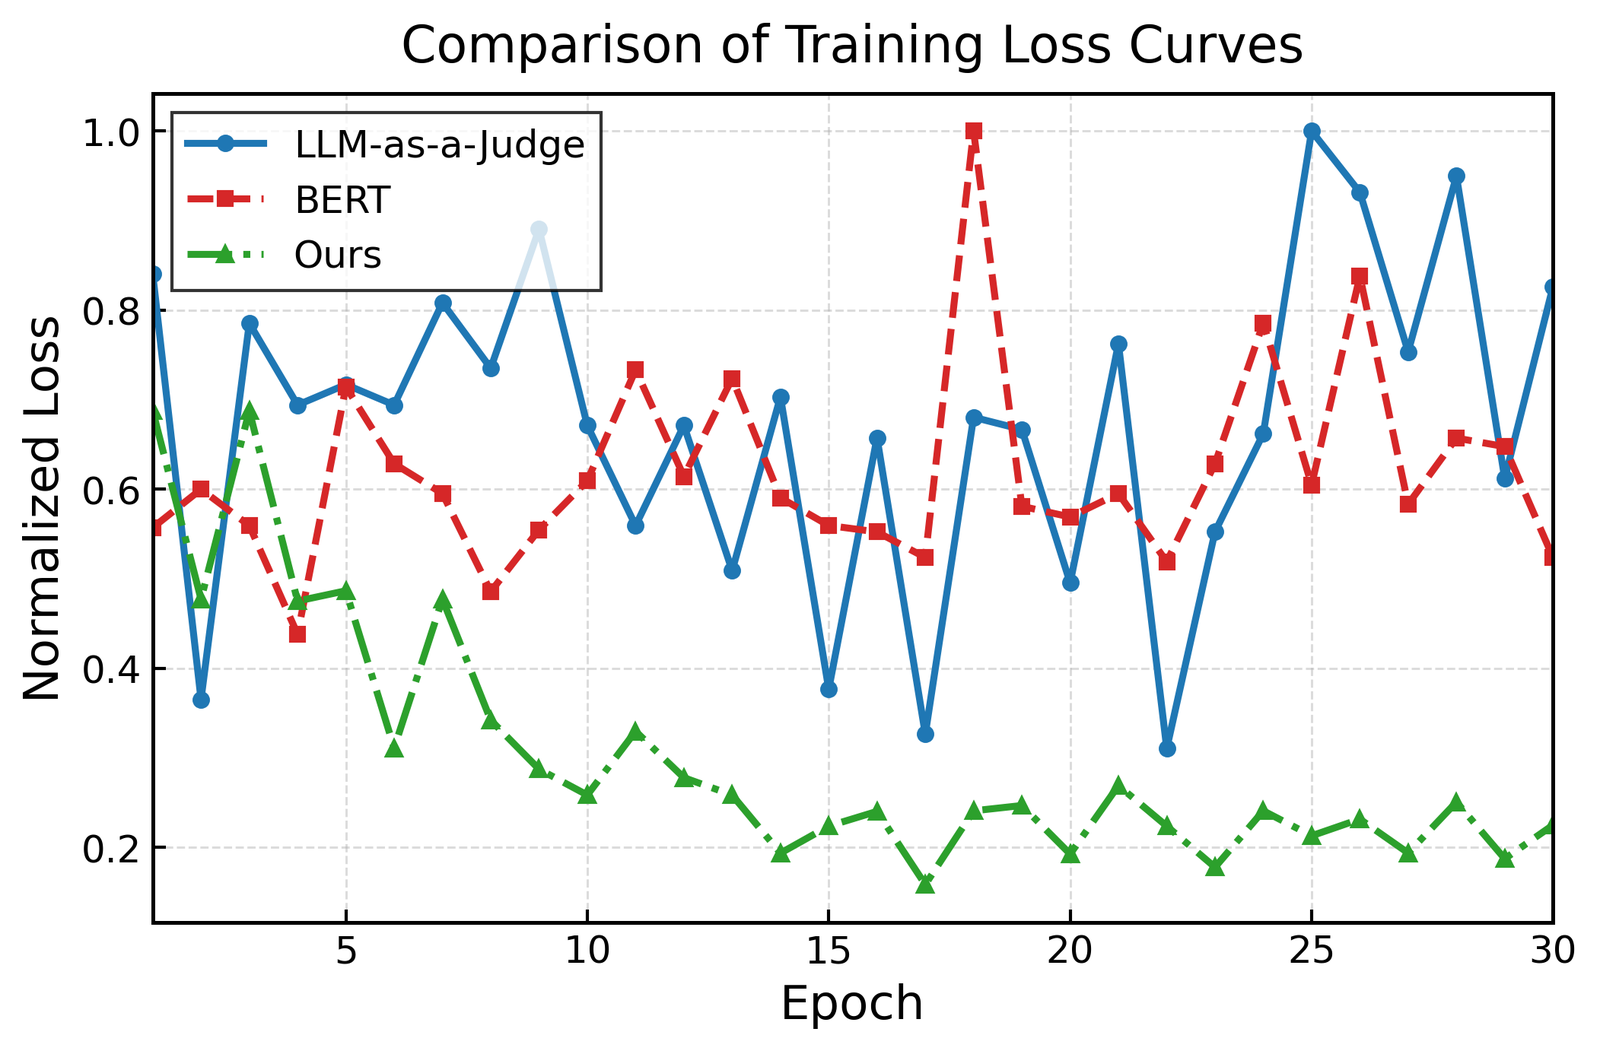
如上图所示,无论是在简单样本还是困难样本上,基于 LLM 评判和语义相似度的损失曲线(红线与蓝线)几乎全程在 0.6 到 1.0 之间剧烈震荡,完全看不到下降趋势。而答案困惑度损失(绿线)呈现出非常平滑且持续的单调下降。
这一设计的深刻之处在于它提供了稠密的中间证据奖励。假设智能体最终没有给出正确答案,但某次参数扰动促使它在 Google 搜索中输入了一个更准确的技术词,从而在抓取的网页摘要中包含了参考答案的局部实体。此时,虽然最终生成的回答依然错误,但以该上下文计算出的参考答案困惑度会显著降低。零阶梯度立刻捕获到这一正向收益,从而将模型参数引向更合理的检索策略。
实证检验:是真突破,还是碰巧多采样了几次?
为了验证该方法是否真正突破了模型的能力边界,作者团队在最具挑战性的两项深度调研基准——GAIA 与 WebWalkerQA 上进行了严苛评估,并与 ReAct、Search-o1、WebThinker、WebDancer、SimpleDeepSearcher 等主流方案以及强化学习(GRPO、ARPO)基线进行系统对比。
1. 核心表现与能力跨越
在 304 个包含复杂网页浏览与多跳推理的高难度训练样本中,原始基线模型(基于 Qwen-3-4B)在 Pass@1 下仅仅答对了 67 道题,在剩余 237 道题上全军覆没,初始成功率仅为 22.0%。
在挂载零阶自进化优化后,针对相同难度的样本集,优化后的智能体在 Pass@1 下成功答对的题目数攀升至 164 道,成功率达到了 53.9%,实现了 31.9 个百分点的巨大增幅。那些原本在模型知识与策略盲区之外的问题,被成功转化为高质量的有监督数据。随后利用这些新轨迹对全局模型进行通用微调,在 GAIA 测试集上全面超越了同量级的基线模型与纯 RL 训练策略。
2. 对决一阶优化与强化学习
在 50 个典型的极难样本对比实验中,研究人员设置了统一的交互与调用预算,结果形成了鲜明反差:
-
固定轨迹一阶优化(FO):在基线采出的失败轨迹上强行做反向传播,最终仅比原始采样多解出 1 道题。显存占用高达 21–24 GB,耗时 2.5–3.5 小时。
-
强化学习(RL):依赖策略采样与稀疏奖励,最终解出 16 道题。
-
零阶优化(Ours):通过动态参数扰动探索全新轨迹,成功解出 23 道题。同时,由于完全不需要保存中间激活值做反向传播,显存占用降低至 12–15 GB,耗时仅 1.7–2.4 小时。
这有力地证明了,在离散环境且奖励极度稀疏的智能体任务中,零阶优化由于其不需要在固定错误轨迹上反传梯度的黑盒特性,不仅更具探索效率,而且在计算资源消耗上展现出了显著优势。
3. 究竟是不是因为“采样次数多”带来的运气?
有人可能会质疑:零阶优化进行了多轮扰动,本质上是不是等于“多抽样了几次”(Best-of-$N$),靠运气撞出了正确答案?
研究团队用一组极具说服力的实验回击了这一怀疑。他们将未做任何优化的原始模型直接进行暴力扩展采样,将单题的采样预算拉满到 $N_{\mathrm{total}} = 45$ 次完整交互。结果显示:
-
原始模型在 Pass@8 时就已经遭遇明显的边际效益饱和(Pass@8 与 Pass@45 的表现完全一致,解题数停滞在 102 道,再增加几十次采样也无法多解出一题)。
-
相比之下,零阶自进化方法在匹配预算内成功解出 194 道题。
-
在零阶优化相较于初始状态新攻克的所有题目中,有超过 63.9% 的题目即便是让原始模型穷举采样 45 次也依然无法解出。
这充分证明,参数空间的扰动带来了质变。模型不是在原有的概率分布下多掷了几次骰子,而是真正偏移了策略空间,重塑了思考路径与工具使用模式。定性轨迹分析显示,优化后的模型明显减少了无效的重复翻页,学会了根据前序检索内容主动重构 Query,展现出了更高维度的环境适应能力。
智能体进化的范式转移
长期以来,学界在推进大模型智能体自我提升时,陷入了一种两难处境:要么依赖更强模型(如 GPT-4o)提供昂贵的蒸馏轨迹与反馈,这让开源模型永远无法摆脱对商业闭源模型的依附;要么依赖纯粹的自演化,却始终无法摆脱模型初始能力上限的诅咒。
这项工作展示了一条此前未被充分探索的第三条道路:将参数空间的黑盒微扰与环境交互直接挂钩。它揭示出一个关键事实——大模型内在的能力潜力往往并没有被初始的解码策略完全释放。通过针对特定难题的低秩参数微调,配合平滑连续的似然损失导向,弱模型完全有能力在自我博弈与盲探中,走出原本无法走出的逻辑闭环。
对于正在构建复杂工作流、网页检索智能体(Deep Research Agent)和具身智能系统的开发者而言,这种结合了并行推理、状态缓存与零阶差分梯度的新范式,不仅提供了一种低显存、易落地的探索方案,更为大模型冲破固有的能力牢笼提供了坚实的技术支点。