BlueLM-GUI:靠数百台真机跑出自我提升飞轮,超越最强闭源模型5.1分
BlueLM-GUI Technical Report: A Real-Device-Centric Flywheel for Self-Improving Mobile GUI Agents
在多模态智能体向垂直落地推进的过程中,移动端手机操作(Mobile GUI Agent)被普遍视为最具商业价值与交互频次的场景。过去业内方案大多依赖将规划、感知与执行拆分为不同模块的工程级联,但长链路下的误差级联与高交互延迟,迫使技术路线全面转向端到端单模型(Native GUI Agent)。然而,把所有能力收敛进一个模型之后,工业界立刻撞上了三堵看不见的墙:模拟器或沙盒训练出的策略,在面对真实手机的风控弹窗、卡顿与千奇百怪的应用状态时极其脆弱(分布不一致);在数百台真机上采跑轨迹成本昂贵,大量失败用例往往被粗暴丢弃(利用率低下);而固定的测试基准在模型持续迭代几轮后便迅速饱和,无法指明后续能力缺陷(归因失效)。
ArXiv URL:https://arxiv.org/abs/2609.12394
BlueLM-GUI 技术报告直面这三大产业落地断点。它并没有在模型结构上堆砌繁复的特化注意力模块,而是提出了一套以“全真机环境为中心”的自进化数据与训练飞轮(Real-Device-Centric Flywheel)。该框架支撑起一个 35B 参数规模、激活参数仅 3B 的混合专家架构(35B-A3B)模型,并贯彻了三条贯穿全生命周期的系统设计法则:每一条样本都有价值(Every Sample Matters)、每一次交互都在真机(Every Rollout Is Real)、每一个评测用例随能力共同进化(Every Query Evolves)。
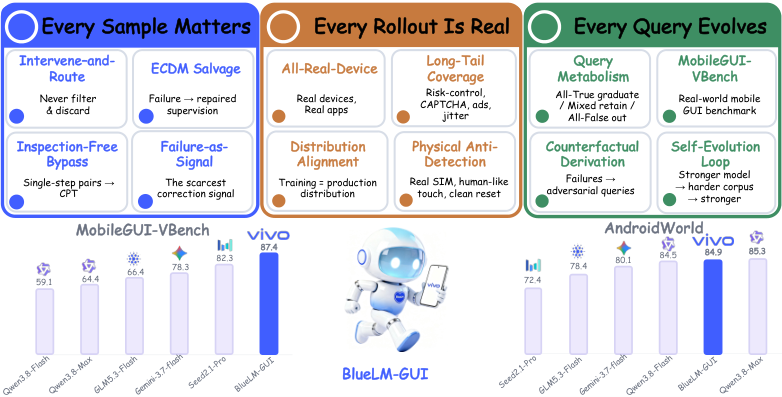
这套体系在严苛基准上展现了统治级的落地能力:在反映真实移动复杂任务的 MobileGUI-VBench 上,BlueLM-GUI 取得了 87.4 的高分,直接超越现有最强闭源商业模型 5.1 分;在业界广泛采用的 AndroidWorld 基准上达到 84.9 分,刷新了开源模型的最好成绩,并足以抗衡顶级闭源竞品。这篇技术报告的核心价值,不仅在于刷新了榜单数字,更在于公开了一套工业级真机数据资产如何自给自足、持续闭环滚动的完整工程方法论。
告别沙盒:真机飞轮直面工业界三大落差
想要理解 BlueLM-GUI 的设计取舍,必须先看清移动端模型在工业化落地中遭遇的核心困境。当前多数学术研究甚至大厂团队,为了保证评测的可复现性与数据采样的并发吞吐量,极度依赖安卓模拟器或轻量沙盒。沙盒确实支持状态回滚、环境变量可控,但其应用生态与真实手机存在巨大的分布偏移。真机上不可避免的网络抖动、第三方输入法干扰、动态广告弹窗、验证码拦截以及超级应用频繁更新带来的界面撕裂,在沙盒中几乎无法复现。模型在模拟器里跑得近乎完美,一放进真实手机就寸步难行。
真机采样固然贴近现实,但其物理门槛极高:设备操作耗时漫长、不可逆的状态变更使得环境极难自动重置,更严重的是,探索过程中会出现大量失败或异常轨迹。传统的做法是设立严格的成功过滤器,只保留顺利通关的“黄金轨迹”,将执行失败的样本悉数丢弃。这种做法在成本昂贵的全真机集群中是巨大的资源浪费,同时也抹杀了最珍贵的负反馈信号——模型究竟在何时偏离了意图、又是在哪一步界面误判了上下文。
此外,当模型通过强化学习不断自我演进时,业界通用的静态评测基准很快会迎来“分数天花板”。当一个基准的成功率逼近极限,它就失去了定位细粒度缺陷的诊断能力。研发团队往往陷入盲目刷榜、却不知真实系统下一阶段瓶颈何在的尴尬境地。BlueLM-GUI 构建的“数据生产—模型训练—评测归因—再生产”闭环,正是为了在系统层面逐一攻破这三个核心痛点。
数据解耦与变废为宝:每一条样本都是有效监督
整个飞轮的第一块基石,在于其对底层真机数据流的重构。为了兼顾持续预训练(CPT)的海量吞吐与监督微调(SFT)的高质量要求,BlueLM-GUI 在数据管线中做出了显式的机制解耦,彻底打破了“所有数据必须等完整轨迹通过后才能入库”的传统瓶颈。
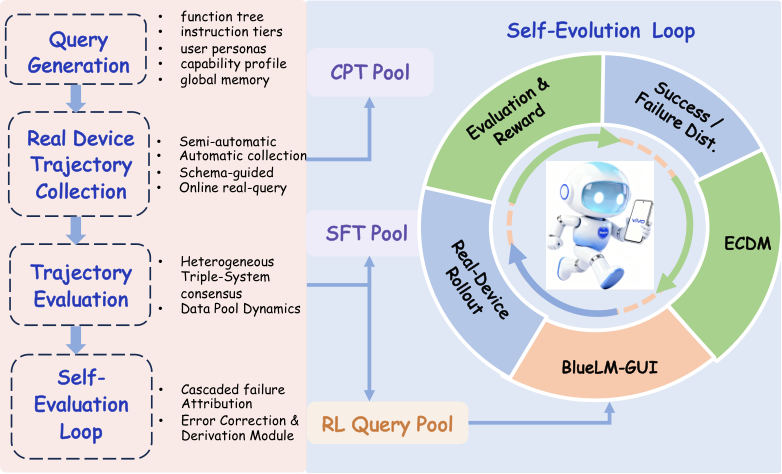
在采集效率与能力基底上,CPT 与 SFT 存在天然的不对称性。SFT 需要一整条跨多步交互的真机轨迹完整跑通、并通过复杂的多裁判系统一致性裁决,生产节奏缓慢而谨慎。如果让训练流水线强行等待长程轨迹,模型迭代就会饥饿停滞。BlueLM-GUI 采取的方案是:在真机执行的每一个单步(Single-step),系统截取的“屏幕截图—即时动作”元组经过规则清洗后,立刻并行流入 CPT 数据池。
更深层的思考在于先验能力的解耦。在模型学会长程 GUI 规划之前,它必须先学会看懂屏幕(OCR、图标语义定位、组件状态判断)以及工具调用的基础范式(API 参数构造、返回值解析与错误捕获)。这些低阶视觉与调用能力并不依赖于整条长任务是否最终成功。即便一条复杂任务在第十步失败了,前九步中精准的图标点击与单步响应依然是极佳的视觉感知与基础动作样本。因此,CPT 阶段不仅快速吞吐真机单步动作对,还注入了大量工具调用先验数据,使模型在进入 SFT 阶段前就筑牢了“何时调接口、何时点界面”的基础感知力;而宝贵的完整轨迹资源,则全神贯注用于 SFT 阶段提炼高级规划逻辑。
面对真机采集产出的庞大失败样本,BlueLM-GUI 研发了“异构三系统一致性评估”(Heterogeneous Triple-System Consensus, HTSC)与“错误纠正与衍生模块”(Error Correction & Derivation Module, ECDM)。当模型在真机上跑出一段异常或失败轨迹时,系统绝不轻易丢弃,而是启动三条外科手术式的修复路径:
-
步骤级错误纠正(Step-level Correction):通过高精度 Teacher 模型辅助结合人工介入,仅对导致偏差的特定单步进行动作重定向,挽救前序已消耗真机时间的成功步骤。
-
追溯式意图对齐(Retroactive Query Alignment, RQA):当模型由于界面缺少前置条件而无法完成宏大目标、但已经顺利完成了前半程阶段性操作时,系统反向缩减指令范围,将原指令降级为与已完成前缀完全匹配的新目标,变废为宝。
-
反事实衍生(Counterfactual Derivation):针对重复出现的系统环境阻碍或典型失败模式,逆向合成对抗性的防御探索任务,直接反哺强化学习训练池。
全局环境图谱:让跨应用任务从臆造走向真实可达
在指令生成阶段,许多自动化系统容易合成看似合规、实则在真实物理设备上根本无法成立的幻觉任务。例如指令要求“在社交软件中复制单号,并粘贴到物流软件中查询”,但当前设备可能并未登录物流账号,或者特定系统版本限制了相册读取权限。脱离设备物理现状的伪任务一旦下发,不仅浪费真机执行时长,更会污染训练语料。
为了让指令具备物理层面的“落脚点”,BlueLM-GUI 在真机农场之上构建了“全局环境记忆”(Global Environment Memory, GEM)。GEM 是一个拓扑图数据库,它融合了两大核心知识来源:其一是真机自动化探索沉淀的真实页面跳转图(Page-Navigation Graph),记录了各个页面之间的物理连通状态与关键操作热区;其二是厂商特有的设备级与系统级状态先验,涵盖不同机型、系统版本、预装应用能力边界及系统设置的真实绝对路径。
当系统需要合成复杂的跨应用或深层任务时,大模型不再是凭空臆造操作步骤,而是先在 GEM 图谱中检索可达路径。VLM 结合路径各节点的真实界面上下文,生成具备物理可行性的高阶指令。如果真机在执行中遭遇不可抗力(如遇到强风控黑屏阻断),该执行失败会作为环境事件立即回写 GEM,将对应分支标记为“暂不可达”,并自动将同类任务重定向至替代分支。这种闭环使指令生成系统具备了动态适应真机生态演进的自愈能力。
在真机轨迹的具体采集实现上,系统混合了三种互补的作业线:
-
半自动人机协同线(HITL):模型以高吞吐负责长链推理,关键步骤由人工进行毫秒级确认与微调,杜绝长尾幻觉,产出最高纯度的黄金监督数据。
-
全自动高通量线:完全由 Agent 端到端直驱真机,放开吞吐量,后续依赖 HTSC 严格把关与 ECDM 修复机制过滤躁动,以量取胜。
-
Schema 引导线:专门针对银行应用、深层系统设置等具备强确定性但页面极度深邃的场景,在系统 Prompt 中注入预定义的操作图谱或搜索定位模式,确保模型在极端垂直领域不盲目试错。
配额驱动与评测自进化:打破基准饱和僵局
对于自进化移动智能体而言,评价体系的停滞往往是系统性能陷入瓶颈的隐形元凶。BlueLM-GUI 提出了 MobileGUI-VBench 以及一套“配额驱动”(Quota-driven)的动态评测方法学。该方法彻底抛弃了“专家挑选一些主观难题组成固定测试集”的旧模式,将基准拆解为业务场景、任务复杂度、交互与风险控制三大正交轴。
每一个测试 Query 的生成,都是为了填补特定能力坐标轴上的配额空缺,而非随意构造。在多裁判 LLM 自动化评分机制下,只有当所有异构判别模型达成一致意见时判定才生效;出现分歧的样本自动流向人工终审,并将判定逻辑反向提炼为评测规则的更新补丁。
最关键的设计在于基准的“平滑自进化”。当经过强化学习迭代的 BlueLM-GUI 在既有测试集上逼近高分上限时,研发团队不需要推翻重来、盲目寻找更冷僻的偏门任务,而是在统一的三维坐标系中平移配额分布:提升长路径依赖的配额比例、增加弱意图及口语化含混指令的权重、注入更高密度的反事实干扰项。基准难度在数学维度上受控升级,同时由于能力坐标轴保持稳定,研发人员可以极为精准地将新一轮退化归因于特定能力的短板,使基准真正成为指引下一轮数据采样的雷达。
核心实验与消融:真机强化学习带来的鲁棒性飞跃
在最终的综合实力评估中,参数规模仅为 35B-A3B(总参数 350 亿,每次推理仅激活约 30 亿)的 BlueLM-GUI,展现出了与其轻量计算开销极不相称的强大落地表现。
在 MobileGUI-VBench 的系统评测中,BlueLM-GUI 最终斩获 87.4 分,相比当前行业顶尖的商业闭源模型高出 5.1 分。在横向对比权威第三方公开基准 AndroidWorld 时,该模型以 84.9 分拔得开源系统头筹,与参数量庞大数倍的闭源旗舰平分秋色。更值得关注的是其消融实验揭示出的能力来源:
-
相比在模拟器沙盒中完成强化学习的对照组,完全在真实手机集群上进行真机强化学习(Agentic RL)的模型,在跨应用长程任务和异常弹窗中断恢复任务上的成功率提升最为显著。真机环境中的随机网络延迟、瞬态错误提示以及应用间的状态穿插,被证明是训练模型抗干扰鲁棒性的最佳养料。
-
ECDM 模块的消融实验证明,被抢救和修复的失败轨迹并未引入噪声,反而向模型提供了最关键的边界恢复能力。去除了失败轨迹修复分支后,模型在面对未知界面偏离预定路线时的自愈成功率出现了断崖式下跌。
-
CPT 与 SFT 的解耦策略使真机数据流的吞吐效能提升数倍,先注入单步视觉基底与工具调用逻辑、再进行全轨迹端到端调优的训练路线,显著优于从零直接进行全量长程 SFT 的传统方案。
总结与展望
BlueLM-GUI 展现了移动端 Agent 研发逻辑的一次深刻转向。当模型架构在端到端多模态范式上逐渐收敛,决定智能体工业可用性生死的,不再是细微的算子魔改,而是能否构建起一套能够自我消化瑕疵、动态感知环境变化并持续自进化的真机数据闭环。
通过将数百台真实物理手机直接化为强化学习的沙场,配合“不丢弃任何样本价值”的精细化修复路由,以及配额驱动的自演进基准,BlueLM-GUI 证明了轻量化 MoE 模型完全能够凭借极致的真机数据飞轮,在极度复杂的真实交互场景中战胜依赖通用庞大算力的闭源方案。对于所有试图让 AI 接管物理或数字终端操作的开发者而言,这套软硬一体、直面脏数据与真实分布的系统级解法,无疑提供了一份极具参考价值的工业落地样本。