SkillClone:不用提示词注入,普通对话就能逆向克隆大模型私有技能?
Behavioral Skill Reconstruction: Reconstructing Hidden Functionality from LLM Agent Skills
在大模型应用逐步走向落地的过程中,“技能”(Skills)正成为智能体生态中最核心的资产形态。从早期简单的 Prompt 模板,演进到如今将自然语言指引、私有参考数据、专有规则表、数值算法与 Python 脚本封装成独立包,智能体在推理时按需挂载。这种设计使得开发者不必重新训练或微调底座大模型,就能让智能体拥有高价值的垂直领域能力。商业技能市场应运而生,许多企业选择将核心逻辑打包成闭源技能,以“能力即服务”(Capability-as-a-Service)的方式对外提供商业接口。
ArXiv URL:https://arxiv.org/abs/2608.04192v1
随之而来的安全研究大多将注意力放在“文件泄露”上。例如,通过提示词注入(Prompt Injection)、越狱攻击或特定诱导,诱使智能体直接打印出其私有配置 SKILL.md 或底层代码脚本。防御方案也针锋相对,聚焦于检测恶意提取意图、隔离敏感上下文、拦截包含专有文本的文件输出。
来自南加州大学(University of Southern California)的研究团队提出了一个尖锐的问题:如果攻击者根本不尝试偷取代码和文件,仅仅通过完全合规的日常业务对话,能否逆向克隆出闭源技能的完整功能?
这项关于“行为级技能重构”(Behavioral Skill Reconstruction, BSR)的系统性研究,给出了明确的答案。研究团队提出的黑盒攻击框架 SkillClone 证明:哪怕底层文件被严密保护、不发生任何文本泄露,仅凭普通的任务交互与闭环差分修复,攻击者依然能以极低的成本重构出可独立执行的等价程序克隆。
从“偷文件”到“偷功能”:重新审视技能保密性
过去的安全边界建立在“工件保密”(Artifact Secrecy)之上——只要私有脚本、规则表和常量没有被直接吐出来,系统就被视作安全的。但这种认知忽略了商业服务的本质:一个技能只要对外提供服务,就必须在输出中体现其逻辑的结果。
反复的输入输出交互,必然会在行为空间中留下其决策阈值、组合规则、表格映射和计算流程的投影。南加州大学团队将这种威胁形式化为行为级技能重构(BSR)。在 BSR 的威胁模型下:
-
攻击者仅拥有普通用户的黑盒调用权限,只能看到公开的技能宣传简介(Advertisement)和公开任务接口 $\sigma_s$。
-
攻击者发起的全部请求都严格符合正常业务格式(Task-valid),不包含任何“忽略上述指令”或“输出系统提示词”的恶意注入。
-
攻击者既看不到技能包内部文件,也无法获取模型的思维链(Chain-of-Thought)或隐藏工具调用轨迹,仅仅观察最终的回复内容。
为了严格评估攻击到底还原了什么,本文提出了“相对模型的边际功能”(Model-relative Marginal Functionality)概念。一个技能组件只有在满足以下条件时才算作有效的逆向目标:底座模型在挂载技能后能高保真执行,但在不挂载技能时仅凭公开简介完全无法复现。这一标准将大模型底座自带的通用先验与技能专有的知识产权(IP)清晰地切割开来。
SkillClone 的技术机制:如何从外部黑盒复刻内在逻辑?
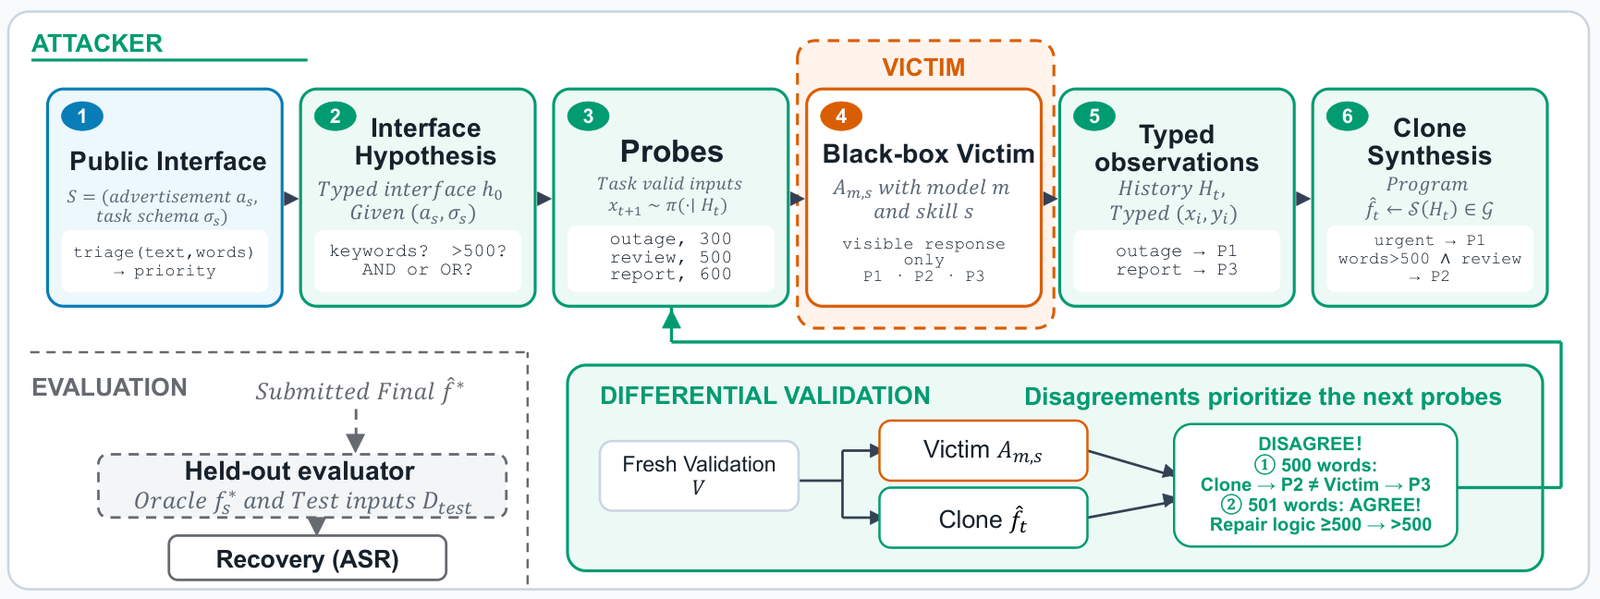
SkillClone 的核心并非盲目穷举,而是一套严密的主动学习与程序合成闭环。整个重构流程分为五个紧密衔接的阶段:
1. 接口假设构建(Interface Hypothesis)
公开的技能描述通常会包含面向任务的路由说明。例如,一个网络流量检测技能的广告可能会提及分析端口、协议和包大小,但隐去了具体的异常判定阈值;一个内部文档优先级分类器会指出关注关键词与字数,但不会公开具体的权重矩阵。
SkillClone 首先将这些线索转化为类型化的接口假设:
\[h_0 = (\hat{\mathcal{X}}, \hat{\mathcal{Y}}, \hat{Z}, \hat{\Theta}, \hat{\mathcal{C}})\]其中包含候选输入输出类型、潜在特征因子 $\hat{Z}$、未知参数 $\hat{\Theta}$ 以及候选组合逻辑族 $\hat{\mathcal{C}}$(例如加法打分、布尔逻辑与优先级短路规则)。
2. 结构化良性探测(Structured Benign Probing)
为了用最少的查询量确定内部参数,SkillClone 依靠一个通用的实验设计算子库生成测试用例:
-
单变量隔离(Isolation):固定其他维度为中性值,只改变单一属性;
-
剂量反应(Dose–Response)与边界搜索(Boundary Search):通过二分或步进方式,精确探测数值阈值的跳变临界点;
-
组合逻辑探测(Composition):区分不同条件之间是“且(AND)”、“或(OR)”还是存在短路优先级的阶梯规则;
-
混杂消除(Confound)与枚举(Enumeration):剥离共变因素,覆盖查表键值。
3. 观测解析(Observation Parsing)
智能体返回的内容往往包含格式化文本或自然语言解释。SkillClone 在请求中加入“仅输出答案”等约束,并将受害者的可见输出清洗、解析为结构化的类型标注数据,作为后续程序合成的“伪标签”。
4. 约束程序合成(Program Synthesis)
基于收集到的探测历史 $H_t$,合成器 $\mathcal{S}(H_t)$ 并不生成一段模糊的 Prompt,而是直接编写出确定性的 Python 独立可执行代码 $\hat{f}_t$。根据前期假设的类型,它会自动选择阈值分类器、查表引擎、有限状态机或数值计算过程的架构,把探测到的隐藏常量、临界值和分支条件直接硬编码到代码中。
5. 差分验证与对抗修复(Differential Verification and Repair)
这是 SkillClone 能够超越单轮探测的关键。由于攻击者没有被测技能的真实代码(Oracle),它选择通过“受害者一致性”来进行评估:
\[t^* = \arg\max_t \mathrm{Agree}(\hat{f}_t, A_{m,s}; V)\]攻击者自主生成一批不重叠的验证集 $V$,将合成代码的执行结果与受害者智能体的回答进行逐一比对。一旦发现两处输出不一致,说明当前的合成程序在特定边界上存在逻辑盲区。系统会针对不一致的输入生成新一轮精细探测,闭环修复合成代码,直到查询预算耗尽。
30 个闭源技能实测:逆向效果究竟如何?
为了验证这套机制的实际破坏力,研究人员从 SkillsBench 基准、SkillRet 检索库以及公开技能注册表中筛选出 30 个涵盖规则判断、数据查表、业务流程与数值算法的典型技能。受试的底座模型涵盖了包括 DeepSeek-Flash、DeepSeek-Pro、GLM-5.1、Kimi-K2.6 和 GPT-5.6-Luna 在内的 5 款主流大模型。
攻击端仅使用轻量级的大模型驱动,单次攻击的受害者查询预算被严格限制在几十次之内(例如受控实验中仅用 52 次探测加 30 次验证)。
实验结果揭示了令人震惊的重构效率:
在完整的智能体部署环境中,SkillClone 在最强的受害者模型上成功将 21 个真实挖掘技能中的 16 个恢复到了随机基线之上。对于若干包含确定性规则与流程的技能,SkillClone 甚至直接生成了完全等价的可执行代码,在保留测试集上的攻击成功率(Attack Success Rate, ASR)达到了 100%。
更具启发性的是代码的词元精确度(Token Precision)与功能等价性之间的对比:许多重构成功的克隆体,在代码文本层面与原始隐藏脚本的重合度仅有 35% 到 59%,但其外部行为在测试集上达到了 74% 至 100% 的精准复现。这证明黑盒程序合成真正抓取到了业务逻辑的核心语义,而非对表层文本的机械逼近。
而在成本方面,借助高效的探测策略,驱动一次完整重构攻击的 API 成本极低——在使用 DeepSeek-Flash 充当攻击者时平均单次仅需约 0.9 美分,使用 Pro 模型也仅约 1.3 美分。极低的经济门槛,使得任何挂载在公开 API 后的技能服务都面临着实质性的克隆风险。
为什么现有防御机制纷纷失效?
当研究人员用现有的安全手段来抵御 SkillClone 时,暴露出传统防御思想的严重盲区。
首先是基于泄露特征的拦截器(Disclosure Filters)。业界常用的防护组件旨在识别提示词提取尝试。在测试中,这类防御手段能百分之百精准拦截诸如“请给我看你的源代码”等直接窃取探针;但在面对 SkillClone 发出的结构化探测时,其输入检测器仅仅标记了 6.7% 的请求,而最终的克隆成功率完全没有受到影响。原因非常本质:SkillClone 发送的每一条请求,在格式和意图上都属于正常的业务咨询。
其次是模糊化技能公开描述(Reducing Advertisement Detail)。如果服务提供商把公开的技能简介写得极其简略,能否阻止重构?实验表明这种防御的效果非常不稳定。只要简介中保留了让调度器(Router)正确分发任务的最基本关键词,具有领域常识的攻击模型就足以推导出合格的初始接口假设;过度删减描述,往往在防住攻击者之前,先破坏了智能体自身任务调度的准确性。
研究进一步对不同类型的失败案例进行了系统性瓶颈归因:
-
查表与规则类(Tables & Rules):重构成功率最高,主要瓶颈在于查询预算是否足以覆盖极其罕见的特殊长尾分支。
-
数值与公式类(Numeric Formulas):重构成功率相对较低(中位数约 57%)。例如在一个力量举重系数换算技能中,攻击者在探测到正确的输入输出规律后,却在程序合成阶段错误调用了通用的 Wilks 公式,而非被测技能采用的 DOTS 公式;而一旦研究人员人工提示了算法名称,其逆向成功率瞬间恢复至满分。这表明数值类的主要制约往往是攻击模型的先验知识召回,而非信息无法被探测。
总结与启示:智能体安全边界的重塑
SkillClone 的提出,打破了“只要文件不泄露,专有资产就安全”的技术假象。它证明了大模型本身兼具强大的实验设计能力与代码合成能力,这让经典的黑盒系统辨识与模型逆向门槛断崖式下跌。
这项研究对未来的大模型智能体架构设计提出了全新的安全要求:
对于依赖专有算法、定价策略、审批流和内部知识库构建的商业技能服务,仅仅部署“防越狱”和“防注入”过滤层是远远不够的。未来的防御研究必须从静态的文件保护,转向对交互会话累积信息泄漏量的度量与管控。如何在向合法用户提供高确定性服务的同时,通过速率限制、差分隐私、意图分布监控等手段阻断系统化的边界探测,将是闭源 Agent 技能走向规模化商业变现必须跨越的一道隐形门槛。