BCP:冻结VLA实现自适应重规划,真机操作成功率从44%提升至84%
Continue or Replan? Bernoulli-Continuation Policy Learning for Adaptive Horizon Execution
在具身智能与机器人操作领域,动作分块(Action Chunking)已成为视觉-语言-动作(Vision-Language-Action, VLA)模型的标准范式。从 ACT、$\pi_0$ 到各类前沿具身大模型,系统通常不再单步预测动作,而是一次性输出未来数十步的连续控制轨迹。这种设计大幅摊薄了庞大模型的单步推理时延,并有效增强了动作的时间平滑性。
ArXiv URL:https://arxiv.org/abs/2608.03483v1
然而,当前的绝大多数系统在动作执行时采用了一种极为机械的折中方案:设定一个固定的执行步长(Execution Horizon)。例如模型一次预测 50 步动作,控制系统就雷打不动地执行完这 50 步,然后再重新采集图像并调用模型进行重规划。这种固定步长机制实质上将重规划变成了一个与任务实际进展完全解耦的“周期性时钟”。当面临抓取闭合、接触插拔等毫米级精度的关键操作节点时,若恰好没有重规划边界落在这个节点之前,机械臂就只能硬着头皮执行几十步之前生成的陈旧动作(Stale Chunk),微小的位姿偏差随之迅速放大,最终导致操作失败。
针对这一根本性矛盾,来自微软亚洲研究院与北京大学的研究团队提出了一种名为 BCP(Bernoulli-Continuation Policy) 的轻量级即插即用框架。该方法无需重新训练或微调庞大而昂贵的底层 VLA 模型,而是保持底座完全冻结,仅在其顶层附加一个极轻量的伯努利连续性决策头,将执行步长的选择分解为一系列“继续执行还是立即重规划”的链式决策。在 RoboTwin 2.0 仿真基准的 13 个低成功率困难任务上,BCP 带来了 11.08% 的显著成功率提升;在真实双臂机器人实验中,更是将悬挂马克杯任务的成功率从 44% 提升至 84%。更反直觉的是,由于减少了走错路带来的无效动作,机器人的整体端到端运行时间不仅没有因为额外的决策而增加,反而比固定步长基线更低。
11.3%的性能鸿沟:固定步长到底错在哪?
要理解自适应执行的必要性,首先要看清固定步长到底引发了什么问题。许多开发者直觉上可能会认为:如果 50 步太长容易导致动作陈旧,那把固定步长改小(比如固定为 20 步或 10 步)不就可以了吗?或者只要底层 VLA 预测得足够准,步长多长并不重要。
为了检验这一假设,研究团队在 RoboTwin 2.0 的 50 项操作任务上设计了一组极具启发性的“相位偏移(Phase-shift)”实验。在这组实验中,底座模型(LingBot-VLA)的单次预测步长和后续执行步长都被固定为 50 步,唯一的区别在于:在回合的最开始,机械臂第一块动作只执行 $\phi$ 步($\phi \in [1, 50]$),随后的所有动作块再恢复每 50 步重规划一次。换言之,所有测试变体的总执行步长完全一致,仅仅改变了后续重规划节点在时间轴上的“相对落点”。
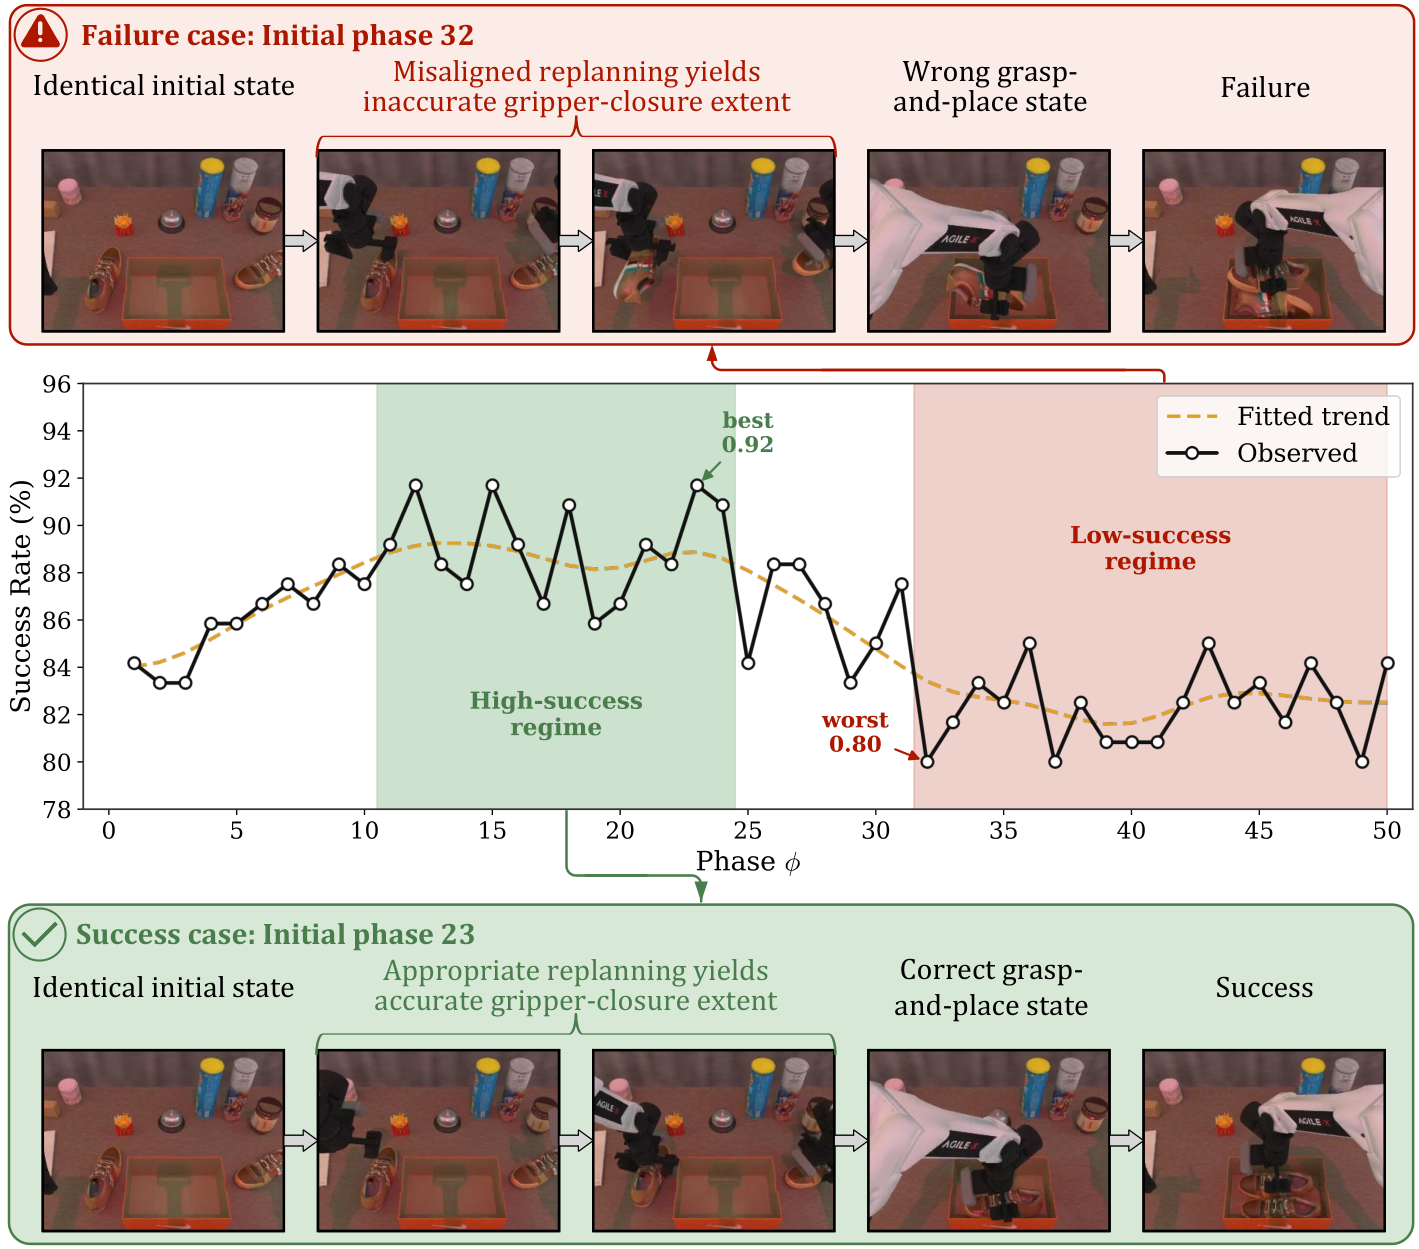
实验结果令人吃惊:仅仅改变初始相位 $\phi$,50 项任务的平均成功率就出现了高达 11.30% 的性能断崖(最差相位平均成功率仅为 82.50%,而各任务最优相位的事后上限可达 93.65%)。
如上图在“放置双鞋(Placing Dual Shoes)”任务中的展示,当初始相位 $\phi=32$ 时,机械臂在即将接触鞋身的关键时刻并未触发重规划,而是强行调用了之前预测的抓取动作,导致夹爪开合幅度出现微小偏差而抓空失败;而在 $\phi=23$ 时,重规划节点刚好自然落在了抓取动作即将发生的前一瞬间,机械臂通过最新摄取的环境图像精准校准了夹爪位姿,顺利完成了抓取。
这一现象揭示了一个被长期忽视的核心事实:操作成功与否,决定性因素不仅在于执行步长本身的绝对长短,更在于重规划边界是否精确对齐了关键操作阶段。 在开阔空间移动时,机器人完全可以信任此前预测的几十步平滑轨迹;但在产生物理接触的瞬间,必须重新“睁眼看世界”。由于不同任务、甚至同一任务不同随机种子下的关键接触时机都是动态变化的,任何固定的静态周期方案都无法在时间线上全盘契合。
难题与洞察:为什么自适应步长并不好做?
既然执行步长需要动态决定,为何此前的具身模型很少将其做成端到端的动态预测?核心阻碍来自三个层面:
-
候选步长的序数与前缀共享属性(Ordinal & Prefix-Sharing Bias): 离散步长(例如选择执行 20、30 还是 50 步)与常规的分类任务截然不同。如果系统决定执行 50 步,前提必然是系统默认前 40 步都是可靠的,50 步的轨迹完整包含了 40 步的前缀动作。如果直接套用标准的 Softmax 多分类器,模型会把这几个步长视为彼此平行的独立类别,完全抹杀了候选步长之间固有的序数包含关系。
-
单步监督信号不可观测(Credit Assignment Dilemma): 在机器人操作的一整个轨迹中,究竟在第几步停下来重规划才是“最优解”,在离线数据中根本没有真实标签(Ground Truth)。同一个任务的成功可能对应着无数种不同的步长组合,步长决策是高度时间耦合的——当前块提前停止,会直接改变下一块的起始状态和观察视角。
-
精度与效率的博弈陷阱: 如果单纯用任务是否成功作为奖励来训练步长选择,强化学习策略极易陷入偷懒的局部最优——它会迅速坍缩到极短的步长,恨不得每执行 1 步或 5 步就重规划一次。这虽然看似最保险,却彻底摧毁了动作分块的设计初衷,导致庞大的 VLA 频繁空转推理,带来不可承受的计算开销与动作顿挫。
伯努利连续性策略(BCP)的核心机制
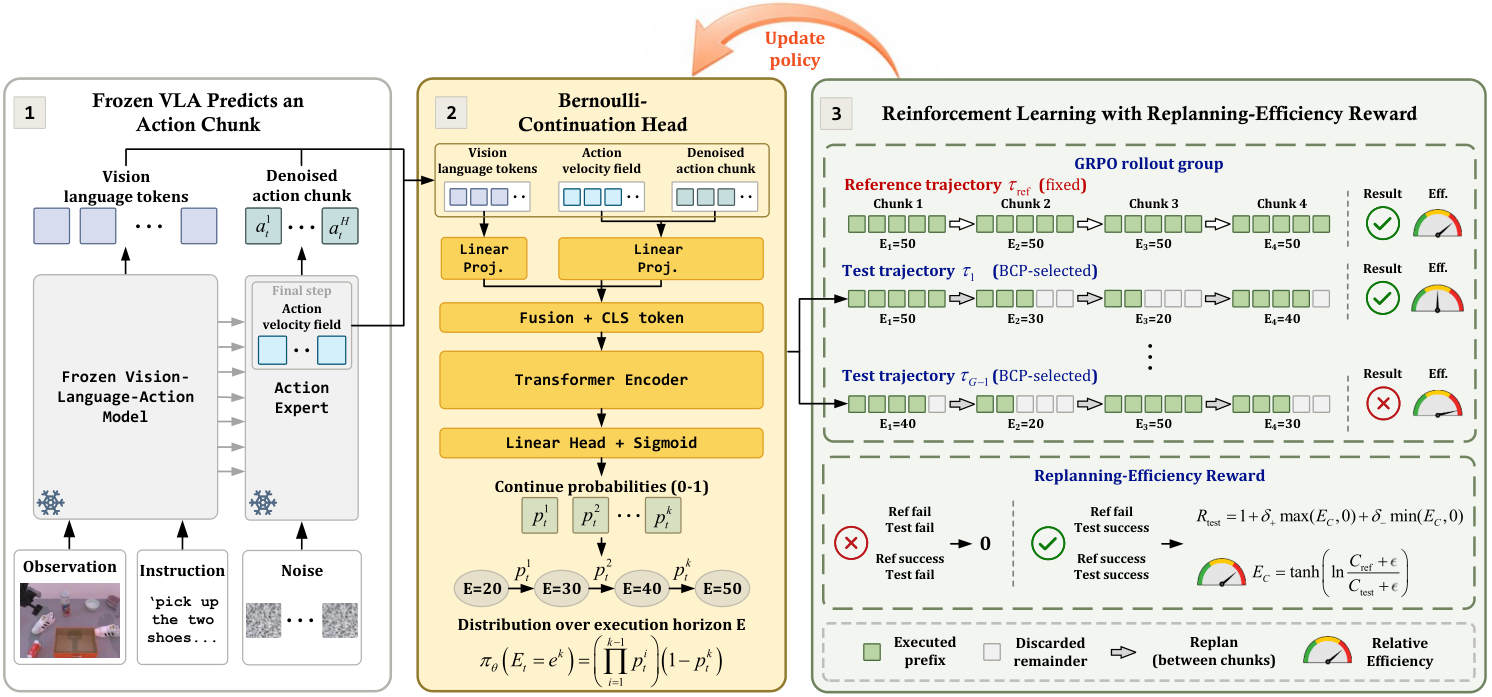
为了化解上述困境,BCP 采用了一种非常轻巧的解题思路:将整个大模型冻结,只学习一个微型的决策头,并将步长预测重构为一条连续的伯努利决策链。
1. 结构与特征复用
BCP 并不重新计算视觉感知特征,而是直接从冻结的底座 VLA 内部提取已经计算完毕的高层表征:包括场景与语言指令的视觉-语言特征向量 $\mathbf{F}_t \in \mathbb{R}^{N \times d_v}$,以及当前动作块中去噪生成的动作序列 $\mathbf{a}_t^j$ 和最后一轮扩散步骤中的动作速度特征 $\mathbf{u}_t^j$。
这些特征被拼接投影后,输入到一个仅有 2 层结构的 Transformer 编码器中:
\[\mathbf{h}_t^j = \mathrm{Proj}_a([\mathbf{u}_t^j; \mathbf{a}_t^j]), \qquad \hat{\mathbf{F}}_t = \mathrm{Proj}_v(\mathbf{F}_t)\]这一设计使 BCP 决策头极其轻量,单次前向推断仅增加约 2 毫秒的时延,在庞大的 VLA 运行开销中几乎可以忽略不计。
2. 链式伯努利继续决策
面对预设的一组候选步长序列 $\mathcal{E} = {e^1, e^2, \ldots, e^M}$(例如 15, 20, 25, …, 50 步),BCP 不直接输出多分类概率,而是为每两个相邻步长之间输出一个独立的“继续执行”概率 $p_t^i = \sigma(z_t^i)$。
在这一公式下,选定执行到第 $e^k$ 步的概率被定义为:
\[\pi_\theta(E_t = e^k \mid s_t) = \begin{cases} \left(\prod_{i=1}^{k-1} p_t^i\right) (1 - p_t^k), & 1 \leq k < M \\ \prod_{i=1}^{M-1} p_t^i, & k = M \end{cases}\]这种因子分解完美地契合了物理动作的包含关系:长步长想要被选中,必须在前面的每一个检查点上都连续做出“继续信任当前动作”的高置信度判定。只要其中任何一步判定当前动作块可能失效,链条就会被打断并立即触发重规划。这种结构天然地赋予了模型强烈的序数偏置,让相邻步长获得相近的置信概率。
3. 强化学习与重规划效率奖励(RER)
由于没有单步真值,团队使用轨迹级强化学习算法 GRPO(Group Relative Policy Optimization)对策略头进行优化。为了防止步长坍缩到极小值,研究人员设计了“重规划效率奖励”(Replanning-Efficiency Reward, RER)。
系统以固定步长 baseline 的平均调用次数作为基准 $C_{\mathrm{ref}}$,统计当前轨迹的实际调用次数 $C_i$,构造出一个相对效率标量:
\[\eta_i = \tanh\left(\log \frac{C_{\mathrm{ref}}}{C_i}\right)\]随后将其与任务成功指示符 $S_i \in {0, 1}$ 结合形成最终奖励:
\[R_i = S_i \Big(1 + \delta_+ \max(\eta_i, 0) + \delta_- \min(\eta_i, 0)\Big)\]这一精妙的设计建立了一个双向约束:只有在任务成功的前提下($S_i = 1$),效率项才会生效;在成功轨迹中,调用 VLA 次数越少(即单次执行越充分、不盲目重规划),获得的额外奖励就越高。失败轨迹则直接归零。这迫使策略在“必须重规划的关键时刻”果断停下,在“动作平稳的安全区间”尽量跑满长步长。
实验评测:不仅更准,而且更快
为了全面验证 BCP 的性能,研究人员在多任务双臂仿真基准 RoboTwin 2.0、经典操作基准 LIBERO / LIBERO-PRO,以及真实世界双臂机器人平台上展开了密集评测。
1. 突破困难任务的瓶颈
在 RoboTwin 2.0 评测中,针对 LingBot-VLA 在 Clean 环境下原本成功率低于 90% 的 13 项极具挑战性的操作任务(如双臂协同放置鞋子、穿插装配等),BCP 将平均成功率从 75.15% 显著拉升至 86.23%,绝对提升达 11.08%。在涵盖日常操作全集的全部 50 项任务中,平均成功率从 89.88% 提高到 93.94%(+4.06%),刷新了该基准上的 SOTA 水平。同样的增益也在 ABot-M0 和经典的轻量级策略 ACT 上得到了复现。
更重要的是跨分布泛化表现:尽管 BCP 仅在无干扰的 Clean 环境下进行强化学习训练,但在直接部署到包含随机背景、随机光照和物体随机位姿的 Randomized 环境中时,依然斩获了 4.06% 的绝对提升(88.78% 升至 92.84%)。这强有力地证明了 BCP 学到的不是某张特定图像像素下的停顿点,而是某种跨越视觉域的“任务阶段性物理直觉”——它学会了识别机器人手爪在即将接触物体时的临界动态特征。
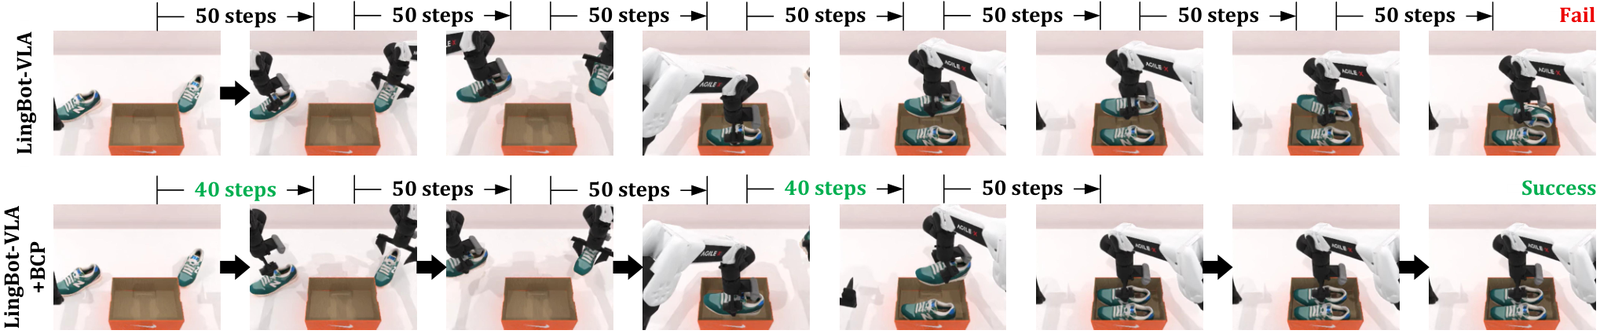
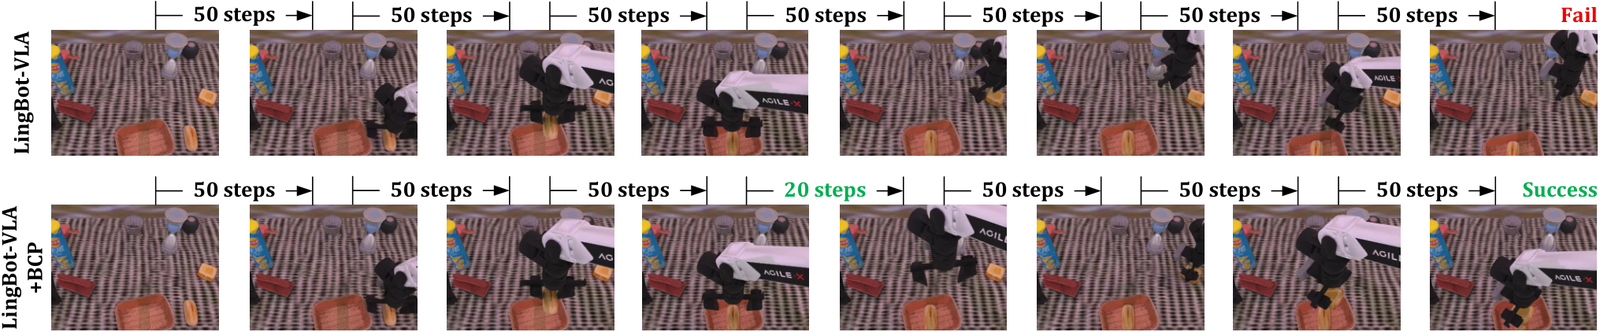
在上图的可视化案例中,这种自适应行为尤为直观。在“放置双鞋”任务的第二阶段,固定 50 步策略由于中间缺乏校准,把鞋子推到了收纳盒边缘并卡死;而 BCP 在接近盒沿时主动收缩步长至 40 步,强制触发了一次重新观测,在获取最新的视角后微调了末端姿态,将鞋子端正地放入盒内。在“抓取面包”任务中,BCP 更是极其聪明地把一段原本机械分配的长距离移动切分为了“快速接近”和“接触前精准悬停”两段,使抓取点刚好落在重规划边界之后。
2. 跨底座架构迁移与抗扰动能力
除了自研模型,BCP 还被外挂到了近期极具代表性的开源具身基准 $\pi_{0.5}$ 上,并在 LIBERO 操作集上测试。在标准测试中,BCP 将 $\pi_{0.5}$ 原本已接近饱和的平均成功率从 97.0% 推高至 98.7%。而在环境引入更大物体位置扰动的 LIBERO-PRO 挑战集上,BCP 的增益被进一步放大:平均成功率从 30.9% 攀升至 37.7%,不仅大幅甩开原始底座(+6.8%),也明显优于基于注意力熵值的 AAC 策略(34.8%)。这说明任务难度越高、外界扰动越大,适时刹车重规划的价值就越显著。
3. 运行时间为何反而更短?
在机器人实际部署中,计算与执行时延是硬指标。直觉上,自适应重规划由于增加了判断环节,调用大模型的频次可能会上升,进而拖慢执行速度。
然而实测数据显示,BCP 的单次推理开销仅从纯 VLA 的 938.10 毫秒微增到 940.13 毫秒,额外开销仅 2.03 毫秒。在整个操作回合中,由于有了自适应停顿,VLA 的平均调用次数微幅上升(从 5.382 次升至 5.614 次);但极其关键的转变发生在机械臂的物理执行动作上:机械臂平均执行的控制步数从 269.08 步大幅缩减到了 248.10 步。
由于不再盲目执行过期的错误动作轨迹,机械臂少走了大量弯路、无效试探和抖动补偿。在结合了 50 Hz 的底层控制周期与 GPU 模型推理耗时后,BCP 的单回合总运行耗时从原本的 10.43 秒下降至 10.24 秒。在提升操作成功率的同时,整体系统响应反而变得更加干脆利落。
真实机器人实验:从 44% 到 84% 的跃升
仿真环境往往具有理想化的物理引擎,而在真实物理世界中,机械臂传动间隙、接触表面的摩擦力波动以及相机标定误差会让微小的不对齐迅速演变为严重的物理失误。研究团队在银河通用 AGIBOT G1 双臂人形机器人平台上对 BCP 进行了实机考验。
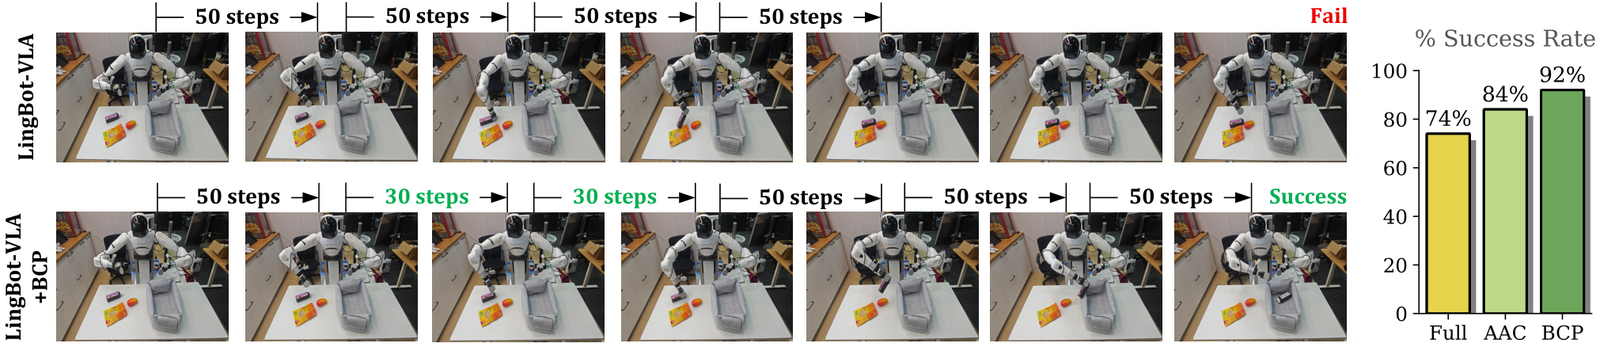
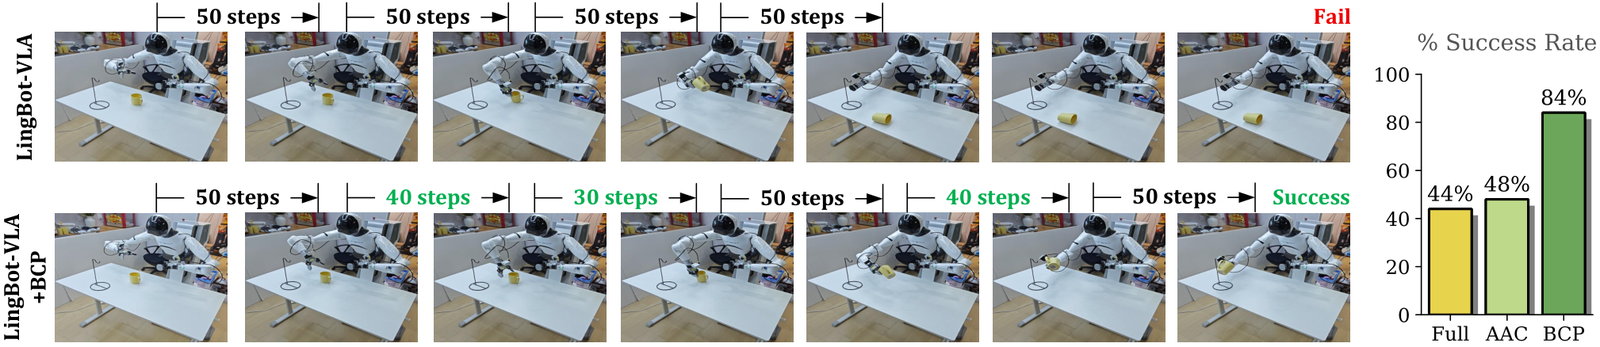
测试选取了两个对重规划时机极度苛刻的具身操作任务:
-
抓取塑料瓶(Grasping Bottle): 瓶身表面极其光滑,任何微小的逼近偏角或接触延迟都会导致瓶子被机械爪推倒滑脱。固定步长策略的成功率为 74%,而接入 BCP 后成功率跃升至 92%。BCP 在夹爪接近瓶身的最后阶段精准缩短步长,及时刷新手眼观测,使夹爪闭合时能够完全贴合瓶壁。
-
悬挂马克杯(Hanging Mug): 这一任务要求机械臂握住杯把,将其精准穿挂在支架纤细的横杆上。对于固定 50 步的基线模型,这一任务极其艰难,只要最后一段进杆动作稍有偏离就会产生硬碰撞,基线成功率仅有 44%(采用注意力启发的 AAC 策略也仅有 48%)。而装备了 BCP 的机械臂展现出了极高的人类级敏捷性:机械臂将杯子快速运送至悬挂架附近时果断触发重规划,重新对准微小的横杆孔位后再执行穿入动作,成功率直接翻倍飙升至 84%。
总结与展望
在追求具身通用大模型(VLA)的大规模扩展时,业界目前的聚焦点绝大多数落在“如何利用海量数据训练更大容量的网络”或是“如何全参微调动作扩散头”。然而,BCP 这项研究揭示了一个更偏系统级但同等关键的盲区:控制策略的有效性,不仅取决于模型脑中“想出”的动作有多好,还取决于系统何时选择相信它、何时选择停下来重新观察。
BCP 巧妙地避免了动辄数十亿参数的全模型昂贵强化学习,仅仅通过在冻结模型之上附加一个具有前缀共享归纳偏置的伯努利决策头,辅以兼顾成功率与推理效率的轨迹级强化学习奖励,就优雅地破解了这一痛点。它向具身智能社区证明:通过精细化重构高层重规划与底层控制执行之间的时间调度关系,即使完全不改动底座大模型本身的参数,也能以近乎零计算代价的轻量方式,释放出巨大的物理操作潜能。