LifelongCrossNav:从平面投影到3D体素记忆,实现跨楼层连续多目标导航
针对这一结构性断层,来自北京智源人工智能研究院(BAAI)与北京大学的研究团队提出了名为 LifelongCrossNav 的具身导航框架。该框架首次将支撑感知的 3D 稀疏体素建图、任务无关的持久视觉语言特征记忆、阶...
知识系统
AGI FRONTIER
深度解读 AI 论文,追踪 Agent、推理、多模态与具身智能的最新进展。
PAPER INSIGHTS
针对这一结构性断层,来自北京智源人工智能研究院(BAAI)与北京大学的研究团队提出了名为 LifelongCrossNav 的具身导航框架。该框架首次将支撑感知的 3D 稀疏体素建图、任务无关的持久视觉语言特征记忆、阶...
为此,研究团队提出了 LAWM-3D 框架,通过揭示并修补传统自监督训练中的“信息泄露捷径”,首次在无标注视频中成功提取出具有真实 3D 几何一致性的潜在动作,并在 16 项评测指标与严苛的分布外(OOD)泛化测试中刷...
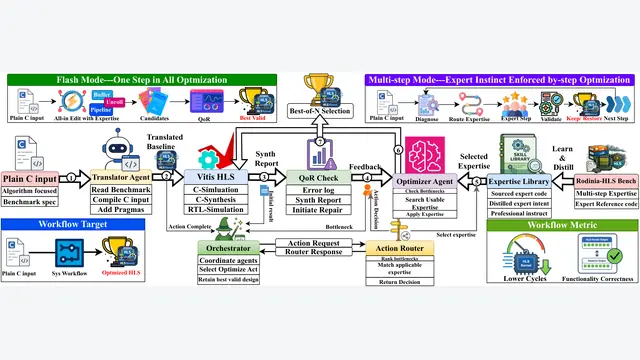
他们提出的 HLSmith 框架将 C 到 HLS 的转换重新定义为“硬件微架构演进”,而非单纯的“代码翻译”。该框架不仅提炼了硬件专家优化技巧并将其模块化、守卫化(guarded recipes),还通过分阶段编译反...
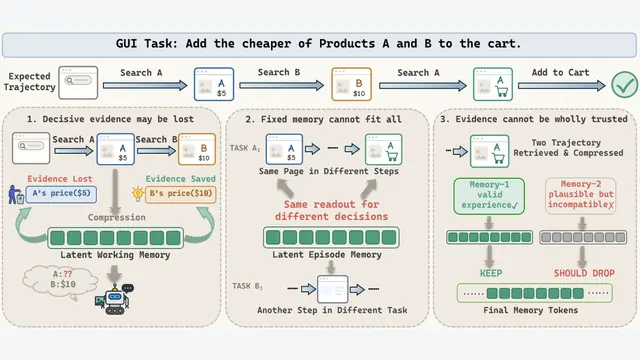
为了彻底解决这一困境,研究团队提出了 FocusMem 。它不再试图打造一个容量更大的黑盒压缩器,而是将隐式记忆的职责明确解耦为三个维度: 存什么(内容基底) 、 怎么看(状态自适应读取) 以及 信不信(置信度门控) 。
EMRD:空间理论(ToS)框架首次提出了“空间信念探测”(Spatial Belief Probing),要求智能体在好奇心驱动下自主探索未知环境,并将内部隐式记忆显式转化为连续的拓扑认知地图。本项研究将这一理念推进...
针对执行引导自纠错中的信任危机,来自北京航空航天大学的研究团队提出了 ExeCRE(Execution-Consistency guided code Reliability Estimation)框架。
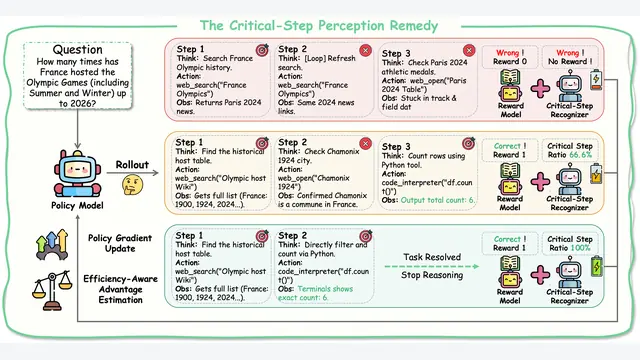
CRISP 提出的核心破局点是“因果证据关联”。一个工具交互步骤是否关键,不取决于它所处的位置或语法结构,而取决于它所获得的观测内容(Observation)是否在因果上直接支撑或促成了最终正确答案的生成。
来自北京通用人工智能研究院(BIGAI)与北京大学的研究团队在最新工作中,通过构建动态评测基准 ContinualSkillBench ,对这一假说进行了严格检验。
IBM:优化器针对一批训练错题提出改写提案后,必须严格在该训练批次上超过原节点得分才会被系统接纳;一旦被接纳,才会在完整验证集上计算 并向祖先节点回传分数累加 与样本计数 。如果提案未能通过初筛,算法只给祖先节点的总访...
为了系统性诊断并逆转这一现象,研究团队提出了一个包含五大维度的“规划对齐失败”(Planning-Grounding Failure)分类体系,并在此基础上设计了轻量级缓解协议 TART(Taxonomy-Guided...
针对这一困境,美团、清华大学与浙江大学的研究团队提出了 AgentOPSD 。该方法不增加任何独立的 Critic 价值网络,也不引入额外的环境采样交互(Rollouts),而是通过在对数几率(Log-odds)空间内...
来自阿里巴巴和中国科学技术大学的研究团队在最新论文中提出了 ADRS(Agentic Reinforcement Learning with Self-Distilled Reward Shaping) 。
实验结果清晰地绘制出了适用边界: 在以深度因果与复杂推导为特征的 BRIGHT 基准上,单靠强向量模型第一阶段只能拿到 22.3 的 nDCG@10;而一旦在后端引入 LLM 列表重排,最终得分直接跃升至 35.1。
” 然而,由 Eigenforma 与 Freemind Labs 联合开展的一项最新测量学审计研究表明,这套遍布生产环境的机制在回答的其实是另一个截然不同的问题:“这段文本的字面措辞改变了多少?
针对这一瓶颈,复旦大学、上海人工智能实验室、上海交通大学与香港科技大学联合提出了安全脚手架演化框架—— SHE (Safety Harness Evolution)。该研究首次将 Agent 的安全外围系统确立为能够通...
这项工作并非简单地堆叠视频时长,而是以构建交互式世界模型为导向,发布了包含 128,892 个视频片段、总计达 2,826 小时的大规模真实世界探索数据集。整个数据集覆盖全球 113 个国家和地区,且全部配备了相机运动...
针对这一洞察,本文提出了无需额外训练的解码算法 Ripple-Pivot Search(RPS) 。该方法不仅在空间上精确定位中熵枢纽(Where),更通过轻量前瞻评估在候选词集合中自适应搜索最优 Token(What)。
RealisticTritonBench:实验结果给大模型在底层系统优化上的应用浇了一盆冷水:即使是当前最顶尖的推理与代码模型,在真实系统环境下的综合任务成功率最高也仅有 25.81%,全模型平均成功率低至 18.71%。
为了抹平这一因模态切换带来的能力损伤,研究团队提出了名为 CAPS (Cross-modal Agentic Policy Self-distillation,跨模态智能体策略自蒸馏)的统一训练框架。
该工作不仅建立了一个包含 3,000 个经过真实 API 执行验证的高质量中文测试集,更首次提出了能够实现自我迭代演进的双阶段闭环构建框架 PCCF(PluginEval Closed-Loop Constructio...
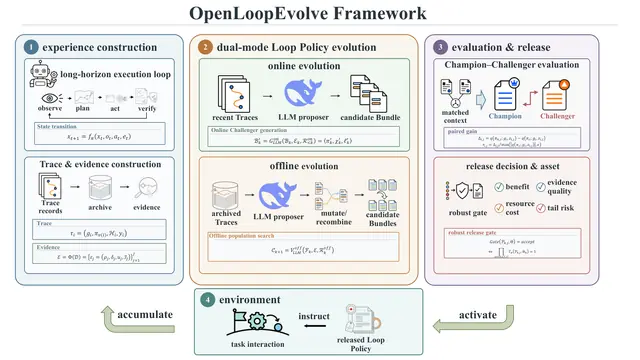
清华大学团队提出的 OpenLoopEvolve (简称 OLE )试图从底层逻辑上改变这一现状。该研究不再把交互控制视为不可分割的代码黑盒或易受干扰的纯文本上下文,而是首次提出了可治理、可验证的“循环策略”( Loo...
OmniScientist:真正的科学研究是一个动态闭环:对原始实验数据的直接观察决定了提出什么假说;实验执行后的原始曲线又决定了下一步如何修正方案;最终论文里的每一个主张,都必须严格回溯到观测细节。缺乏端到端感知的自...
无论是各类商业化的研究助手,还是开源社区构建的自动化研究流水线,都在尝试让大语言模型处理极其开放且复杂的调研任务。然而,这类长程(Long-horizon)任务普遍伴随着极其高昂的计算代价:智能体沿着分解出的子问题不断...
针对这一瓶颈,耶鲁大学的研究团队提出了名为 MoRSE (Task-Oriented Multi-Agent System with Mixture of Role-Subtask Experts)的新型多智能体框架。