StepReflect:结构化UI状态反思,8B模型准确率反超GPT-5.2
针对这一痛点,康考迪亚大学(Concordia University)的研究团队提出了 StepReflect。这项工作打破了“用昂贵前沿大模型做开放式单步反思”的传统路径,首次将移动界面的单步动作反思形式化为一种 基...
AI Agent
AGI FRONTIER
深度解读 AI 论文,追踪 Agent、推理、多模态与具身智能的最新进展。
PAPER INSIGHTS
针对这一痛点,康考迪亚大学(Concordia University)的研究团队提出了 StepReflect。这项工作打破了“用昂贵前沿大模型做开放式单步反思”的传统路径,首次将移动界面的单步动作反思形式化为一种 基...
来自美国东北大学与明尼苏达大学的研究团队提出了全新解决方案 SparseDitto 。该系统将大语言模型(LLM)的开放代码生成能力与基于真实硬件测量的闭环反馈相结合,为任意给定的稀疏矩阵、算子和目标 GPU 动态定制...
与以往只在玩具数据集或单机沙盒中跑代码的 Agent 不同,RecEvolve 直接接入了分布式仓储计算集群与生产级版本控制系统,端到端接管了“提出假设、编写代码、拉起分布式训练、指标评估到沉淀经验”的完整研发闭环。
为了厘清这一因果机制,研究人员构建了专门面向持久化个人 Agent 的归因基准 PAST-Bench,并在其诊断指导下设计了增强运行时框架 Hermes+。这项研究不仅揭示了当前主流大模型与智能体框架在跨会话经验复用上...
针对这一交互硬伤,阿里团队提出了 PACE (Playback-Aligned Context Engine,播放对齐上下文引擎)。这是一个独立于具体模型厂商的中间件层,它把客户端真实的音频播放边界作为物理代理锚点,将...
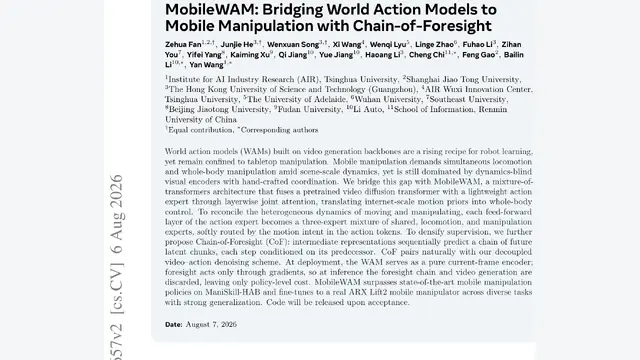
为此,清华大学智能产业研究院(AIR)、上海交通大学、香港科技大学等多家机构联合提出了 MobileWAM ,首次将视频生成世界动作模型系统性适配到全身移动操作中。
由北京邮电大学、复旦大学、南洋理工大学、北京大学、上海交通大学等多所高校联合提出的最新研究 MemPrism ,指出了一个长期被忽视的底层瓶颈: 检索后表征失配(Post-retrieval Representatio...
针对这一困境,研究者提出了面向 Lean 4 与 Mathlib 原生的智能体框架 MechGeo 。该框架将自动形式化与形式化证明置于统一的验证闭环中:前半段通过解耦的中间表示语言 GeoIR 实现确定性编译与语义修...
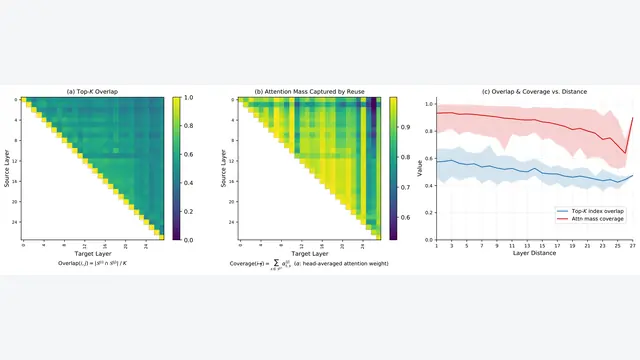
LongCat:其中,DeepSeek 提出的 DeepSeek Sparse Attention(DSA)凭借独立的轻量化检索器 Lightning Indexer,实现了精细的 Token 级动态检索,不仅在 De...
针对这一瓶颈,研究团队提出了全局化技能演化框架 GSE ( Globalized Skill Evolution )。该方案不再将技能视为孤立文本的线性堆叠,而是引入 技能关系图 ( Skill Relation Gr...
针对这种“高开销”与“信息丢失”的死锁,合肥工业大学的研究团队提出了轻量级长期记忆框架 LeanMem。该方案的核心洞察在于: 人类对话产生的信息天然具有异构性,试图用单一、均匀的“摘要-检索”流水线去处理所有对话历史...
为了精确刻画风险在系统内部渗透的深度,HarnessSafe 提出了一套基于客观执行证据的七阶段评估阶梯(N0 到 N5b): N0(未接触) :系统在执行中甚至未与受污染的载体表面产生任何交互; N1(接触未驻留) ...
基于这一观察,作者提出了名为探针过滤引导训练(Probe-Filtered Bootstrapped Training, PBT)与探针引导重排(Probe-Guided Reranking, PGR)的完整框架,并构...
为此,研究团队设计了一套可执行的合成任务生成引擎,并提出了 Fisher-R1 智能体训练范式。该框架从统计检验方法、应用领域情境、样本规模、效应量大小、提示词风格和随机种子六个正交维度出发,程序化生成了 8,642 ...
针对这一核心断层,Meta AI 联合伊利诺伊大学厄巴纳-香槟分校(UIUC)提出了 EvoHarness-RL 框架。这项研究不再把外部支架看作不可修改的环境包装或静态脚手架,而是将其抽象为可由策略直接调度的元动作空间。
针对这一工程痛点,NVIDIA 团队提出了一种全新的解决思路: 跨模型 KV 缓存迁移(Cross-Model KV Cache Transfer) 。研究人员发现,同家族但不同尺寸的模型之间,其 KV 表征存在着显著...
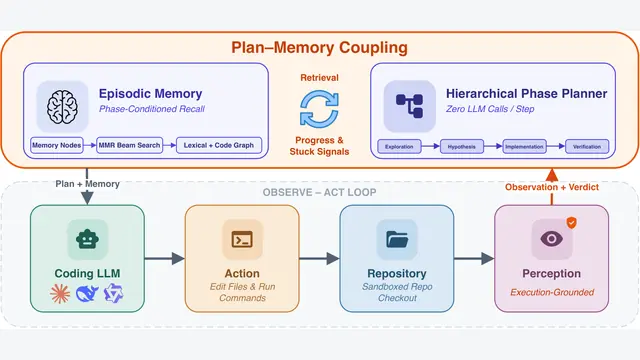
来自范德堡大学(Vanderbilt University)的研究团队提出了名为 PMCoder 的软件修复智能体,核心机制在于将分层阶段规划器(Hierarchical Phase Planner)与情境记忆(Epi...
CliniCARE-Bench 正是基于这一严苛的部署导向而构建。研究团队依托 MIMIC-IV 真实患者数据集,设计了 25 个经由临床专家严格验证的审计场景,共实例化为 750 个具体的纵向病历案例,横跨 14 个...
Google:实验结果清晰地表明了“盲目提示”与“精准开药”的差距。仅仅依靠第二阶段的泛化指令,模型往往在代码外围做无用功,甚至引发代码膨胀;而一旦在第三阶段提供精准的缺陷分类反馈,模型便能准确识别此前遗漏的性能陷阱。
针对这一核心瓶颈,来自 AweAI、中国人民大学及独立研究团队的研究者们提出了 CalibForge 。这是一套基于 对抗求解器校准 (Adversarial Solver Calibration)的自主终端任务合成系统。
针对这一根本隐患,研究团队提出了 观察校准自蒸馏(Observation-Calibrated Self-Distillation, OCSD) 。该方法通过构建两套结构完全对齐、仅差真实环境观测的回放视图,精准剔除回...
为了打破单次判决的局限,来自南京大学、南洋理工大学与新加坡管理大学的研究团队提出了 AgentAntibody 。该工作借鉴生物学中的自适应免疫系统(Adaptive Immune System),首次为大模型智能体建...
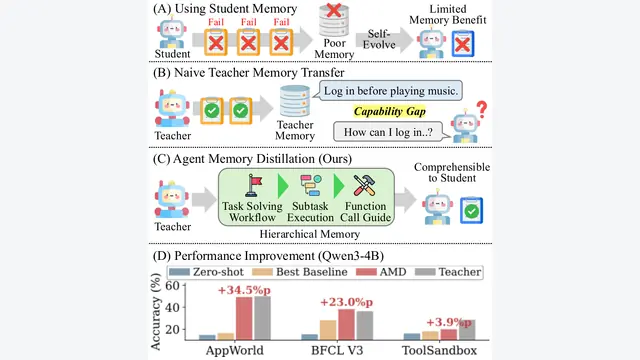
为了攻克这一难题,来自韩国科学技术院(KAIST)与 DeepAuto.ai 的研究团队提出了一种无需重新训练参数的全新框架:Agent Memory Distillation(AMD,智能体记忆蒸馏)。
来自上海交通大学的研究团队提出了名为 ABC(Answer-Backtracked Credit Assignment,答案倒推信用分配) 的全新框架,并基于 Qwen3.5-4B 训练出了长程搜索智能体 ABSeek...