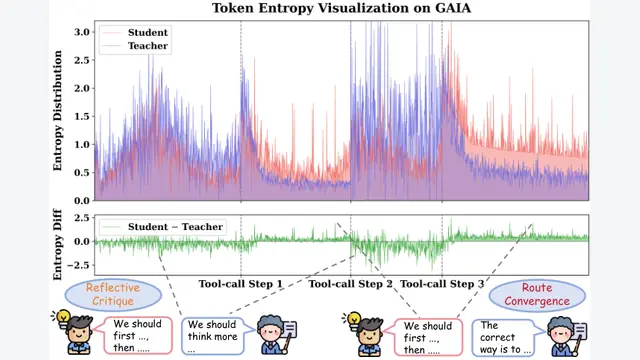
CRPO:用对比自蒸馏重构智能体强化学习,8B模型跨级超越32B基准30个点
针对这一本质缺陷,本文提出了对比强化策略优化(Contrastive Reinforced Policy Optimization,简称 CRPO)。CRPO 彻底跳出传统蒸馏单纯拟合分布的旧思路,将智能体自蒸馏重构为...
AI Agent强化学习
AGI FRONTIER
深度解读 AI 论文,追踪 Agent、推理、多模态与具身智能的最新进展。
PAPER INSIGHTS
针对这一本质缺陷,本文提出了对比强化策略优化(Contrastive Reinforced Policy Optimization,简称 CRPO)。CRPO 彻底跳出传统蒸馏单纯拟合分布的旧思路,将智能体自蒸馏重构为...
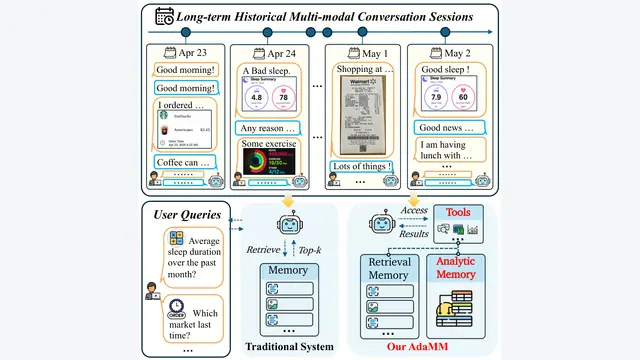
针对这种 检索与分析的结构性失配 (Retrieval–Analysis Mismatch),一项最新研究提出了 AdaMM (Adaptive Multi-view Memory)框架。
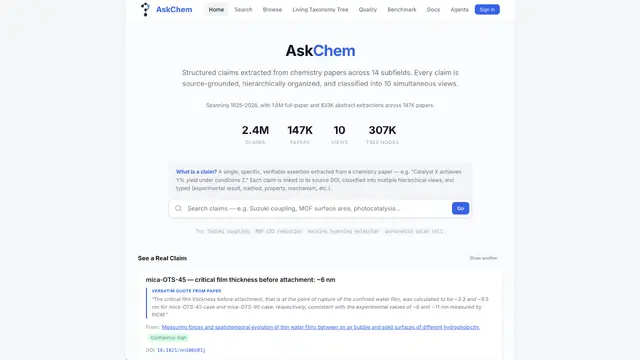
近期开源的学术检索基础设施 AskChem 提出了一个根本性的转变方案:彻底打破以整篇论文为基本检索单元的传统做法,转而将承载可溯源信息的“原子化科学断言”(Provenance-carrying Claim)作为核心对象。
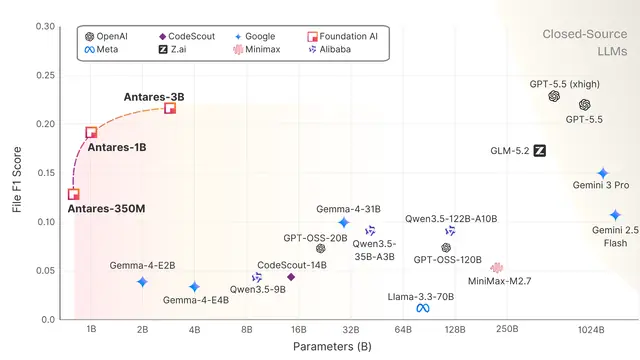
这项研究最引人注目的实验结果在于:在涵盖 500 个真实工业任务的基准测试 VLoc Bench 上,仅有 30 亿参数的 Antares-3B 在定位文件 F1 分数上达到了 0.223,不仅逼近了顶尖闭源模型 GP...
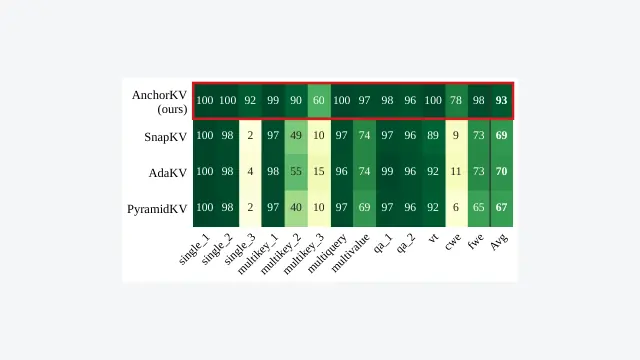
最新提出的 AnchorKV 彻底打破了这种两难困境。它在 不丢弃任何一个 Token 位置 的前提下,将 KV 缓存体积压缩了整整 20 倍。在 70B 参数规模的模型上,AnchorKV 在 20 倍极致压缩下依然...
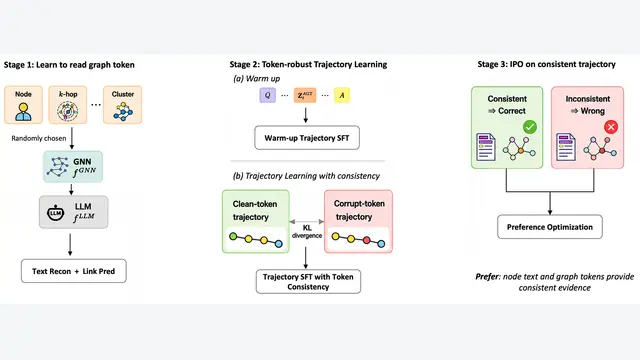
针对这一困境,研究者提出了 AGT(Agentic Graph Token Reasoning,智能体图 Token 推理) 框架。这项工作的突破之处在于:它没有继续在“如何把子图压缩得更紧凑”上打转,而是从底层将图的...
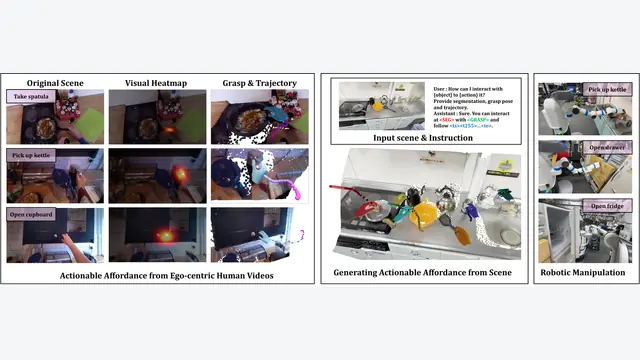
团队构建了一个拥有 20.4 万条视频片段、千万级标注的大规模第一人称数据集 EgoAffordance ,并在此基础上提出了统一的多模态视觉-语言-操作引导模型 VLAff (Vision-Language-Affo...
来自北京人工智能研究院(BAAI)、北京理工大学、北京工业大学、湖南大学、奥克兰大学、澳门大学和悉尼科技大学等机构的研究团队,针对这一痛点推出了视频真值诊断基准 VideoVIBE,并同步提出了免训练的多智能体协同诊断...
针对这种执行失真,研究团队提出了 TRACE ( Trajectory-Relative Agent Context ComprEssion )框架。该方法抛弃了依靠终局任务成败做逆向归因的粗粒度反馈逻辑,转而在发生压...
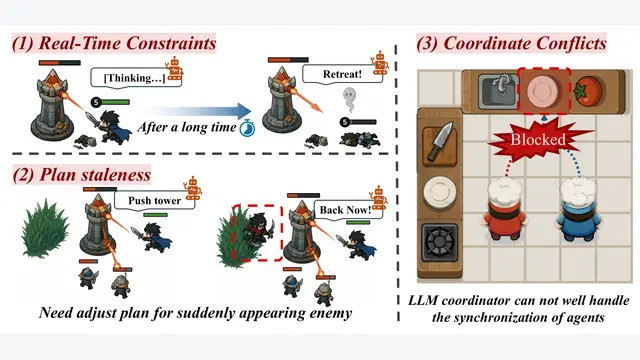
针对这一核心冲突,最新研究提出了名为 SyncPlan 的“规划-执行-修正”(Plan-Execute-Correct)长程多智能体协同框架。该框架让中心化 LLM 在单次调用中生成带有显式同步原语的长程动作链,在底...
这项研究正式提出了“多步间接提示注入”攻击范式,并开源了专门针对 CUA 评估的基准测试框架 StepJack 。实验揭示了一个令人警惕的结论:拆解并非削弱了攻击威力,反而是绕过安全机制的倍增器。
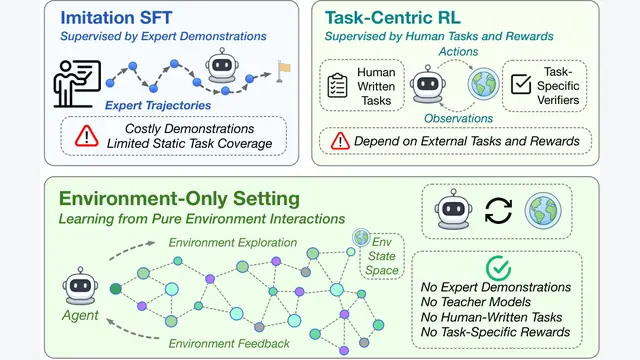
面对这一困局,来自阿里巴巴和清华大学的研究团队提出了全新的解决思路: State2State 。这项研究不再纠结于“如何让人类或更强的大模型生成更多任务”,而是退回智能体交互的最本质关系——智能体与环境。
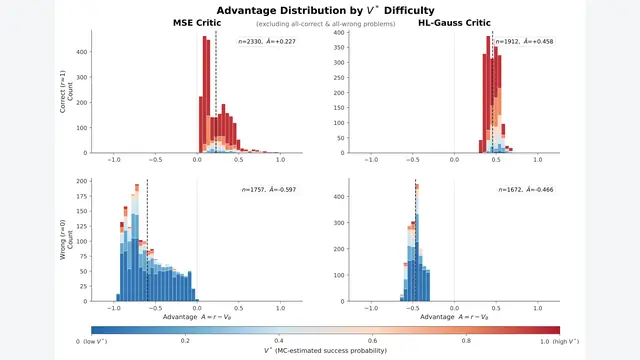
为此,本文提出了 HL-Gauss PPO :彻底放弃标量的 MSE 回归头,改用带有高斯平滑的离散分类头来学习价值分布,最后仅通过求期望还原出标量值供 PPO 使用。
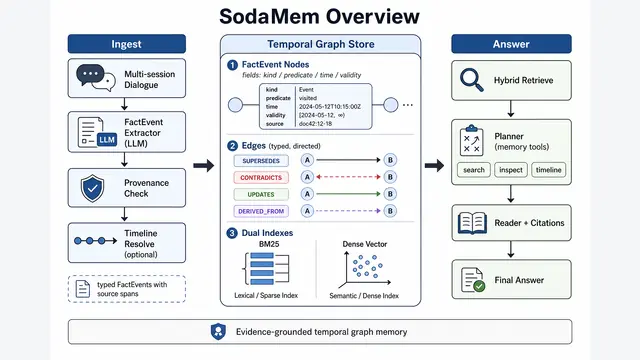
针对这一长期记忆难题,来自北京大学的研究团队提出了 SodaMem 。该工作将 Agent 的长期记忆重新定义为一种强证据溯源的时序知识图谱(Evidence-Grounded Temporal Graph Memory)。
针对这一问题,该研究提出了包含 61,228 个技能的新基准 SkillReason-Bench ,并设计了名为 SkillReason 的双阶段推理增强框架。
面对这个难题,来自字节跳动、上海交通大学、清华大学、香港大学和东京大学的研究团队提出了全新视角:将大模型时代的后训练数据选择转化为一个成熟的“工业级推荐系统问题”,并推出了相似性数据挖掘框架 SiMDex 。
为了打破被动排名的局限,Meta 提出了名为 Shape Your Feed (简称 SYF )的大模型主动推荐系统。该系统让大语言模型扮演结构化控制器的角色,构建了包含感知、在线服务与自我进化的三层架构,打通了用户显...
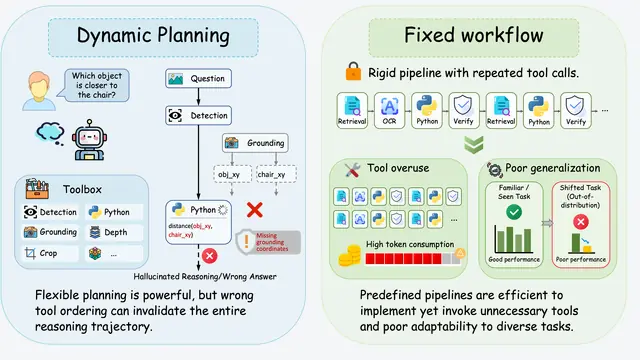
针对这一核心痛点,研究团队提出了名为 NeSy-Spatial 的神经符号空间技能自演进框架。该框架放弃了从零临时规划或套用僵化模板的做法,而是将工具交互与几何算法解耦并抽象为可执行的原子指令,进一步组合成 Tool-...
为此,他们提出了一种名为 OEO (Open-Ended Optimization,开放式优化)的极简范式:框架仅负责严格锁定目标、预算、权限和评测红线,而把“何时收集证据、如何诊断失败、提出何种粒度的修改以及何时停止...
本文提出了 轨迹后门攻击 ( Trajectory Backdoor Attack ,简称 TBA )。在完全无需触碰技能代码、没有任何提权行为,甚至仅拥有普通用户提问权限(Query-only)的前提下,攻击者只需巧...
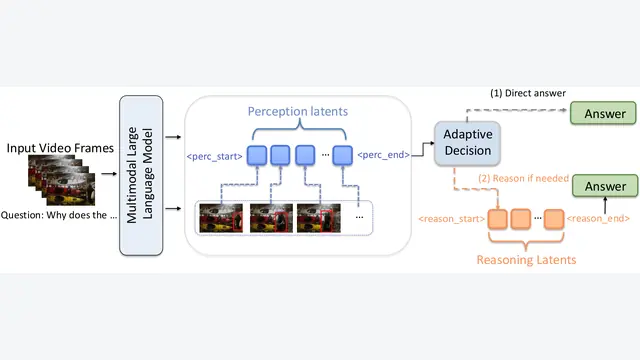
针对这一核心痛点,来自佐治亚理工学院(Georgia Institute of Technology)与莱斯大学(Rice University)的研究团队提出了名为 DyLaR (Dynamic Latent Rea...
针对这一本质矛盾,研究团队提出了全新的视觉工具轨迹构建框架 OpenVisTool 。该工作的核心见解在于:一条有价值的教学轨迹,必须同时满足 结果正确性(Outcome Validity) 与 因果效用(Causal...
针对这一核心瓶颈,来自华为、慕尼黑大学(LMU)、慕尼黑工业大学(TUM)、浙江大学等机构的研究团队提出了 MemWM (Memory-Augmented Text-Based World Model)。
为此,研究团队提出了 MemOPD (Memory-Aligned On-Policy Distillation)框架,在长程问答基准上使 3B 模型的 F1 值相比纯 PPO 基线最高跃升 416.2%,并在保证数值...