Vilya-2:全原子扩散击败共折叠模型,多肽界面建模恢复率达59.1%
Accurate structural modeling of chemically diverse molecular interfaces with Vilya-2
在以 GLP-1 受体激动剂司美格鲁肽为代表的药物掀起产业狂潮后,多肽与大环分子已成为现代生物医药最具潜力的赛道之一。它们既具备小分子易于规模化生产、口服生物利用度高的潜力,又能像单克隆抗体一样精准阻断复杂的蛋白质-蛋白质相互作用(PPI)。然而,真正具有成药潜力的多肽分子往往极其“离经叛道”:它们充斥着非天然氨基酸、复杂的烃链交联(Stapling)、大环化拓扑以及非标准化学键修饰。
ArXiv URL:https://arxiv.org/abs/2607.25156v1
面对这类分子,过去几年大放异彩的蛋白质结构预测大模型集体遭遇滑铁卢。无论是依赖共进化信息(MSA)的传统预测工具,还是近期以 AlphaFold3、Boltz 为代表的多分子共折叠(Co-folding)网络,在面对含有非天然拓扑的多肽复合物时,经常输出扭曲的手性、错误的键长,甚至产生完全不切实际的结合构象。从头设计多肽药物(De novo peptide design)的核心瓶颈,已经从“能不能生成序列”,变成了“有没有一个靠谱的结构预测裁判(Oracle)来筛选有效分子”。
AI 制药初创公司 Vilya Research 给出的破局方案是 Vilya-2。该模型彻底摒弃了蛋白质大模型长期沿用的“残基-原子双轨制”与共进化依赖,将整个复合物系统统一降维至“全原子化学图”,并基于纯扩散 Transformer 框架建模。在团队最新构建的化学多样性多肽基准 Riptides 上,Vilya-2 实现了 59.1% 的骨架 RMSD < 2 Å 高精度预测恢复率;即使将结合态受体晶体结构直接作为模板投喂给代表性共折叠模型 Boltz-2,后者的成功率依然被 Vilya-2 远远甩开。这项研究不仅为多肽药物研发补齐了关键的评估基石,也宣告了全原子表征在跨尺度分子互作建模中的巨大威力。
共折叠模型的盲区与全原子图的彻底重构
要理解 Vilya-2 的颠覆性,必须先看清现有共折叠模型在多肽设计中的根本困境。
现有的生物大分子预测模型大多从单链蛋白质折叠演化而来。在架构底层,这些模型习惯将分子切分为“残基 Token”(针对天然氨基酸序列)与“原子 Token”(针对小分子或配体修饰)。这种割裂的表征方式在面对经典天然蛋白时运转良好,但在多肽药物分子面前却暴露出两一致命缺陷:
其一,知识迁移受阻与严重记忆化。非天然多肽处于小分子与天然蛋白的灰色地带。残基-原子双轨制使得模型无法直接将在海量小分子晶体中学习到的立体化学规则无缝迁移至肽链主干,导致网络极度依赖多序列比对(MSA)提供的进化信息,或者直接去死记蛋白质数据库(PDB)中已有的同源结合口袋。一旦药物设计遇到全新的作用口袋或罕见的环状交联拓扑,共折叠模型的预测性能便呈断崖式下跌。
其二,几何与手性崩溃。很多大环多肽通过非肽键连接(如烃链缝合、二硫键套索等),甚至骨架本身就缺乏明确的 N 端与 C 端方向性。当强制将其塞入基于残基主链框架的模型中时,经常出现严重的立体碰撞、反常二面角,甚至错误的四面体中心手性翻转。
Vilya-2 的核心设计哲学非常激进:完全抹去“蛋白质”、“多肽”与“小分子”的分类界限,不做任何残基级 Token 化,不使用任何序列进化信息。
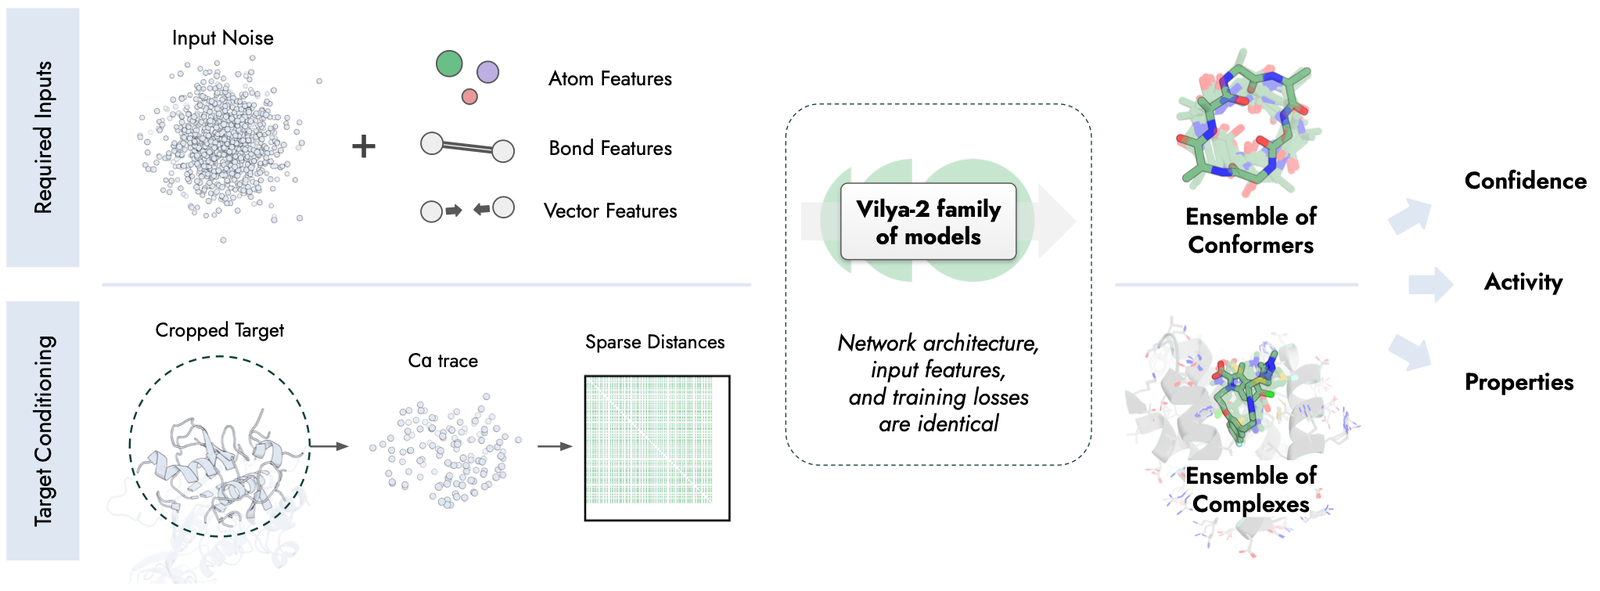
输入模型的是一个纯粹的化学分子图,图中的每个节点即为一个重原子,边则代表共价键。每个原子节点只携带最纯粹的基础物理化学属性:元素种类、杂化状态、形式电荷、键级、共轭/芳香性状态,以及辅助指示局部立体几何与四面体手性中心的手性向量。靶点蛋白质、辅因子、无论线状还是高度交联的拟肽配体,全部一视同仁地平铺在同一个全原子图里。
任务降维:聚焦局域柔性对接的骨架条件化
既然放弃了整蛋白残基表征,如果让模型从零开始连同整个庞大受体蛋白质的几万个原子一起进行从头全折叠,在计算复杂度与收敛难度上显然不切实际。
Vilya-2 在此做出了极其务实的工程取舍:将任务从“全局共折叠”明确收敛为“受体结构约束下的局域柔性界面建模”。在实际药物发现管线中,生物医药团队通常早已通过冷冻电镜、晶体学或可靠同源模型明确了靶点的三维轮廓以及结合表位(Epitope)。此时的核心挑战从来不是重新预测受体整体如何折叠,而是在受体骨架大致固定时,配体如何调整构象、受体活性口袋的侧链如何发生诱导契合(Induced fit)。
具体而言,Vilya-2 包含两个核心主干:单分子构象生成器(Conformer Generator)与靶点条件化复合物预测器(Complex Predictor),二者共享完全相同的全原子扩散 Transformer 架构与物理化学特征嵌入。
在复合物界面预测阶段,除了全系统统一的化学图外,模型仅额外接收一个二维先验特征:来自参考受体晶体结构的非配体蛋白质 $C\alpha$ 原子(以及核酸 $C4’$ 原子)的稀疏距离矩阵。扩散过程贯穿整个 Transformer 骨干网络,而不是仅挂在条件主干顶部的外置模块。模型借助 $C\alpha$ 骨架提供的刚性轮廓,全自由度地联合扩散预测配体所有原子与受体侧链原子的坐标。这种设计既规避了庞大受体无序折叠的计算陷阱,又完整保留了结合界面原子级的相互适应能力。
填补行业空白:Riptides 评测基准与多肽预测飞跃
为了检验模型在极具挑战的多肽化学空间中的真实能力,Vilya 团队推出了专门针对该领域的基准测试集 Riptides(已开源)。
长期以来,业界评估小分子对接常用 PoseBusters,评估蛋白-蛋白相互作用有 CASP 或 CAPRI,但唯独缺乏针对非天然、大环化、复杂交联多肽的权威基准。Riptides 共精选收录了 88 个高质量的蛋白质-多肽复合物晶体结构:
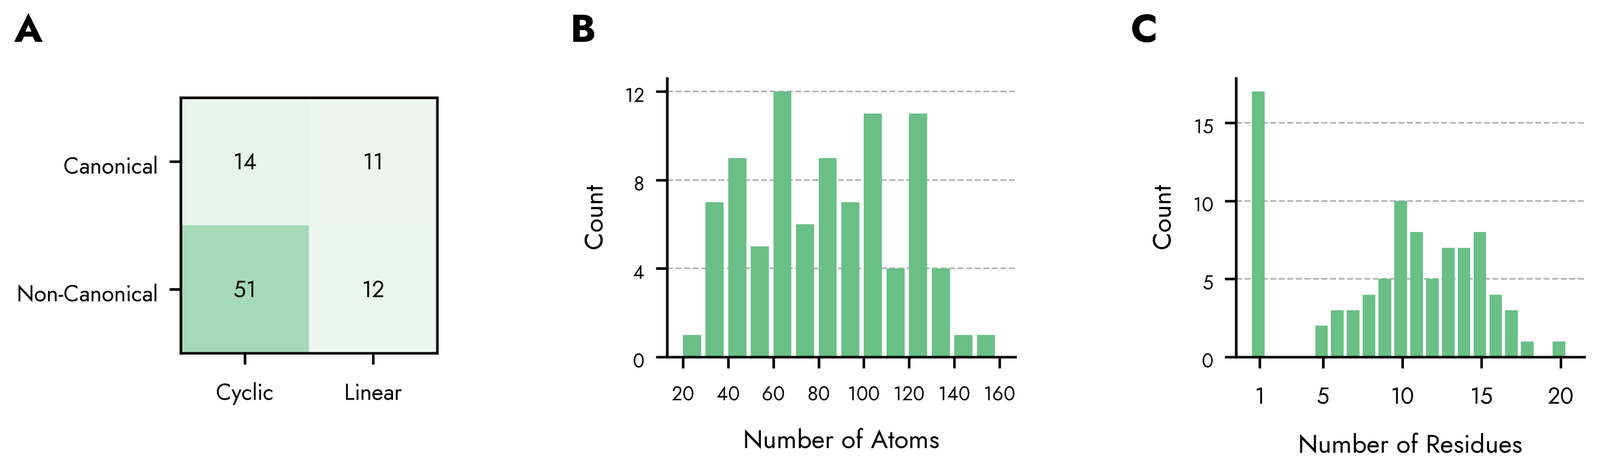
从拓扑结构来看,这 88 个复合物中,含有非天然修饰的大环多肽占据绝对统治地位(51/88),其余由天然大环、非天然线肽和天然线肽构成。配体原子规模横跨数十至数百个原子,包含大量在 PDB 中甚至被粗暴标注为“非聚合物”的复杂化学实体。为了保证评测公平,Vilya-2 的训练集截止日期严格锁定在 2021 年 9 月 30 日之前,所有基准样本均在训练集时间线之后或完全不含同源数据。
在 Riptides 基准上,评估指标采用多肽配体骨架 RMSD。常规共折叠模型 Boltz-2 即便在推理时被直接输入结合态受体的真实坐标作为“作弊”模板,其结合界面预测表现依然疲软:达到亚 2.0 Å 骨架精度的比例仅有 10% 左右,亚 1.0 Å 的超高精度预测更接近于零。
而采用纯全原子扩散的 Vilya-2 在同一基准上直接取得了 59.1% 的亚 2.0 Å 成功率,骨架 RMSD < 1.0 Å 的严苛高精预测比例更是接近 30%。这证明当剥离了虚幻的序列同源偏置、深入到底层化学物理图之后,模型反而能够更精确地理解复杂非共价相互作用的排布规律。
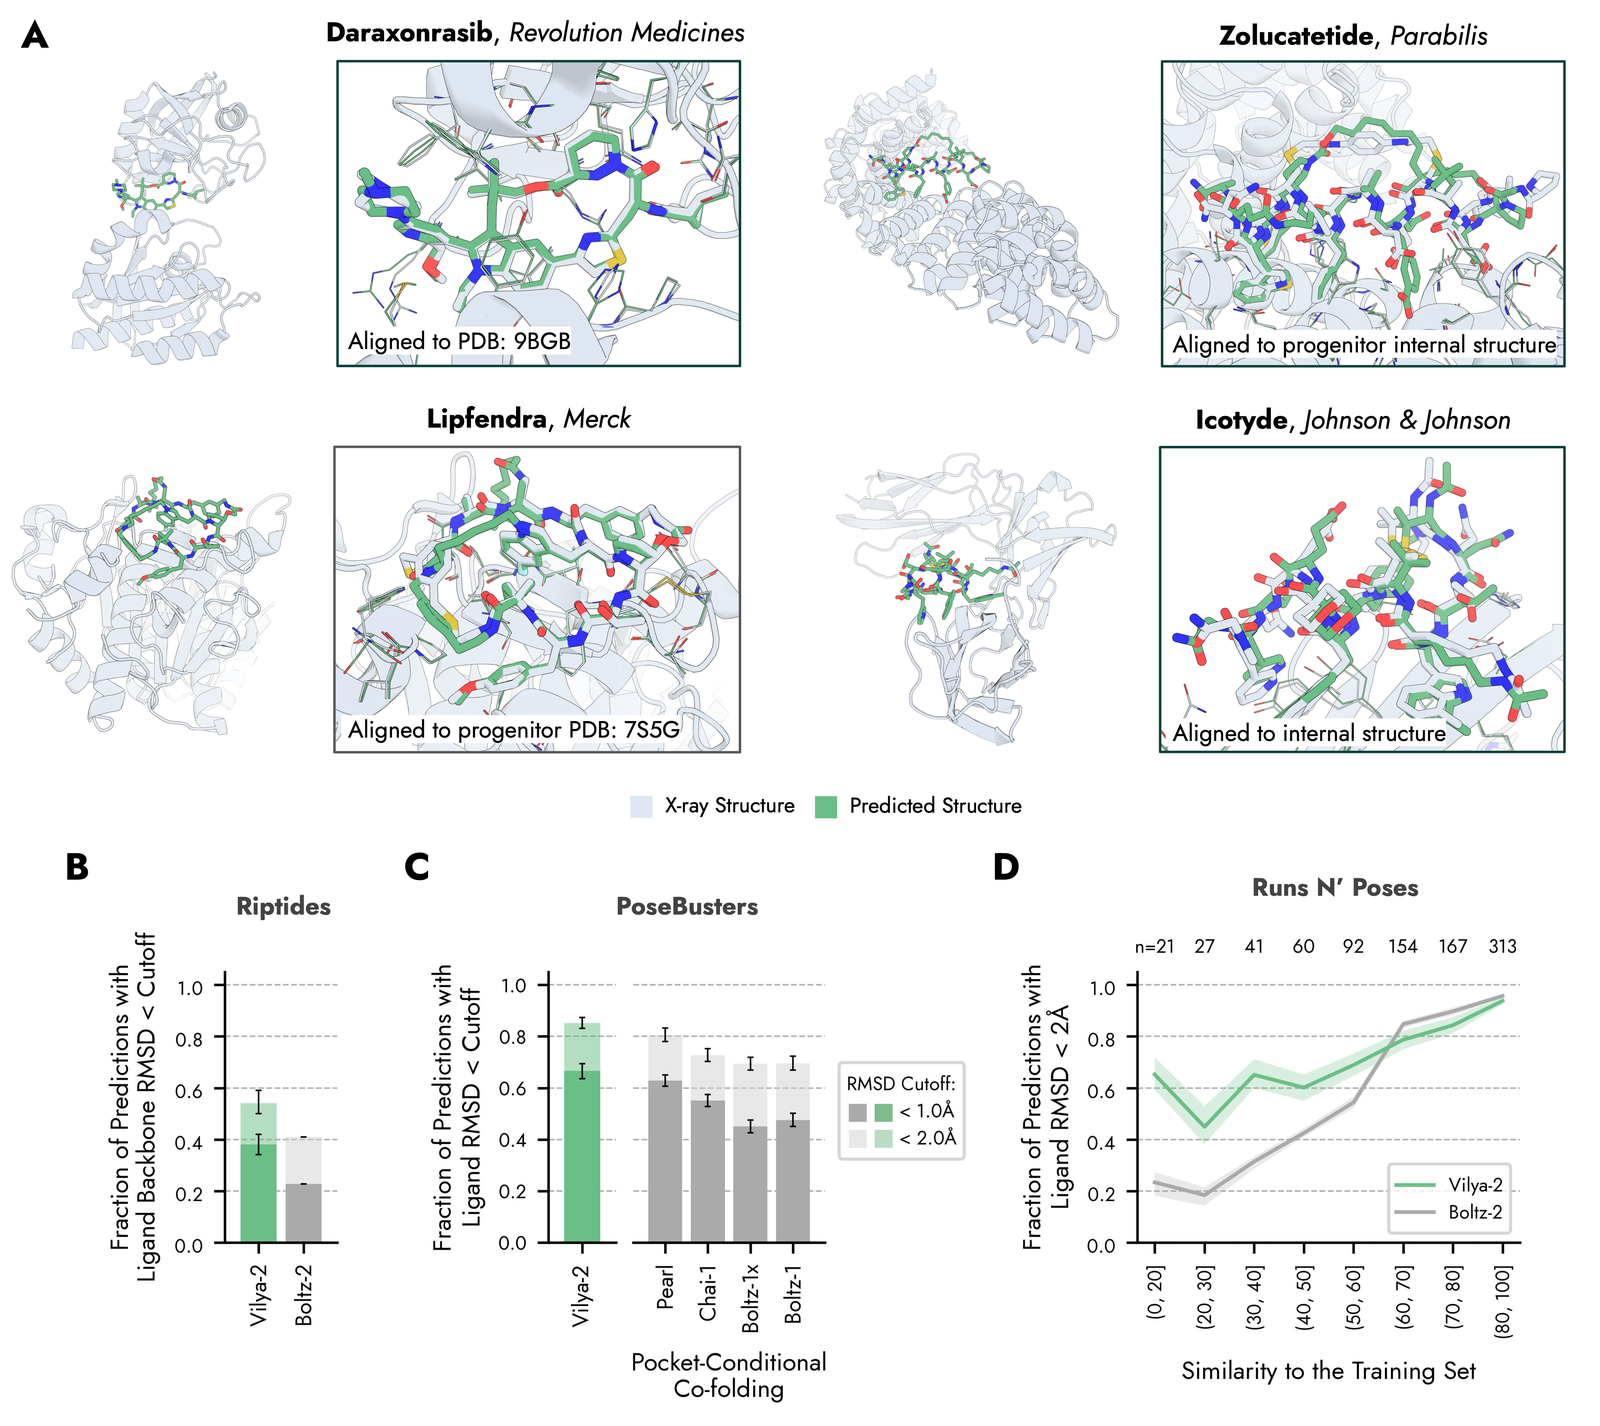
不仅在统计指标上领先,Vilya-2 对目前已进入临床或已获批的多款超高难度明星药物大环的预测同样令人信服:
-
Zolucatetide(靶向 $\beta$-catenin 的碳氢穿透肽):该分子包含三个独立的侧链-侧链交联共价桥(两个不同跨度的碳氢链和一个酰胺键),Vilya-2 完美复原了交联强行锁定的 $\alpha$-螺旋结合构象。
-
Icotyde(近期获批用于银屑病的二硫键套索肽):分子内含有一个奇特的二取代氧杂环己烷(Oxane)非天然氨基酸,Vilya-2 准确还原了该非天然修饰诱导稳定形成的螺旋短尾。
-
Lipfendra(靶向 PCSK9 的口服大环候选药):该分子没有任何规则二级结构,完全依靠错综复杂的化学交联锁定在结合构象,Vilya-2 同样在无模板先验下近乎完全复现了先导晶体中的关键相互作用模式。
-
Daraxonrasib(靶向 KRAS 的大环候选药):该分子整体几乎由小分子砌块构成,仅保留极少数酰胺键,传统肽模型完全无法解析,Vilya-2 同样以极高精度命中晶体结构。
推理期扩展与置信度校准:找回 AI 的“物理折叠漏斗”
如果说高精度的生成能力是 Vilya-2 的锋刃,那么它的“推理期扩展”(Inference-time scaling)与置信度打分体系则是让其真正成为药物筛选核心的基础。
现代大语言模型和视觉模型的飞跃,在很大程度上得益于推理期的思维链展开或重采样搜索。但在基于共折叠的结构预测模型中,若想增加采样,往往必须将沉重的特征提取骨干网络与扩散头整体重跑一遍;更关键的是,已有研究(如 Pearl、Boltz-1x 相关工作)表明,共折叠模型的输出分布极易坍缩,即便反复采样上百次,生成的构象分布也高度局限,缺乏结构多样性。更严重的是,这些模型自带的置信度评分(pLDDT)在打分受体-配体结合界面时,表现往往“接近随机猜测”,根本无法作为挑选正确构象的可靠判据。
Vilya-2 依靠纯扩散 Transformer 架构改变了这一现状:所有的多样性生成完全通过在轻量化扩散阶段调整随机种子实现,可以在极低计算代价下实现数百乃至数千次采样。
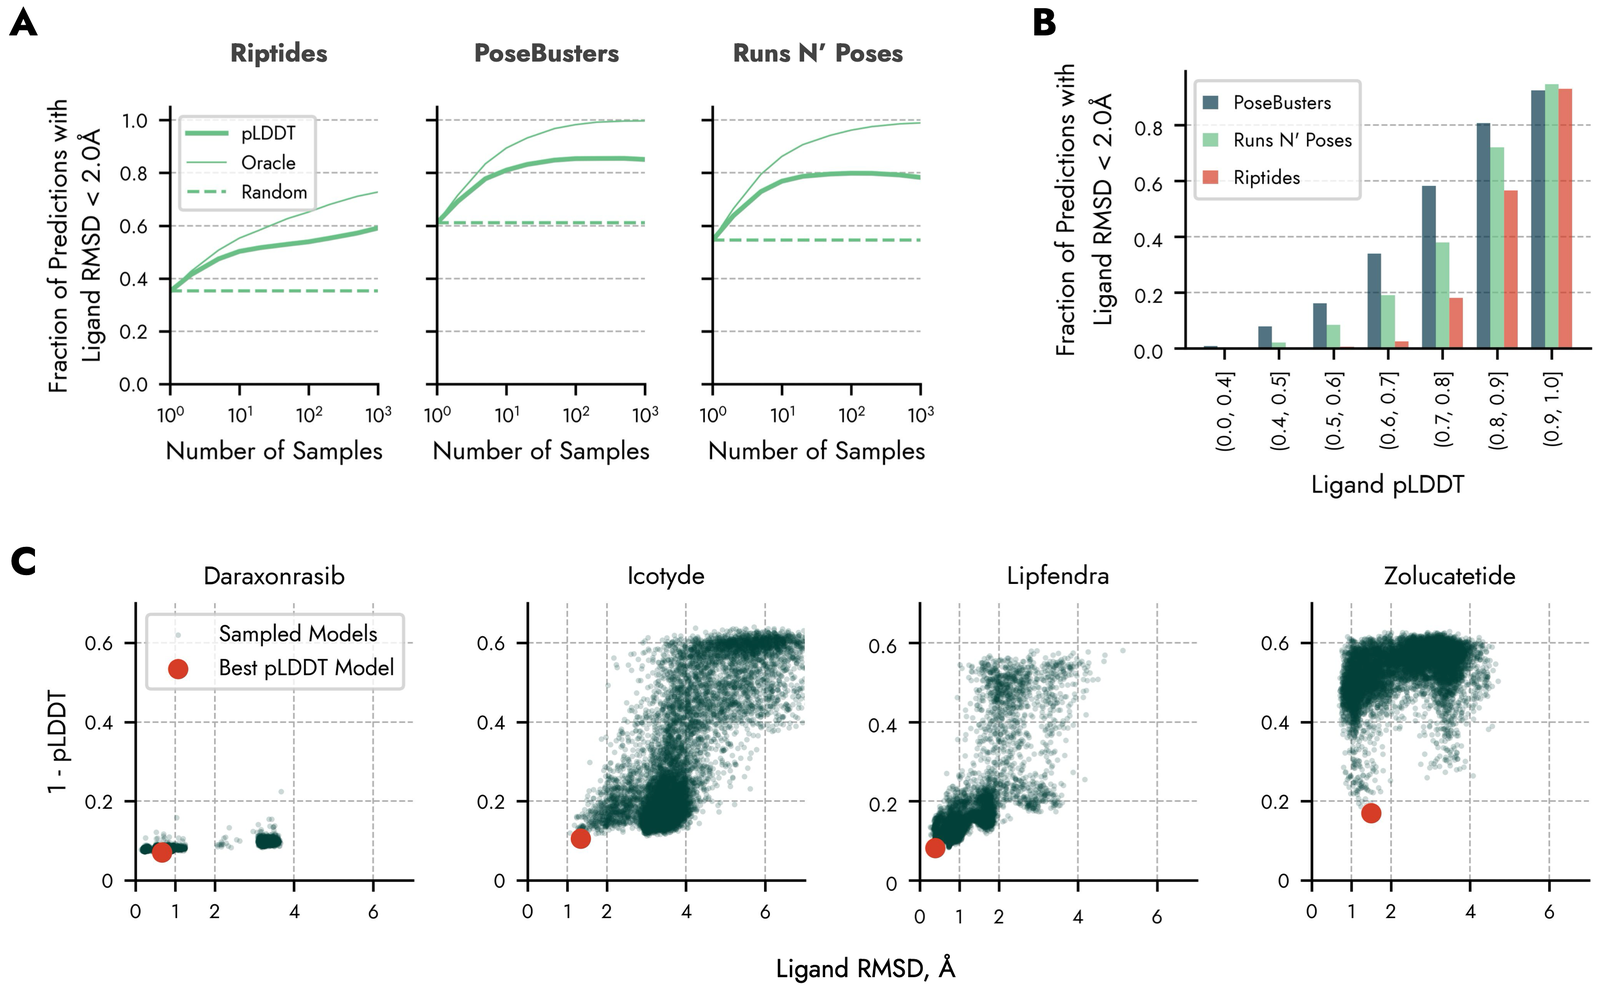
如图 4A 所示,在 Riptides 以及标准小分子基准(PoseBusters、Runs N’ Poses)上,随着采样数量从 1 个提升至 100 个乃至 1000 个,配合置信度打分模型的筛选(绿粗线),最终输出模型的预测成功率呈现稳步单调上升趋势。对于空间搜索极其繁琐的多肽分子,采样扩展到 1000 次时收益依然没有见顶。
更可贵的是 Vilya-2 的置信度校准特性。研究团队基于预训练骨干网络,微调了一个专门用于预测局部距离差异测试得分(lDDT)的置信度评估头。实测表明,模型输出的配体平均打分(plddt-ligand)与真实精度的相关性极高(图 4B):当 plddt-ligand 打分高于 0.8 时,预测构象处于全原子 RMSD < 2 Å 成功范围内的经验概率超过 60%;而当打分低于 0.6 时,系统则发出了极其明确的信号——当前采样池中尚未捕获到真实结合构象,必须继续扩大采样规模。
这种“高效多样性采样 + 高保真校准打分”的协同,直接在 AI 模型中复现了经典物理化学能量景观中的打分漏斗(Scoring Funnel)(图 4C)。面对未知复合物,模型不仅能发散性地探索远离结合态的构象空间,更能沿着打分梯度精准筛选出收敛于低 RMSD 的近天然状态。这种绝对可靠的信号,在从头药物设计的干实验筛选中具有决定性价值。
全原子通用范式的延伸意义
在补足多肽短板的同时,Vilya-2 在传统小分子对接基准(PoseBusters)上也展现了顶尖水平,并在评估跨分布泛化能力的 Runs N’ Poses 测试中证明:即使靶点口袋与训练集相似度降至极低水平,模型依靠底层原子物理图谱的表征能力依然不会发生雪崩式退化。此外,利用预训练获得的几何表征,团队通过低秩自适应(LoRA)微调与构象系综池化(Ensemble pooling),成功将其迁移至下游先导化合物活性预测(Hit-to-lead potency prediction),在真实湿实验 HTRF 亲和力回归任务中取得了显著优于单一构象模型的效果。
从 AlphaFold 确立“残基-MSA”范式,到近期 AlphaFold3 开启向核酸和小分子的“全分子扩展”,结构生物学模型一直在向通用化学空间探索。但 Vilya-2 的表现给出了一个更为清醒的技术判断:在药物设计真正面临的复杂化学前沿——非天然拟肽、大环药物、抗体偶联、共价交联系统中,残基与生物聚合物的先验不仅不是助力,反而在某种程度上演变成了阻碍模型跨化学领域迁移的“信息茧房”。
通过彻底推平残基与分子的概念界限,将相互作用退回到统一的全原子化学图,配合基于扩散的推理期几何采样与严格校准的打分漏斗,Vilya-2 为复杂多肽与大环界面的结构建模确立了新的行业标杆。对于正在转向从头生成设计的计算生物学与药物研发管线而言,这样一个具备高保真度判别能力的“结构先知”,或许正是将算法生成的分子蓝图大规模带进真实实验室的最关键拼图。