AgentBrew:不改权重打破能力鸿沟,强教师闭环酿造弱Agent专属记忆
AgentBrew: Lifelong Knowledge Brewing from Strong Teachers to Weak LLM Agents
在实际业务场景中部署大语言模型智能体(LLM Agent)时,工程师往往面临极其苛刻的现实约束:受限于推理成本、吞吐量和隐私合规,终端往往只能运行参数量较小的轻量级模型,或是无法微调参数的闭源 API;模型权重在部署后必须保持冻结,无法频繁通过反向传播进行参数更新。
ArXiv URL:https://arxiv.org/abs/2607.16851v1
与此相对,学术界常见的智能体增强方案往往依赖两个强假设:要么让强大的旗舰大模型全程在线协同,承受高昂的 Token 账单;要么依赖密集的专家轨迹、精准的单步标注进行有监督微调。当这些依赖在生产环境中全部失效时,系统往往只能拿到一个极其稀疏的信号——任务执行完毕后的二元反馈(Pass 或 Fail)。更致命的是,哪怕在离线阶段引入顶尖大模型充当“导师”,大模型写下的反思经验也经常让小模型“读得懂、做不到”,因为强弱模型之间存在着不可忽视的能力鸿沟(Capability Gap)。
来自香港大学(The University of Hong Kong)的研究团队提出了名为 AgentBrew 的知识酿造框架,尝试从根本上重塑强教师与弱学生之间的经验传递逻辑。该方案不更新弱学生模型的任何权重,不依赖专家微调标签,也不在测试推理期调用教师模型,仅凭借环境给出的对错信号,通过离线“酿造”(Brewing)机制将经验沉淀至终身外部记忆库,最终让轻量级学生在复杂的编程、数学和工具调用任务中实现性能大幅跃升。
为什么强教师的经验反而会带偏弱学生?
直觉上,知识的质量似乎完全取决于其生产者的智能水平。若想提升小模型的能力,用 GPT-4 或 DeepSeek 这类旗舰模型写一套最严谨、最深入的解题策略与避坑指南,小模型直接照着检索执行即可。
然而,研究团队在实验中捕捉到了一个耐人寻味的反直觉现象:如果让强教师(DeepSeek-Chat-v3.1)去指导另一个同样强大的模型,并将两者的成功经验打包成记忆库供弱学生(Qwen3-14B)使用,其测试表现反而显著落后于“强教师专门针对弱学生试错过程”所提取出来的记忆。换言之,知识不是放之四海皆准的通用真理,它必须与最终负责执行的宿主模型相匹配。
这种能力鸿沟主要体现在三个层面。其一是思维跳跃,强模型在复盘时会自然省略其认为“显而易见”的中间推理,但小模型在这一步恰恰最容易失控;其二是表达粒度,强模型偏好抽象、高维的泛化原则,而弱模型需要的是按部就班、触发条件清晰的操作清单(Checklist);其三是行动断层,一旦提示词中的词汇超出弱模型的理解舒适区,弱模型非但无法纠错,反而会引发幻觉或工具调用格式崩溃。
为了让弱学生真正获益,知识的传递不能是自上而下的单向灌输,而必须是一场量体裁衣的“酿造”。这就是 AgentBrew 提出的核心起点:将经验获取解耦为离线的“酿造阶段”(Brewing Phase)与在线的“服务阶段”(Serving Phase)。在酿造期,大模型不是简单充当保姆,而是担任专门为弱学生量身定制行动守则的调优工匠;在服务期,大模型彻底隐退,弱学生凭借高度适配的外挂记忆单次通过任务。
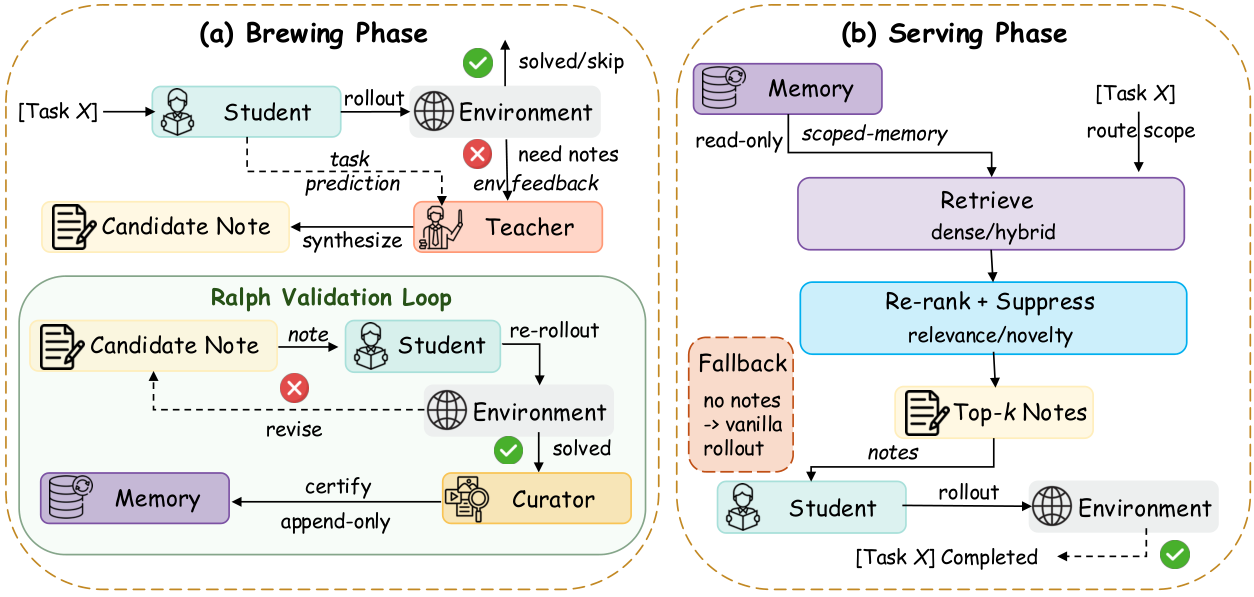
反应式过滤:失败触发与 Ralph 闭环验证
在离线酿造阶段,面对环境仅有的二元奖励 $R \in {0, 1}$,AgentBrew 确立的第一个原则是“不犯错则不介入”。
弱学生模型 $\mathcal{S}$ 首先在训练任务集上自主探索并生成交互轨迹 $\tau_{\mathcal{S}}(x)$。如果任务成功($R=1$),系统直接跳过,不做任何无效冗余记录;唯有当弱学生遭遇失败($R=0$)时,强教师 $\mathcal{T}$ 才会介入。此时,教师唯一能拿到的监督信号就是原始任务描述、弱学生完整的失败轨迹以及终端报错。教师的目标并非给出该题的标准答案,而是定位学生在哪个具体环节失控,并输出一份结构化的候选笔记(Candidate Note)。
然而,大模型写出的修正策略即便逻辑再自洽,也完全可能超出小模型的执行范围。传统自演化方法往往依赖大模型自己对笔记进行打分,或者让小模型自我反思,这种“自评”极易受到模型固有认知偏差的误导。
AgentBrew 引入了基于环境真实反馈的 Ralph Loop(拉尔夫循环)作为反应式过滤器。每当教师拟定一份结构化笔记,系统并不会直接将其持久化存储,而是将该笔记临时挂载至弱学生的上下文,强迫弱学生在刚才失败的原任务上立即进行再尝试(Re-rollout)。
如果弱学生在引入这份笔记后顺利通过环境评测($R=1$),说明该笔记具备了最关键的性质——被当前弱模型真正执行并解决问题的实际可行性;如果重试依然失败,笔记将被打回重写或直接丢弃。通过将真实环境的执行成功作为唯一的入库许可证,AgentBrew 彻底斩断了“大模型觉得很对、小模型拿来全废”的伪知识链条。
在数据层面,这种基于环境闭环的过滤机制展现出了惊人的筛选效率。在未引入 Ralph 闭环的消融实验中,由于生成的笔记缺乏可执行性背书,后端的记忆库策展人(Curator)被迫充当硬性看门人,导致笔记的拒绝率高达 61% 至 73%;而在完整的 Ralph 闭环下,候选笔记已经在弱学生身上得到了实证检验,进入策展阶段时的拒绝率直接骤降至 24% 至 39%。每一个最终写入持久化记忆库的条目,都是经过弱模型亲身肉身排雷后的“有效资产”。
主动式校准:让强教师用小模型的语言写操作手记
仅仅依靠 Ralph 循环的被动过滤还不够。如果教师每次给出的建议都极度抽象,弱学生在 Ralph 循环中的重试成功率就会极低,从而引发大量的回滚与重写,造成训练期计算资源的巨额浪费。
为此,AgentBrew 在教师端设计了学生感知合成(Student-Aware Synthesis)机制,从生成的源头进行前瞻性校准。系统在 Prompt 中显式告知教师当前学生模型的规格基座及其常见的行为缺陷(例如长程多步算术不稳定、对复杂的嵌套工具调用语法脆弱等)。教师被强制要求以“资深工程师为实习生撰写避坑手册”的视角来输出内容。
所有生成的笔记必须严格遵循结构化 JSON 范式,包含三个核心字段:
-
触发模式(Trigger Pattern):用贴近学生自身观察视角的操作级特征,定义何时应当调用该经验;
-
矫正规则(Corrective Rule):以短句、强顺序、命令式的动作清单呈现,杜绝高位抽象哲学,直接告知“第一步看哪里、第二步改哪个参数”;
-
例外情况(Not Applicable When):清晰界定知识边界,避免学生盲目套用导致负迁移。
这种主动校准将经验的表达粒度强行下沉至小模型的执行水位。结构化定义不仅提升了 Ralph 循环的首轮通过率,也确保了知识在不同场景下的泛化能力,使得笔记沉淀的是程序性原则而非某一题的具体答案。
终身记忆管理与轻量化部署服务
当海量的经过验证的笔记源源不断产生时,系统如何避免灾难性遗忘以及不同知识之间的交叉污染?
AgentBrew 采用技能分区(Skill-Scoped)的终身记忆架构,将记忆空间划分为编程、符号推导、API 调用等不同能力子域。策展人 Agent 在吸纳新笔记时采用纯追加策略(Append-only),绝不为了腾出空间而粗暴覆盖历史条目,从而保留了技能的多样性。每个条目在存储时都会记录调用频次、成功率先验与质量动态分。
当系统转入实际部署的服务阶段(Serving Phase)时,运行模式立刻切换:
-
完全冻结:记忆库 $\mathcal{M}^\star$ 变为只读状态,教师模型彻底下线,杜绝任何将测试数据反向渗透至记忆库的潜在泄漏;
-
单次前向执行:面对测试任务 $x$,系统根据指令路由至对应的技能子域,计算检索相似度,并引入频次抑制因子 $\phi(n)$ 与质量分进行重排;
-
软性抑制(Soft Suppression):避免简单粗暴的阈值截断,对高频但泛化的规则施加柔性衰减,确保多样化规则被检索出,选取 top-$k$ 条笔记拼接入弱学生的 Prompt 中。
弱学生在此辅助下只需完成一次标准的环境交互,既不需要任何在测试阶段耗时耗资的反思自纠错,也不产生多轮大模型仲裁调用。整个推理开销与部署一个原生的轻量模型几乎无异,极大契合了低延迟生产系统的工程诉求。
跨场景验证:能力跃升与模型适配启示
为了验证该酿造范式的普适性,研究团队在涵盖代码生成(MBPP、MBPP+)、高难度数学符号推理(MATH、GSM8K)以及需要多步调用多应用接口的长程复杂工具任务(AppWorld)三大核心场景下进行了严谨评测。
在所有基准测试中,AgentBrew 均以固定且不更新权重的 Qwen3-14B 为学生,DeepSeek-Chat-v3.1 为教师,全面对比了 Simple RAG、ExpeL、Reflexion、ACE 等记忆与自演化基线。
实验数据表明,相较于盲目存储教师成功轨迹的 Simple RAG,以及未能考虑能力鸿沟的通用记忆方案 ACE,AgentBrew 在各项指标上均展现出显著的性能优势。特别是在对严谨性要求极高、单步错误即可导致整体崩溃的 MBPP+ 严格单测集,以及 AppWorld 的复杂长任务挑战集(test_challenge)上,AgentBrew 的领先优势尤为突出。这一结果强有力地证实:没有经过宿主模型亲自验证的外部记忆,往往会成为干扰小模型决策的噪声。
消融实验进一步剖析了各组件的独立贡献:
-
移去 Ralph 闭环后,数学任务表现明显下滑,证实没有环境认证的笔记包含大量小模型无法消化的“空头支票”;
-
移去外部记忆库后,小模型在处理相对简单的初等算术(GSM8K)时尚可勉强维持,但在面对需要长链条推理的竞赛级数学题(MATH)时性能断崖式下跌,表明外部知识库在拓展小模型认知边界时具有不可替代的作用;
-
移除测试期软性抑制策略或采用强模型代理记忆进行迁移,均带来了不同程度的性能衰退。
此外,在探索不同教师与学生配对的实验中,研究团队还揭示了一个关键趋势:教师绝对实力的绝对高低,并不完全决定迁移的最终胜率。例如,在 AppWorld 环境中,以 Qwen3-14B 为学生时,DeepSeek-Chat-v3.1 的配合效果优于另一款更大体量的旗舰模型;而以更强的模型充当学生时,更大体量的教师才展现出最佳匹配度。这进一步深化了 AgentBrew 的核心论点:教师的传授能力受制于其对学生认知水位的适配程度,寻找最佳的“酿造配对”远比盲目追求单点最强模型更为关键。
总结与展望
在过去较长一段时间内,智能体落地面临着参数微调成本过重与纯 Prompt 引导上限过低的双重夹击。许多尝试将经验沉淀为可复用记忆的工作,又在不经意间假设了“知识是中立且普遍可理解的”,忽视了不同模型之间深不见底的能力沟壑。
AgentBrew 通过“失败触发 + 闭环认证 + 降维合成”的组合拳,证明了一种极具吸引力的第三条演化路径:将执行能力固化在小模型内,将认知增长沉淀于环境校准的外置记忆中。通过完全利用稀疏的二元反馈进行闭环试错,它为资源受限场景下安全、廉价、长效地演进端侧智能体提供了高度可行的工程与理论参考。未来的端侧 Agent 系统,或许不再需要为了每一次任务迭代而承受重训权重的代价,只要拥有源源不断酿造适配经验的管道,轻量模型同样能在复杂交互世界中独当一面。