AgenticCANN:攻破昇腾算子冷启动瓶颈,推理提速达6.65倍
AgenticCANN: Automated Ascend C Operator Generation via Knowledge-Augmented Agentic Evolution
在大模型基础设施的底层软件栈中,高性能算子(Kernel)通常被视作决定推理吞吐与延迟的“最后一公里”。长久以来,利用大语言模型自动编写与优化算子(如基于 CUDA 的 KernelBench、EvoEngineer 等工作)取得了一定进展。然而,这些研究无一例外建立在一个未被明说的先决条件之上:目标硬件架构在主流代码预训练语料库中占据着极高的权重。一旦将战场转移到预训练语料极度匮乏、编程范式截然不同的国产 NPU 平台——例如基于华为 CANN(Compute Architecture for Neural Networks)架构的 Ascend C,既有的自动化代码生成方法就会遭遇致命的泛化断崖。
ArXiv URL:https://arxiv.org/abs/2607.26661v1
在缺乏领域特定语料引导的情况下,主流大语言模型在 Ascend C 上甚至无法生成哪怕一个能够成功编译的非基础算子,可行解概率直接归零。来自香港城市大学与香港宇唯科技的研究团队近日提出了 AgenticCANN 框架。这项工作并非简单地将提示工程搬运到国产硬件上,而是直击非 CUDA 架构低语料环境下的核心症结,将算子合成难题拆解为“知识编排引导”(Knowledge Orchestration)与“阶段自适应演化”(Stage-Adaptive Evolution)两个关键支柱。
在华为 Ascend 910B 真实集群上的严苛评测显示,AgenticCANN 将 Elementwise(逐元素)与 Normalization(归一化)算子的代码可行率从 baseline 的 0% 直接拉升至 90% 到 100%,不仅攻克了编译与数值验证难关,更在盘古 1B 大模型的真实推理负载中,将关键归一化算子实现了高达 6.65 倍的执行加速,为大模型推理带来了 8% 至 10% 的端到端时延缩减。这标志着大模型自主适配低资源、高复杂度异构计算体系迈出了关键一步。
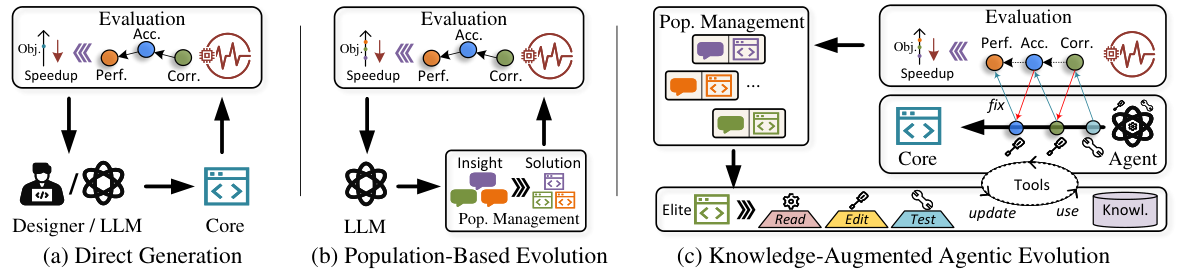
范式冲突与冷启动陷阱:为什么 CUDA 的经验在昇腾上全盘失效
理解 AgenticCANN 的价值,首先必须剖析 Ascend C 与 CUDA 之间不可逾越的体系结构鸿沟。在传统 GPU 编程中,开发者习惯于细粒度的线程块(Thread Block)与 Warp 级调度,底层依赖硬件层面的 SIMT(单指令多线程)隐式掩盖延迟。只要大模型理解了基本的线程索引映射与共享内存分块,即便代码稍显粗糙,也往往能够顺利通过 nvcc 编译,后续的自动搜索主要是围绕参数微调与循环展开做性能收敛。
华为昇腾 NPU 的 Ascend C 则完全是另一套物理法则。它建立在显式的数据流架构(Explicit Dataflow Architecture)之上,计算核心由矢量计算单元与片上统一缓冲区(Unified Buffer, UB)构成。开发者不再控制线程分发,而是必须显式管理数据在外部全局内存(Global Memory)与片上统一缓冲区之间的搬运流水线。在 Ascend C 中,算子必须显式构建多阶段流水线队列(例如搬入队列 VECIN 与搬出队列 VECOUT),并手动处理内存切分对齐(Tiling)、物理 Ping-Pong 双缓冲交替以及严苛的 32 字节硬件地址对齐约束。
这种机制差异导致了一个残酷的数学事实。论文将算子生成形式化为一个约束优化问题:在给定算子规范 $\mathcal{O}$ 下,搜索满足正确性约束 $C(x)=1$ 且硬件执行时间 $T(x)$ 最小的实现 $x^*$。对于 CUDA,模型依靠庞大的预训练记忆能够保证初始解的可行性概率远大于零;但在 Ascend C 上,由于开源语料极度匮乏,模型在未注入外部领域知识时,其对非平凡算子的先验可行概率 $P_{\text{LLM}}(C(x)=1 \mid \mathcal{O}) \approx 0$。
当先验概率为零时,传统的闭环演化算法(如依靠编译器报错信息指导模型修改的闭环机制)会陷入彻底瘫痪。因为 Ascend C 编译链反馈的错误日志充斥着底层流水线死锁、UB 缓冲区越界对齐失败或队列生命周期不匹配等硬件专有表征,缺乏昇腾领域知识的大模型根本无法理解报错日志的真实语义,只能在死循环中胡乱猜测,使演化搜索变成了毫无方向的布朗运动。因此,在低语料硬件上,核心挑战根本不是下游的性能参数微调,而是如何在上游打破可行性为零的死锁。
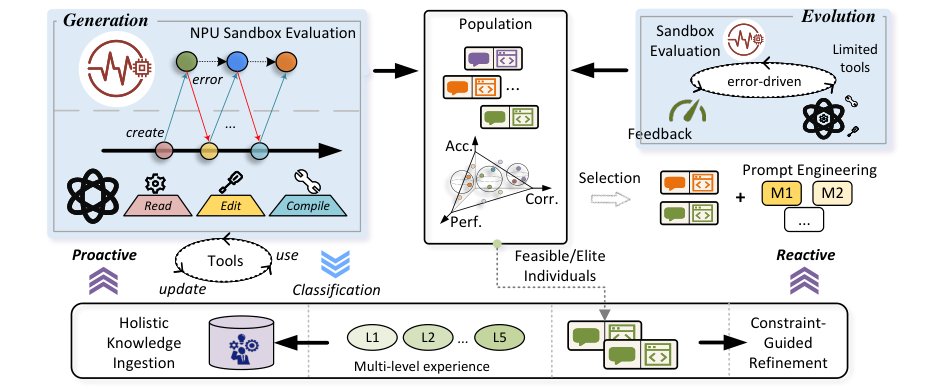
知识分级与动态组装:六层认知分类法击破上下文稀释
为了打破这一上游可行性瓶颈,最直觉的做法似乎是检索增强生成(RAG)或直接把官方文档塞进提示词。然而,硬件开发手册通常长达数百页,未经整理的技术文档直接丢给大模型会导致严重的上下文稀释(Context Dilution),大模型不仅无法抓取硬件不变性约束,反而容易因指令冲突而进一步退化。
AgenticCANN 的第一项关键创新,是构建了一套结构化的六层领域知识分类体系(Multi-Level Knowledge Taxonomy),将复杂的硬件规范解构为不同认知维度的知识资产:
-
L0 硬件心智模型(Hardware Mental Models):界定多核计算体系与片上内存拓扑结构。
-
L1 运行语义(Operational Semantics):明确数据拷贝、计算流水线与显式同步机制。
-
L2 不变性约束(Invariant Constraints):强调内存对齐(如 32 字节边界)与缓冲区容量上限等硬性法则。
-
L3 切分策略(Tiling Strategies):提供多维数据切分算法与多核负载均衡方案。
-
L4 API 规范(API Specifications):约束特定算子内置加速接口的调用签名。
-
L5 验证基准范例(Verified Structural Exemplars):包含经过硬件验证的完整流水线代码框架。
仅有六层知识依然不够,如果一股脑将 L0 到 L5 塞入每个生成轮次,仍然会造成巨大的上下文冗余。AgenticCANN 由此提出了阶段差异化组装机制(Phase-Differentiated Assembly)。在初始代码生成(Initialization)阶段,系统注入全量 L0–L5 知识,帮助大语言模型构建完整的硬件心智模型与代码骨架;进入变异演化(Mutation)阶段时,上下文被大幅压缩,仅保留精简的 L2–L4 硬件守卫规则,防止发生结构漂移;在编译修复阶段,则动态聚合结构范例与报错对应的特定硬件约束;而在最后的性能调优阶段,系统剔除一切语法与结构信息,仅提供纯粹的 L3 切分策略。
这种按需供给机制带来了惊人的效率提升:提示词长度从初始阶段的约 800 个 Token 骤降到性能调优阶段的不足 100 个 Token,单次代码迭代的开销降低了整整 8 倍,彻底避免了长上下文带来的注意力和精度损耗。配合预先建立的计算模式路由系统(涵盖 Elementwise、Reduction、Normalization、Fusion 等主流算子模式),框架能够将任务目标精准映射到对应的计算模板与约束体系,实现了高效解耦。
阶段自适应演化:破解探索与收敛的“代际漂移”悖论
在算子代码生成的可行性问题解决之后,演化算法自身的设计成为了左右性能的瓶颈。以往基于智能体的代码生成框架常常陷入非此即彼的模式:要么采用简单的单轮自修复(Fix-Loop),要么赋予智能体调用命令行与调试工具的完全自主权(Full Tool-Using Agent)。
研究人员通过大量对比实验发现了一个关键反直觉现象:智能体的自主度(Agency)并非越高越好。完全自主的 Tool-Agent 在初期具有极强的代码探索引导力,能够通过频繁的环境交互探索出一条可以通过编译的粗糙通路;然而在进入多代演化收敛期后,过高的自主度反而会导致灾难性的“结构漂移”(Structural Drift)。由于智能体倾向于大改代码框架以修复细微报错,它常常在不经意间破坏上一代已优化好的流水线布局,导致多代演化几乎零收益。
在 GELU 算子的演化实验中,这一现象体现得淋漓尽致:全自主 Tool-Agent 模式在 5 代演化中狂揽了 4.18M 的 Token 开销,但最终代码相较初始候选仅带来了极其微弱的 +0.04% 性能增益;相比之下,结构约束极严的轻量级修复循环(Fix-Loop)在演化阶段却能稳扎稳打,以仅仅 350K 的 Token 消耗实现了 +26.0% 的性能提升。
为了兼收两者的优势,AgenticCANN 提出了阶段自适应演化策略(Stage-Adaptive Evolution)。该策略动态地将智能体模式与演化生命周期解耦匹配:在第 1 代($g=1$)初始种子探索期,框架激活高探索性的工具智能体,允许其进行激进的语法探索与试错,全力越过冷启动可行性门槛;一旦获得可正确执行的代码种子,从第 2 代($g>1$)开始,框架立即将调度模式切换为高收敛性的单次推演(Single-Pass)或受约束修复循环。此时模型被严格限制在既有流水线拓扑内,仅对数据切分比例、Ping-Pong 缓冲队列深度等关键局部进行参数演进。这种调度逻辑在将总体 Token 消耗压低到传统全自主模式 8.4% 的同时,大幅提升了下游算子的优化收敛效率。
真实硬件实测:从零可行率到盘古大模型全流程加速
为了检验 AgenticCANN 的真实工业价值,所有实验均部署在配备 8 张华为 Ascend 910B1 NPU(单卡 61GB HBM)的物理集群上运行,底层依赖 CANN 8.1.RC1 软件栈,调用 DeepSeek-V4 系列模型进行代码推理。
实验设计涵盖了六大代表性算子与总计 54 个分层测试算子。第一组对比展现了领域知识编排带来的本质颠覆:在不施加外部知识编排的闭环生成(Free 模式)下,大模型对所有非逐元素算子(如 LayerNorm、RMSNorm、Softmax 等)的可行率全部为 0%,无一能够编译通过并获得数值校验。而在引入结构化知识编排后,Elementwise 与 Normalization 算子的可行率直接拉升到了 90% 至 100%,算子执行性能相较初版实现了最高 2.71 倍的飞跃;对于结构极度复杂的融合算子(Fusion Pattern),可行率也达到了 56%。
在针对 LayerNorm 的细粒度消融实验中,逐层叠加知识展现出清晰的单调递增规律:仅提供 API 说明(L4)时可行率仅有 20%;引入不变性约束(L2)后提升至 40%;加入切分策略(L3)使速度提升出现拐点;当 L0 至 L5 全栈知识通过阶段差异化方式协同工作时,算子可行率达到 90%,并伴随 2.71 倍的性能提升。这证明算子生成不仅需要 API 语法,更需要深度的硬件设计逻辑注入。
在更大规模的 54 个全量算子基准评测中,全知识体系驱动的 AgenticCANN 展现了广泛的通用泛化力。对比缺乏硬件细节的方案,在 Hardtanh 算子上取得了 18.4% 的执行时间缩减,Softplus 算子缩减了 15.2%,逐元素类算子的生成可行率从 57% 单调递增至 86%。
最引人注目的验证来自真实工业模型的端到端部署。研究团队将 AgenticCANN 自动合成并优化后的算子,直接替换进 10 亿参数(1B)的盘古(Pangu)大模型推理流水线中。硬件剖析显示,Normalization 层在盘古模型的全生成周期中需要调用 3392 次,占到了模型总体推理时延的 11%(约 1102 毫秒)。
实测结果显示,在生产环境标准的张量维度下,AgenticCANN 合成的 RMSNorm 算子相比物理设备上原生的 PyTorch 默认算子实现了 6.19 至 6.65 倍的执行加速;LayerNorm 算子同样获得了 2.68 倍的稳定加速。当将盘古 Transformer 主干网络中的全部 53 个归一化算子层全量替换后,整个大语言模型的端到端推理时延直接下降了 8% 至 10%。这一数据极具说服力:在无需人类资深硬件工程师介入数周进行手动汇编调优的前提下,大模型完全依靠知识增强的自主智能体体系,在真实的国产 AI 算力底座上榨取出了可观的性能红利。
低资源异构计算自动化的启示
在算力多元化发展的今天,算子生态的适配成本一直是非 NVIDIA 硬件难以逾越的壁垒。如果每一次硬件架构的迭代都必须依赖规模庞大的工程师团队从头手写算子库,或者被动等待开源社区积累数年代码才能让大模型勉强发挥代码补全作用,硬件迭代的步伐势必被严重拖慢。
AgenticCANN 的探索提供了一个极具示范意义的破局范本。它表明,面对一个未曾充分见过的陌生硬件架构,解决大模型“不会写”的核心途径绝不是单纯地增大参数量,也不是将非结构化文档直接作为长上下文倾倒,而是通过深度的专家知识形式化建立精准的分级心智模型;同时,在演化过程中动态约束智能体的自主权限,用工程规则约束搜索发散,用定向微调驱动收敛。
当然,该框架目前仍有边界,例如涉及复杂动态索引重排的 Broadcast 算子在自动化合成中仍遭遇了瓶颈,表明跨维度的张量内存对齐需要更高阶的符号推理支持。但它成功在 Ascend 910B 这一高复杂度 NPU 上实现了从“不可编译”到“数倍加速”的跨越,证明了即使在语料荒漠中,大语言模型与领域专属编译优化的结合依然大有可为。这一思路未来完全有潜力扩展至图卷积、异构脉冲网络乃至各类专用加速芯片(ASIC)的算子自动化生产中,成为打破底层生态壁垒的关键催化剂。