Auto Research:AI科学家闭环搜出701次代码迭代,泛化验证真能打?
Auto Research for Materials: Auditable AI-Scientist Workflows with Held-Out Transfer
让大语言模型(LLM)充当科研助手或自主“AI 科学家(AI Scientist)”,在最近一年里已经不是新鲜事。从自动阅读论文、提出假设、编写代码到运行跑分,自动化闭环实验(Closed-loop Research)展示出了惊人的迭代速度。然而,华丽的跑分曲线背后始终悬着一把达摩克利斯之剑:AI 智能体在闭环中刷出来的高分,到底是真的找到了普适的科学规律,还是在单一验证集上把代码“过拟合”了?
ArXiv URL:https://arxiv.org/abs/2607.17100v1
如果在搜索过程中尝试了数百次代码修改,智能体往往能轻易挑出一个在当前验证集上表现抢眼的方案。但当这套修改被部署到从未谋面的盲测数据上,或者换一个相近任务时,它会不会立刻原形毕露?更关键的是,我们到底该如何评估一个 AI 科研智能体的真正产出——是看它跑了多少轮迭代,还是看它最终沉淀下来的可执行代码是否具备可审计的泛化价值?
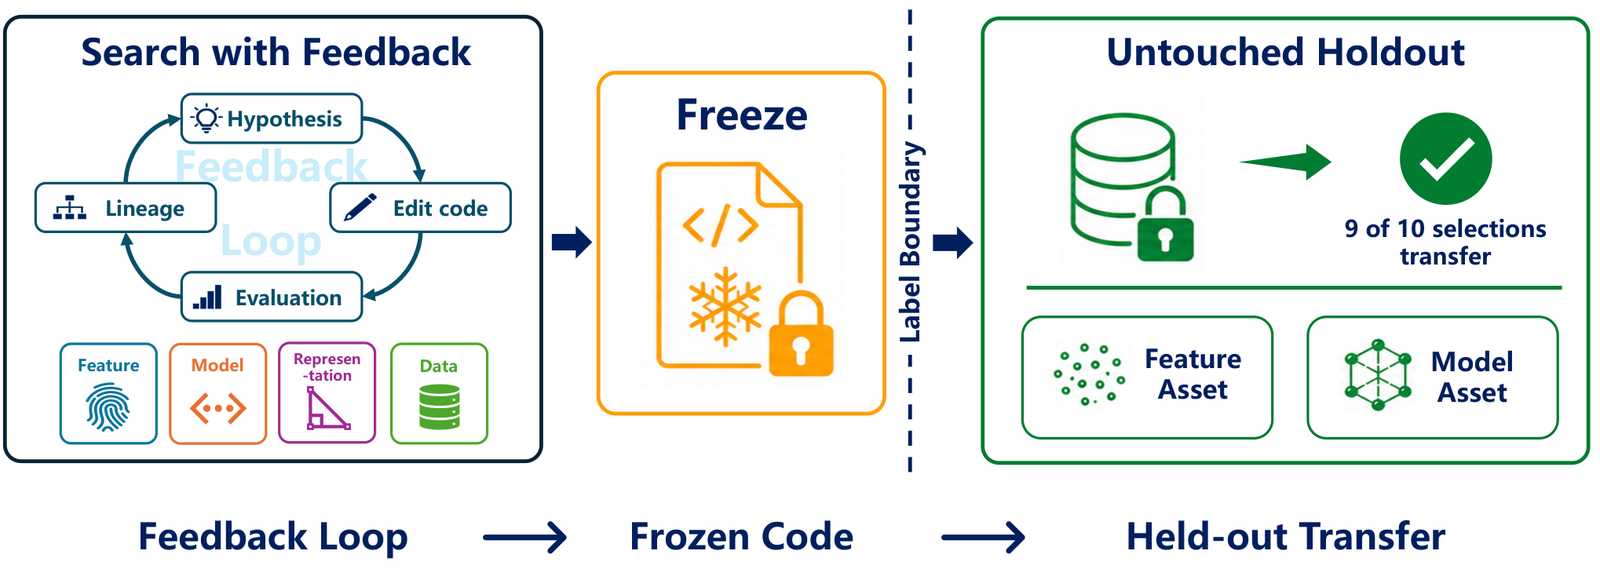
来自卡内基梅隆大学(CMU)和深势科技(DP Technology)的研究团队在最新研究中直面了这一核心难题。他们提出了针对材料科学的 Auto Research 工作流,设定了极其苛刻的审计红线:严格隔离搜索与最终评估,将搜索空间解耦为四大干预维度,并将最终选定的代码完全“冻结”,送入绝对不可见的保留测试集(Hold-out Test)中进行盲测。
这项研究基于开源材料基准 Matbench,通过 DeepSeek-v4-pro 驱动的智能体完成了 7 轮自主搜索,累计评估了 701 次代码改动。盲测结果令人振奋:在 10 个材料预测任务中,智能体自主选拔出的单一代码方案有 9 个在从未参与闭环的数据集上稳坐第一;将独立发现的特征与模型代码组合后,更带来了平均 26.3% 的性能提升。
这不仅是材料信息学的一次落地突破,更确立了一套评估“AI 科学家”发现成果是否具有真实科研价值的标准范式。
戳破自嗨泡泡:什么是真正可审计的 AI 科研?
很多闭环智能体系统最容易陷入的误区,是将“智能体活跃度”或“在闭环内见到的最高分”等同于科研发现。大模型在针对固定验证集进行反复尝试时,本质上是在进行自适应数据分析(Adaptive Data Analysis)。几百次改动下来,极其微小的统计噪声都会被放大,最终选出的代码很可能只是暗中记住了验证集的特定切分。
为了让 AI 发现真正立得住,研究团队在系统架构上做出了两个至关重要的设计取舍:
-
五折内层平均作为搜索信号:智能体在迭代代码时,绝对无法接触到测试集标签,甚至连开发集的单一切分都看不到。系统只向智能体反馈基于训练集内部进行 5 折交叉验证的平均得分(Mean 5-fold CV)。这种平滑设计大幅降低了智能体针对某一个特定验证子集进行“作弊式调优”的风险。
-
严格的代码冻结与单次盲测:搜索结束后,智能体选拔出的优胜代码被立即哈希锁定并冻结。随后,该代码在完全未被触碰的保留测试集(Fold-0 Hold-out Test)上仅运行一次。只有在盲测中依然战胜其他对照组的方案,才被认定为实现了真正的选择泛化(Selection Transfer)。
不仅如此,为了彻底弄清代码提升的物理来源,研究团队拒绝让智能体进行漫无目的的“全局大乱炖”,而是将代码修改严格约束在四个互斥的干预类别中:
-
特征工程(Features):修改人工构造的物理化学描述符;
-
模型设计(Models):替换估算器、调优损失函数或调整后验标定(Calibration);
-
表征学习(Representations):引入基于自监督或预训练生成的原子/组分向量(如 mat2vec、MEGNet 嵌入);
-
外部数据(Data):通过严格的化学式查重,从外部数据源有选择地引入新训练样本。
每次搜索中,智能体只能修改属于该类别的代码文件,其余文件强制重置回基线并校验 Hash 值。这种审计机制确保了每一个百分点的性能跃升,都能明确归因于具体的建模维度。
盲测通关:10个端点中9个守擂成功
在基于 Matbench 的十个物理性质预测任务中(涵盖带隙、钢材屈服强度、金属性、玻璃形成能力,以及晶体声子频率、弹性模量、折射率等),智能体在 701 次自主尝试后提交了它的最终答卷。
盲测评估给出了极高说服力的结果:在 10 个性质端点上,智能体依据内层搜索信号挑选出的最优单项干预方案,有 9 个在完全盲测的保留数据集上保持了同类第一。这意味着,模型并未被搜索过程中的中间分数带偏,其探索策略捕获到了具备真实泛化能力的建模规律。
在仅基于化学组分的预测任务上,智能体的优化探索呈现出百花齐放的态势:
-
在实验带隙预测(Band Gap)上,模型类别的改动斩获了 17.4% 的保留集 MAE(平均绝对误差)下降;
-
在钢材屈服强度任务上,表征维度的嵌入改动取得了 18.6% 的误差降幅;
-
在金属性与玻璃形成能力的二分类任务中,智能体挑选的方案同样将保留集的 ROC-AUC 分别提升了 0.0069 和 0.0198。
过去很多人怀疑 LLM 只能写出千篇一律的模板代码,但审计日志显示,智能体会针对不同的物理场景探索截然不同的解法:在某些端点上它通过重构特征组合取胜,而在另一些端点上则通过重写回归估算器或引入更契合的元素表征脱颖而出。
两类建模范式:组分与晶体结构的物理分野
将这 701 次实验放在一起横向对比时,Auto Research 揭示出了材料建模领域深刻的物理分水岭:纯化学组分建模与引入晶体几何结构的建模,遵循着截然不同的干预规律。
在仅输入化学组分(Composition-only)的体系中,特征工程、模型选择和表征向量几乎平分秋色,每一条技术路线都能带来约 5% 至 7% 的平均增益。但在引入了明确的晶体三维结构(Structure-based)的任务中,这种均势被瞬间打破:
-
几何描述符处于绝对统治地位:引入更精细的三维几何特征,使声子最高振动频率、二维剥离能、钙钛矿形成能的保留集 MAE 平均降低了 14.6%;
-
模型调优成为有力补充:针对回归估算器和标定代码的改进,在弹性模量(体积模量与剪切模量)和折射率任务上展现出最强适应力,带来了 7.1% 的误差缩减;
-
纯组分表征出现“负迁移”:如果在已经具备晶体几何结构的任务中强行塞入基于化学式的组分嵌入(如 mat2vec),模型在搜索内层看似略有微小提升,但一进入盲测集立刻表现崩塌。
这一对比清晰地表明,一旦三维立体空间信息到位,局限于一维化学式的统计表征不仅冗余,甚至会引入破坏几何对称性的噪声。智能体通过冷酷的盲测数据,独立逼近了材料计算化学的本质直觉。
还有一个反直觉的发现来自于外部数据引入(Data Intervention)。在过去的认知中,“加数据”往往是提升性能的最粗暴手段。然而智能体在遍历了 53 轮外部数据筛选干预后,即便经过严密的化学式查重与配对,引入的微量增量数据在保留集上带来的平均提升仅有 0.20%,在基准重放中仅有 0.03%。在高质量特定物性预测任务中,盲目引入分布存在细微差异的外部样本,其性价比远远落后于在特征和模型结构上的精心重构。
积木式拼装:独立发现的代码如何“1+1>2”
如果 AI 科学家只是在单个脚本里试出了一个碰巧能跑的数字,它的工业和学术价值仍然有限。这项研究最具启发性的突破在于:在不同搜索周期中独立演化出的代码改动,完全可以在后期组合起来,形成战力更强的复合模型。
由于特征工程修改与模型估算器修改在代码架构上保持解耦,研究人员在所有单项搜索结束后,将两者冻结的代码合并到了同一个流水线中进行联调。
实验数据表明,这种代码组合爆发出了显著的协同效应。在晶体结构预测任务中,将独立发现的最优几何特征模块与最优模型估算模块拼装后,在保留集上实现了高达 26.3% 的平均误差缩减。在组分带隙任务中,组合方案将保留集 MAE 的降幅进一步拉大到 28.9%,在金属性和玻璃形成任务上的 AUC 增益分别扩大到 0.0103 和 0.0232。
在官方标准的 Matbench 五折重放测试中,这一拼装组合在多个任务上的表现直接追平甚至反超了文献中长期作为强基准的 MODNet 等专用材料深度学习架构。这充分证明,智能体产出的并非不可复用的临时脚本,而是模块化、可迁移的高质量计算组件。
AI 科学家的下一程:从刷榜走向真实泛化
回顾 Auto Research 这项工作,它给整个“AI for Science”及“自主智能体科研”领域敲响了警钟,也指明了一条更严谨的演进路线。
过去一段时间,大量研究热衷于展示智能体生成了多么冗长的论文草稿、执行了成百上千次复杂的工具调用,抑或是在某个公开榜单的公用测试集上“再创新高”。然而,如果缺乏不可见标签的物理隔离,缺乏对代码改动模块的归因追踪,这种“自动化发现”很大程度上只是一场算力推动下的过拟合游戏。
CMU 与深势科技团队的研究确立了一套标准的方法学框架:
-
评估的核心必须是“冻结的可执行改动”,而非过程中的自嗨分数;
-
搜索信号必须通过多折交叉打散,切断智能体针对固定切分的自适应攻击;
-
盲测验证集必须做到物理隔离与一次性判定,守住科学泛化的底线。
当大模型不仅能编写代码,还能在严谨的审计协议下自我推演、去粗取精,并产出能通过盲测检验的模块化科学代码时,真正的“AI 科学家”才算迈出了摆脱幻觉、融入前沿科研基础设施的第一步。