AutoDesign:不是微调模型而是迭代脚手架,得分超Claude Design 7.4分
AutoDesign: Meta-Harness Optimization for Long-Horizon Agentic Design
多模态长程生成任务一直被视作大模型落地的深水区。把一篇包含复杂公式、图表、长文本与实验对比的几十页学术论文,浓缩成一张版面紧凑、视觉平衡、逻辑严谨且可直接交付印刷的学术海报,人类设计师通常也需要耗费数小时。当前多模态代理(Agent)虽然具备一定的生成和自我反思能力,但大多停留在“单次会话修修补补”的阶段——系统在完成一次任务或遭遇失败后,获得的经验往往会随着上下文清空而灰飞烟灭,底层支撑系统的逻辑依然是一套静态的硬编码流程。
ArXiv URL:https://arxiv.org/abs/2608.13560v1
来自清华大学、北京大学、华中科技大学、美团、MBZUAI、上海交通大学和香港中文大学等机构的研究团队提出了 AutoDesign 框架。这项工作跳出了“微调底层多模态模型权重”的传统路径,而是引入了元脚手架优化(Meta-Harness Optimization)机制。它将设计代理运行的外部环境、反思逻辑、校验工具与协调策略抽象为“设计脚手架(Design Harness)”,并由更高层的代码代理担任“元优化器”,根据任务运行的真实反馈,对脚手架进行递归自我改良。
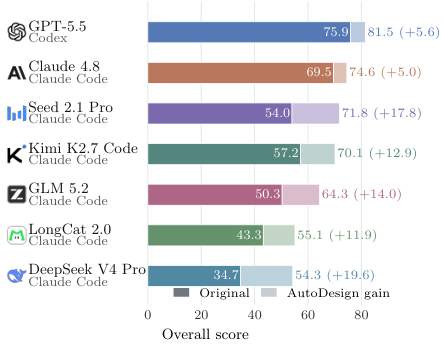
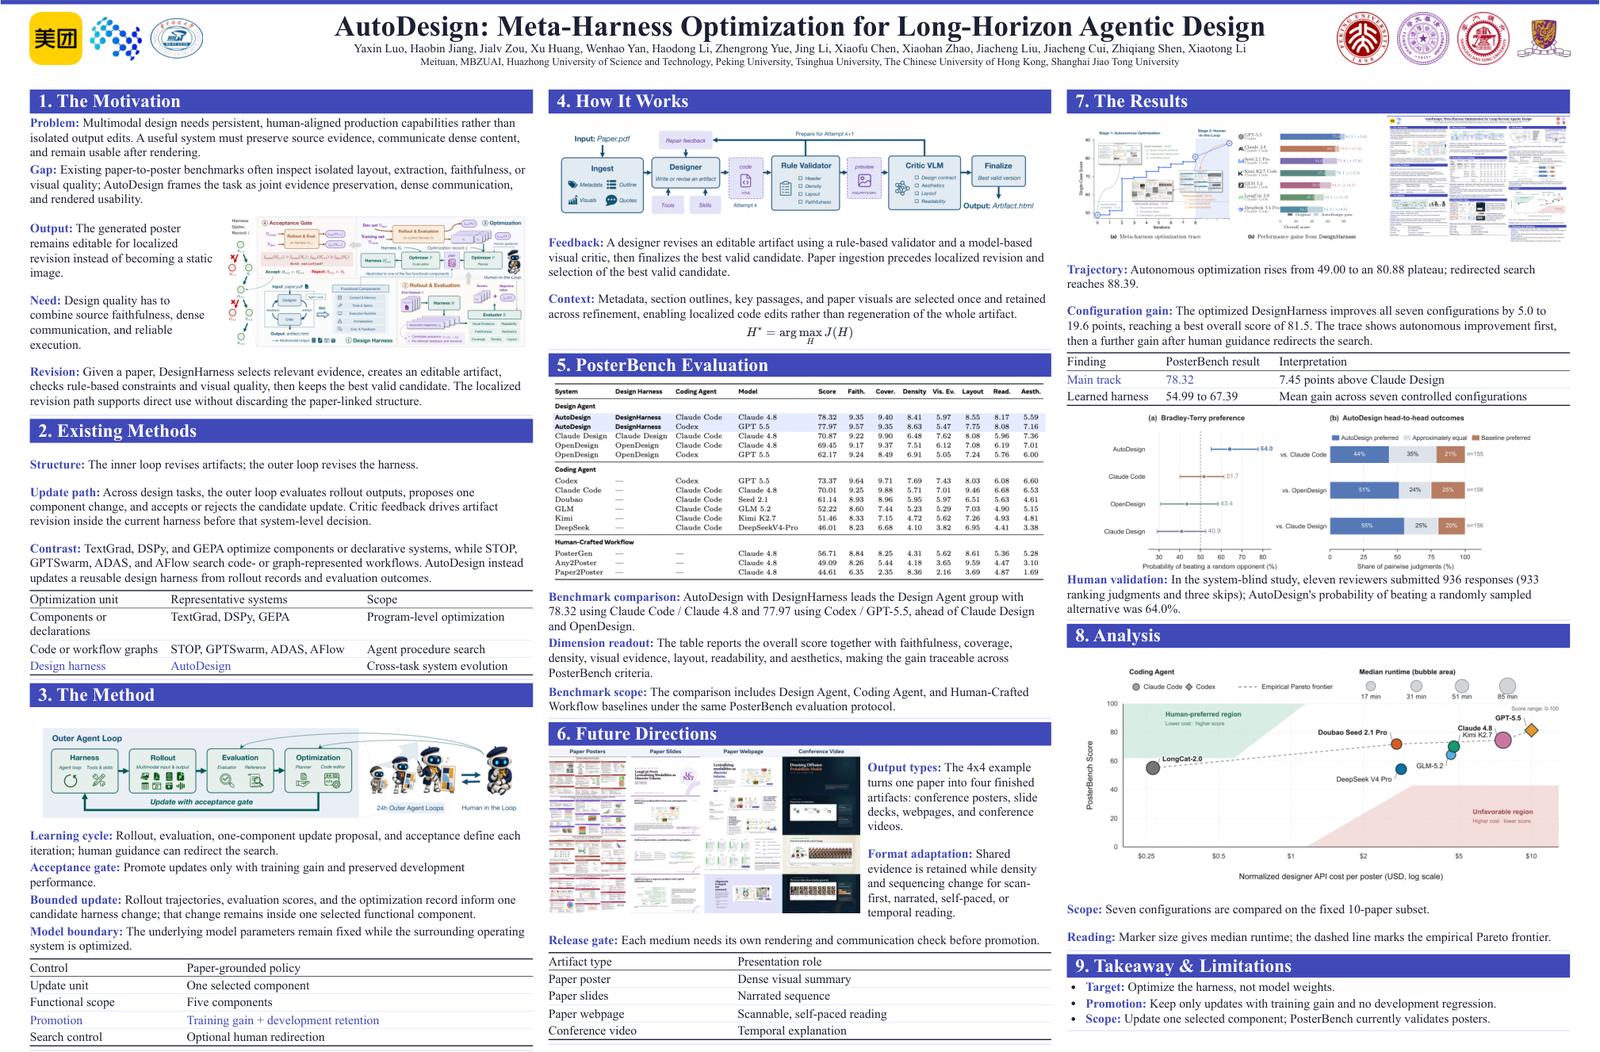
实验表明,由 AutoDesign 自主进化出的最终落地系统 DesignHarness 展现出了惊人的泛化与工程表现:在涵盖五个学科领域、100篇学术论文的 PosterBench 基准测试中,AutoDesign 取得了 78.32 的最高综合得分,超越商业闭源设计系统 Claude Design 达 7.45 分;在7种不同的代码代理与底层模型组合下,挂载 DesignHarness 带来了平均 12.4% 的性能提升(从 54.99 分跃升至 67.39 分),其中 DeepSeek V4 Pro 配合该脚手架更是提升了 19.56 分。在全自主运行的测试中,系统耗时约 40 分钟、执行 253 次工具调用和 11 轮局部重构,仅消耗不到 3 美元成本,便生成了达到顶会现场张贴标准的论文海报。
为什么多模态设计需要“脚手架自进化”?
以往基于多模态大模型的长程设计方案,痛点并不完全在于大模型本身的理解力,而在于模型所处的执行环境极度僵化。常见的模式通常分为两类:要么是通过长提示词要求多模态模型“一步到位”生成完整代码或图像,要么是硬编码一个固定的“生成-批评-重写”管线(Feedback Loop)。这类设计存在一个根本矛盾:单次任务中的反思反馈只是瞬时信号,无法沉淀为系统级工程先验;不同任务间遇到的版面溢出、证据溯源丢失、图表失真等共性错误,系统在下一次任务中依然会盲目重复。
真实的人类专业设计绝非黑盒绘图,而是一套包含证据链提炼、版式流式排布、代码级精准控制以及持续根据排版物理引擎纠偏的严谨流程。如果每次都通过重新训练或微调基础模型来解决排版规则和协作流程问题,不仅计算成本高昂,而且微调很可能会破坏模型原本通用的推理能力。
AutoDesign 的立论核心在于:保持底层基础模型权重固定不变,将长程设计能力的进化压力全部转移到围绕模型运转的“脚手架(Harness)”上。脚手架涵盖了任务输入的结构化预处理、代理使用的排版与渲染工具链、双重检查评估机制以及局部代码修改策略。通过建立能够自主改写代码脚手架的元循环,让系统在跨任务的实战失败与经验中,自主生长出成熟的工程化设计范式。
双层反馈循环:从局部代码编辑到全局元优化
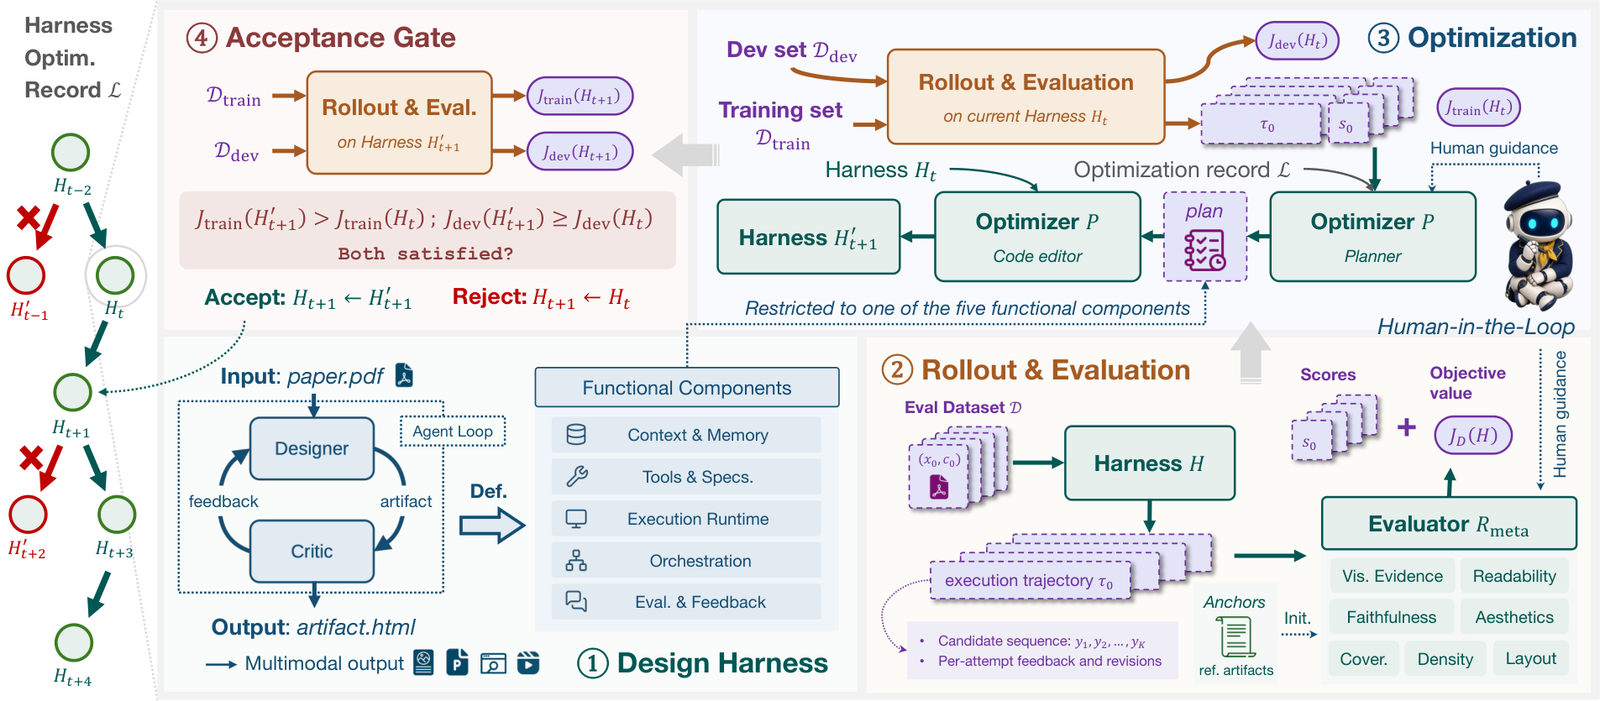
AutoDesign 在架构上被解耦为嵌套的双层循环系统,其核心逻辑清晰地区分了“产出单个设计制品”与“优化生产流水线”两个完全不同的生命周期。
内层循环(Inner Loop)是运行在单个具体任务之上的设计脚手架。对于给定的输入论文,设计代理不会从零凭空幻觉布局,而是将设计产物始终保持为可局部编辑的代码形式(如模块化 HTML/CSS)。设计代理在每一步修改时,接收来自双重批评模块的反馈:一个是由确定性算法驱动的规则验证器(Rule-based Validator),专门拦截图层溢出、文字重叠、断链、溯源丢失等物理渲染与排版约束;另一个则是多模态大模型(VLM)批评器,负责从整体视觉美学、层次感与学术可读性角度审视渲染出的图片预览,并提供结构化的局部修改建议。在整个内层循环中,脚手架的结构与规则是固定不变的,代理在最大 12 轮预算内反复执行局部修正,输出当前最优的海报代码。
外层循环(Outer Loop)则是元优化器(Meta-Harness)展开自我更新的场域。当内层循环在多篇训练集论文上跑完多轮设计轨迹后,元优化器会聚合所有任务的执行日志(包含错误诊断、渲染耗时、评测打分等),从中挖掘出反复出现的系统性缺陷。例如,它可能会发现多模态模型经常在解析双栏论文图表时漏掉坐标轴说明,或者在 CSS 网格分配上反复出现列宽冲突。
此时,担任元优化器的代码代理由此构想出一组针对脚手架代码的有界修改(Bounded Update)。这种修改可能是重写一段工具接口、改进提示词中的布局约束策略、增加新的物理渲染自检规则,或者调整批评器的反馈粒度。为了防止元优化器“过拟合”或改出破坏性的系统逻辑,系统设置了严格的准入网关(Acceptance Gate):候选脚手架只有在训练集上平均表现优于旧脚手架,并且在保留的验证集上性能没有发生倒退时,修改才会被正式合并进代码主干。
在经历长达数天、包含123次递归迭代和224个子代理调用的演化追踪后,AutoDesign 沉淀下了54次经过严格验证的脚手架升级,最终凝结成了高度稳健的生产级系统 DesignHarness。
进化的结晶:DesignHarness 如何解构复杂学术源文
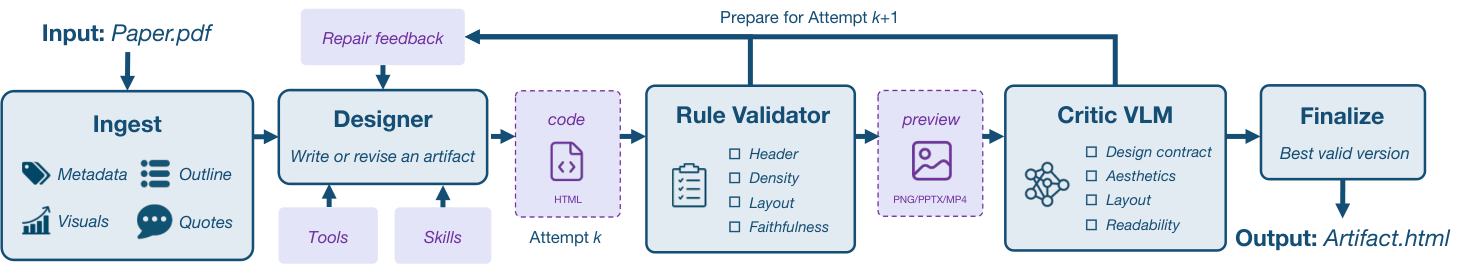
最终通过元优化自主生长出的 DesignHarness,呈现出极其成熟的四阶段流水线设计:
首先是源文结构化摄取(Paper Ingestion)。面对长达几十页的学术 PDF,DesignHarness 不会生硬地将全文直接塞进上下文,而是先构建具有“溯源性(Provenance-aware)”的上下文纲要。它精准拆解论文的元数据、大纲逻辑骨架,并将关键结论与对应的图表原件、支撑段落严格绑定。每一个被抽取的视觉和文本元素都保留了在源文中的原始索引位置,这为后续的真实性核验提供了不可伪造的证据链。
其次是基于局部代码编辑的生成与迭代(Generation and Revision)。不同于直接生成整张死板位图的文生图模型,DesignHarness 将学术海报视为动态渲染的代码结构。设计代理每次拿到诊断报告后,仅针对特定有问题的 DOM 容器或 CSS 属性发起局部修补。由于渲染预览图在每一次尝试后都会作为视觉上下文重新喂给多模态模型,模型能够直观看到自己上一步修改后的视觉真实外观,从而迅速识别出纯文本诊断难以捕捉的微小字距排布和留白失衡。
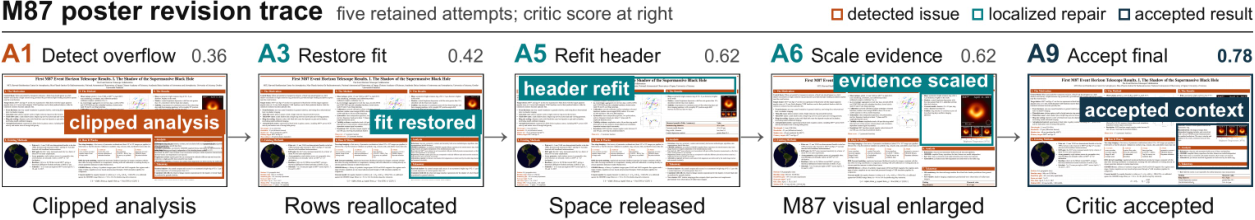
再次是确定性规则与视觉审美的双重把关(Validation and Finalization)。DesignHarness 引入了严苛的阻断性检查机制。只有当海报完全消除了图文重叠、文本溢出容器、未引用图片占位等硬性硬伤后,流程才会提前跳出循环进入交付阶段;若达到最大尝试上限依然存在轻微缺陷,脚手架则会触发回退策略,选择历史上综合健康度最高的候选版本。最后,系统通过内联外部依赖资源、规范化数学公式排版,输出独立且完全可渲染交付的矢量化海报产物。
PosterBench:建立学术海报的七维严苛基准
为了检验设计脚手架的真实能力,研究团队构建了涵盖物理科学、生命科学、工程技术、计算机与跨学科共 100 篇高质量论文的 PosterBench 全面基准,并配套提供了 10 篇论文构成的受控精简集 PosterBench-mini。
传统的图文评估往往依赖单一的 VLM 打分,极易受大模型自身的审美偏见影响,对排版重叠、数值篡改等细微硬伤极不敏感。PosterBench 构建了一套包含七个维度的混合评测协议,结合了确定性空间几何计算、OCR 文本提取、数值溯源比对以及多模态大模型的结构化打分:
-
忠实度(Faithfulness):海报所展示的核心论点是否严格来源于论文,杜绝大模型编造虚假实验结论。
-
覆盖度(Coverage):是否囊括了论文核心的问题背景、方法机制与关键实验结果。
-
信息密度(Density):排版是否紧凑高效,既不空洞也不过于拥挤。
-
视觉证据(Visual Evidence):核心图表与数据曲线是否被准确截取、高保真内嵌且图注对应无误。
-
结构布局(Layout):各板块是否有清晰的视觉流向与科学分组,几何网格系统是否稳定。
-
可读性(Readability):字体大小、层级对比、行距与公式排版在远距离或缩略视域下是否清晰易辨。
-
视觉美学(Aesthetics):配色方案、空白留存以及整体学术视觉调性是否协调。
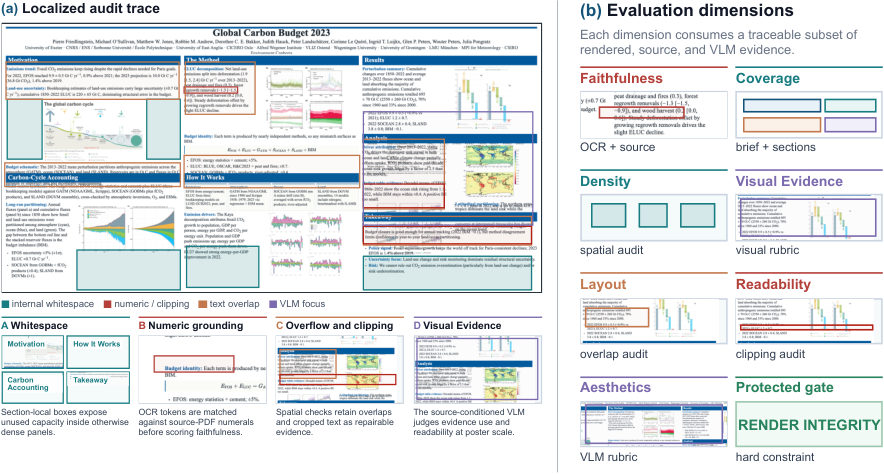
针对海报可能出现的致命物理缺陷,PosterBench 设立了四个门控惩罚算子:一旦检测到严重的版面错位重叠、代码无法渲染崩溃、缺少核心输出或者未达到最小可用标准,最终总分将直接被截断为极低的惩罚分。这一设计彻底堵死了生成模型用“表面华丽但底层错乱”的代码刷分的技术漏洞。
实验结论:脚手架带来的系统级代差
在严苛的基准测试下,AutoDesign 展现出了对现有端到端设计体系的全面超越。
在 PosterBench Main Track 的完整体系对决中,AutoDesign 达到了 78.32 的全场最高分。作为对比,业界顶尖的商业闭源系统 Claude Design 得分为 70.87,AutoDesign 确立了 7.45 分的显著优势。值得注意的是,如果单独使用 Claude Code(搭配 Claude 4.8)原生执行设计任务,得分仅为 70.01;而在不改变底层任何模型的前提下,仅仅挂载了 DesignHarness,性能就直接提升了 8.31 分。
更具说服力的是受控消融实验。在 PosterBench-mini 上测试的 7 种代码代理与基础模型组合中,无论是前沿的闭源模型还是开源顶尖架构,接入 DesignHarness 后均获得了无一例外的阶跃式提升:
-
Codex + GPT-5.5 原生仅有 75.87 分,引入 DesignHarness 后升至 81.46 分(+5.59),刷新了所有配置的绝对上限;
-
Claude Code + Kimi K2.7 从 57.20 分攀升到 70.12 分(+12.92);
-
提升最显著的配置为 Claude Code + DeepSeek V4 Pro,直接从原先难以通过门控测试的 39.88 分提升至 59.44 分,净增 19.56 分。
除了客观跑分,团队组织了 11 位评审专家在系统完全盲测(System-Blind)的状态下对 100 篇论文的海报进行两两成对打分。在搜集到的 933 组有效真实偏好中,通过 Bradley-Terry 概率模型拟合,AutoDesign 斩获了高达 64.0% 的最高人类偏好概率;当两款系统在 PosterBench 自动评分差距达到 20 分以上时,人类偏好与自动评分倾向的高度一致率达到了 74.4%,强力验证了自动评测协议与真实人类审美品位的高度对齐。
而在成本效益曲线方面,数据揭示了工业化部署的广阔空间。当搭载轻量模型 LongCat-2.0 时,单张复杂学术海报的平均调用成本仅为 0.27 美元,却能取得 55.13 分的基本可用表现;搭载豆包(Doubao Seed 2.1 Pro)时,系统能以 2.75 美元的单张成本达到 71.83 分的优异水准,实现了 GPT-5.5 顶级配置 88% 的性能,而消耗成本降低了 73%。
走向自进化的通用多模态工作流
这项研究的深层价值不仅在于“搞定了一张会议海报”,更在于验证了复杂多模态设计任务中的工程范式转移。长期以来,社区习惯于把长程推理与高质量生成的期望完全寄托在基座模型的规模膨胀上;然而 AutoDesign 证明,面对现实世界中严苛的排版、渲染、证据溯源和交互修改需求,优化外围脚手架的代码逻辑与工具拓扑,往往能释放出比单次模型微调更直接、更透明且可复用的生产力。
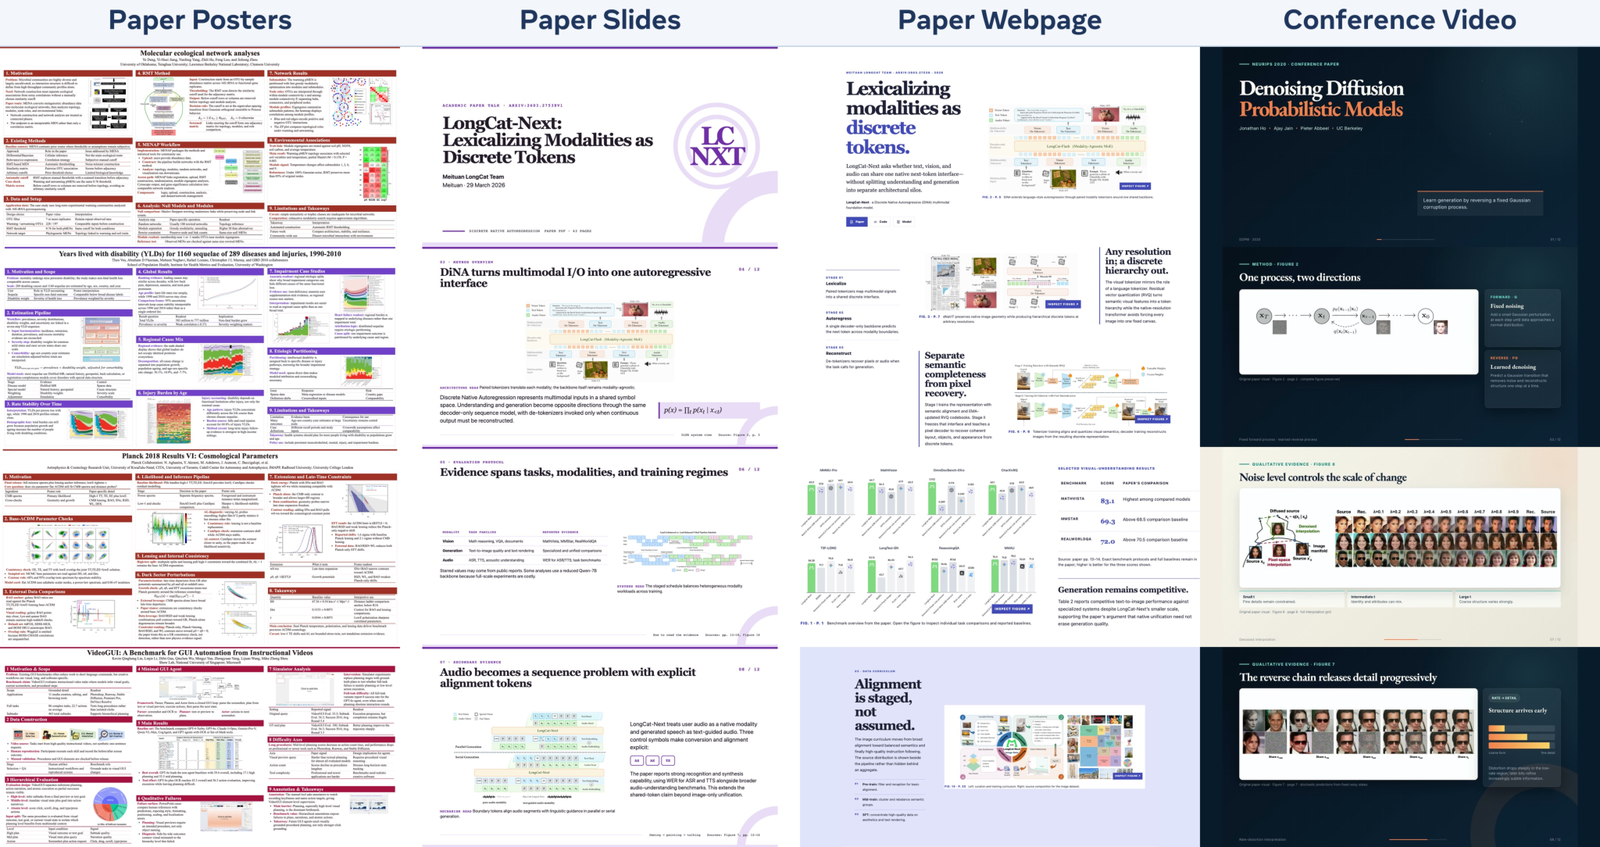
论文展示的早期实验表明,相同的元脚手架进化机制同样可以直接迁移至学术幻灯片(Paper-to-Slide)、学术专题网页(Paper-to-Webpage)以及短视频汇报(Paper-to-Video)等多样化呈现载体。当模型面对一个全新的传播媒介时,无需耗费重金重训多模态架构,只需要赋予元优化器该媒介特有的编译规则、视觉评判标准以及足够丰富的探索试错空间,系统就能依靠自身在失败轨迹中的推演,逐步“写”出一套工业级的自动化生产系统。这种“让 Agent 自己迭代 Agent 运行环境”的思想,无疑为未来自进化智能体的长程任务架构设计指明了一条极具实操价值的新路线。