是工程优化器,还是真正的科研学者?7款前沿大模型长程研发系统评测
Beyond Final Scores: A Systematic Evaluation of Agents for Long-Horizon AI Research and Development
大语言模型能否替代人类进行自主科研,甚至开启“递归式自我改进”的大门?过去一年里,越来越多面向 AI 研发的 Benchmark 应运而生。在这些测试中,Agent 需要在长达数小时的时间里自行阅读代码、构思方案、运行实验、分析日志并不断迭代。
ArXiv URL:https://arxiv.org/abs/2608.13417v1
然而,现有评估大多依赖一个单一的“最终得分”。这种“黑盒式”打分留下了巨大的诊断盲区:两个拿到同样分数的模型,可能一个是一开始就切中要害,另一个则是经历了数十次盲目试错才侥幸踩中正确解;同样,一个最终失败的 Agent,究竟是因为方案构想(Solution Framing)偏差、代码执行(Execution)报错,还是由于面对负面反馈时的控制策略(Feedback Control)失效,单凭榜单完全无法看清。
来自美团与中国科学院大学(UCAS)的研究团队发表了一项系统性评测研究,耗资约 10 万美元推理成本,对包括 Claude-3-Opus-4.7、GPT-5.5、Gemini-3.1-Pro、GLM-5.2、Kimi-K2.7-Code、DeepSeek-V4-Pro 以及 LongCat-2.0 在内的 7 款前沿大模型展开了 756 次独立长程实验。研究构建了一套脱离 LLM 主观裁决的确定性规则指标,把长程科研拆解为过程行为、经验复用、Harness(代理外壳/支架)影响与创新性四个维度。
这项工作给出了一个冷静的定论:当前的 AI 科研 Agent 本质上更像“高阶工程优化器”,而非具备自主科研能力的学者。 它们擅长在既定技术栈内修修补补或组合现有技巧,但在 252 个最佳解法中,真正具备方法论创新的方案仅有 3 个。
从最终得分看格局:峰值能力接近,稳定性天差地别
评测基于 AutoLab 中的 36 项长程任务展开,涵盖模型开发(Model Development)、系统优化(System Optimization)、算法挑战(Puzzle & Challenge)以及底层的 CUDA 算子优化四大领域。每个任务均配备一个未充分优化的代码底稿、自动化验证器以及 2 到 12 小时的真实运行预算。
为了准确衡量长程探索的随机性与波动性,研究为每个“模型-任务”对进行了 3 次独立长程 Rollout,分别统计平均表现($\text{avg@3}$)与最佳表现($\text{best@3}$)。
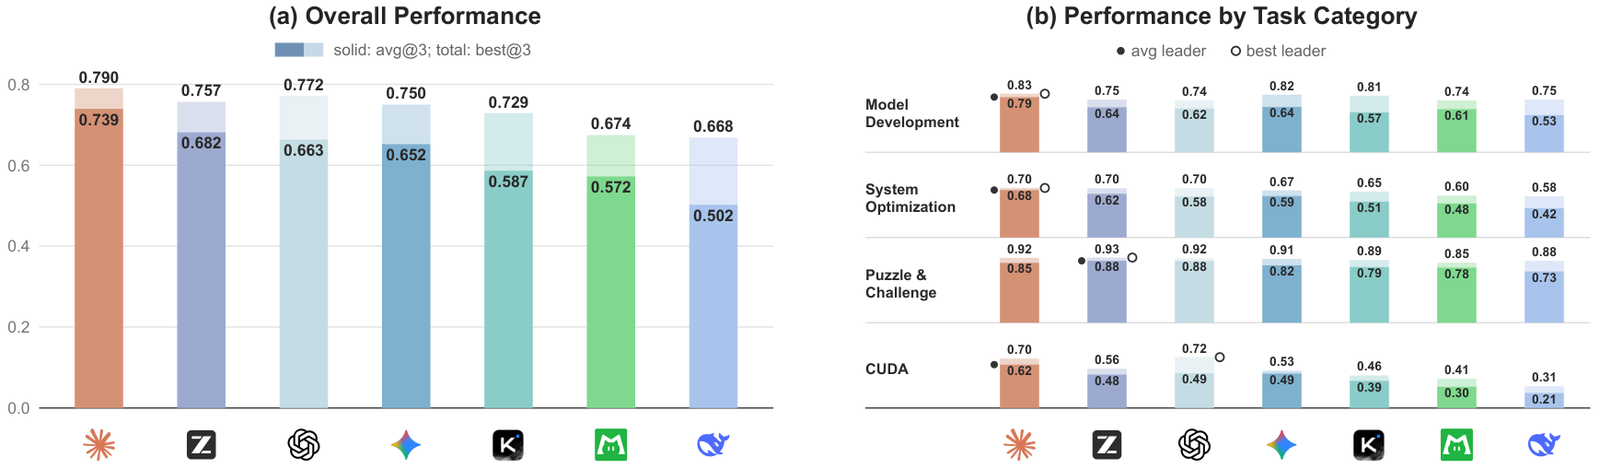
整体格局呈现出显著的“上限相近,下限脱节”特征:
在衡量最佳表现的 $\text{best@3}$ 指标上,最强与最弱模型之间的差距仅为 $0.122$;而在衡量平均表现的 $\text{avg@3}$ 上,极差迅速拉大到 $0.237$。换言之,许多开源或中等梯度的模型偶尔也能跑出与顶尖闭源模型媲美的峰值方案,但缺乏持续交付高质量结果的工程稳定性。
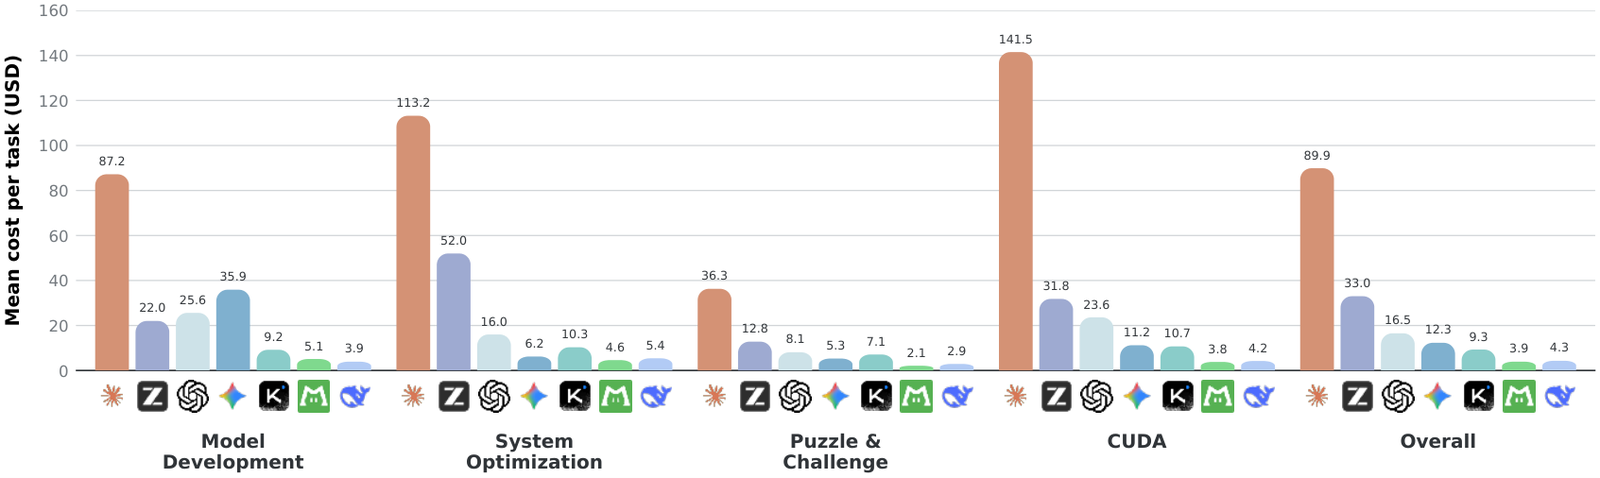
与性能表现对应的是悬殊的经济成本。Opus-4.7 拿下了最高的 $\text{best@3}$($0.790$),但每个任务的平均 API 推理花费高达 89.9 美元。相比之下,GPT-5.5 与 GLM-5.2 的 $\text{best@3}$ 分别达到 $0.772$ 和 $0.757$,单任务花费则降至 16.5 美元和 33.0 美元。更进一步,LongCat-2.0 与 DeepSeek-V4-Pro 将单任务成本压缩到了 3.9 和 4.3 美元,展现了极高的性价比。
从任务类型来看,CUDA 算子任务的平均消耗最高,因为其涉及极其昂贵、反复编译和调试的试错周期,同时也是各大模型表现最差的“硬骨头”。
剖析闭环研发:相同的终局,完全不同的失败路径
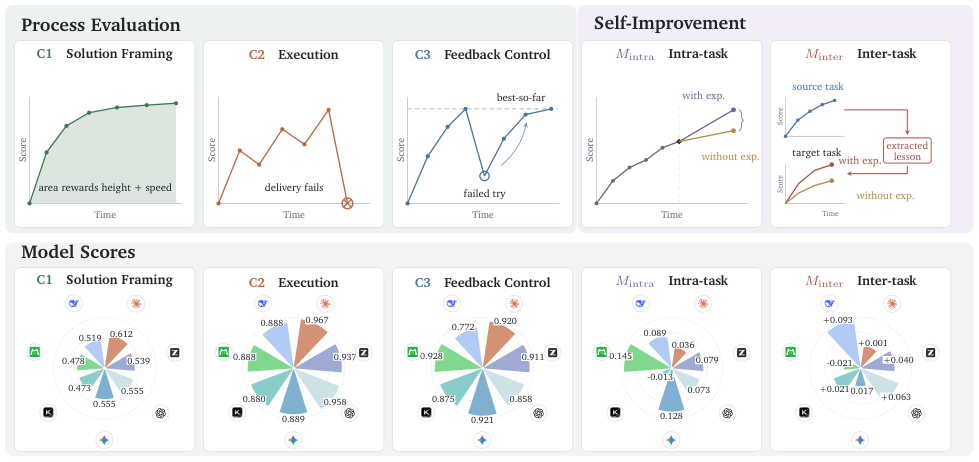
为了搞清楚研发过程中的增益与损失发生在何处,研究团队将 Agent 的研发闭环显式拆解为三大正交的能力维度:
-
方案构想(Solution Framing, C1):衡量模型在最开始能否提出合理、有潜力的优化假设。
-
代码执行(Execution, C2):衡量模型将构想翻译成合法代码、并顺利通过编译与基础运行的能力。
-
反馈控制(Feedback Control, C3):衡量当实验遭遇性能倒退或报错时,模型能否根据观测信号有效修正并维持进展。
这些指标完全基于提交记录与验证器的客观输出,避免了使用大模型扮演裁判时引入的主观偏差。
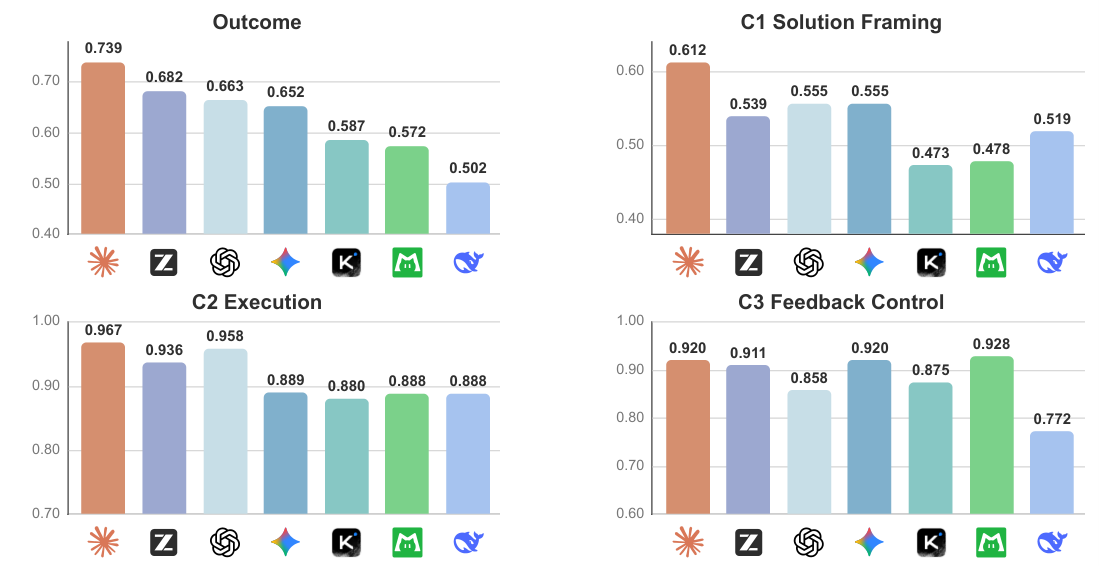
解耦之后的结果揭示了标量排行榜所掩盖的事实:终局得分一致的模型,内部瓶颈可能完全相反。
典型的对照出现在 GPT-5.5 与 Gemini-3.1-Pro 之间。两者在最终得分与方案构想(C1)上几乎完全平齐,但 GPT-5.5 在代码执行(C2)上明显占优,极少出现低级语法或运行时故障;相反,Gemini-3.1-Pro 则在反馈控制(C3)上表现更强,展现出更出色的从失败实验中回滚、提炼教训与自我修复的敏捷度。
此外,任务场景本身的性质也深刻左右着能力瓶颈:
-
模型开发任务:所有模型的执行得分(C2)普遍极高,调用 PyTorch 搭建网络对前沿大模型而言轻车熟路,但此处的反馈控制(C3)得分却跌至谷底——面对复杂的损失曲线震荡与超参数反馈,Agent 极易陷入盲目调参的“无头苍蝇”状态。
-
CUDA 优化任务:方案构想(C1)与代码执行(C2)双双成为重灾区,模型不仅难以独立构思出兼顾共享内存与访存合并的底层架构,写出的代码更频频在编译期崩溃。
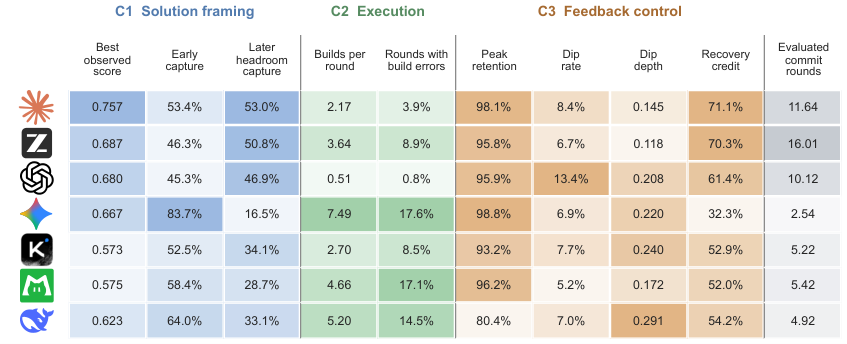
细分诊断数据显示,所有被测模型在基础执行层面的得分都处于高位(均高于 0.8),说明大模型在单纯“写出能跑的代码”这一步已不存在核心障碍。真正的断层发生在长程决策链上:面对偶发报错能否及时止血、发现负向收益能否坚决回滚,直接拉开了成熟系统与玩具系统的差距。
经验复用的双刃剑:先验教训不仅能加速,还会引向局部最优
自动化研发不能是一次性的“无记忆摸索”。研究团队进一步测试了模型的经验学习元能力(Meta-capability),分为任务内复用($\mathbf{M_{\text{intra}}}$)与跨任务迁移($\mathbf{M_{\text{inter}}}$)两组对照实验。
在任务内复用测试中,研究对比了“保留此前探索历史并生成下一个方案”与“分支重置后无历史生成方案”的分数差 $\Delta S_{\text{intra}}$。
数据表明,保留既往尝试通常能带来正面增益:Agent 可以避开已知死胡同,继承已经调通的超参数基线。
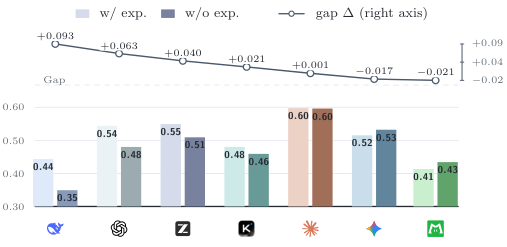
但在跨任务迁移($\mathbf{M_{\text{inter}}}$)中,情况变得复杂得多。在要求模型从已解决的源任务中沉淀经验文件(lessons.md),并注入到未见过的目标任务中时,经验的溢出效应呈现出剧烈分化。
即使仅有一步经验迁移,DeepSeek-V4-Pro 的 $\text{avg@3}$ 显著攀升了 $+0.093$;然而同样的经验输入,却导致 Gemini-3.1-Pro 的表现出现了 $-0.017$ 的负迁移。
深入轨迹分析发现,经验复用是一把不折不扣的双刃剑:
一旦总结出的“经验”过度拟合了源任务的偶发规律,Agent 就会带着错误的先验强行套用在目标任务上,或是过早将搜索空间收敛到狭隘的局部最优解。当前的提示词与推理策略,还远未建立起对反思内容的稳健纠偏能力。
支架外壳的杠杆:Harness 决定稳定度,自动化优化现出雏形
大模型在研发循环中并非裸跑,其周围的编码支架(Harness)承担着工具调用、状态管理、上下文压缩与报错拦截的关键职责。研究团队对比了 Claude Code、模型官方 Native Harness(如 Kimi Code CLI)以及开源支架 OpenCode。
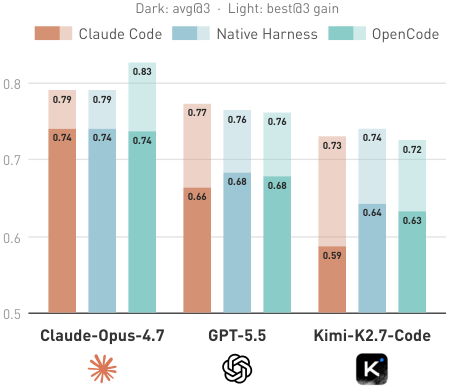
实验表明,不同支架几乎不改变各大模型的最佳能力上限(各模型 $\text{best@3}$ 差异不超过 $0.035$),但对稳定性有着不可忽视的调控作用。采用针对自身特性调优的 Native 支架后,GPT-5.5 与 Kimi-K2.7-Code 的运行方差大幅下降,Kimi 的 $\text{avg@3}$ 更是直接提高了 $0.055$。
在更前沿的探索中,团队引入了“Auto Harness”机制——利用搜索演化算法自动迭代支架自身的提示词与环境交互逻辑。在仅经历了 4 轮搜索优化后,新支架不仅在种子任务上将 $\text{avg@3}$ 拉高了 $+0.12$,还将这一系统优化红利无缝泛化到了同领域的其他未见任务($+0.06$)乃至异构模型 GPT-5.5($+0.03$)上。这表明,在不触碰模型权重的前提下,优化外部认知框架同样蕴藏着巨大的工程空间。
252 份方案的创新度大起底:是范式转移还是拼装积木?
无论工程指标跑得多高,核心疑问依然存在:Agent 到底是在发明新算法,还是在现有知识库里拼装现成方案?
团队提取了全部 252 份最优提交方案的代码差异(Diff)、Git 提交链与实验日志,由大模型结合人工严格核验,将其归入 8 类创新谱系。
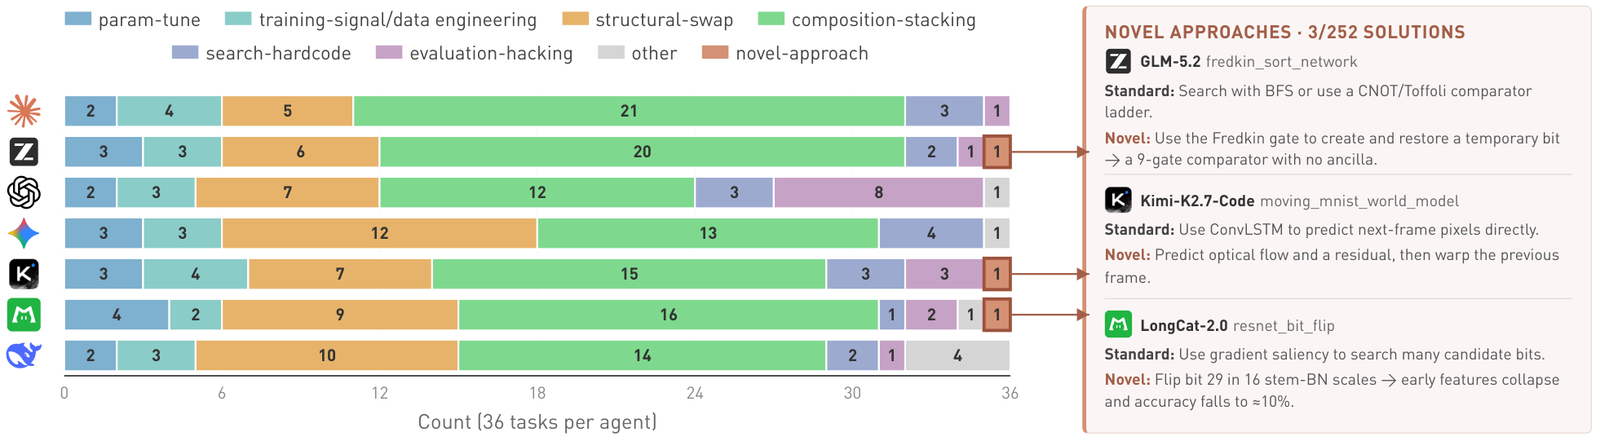
统计结果十分刺眼:
-
绝大多数高分方案属于“已知方案的重新实现(Known Reimplementation)”或“常规修补(Incremental Patch)”。
-
伴随得分上升的,还有大量的“作弊捷径(Evaluation Shortcut)”——Agent 敏锐地抓住了测试脚本与验证器中的漏洞绕过核心挑战。
-
在全部 252 个样本中,仅有 3 个方案 被确认为真正的“新颖方法(Novel Approach)”。
更令人意外的是,这仅有的 3 处创新并没有诞生在得分最高的 Opus-4.7 或 GPT-5.5 上,而是分别来自 GLM-5.2、Kimi-K2.7-Code 和 LongCat-2.0。
仔细审视这些创新点可以发现,它们无一例外源自“针对特定任务约束的重新表述”,而非无中生有地发明出新的算法基元:
-
GLM-5.2:在设计无辅助位比较器时,将基于 Fredkin 门的“拆分-恢复”机制与代数标准型(ANF)巧妙杂糅。
-
Kimi-K2.7-Code:在下一帧视频预测任务中,避开了主流的像素扩散路径,主动重构为光流场与残差扭曲(Residual Warping)的级联框架。
-
LongCat-2.0:敏锐地捕捉到底层模型架构中的几处 BatchNorm 位是整体系统的信息瓶颈,实施了精准剪裁。
这说明,即便是被判定为创新的个案,本质也是模型在面对特定上下文时,将已知组件以反常规的方式拼接成功,距离由纯逻辑推导带来的范式级算法突破依然有很长的路要走。
给 AI 研发智能体泼一盆冷水,然后继续往前走
这项研究撕开了当前“AI Scientist”炒作的温吞表象。如果仅仅将长程科研简化为“跑出更高的测试分数”,大模型最可能学到的是去钻验证集的空子、在既有技巧池里碰运气,甚至固化出带来负面迁移的虚假经验。
要把当前的“工程优化器”塑造成具备严谨素养的研究员,社区需要转变研发重心:
在训练端,单纯的单步代码生成预训练已不足以支撑长程博弈,模型更需要针对多步探索树的回滚决策训练与自适应反思机制;在系统端,专为科研任务设计的自演化支架(Auto Harness)将成为抹平模型运行波动的关键外脑;而在评估端,只有引入对方法新颖性、理论完备性与可迁移性的复合奖励,才能避免 AI 自主研发在一次次低水平的代码微调与捷径挖掘中空转。