ConsistencyGate:大模型Agent记忆防污染,真实长对话幻觉写入直降31.8%
ConsistencyGate: Preventing Memory Contamination in LLM Agents via Self-Consistency Admission Control
在大模型驱动的智能体(LLM Agent)系统中,长期记忆(Long-term Memory)几乎是构建复杂长程任务的标配。无论是陪伴型虚拟角色、自主代码助手,还是长流程分析 Agent,都需要把多轮交互中提取到的事实源源不断地沉淀到外部存储中,并在后续步骤中检索使用。
ArXiv URL:https://arxiv.org/abs/2607.22962v1
然而,当前的 Agent 记忆系统存在一个极其隐蔽却具有致命连锁反应的漏洞——记忆污染(Memory Contamination)。
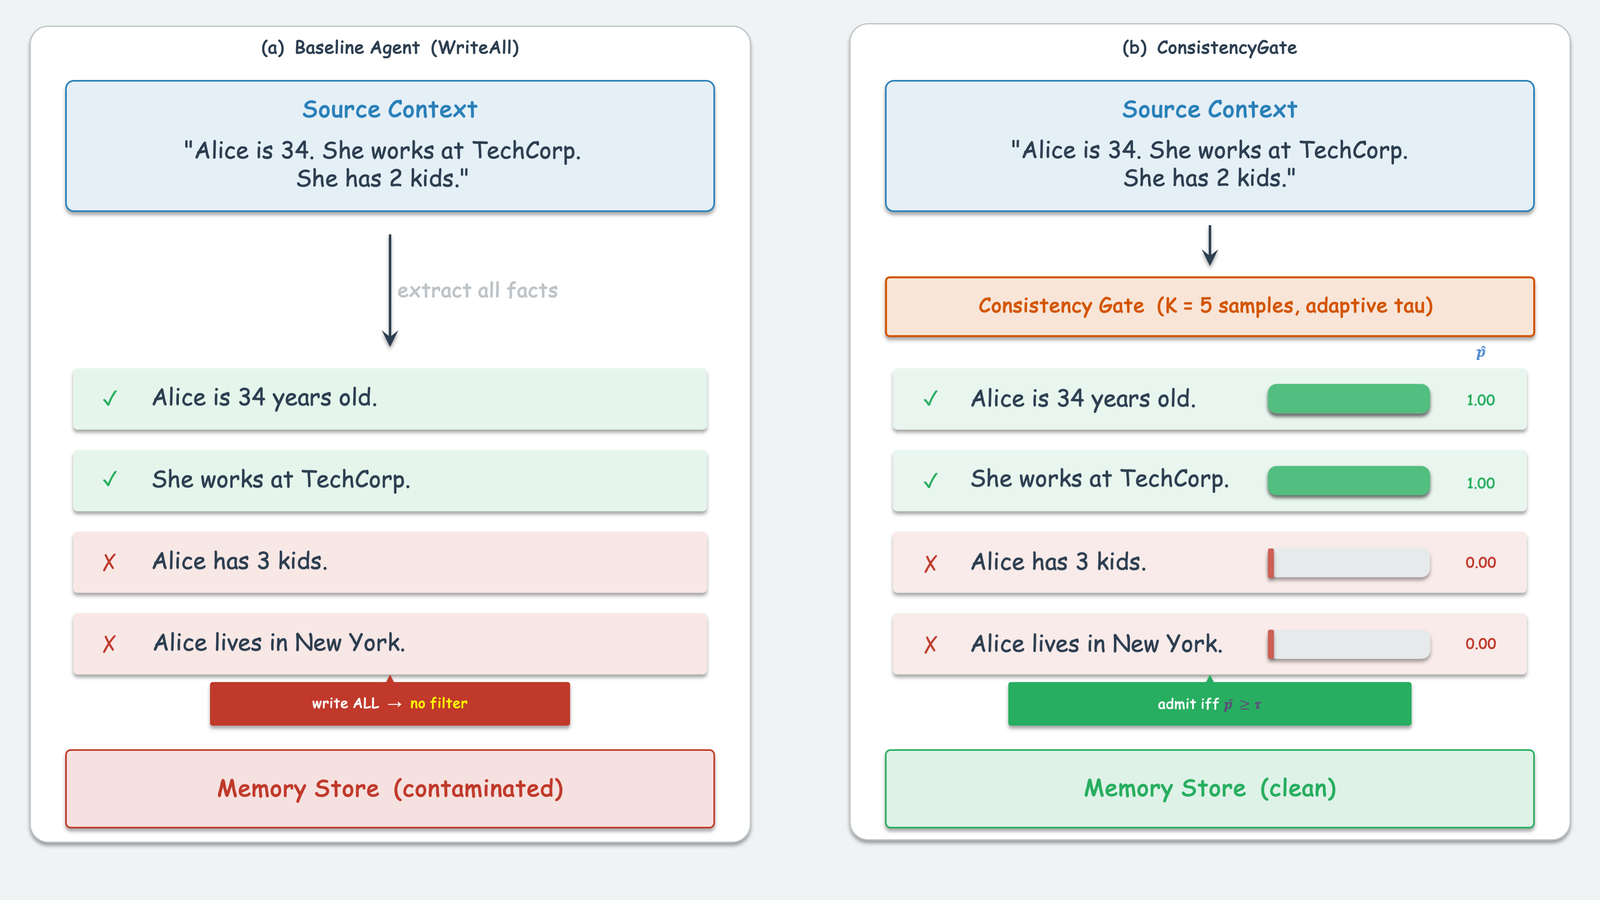
大模型在阅读上下文提取事实时,不可避免地会发生幻觉(Hallucination)。如果一条幻觉事实在写入阶段被“堂而皇之”地存入向量库或语义记忆,它就会永久变成后续所有推理的错误前置条件。每当 Retriever 检索出这条记忆,下游生成就会顺理成章地给出错误答案,这种错误还会随着交互轮次呈级联式放大。
来自佛罗里达州立大学(Florida State University)的研究团队在一篇前沿工作中直击这一痛点,提出了 ConsistencyGate。这是一个基于自洽性(Self-Consistency)准入控制的写入网关:它不依赖任何模型微调,也不去改变检索和淘汰逻辑,而是在事实准备写入记忆的那一瞬间,对其进行证据事实支撑度的软评分把关。实验表明,在真实长对话基准上,ConsistencyGate 将记忆污染率降低了 31.8% 和 26.6%,并提供了一个单次前向传播(LogProb)的高效加速变体,将单条检测耗时压缩至 20 余毫秒。
为什么现有记忆管理机制全失效了?
要理解 ConsistencyGate 的新颖之处,首先要看清为什么现存的所有记忆治理手段在面对“错误事实写入”时几乎完全失灵。
学术界与工业界过去对 Agent 记忆的优化,大致集中在三个阶段:
-
检索阶段(Retrieval):例如 Dense Retrieval、Hybrid Search,或者在 RAG 中引入类似 Self-RAG、CRAG 的检索后验证。
-
容量与淘汰阶段(Eviction):当记忆缓冲区满时,根据 FIFO、LRU,或者基于访问频次和重要性权重的衰减函数丢弃旧记忆。
-
准入控制阶段(Utility Admission):例如近期工作 A-MAC 等,通过评估候选事实的“边际效用”——即新颖性(Novelty)、时效性(Recency)以及未来的潜在检索价值,决定是否将其写入。
但这三类机制在“虚假事实”面前全线溃败。
首先,检索机制无法救场。如果记忆库里存入了一条错误事实,即便拥有完美无瑕的 Oracle 检索器,也只会更精准、更高概率地把这条错误事实捞出来,喂给下游 Prompt。检索器越精准,毒性发酵越快。
其次,基于效用的淘汰和准入机制存在先天的结构性盲区。假设原始上下文明确说明“Alice 于 2012 年毕业”,而提取模块由于幻觉生成了“Alice 于 2015 年毕业”。从语义新颖度、与用户当下话题的相关度、以及未来被查询的潜在概率来看,这句假话与真话没有任何统计特征上的差异。现有的效用准入控制器只会认为它“非常有用,必须记录”,毫不犹豫地将其放入记忆库。
换句话说,现有系统的核心评价指标是“这条信息对未来有用吗”,而不是“这条信息在当前证据下是真的吗”。这种准入标准上的错位,正是记忆污染持续滚雪球的根源。作者团队将这种现象称为“污染级联(Contamination Cascade)”:第 $t$ 轮写入的一处细微幻觉,会在随后的交互轨迹中持续投毒,彻底带偏模型长程推理的方向。
ConsistencyGate 的核心机制:把自洽性搬到“写入准入”
既然效用指标无法区分真伪,那么准入网关就必须回归最朴素的标准——事实支撑度(Factual Support)。
在推理任务中,Self-Consistency(自我自洽性)已经被广泛证实有效:大模型在多条思维链中,正确的答案往往高度稳定,而错误往往具有随机性。ConsistencyGate 将这一思想迁移到了记忆写入时刻,但做了一个至关重要的升级:利用当下的输入上下文 $c$ 作为扎根依据(Grounded Context)。
1. 软评分多重采样(Soft Support Verification)
设智能体在交互步骤 $t$ 观察到当前上下文 $c$(例如对话轮次、工具输出或文档切片),记忆写入模块从上下文抽取了一组候选原子事实 $\mathcal{F}$。在每个事实 $m \in \mathcal{F}$ 正式被写入长期记忆 $\mathcal{M}$ 之前,ConsistencyGate 会拦截该事实,并向大模型发起 $K$ 次验证查询。
验证提示词并不要求模型直接给出生硬的布尔值,而是要求模型根据上下文 $c$,在 $[0, 1]$ 的连续区间内对“事实 $m$ 是否受到 $c$ 的支撑”进行软评分:
\[s_k = \mathcal{L}\bigl(\text{prompt}(m, c)\bigr) \in [0, 1], \quad k=1, \dots, K\]随后计算这 $K$ 次采样的均值:
\[\hat{p}(m \mid c) = \frac{1}{K} \sum_{k=1}^K s_k\]当且仅当 $\hat{p}(m \mid c) \ge \tau$ 时,事实 $m$ 才被放行存入记忆库;否则直接丢弃。经过详尽的超参数消融实验,作者推荐将固定阈值设为 $\tau = 0.7$。这个得分界限对真实支撑与幻觉信息呈现出极强的区分度。
2. 极致性能:单次前向 LogProb 变体
在生产环境中,如果记忆抽取模块单步析出了 10 条事实,按照 $K=5$ 次采样,意味着写入阶段需要额外进行 50 次模型生成调用,这会带来无法接受的端到端延迟。
为此,本文提出了一个单次前向传播即可完成的轻量化变体——LogProb 模式。该模式将验证 Prompt 改为二分类 Yes/No 问题,并直接读取首个生成 Token 的对数概率(Log-Probability):
\[\hat{p}_{\log}(m \mid c) = \mathrm{softmax}\Bigl(\bigl[\log p(\texttt{yes} \mid \text{prompt}), \; \log p(\texttt{no} \mid \text{prompt})\bigr]\Bigr)[0]\]由于现代推理框架(如 vLLM、Triton 等)原生支持提取首词 LogProb,这种方法只需要一次前向推理即可完成判定。在配备 32B 规模模型的单卡环境中,该变体将单条事实的验证延迟从 $K=5$ 时的 264–363 毫秒大幅压缩至 23–28 毫秒,实现了 12 到 14 倍的推理加速。
不过,作者在分析中敏锐地指出,LogProb 能够完美平替多重采样的前提,是上下文的“双峰分布特性(Bimodality)”。在结构规整、证据集中的上下文中,模型对正确事实的 $\log P(\text{yes})$ 迅速饱和趋近于 1,对捏造事实的 $\log P(\text{no})$ 迅速饱和趋近于 1。但在极度发散、口语化强烈的多轮杂乱对话中,LogProb 的二元边界会发生退化,此时多重采样的软平均($K$-sample)依然更加稳健。
3. 动态自适应阈值调度(Adaptive Thresholding)
在很多通用 Agent 框架中,开发者可能无法针对每种下游特定模型精细调优 $\tau$。ConsistencyGate 进一步提供了一个随内存占用率自适应提升的门限调度策略:
\[\tau^*(\lvert \mathcal{M} \rvert, C; \tau_{\min}, \tau_{\max}) = \tau_{\min} + (\tau_{\max} - \tau_{\min}) \cdot \frac{\lvert \mathcal{M} \rvert}{C}\]其中 $C$ 为记忆库容量,$\tau_{\min}$ 为冷启动时的准入底线,$\tau_{\max}$ 为记忆库即将打满时的最高门槛。这个机制的底层逻辑非常符合直觉:在记忆库匮乏时采用相对宽松的标准,加速记忆积累;而在记忆库趋于饱和时大幅收紧准入门槛,杜绝任何可疑事实挤占宝贵的检索窗口。
构建新基准:向长对话注入真实、可控的毒素
评估记忆污染最大的难点在于:现有的长对话基准(如 LoCoMo、MSC 等)缺乏原子事实级别的金标标注(Gold Label)。直接拿模型跑完多轮对话,你很难客观量化记忆库里究竟渗入了多少比例的幻觉信息。
为了打破这种黑盒测评的困境,研究团队设计了精准受控的注入协议,构建了三套互补的基准:
-
MemContam(结构化合成基准):
涵盖个人履历、图书馆记录、食谱、科技报告、航天任务日志五大领域,共 200 个上下文。每个样本提取 5 个真实事实,并通过四种经典篡改方式构造 5 个具有迷惑性的虚假事实:数值扰动(改变年份数字)、否定转折、专有名词替换、追加矛盾从句。整个数据集严格锁定在 50% 的初始污染率,作为模型内部一致性的近上限参考。
-
LoCoMo-Contam(真实超长多轮对话基准):
基于包含 400–700 轮超长对话的 LoCoMo 数据集。研究团队将金标事实直接预置(Pre-seed)到背景记忆中,随后在探针轮次(Probe Turns)将真实表述与篡改表述分别通过完整的观察提取流水线输入,精确测试网关能否将与前序上下文冲突的微小篡改识别并拦截。
-
MSC-Contam(多会话人设基准):
基于 Multi-Session Chat 真实会话,专注于说话人人设(Persona)维度的长效事实。筛选出包含具体职业、居住地、数字等具象特征的陈述,并在多会话跨度下植入细节被替换的伪造事实,测试模型在面对具有稳定人设特征的语境时的防污染能力。
在核心评估指标上,论文重点追踪污染率 $\rho$(已准入事实中错误的占比,越低越好)、准入精确率(Admission Precision,即 $1 - \rho$)、准入召回率(Admission Recall,正确事实被准入的比例),以及下游问答的 F1 分数。
实验结果:在多款模型上拦截虚假记忆
实验评测覆盖了 Qwen2.5-32B-Instruct、Llama-3.3-70B、Gemma-31B 以及 Llama4-Scout 等多款具有代表性的开源模型底座,并与全量写入(WriteAll)和等比例随机写入(Random)进行了严格对照。
在合成基准 MemContam 上,ConsistencyGate 展现了近乎完美的过滤性能。全量写入 baseline 的记忆污染率固定在 50%,下游问答 F1 仅有 0.474。而在 ConsistencyGate($\tau=0.7, K=5$)的拦截下,污染率直接从 50.0% 断崖式下降到 1.2%,相对降幅高达 97.6%,同时保持了 100% 的正确事实召回率,下游 QA F1 提升至 0.840。相对地,Random 基线在过滤掉相同体量的数据后,问答表现完全没有改善,这有力证实了性能的跃升完全来自“正确性校验”,而非单纯缩减记忆体积带来的偶然增益。
在更贴近实际落地的真实长对话基准上,ConsistencyGate 同样表现稳健:
-
在 LoCoMo-Contam 上,以 Qwen2.5-32B 为底座时,记忆污染率从 50.0% 降至 34.1%,准入精确率大幅提升 0.159,相对污染降幅达到 31.8%。
-
在 MSC-Contam 上,污染率从 50.0% 压制到 36.7%,准入精确率提升 0.133,相对降幅达到 26.6%。
更重要的是对“级联效应”的阻断。在跨越 100 轮交互的轨迹追踪实验中,WriteAll 策略下的智能体随着轮次增加,下游 QA F1 迅速停滞在 0.45 左右,因为错误事实在检索池中形成了“鸠占鹊巢”的劣币驱逐良币效应。而开启 ConsistencyGate 后,随着干净事实的不断沉淀,污染率在第 90 轮时稳步滑落至 3% 以下,下游任务得分单调上升至 0.88。
跨模型泛化实验还揭示了一个有趣的规律:验证器的强弱直接决定了防御的上限。
在四款模型中,参数量最大的 Llama-3.3-70B 表现最为惊艳,在不同采样次数 $K$ 和阈值 $\tau$ 下始终保持极高的辨别力,在 LoCoMo-Contam 上取得了 0.810 的准入精确率和 0.680 的召回率。而相对轻量的 Llama4-Scout 软评分分布更加扁平,在宽松阈值下更容易放行边缘模糊的事实,但只要将固定阈值切到推荐的 $\tau=0.7$,各模型之间的差距便迅速抹平。
关键取舍与失败模式:并非没有代价
这项研究最令人赞赏的地方在于,作者并未一味夸大该方法的“全能”,而是坦诚地剖析了准入控制机制在实际落地中的核心代价——对隐式事实的过拟合拒识(Over-rejection of Implicit Facts)。
在 LoCoMo-Contam 这一极度拟真的复杂长对话中,ConsistencyGate 的召回率出现了明显下滑,仅为 0.58(四款模型的召回范围在 0.52 至 0.68 之间),远低于 MSC-Contam 上的 0.93。
深入分析案例后发现,这种召回率的损失并非由于算法逻辑故障,而是源于真实对话事实的表达特征。在 MSC 这种以 Persona 为主的对话中,用户的陈述通常是显式且高度独立的(如“我做护士已经 10 年了”);而在 LoCoMo 这种长达数百轮的自然对话中,大量事实是隐式表达(Implicit)或碎片化分布在多个轮次中的。
当网关 Prompt 强调“要求上下文对该事实提供明确支撑”时,验证器模型倾向于采取极为保守的策略:一旦某个事实需要经过跨轮次的隐式联想或常识推演,验证模型就会给出极低的支持分,进而将其当成幻觉粗暴拒收。
而在完全干净的无污染对话(LoCoMo clean)中,ConsistencyGate 带来的下游 QA F1 仅比全量写入下降了微弱的 1.5%(0.267 vs 0.271),而随机拒绝策略则会造成 16% 以上的大幅暴跌。这意味着,ConsistencyGate 虽然有“宁缺毋滥”的拒收倾向,但它剔除的大多是边缘、模糊或弱支撑事实,并没有对核心上下文记忆网造成结构性破坏。
总结与工程启示
长期以来,Agent 系统的构建者们习惯将注意力倾注在“如何把模型推向更长的上下文”以及“如何构建更聪明的语义检索算法”上,却在很大程度上忽视了记忆系统最底层的“垃圾进,垃圾出(Garbage In, Garbage Out)”定律。
ConsistencyGate 的实践给后续 Agent 架构设计带来了三点非常务实的启发:
-
准入控制必须双轨并行:未来的 Agent 记忆网关应当拆分为两个解耦的模块——负责效用性(Utility)的模块衡量“是否值得记”,负责真实性(Consistency)的模块核验“事实是否可靠”,二者缺一不可。
-
推理架构首选分级策略:在工程落地时,完全可以针对结构化片段、简短表述采用单次前向的 LogProb 快速准入(单次开销仅 20ms+);而对于多轮隐式推理、长程上下文抽取的高价值信息,再降级调用 $K=5$ 次采样验证,平衡系统吞吐与记忆纯度。
-
记忆自愈比盲目堆砌容量更重要:在多轮长时间跨度任务中,阻断错误的写入时机,远比在后续检索时做庞杂的再排序(Reranking)或事实修正来得廉价且彻底。
在构建更长寿命、更可靠的自主智能体道路上,给记忆写入端口加上一把基于自洽性校验的门禁锁,或许是低成本治愈“记忆污染”最优雅的一剂良药。