破解异构机械臂迁移难题!行为对齐表征让真机任务进度提升28%
Cross-Embodiment Transfer via Behavior-Aligned Representations
在大模型走向物理世界的过程中,具身智能(Embodied AI)面临着比纯文本或纯视觉模型更为棘手的数据异构问题。自然语言的数据格式天然统一,但机器人的硬件形态却千差万别:不同的自由度、不同的运动学链条、不同的连杆外观与相机视角,以及截然不同的控制频率与动作空间。这种强烈的“本体特异性”(Embodiment Specificity),导致我们在机械臂 A 上辛苦收集的成千上万条轨迹,往往极难直接迁移到机械臂 B 上使用。长久以来,许多跨本体(Cross-Embodiment)学习方法要么退化为简单的多任务粗暴混合训练,要么受制于各平台间巨大的状态分布偏差,导致正向迁移效果微弱,甚至发生性能负迁移。
ArXiv URL:https://arxiv.org/abs/2607.27549
面对这一瓶颈,最新研究提出了利用行为对齐表征(Behavior-Aligned Representations)来打破本体壁垒的新思路。这项研究的核心观察在于:尽管机器人的外观和关节参数各异,但在完成同一类操作任务时,其高阶意图、与交互物体的空间几何关系、以及末端执行器在工作空间内的运动趋势往往具备高度的跨本体不变性。如果能够在视觉-语言-动作(VLA)模型中显式引入这类行为对齐的辅助表征作为中间桥梁,就能在底层策略参数中构建出跨本体的隐式对齐空间。
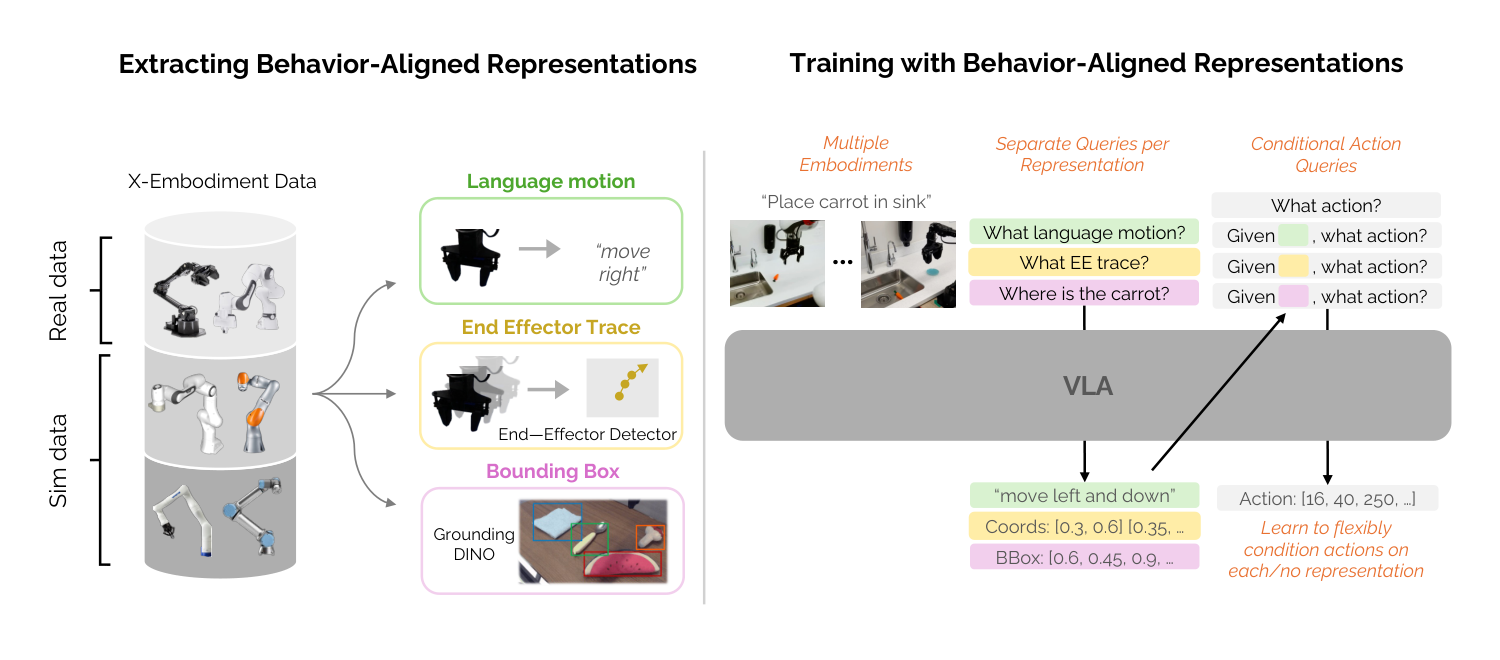
该研究在构建的跨本体仿真基准以及真实机械臂测试中给出了扎实的结论:引入行为对齐表征能显著改善跨平台迁移效果,其中以末端执行器轨迹(End-Effector Traces)的提升最为关键;更重要的是,这种表征使得策略能够从完全不带底层控制动作的跨本体数据(Action-Free Data)中汲取有效先验;在极具挑战的虚实跨本体(Sim-to-Real Cross-Embodiment)泛化实验中,该方法将真实机械臂的整体任务完成进度大幅提升了 28%。
异构数据的核心冲突:低阶动作与高阶意图的割裂
在大规模模仿学习中,数据规模和多样性直接决定了策略的泛化边界。然而,现实中机器人领域的公开数据集往往来自不同实验室的不同平台,如各种不同规格的 Franka、UR5e、KUKA iiwa、Kinova 以及 ViperX 等机械臂。现有的通用做法通常是依赖视觉-语言-动作(VLA)模型的大容量参数,硬生生地端到端拟合所有跨本体演示数据。
但直接拟合往往面临一个根本矛盾:观察图像中包含了极强烈的机器人本体视觉线索(例如机械臂的材质、颜色、关节连杆的拓扑位姿),而最终要回归的目标动作又是高度依赖当前机械臂几何结构的物理位移。这导致网络很容易将任务意图(如“把黄瓜放进水槽”)与特定的机械臂外观及特定关节配置过度耦合。当模型被部署到全新的目标机械臂上时,哪怕场景中的操作物体完全一致,模型也会因为外观差异和动力学错配而产生严重的动作误判。
解决这个问题的直觉,是寻找一种表征层级:它既不能像底层关节扭矩或末端增量动作那样对机器人结构极其敏感,也不能像纯语言描述那样抽象到丢失精确的空间几何控制细节。作者将这一平衡点定义为“行为对齐表征”。
行为对齐表征:在隐空间构建物理不变性
所谓行为对齐表征,是指那些在不同机器人本体之间具有物理几何或语义不变性,同时又对未来的动作决策具备极高预测价值的中间表征。研究团队聚焦并系统评估了三种易于标注、且与物理操作强相关的表征形式:
-
末端执行器未来轨迹(End-Effector Traces):机器人在第三人称相机画面中未来执行动作时,末端执行器在二维图像平面所经过的像素轨迹序列。机械臂的外形和轴数可以不同,但要抓住一个杯子,夹爪在空间中接近物体的相对位移路径往往是相似的。利用现有的开箱即用分割模型或几何反投影,可以极其方便地在图像帧上标记出这串 2D 坐标点序列。
-
物体目标边界框(Object Bounding Boxes):通过开放词汇检测模型(如 Grounding DINO)识别任务涉及的核心交互物体与容器位置。无论何种机械臂来执行操作,操作对象与目标区域的空间相对关系是恒定不变的。
-
语言动作描述(Language Motions):利用启发式规则和末端位姿变化量,将细粒度的动作分解为结构化的自然语言描述(例如“向右平移靠近水龙头”“向下移动夹爪”)。
在数学形式上,设机器人本体空间为 $\mathcal{R}$,每个特定本体 $r \in \mathcal{R}$ 拥有各自的观察空间 $\mathcal{O}^{r}$ 和动作空间 $\mathcal{A}^{r}$。常规模仿学习的目标是学习条件策略 $\pi_{\theta}(a \mid o, l)$,以最小化行为克隆损失:
\[\mathcal{L}_{\text{BC}}(\theta) = \mathbb{E}_{(o, a, l) \sim \mathcal{D}} \left[ \ell(\pi_{\theta}(\cdot \mid o, l), a) \right]\]而在引入行为对齐表征集合 $z = {z^{(1)}, z^{(2)}, \dots, z^{(K)}}$ 后,整体优化目标被扩展为动作预测损失与辅助表征对齐损失的加权联合形式:
\[\mathcal{L}_{\text{total}}(\theta) = \mathbb{E}_{(o, z, a, l) \sim \mathcal{D}, \tilde{z} \sim p_{\text{rep}}(z)} \left[ \ell(\pi_{\theta}(\cdot \mid o, l, \tilde{z}), a) + \ell_{\text{aux}} \right]\]其中辅助表征损失由多项表征重构项组成:
\[\ell_{\text{aux}} = \sum_{k=1}^{K} \lambda_{k} \ell^{(k)}_{\text{rep}}(\pi_{\theta}(\cdot \mid o, l), z^{(k)})\]在实际整合这些表征时,研究对比了两种架构策略:一种是显式的“具身思维链”(Embodied Chain-of-Thought, ECoT),即先由模型生成表征序列作为前缀 Token,再基于该表征生成动作 Token;另一种则是联合表征预测(Joint Reps),直接让多任务 Head 共享视觉与语言骨干的内部表征,同时监督动作与对齐表征。
打造具身评估场:RoboCasa-X 跨本体仿真基准
为了全面验证表征对跨本体迁移的真实影响,研究者没有停留在零散的评估上,而是基于真实的厨房交互环境 RoboCasa,设计了专门针对跨本体学习的仿真基准平台 RoboCasa-X。
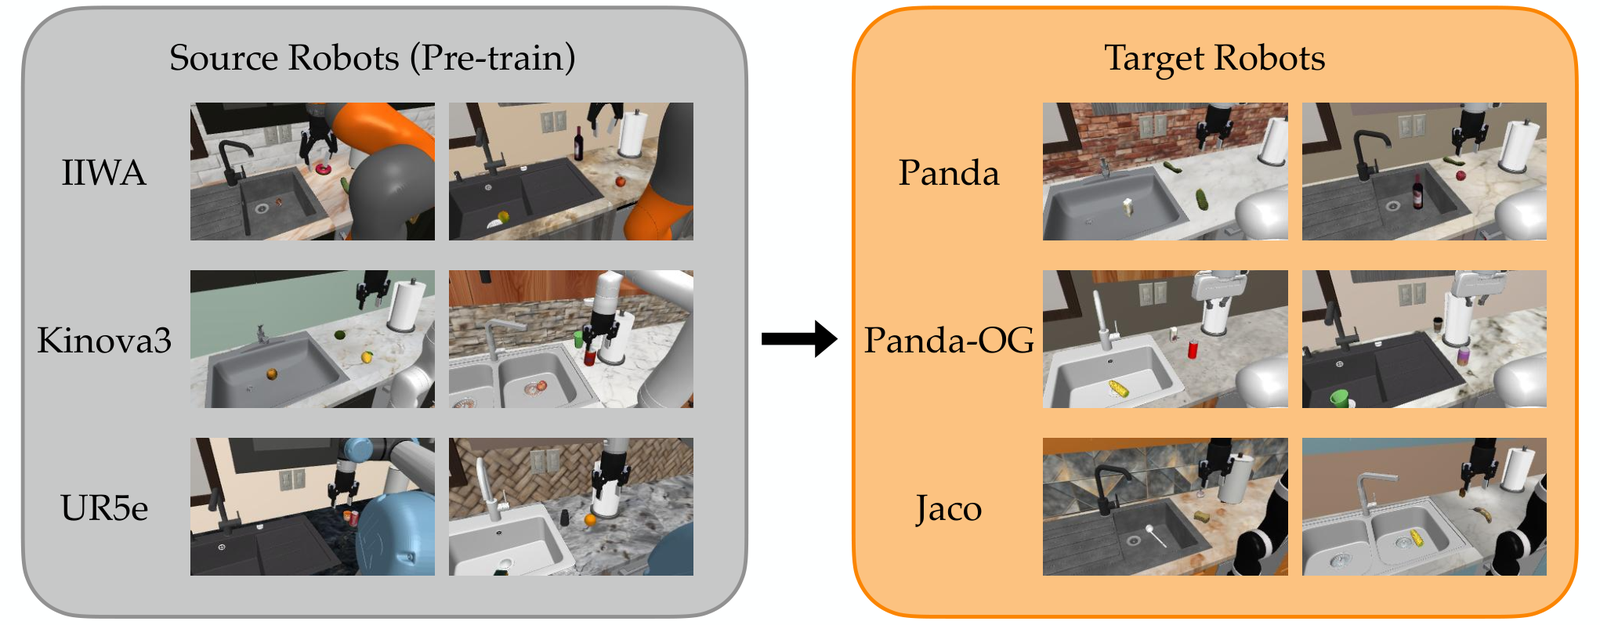
以往的机器人基准测试往往将重点放在任务的多样性上,而忽略了跨本体的受控变量对比。RoboCasa-X 填补了这一空白。它涵盖了多样化的现实厨房布局、复杂的材质纹理和丰富的可交互物体,包括四类具有代表性的操作任务:从台面取物放至水槽(PnP Counter to Sink)、从水槽取物放至台面(PnP Sink to Counter)、开启水龙头(Turn On Sink Faucet)以及将翻倒的马克杯扶正(Flip Mug Upright)。
在数据配置上,实验设置了三台源机器人(Source Robots):包括搭载在移动底座上的 KUKA IIWA、UR5e 以及 Viper 机械臂;同时设置了四台截然不同的目标机械臂(Target Robots):包括搭载移动底座的 Franka Panda、Kinova Gen3,以及采用不同安装配置的固定底座 Panda 等。研究方案采用在海量源机器人数据(混合了多种本体与复杂场景)上进行大模型预训练,随后仅使用极少量(例如每项任务仅 50 条)目标机器人的数据进行微调与零样本/少样本迁移评估。
仿真实验揭示的三大核心规律
通过系统性的对照消融实验,研究得出了一系列对于跨本体具身策略设计至关重要的技术洞察:
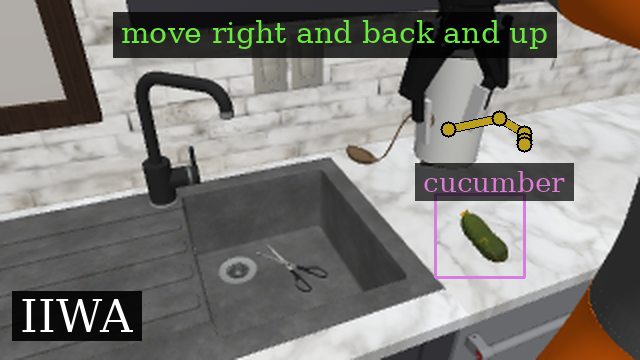
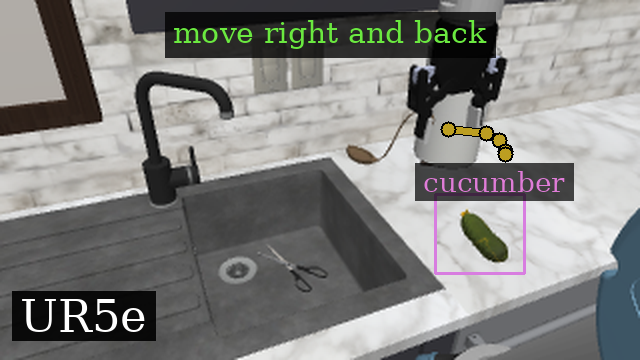
首先,所有行为对齐表征都能带来正向迁移收益,但“末端执行器轨迹”的贡献最为突出。实验数据显示,不论是边界框、语言动作描述还是末端轨迹,单独引入任何一种都能超越完全不使用中间表征的基线 VLA。然而,末端轨迹在所有本体上的提升幅度均最为明显。这是因为 2D 末端轨迹兼具了“局部连续动作导向”与“跨本体外观无关性”的双重属性,它不仅告诉模型应该关注哪里的空间位移,还直接过滤掉了机械臂形态和运动学逆解的低阶噪声。
其次,联合多任务预测(Joint Reps)在综合性能上优于显式的链式生成(ECoT)。虽然在理论上,以自回归方式生成思维链 Token(ECoT)符合直觉,但在高自由度操作控制下,自回归生成的微小表征漂移容易在后续的动作生成阶段被放大,从而导致复合误差。相反,Joint Reps 将这些表征作为底层的多任务监督信号,直接将几何不变性约束“压实”在骨干网络的内部特征空间中,动作预测 Head 依然能以端到端的方式直接输出动作,兼顾了表征规范化与动作执行的平滑度。
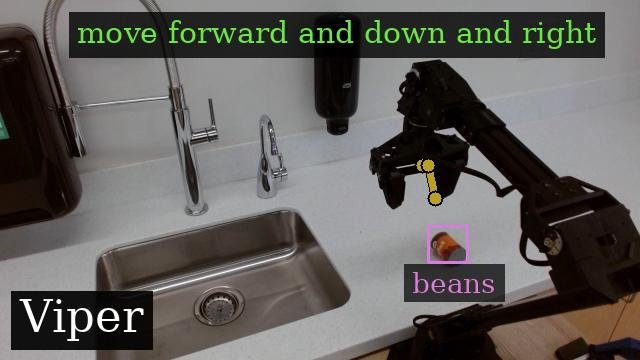
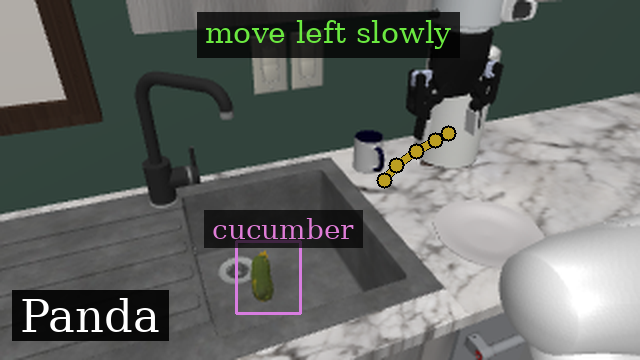
第三,行为对齐表征能够盘活海量的“无动作跨本体数据”(Action-Free Data)。在机器人领域,获取人类操作视频或缺少低阶动作标签的第三方机器人演示视频相对容易,但由于缺少动作标签,这类数据以往很难被直接用于模仿学习策略的预训练。研究团队进行了一项关键实验:在源数据集的预训练阶段完全抹去底层的精确动作标签,仅保留视觉观察和自动提取的行为对齐表征(末端轨迹、检测框等),在微调阶段才使用目标机器人的少量带动作数据。
结果表明,这种“无动作预训练”相比直接在目标机器人上从头训练提升了 14% 的成功率;甚至相比于使用全量跨本体数据预训练但“不使用任何对齐表征”的模型,其表现依然高出了 11%。这一结果具有极高的工业应用价值:它证明了行为对齐表征可以作为通用特征提取器,将原本无法直接执行模仿学习的海量无动作演示转化为强有力的跨本体视觉意图先验。
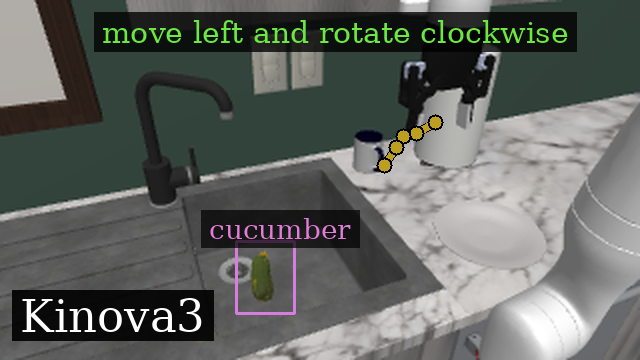
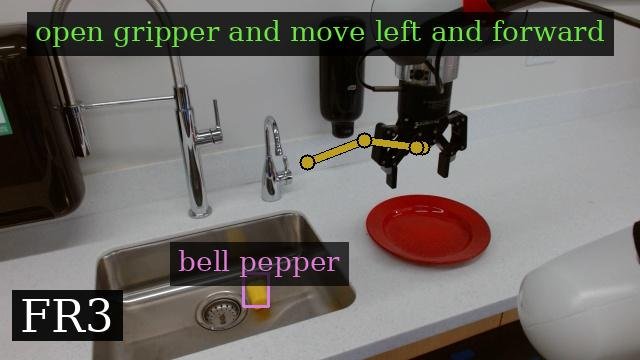
从虚到实:突破本体与域差距的双重挑战
单纯在仿真中实现跨本体迁移并不足以打消从业者的疑虑,因为真实世界的相机畸变、光照变化以及机械臂动力学漂移会进一步放大跨本体学习的难度。为此,作者设计了高难度的 Sim-to-Real 跨本体迁移实验。
实验的目标实体机采用了两款在仿真预训练数据中从未出现过的真实机械臂硬件:Franka Research 3(FR3)与 ViperX 300 S。这意味着模型在部署时必须同时承受两重巨大冲击:一是来自仿真环境到现实世界的视觉与物理域间隙(Sim-to-Real Gap);二是来自模型从未见过的真实机械臂物理几何结构的本体间隙(Cross-Embodiment Gap)。
评估在真实的厨房台面和水槽抓取任务上展开,对比了经过 3000 条仿真跨本体轨迹预训练后、再用真实机械臂每项任务仅 50 条演示数据微调的策略。实验结果不仅展现了更明显的代差,而且行为对齐表征在真实场景下的相对优势甚至比仿真环境更为剧烈:引入表征后,真实机械臂策略的任务完成进度相对基线整体提升了 28%。
这种显著优势的根本原因在于,现实世界中的视觉扰动极大,缺乏中间约束的端到端 VLA 很容易将注意力分散到真实机械臂的特异连杆高光或反光背景上。而通过端到端隐式预测末端轨迹与关键物体框,网络被迫学会将计算资源集中在与任务紧密相关的物理空间走向上,从而抑制了对机器人本体外表的敏感度。模型在面对未曾见过的全新机械臂本体时,依然能够精准预测出与仿真中高度一致的末端轨迹走势。
具身智能通用化的未来路径
这项工作通过清晰的实验设计与理论假设,对机器人跨本体迁移给出了一个极具启发性的技术路线:跨本体策略的泛化,关键不在于强行统一底层的关节动作空间,而在于寻找并规范跨本体共享的行为不变性。
研究不仅证实了末端执行器轨迹等表征在跨平台迁移中的决定性作用,更为利用网络上泛滥的人类视频和无动作多机器人数据开辟了低成本接入的渠道。虽然当前选取的边界框和 2D 轨迹主要面向以物体为中心的桌面操作任务,在更复杂的多指精细抓握或全身协调运控中仍需进一步探索更通用的 3D 行为几何表征,但它所确立的“通过行为对齐表征实现隐式本体泛化”的范式,无疑为解决具身智能硬件碎片化难题迈出了坚实的一步。