Decode-Time Grammars:根除代码幽灵引用,SQL执行匹配率达100%
Decode-Time Grammars: Constrained LLM Generation over a Refinement Order of Grammar Fragments
在大模型已经能够流畅编写主流语言代码的今天,越来越多的 AI 生成代码被直接丢进自动化管道:在没有人工逐行审查的情况下,由 Agent 调度分发、交付编译器构建或由数据库引擎执行。然而,当大模型离开 Python、JavaScript 这类海量语料哺育的主流语言,进入高性能张量算子语言(如 TileLang、Triton)、领域特定语言(如网络数据面语言 P4)、定制库 API 以及复杂的命令行接口时,一种隐蔽而致命的代码生成错误开始频繁暴露。
ArXiv URL:https://arxiv.org/abs/2607.18357v1
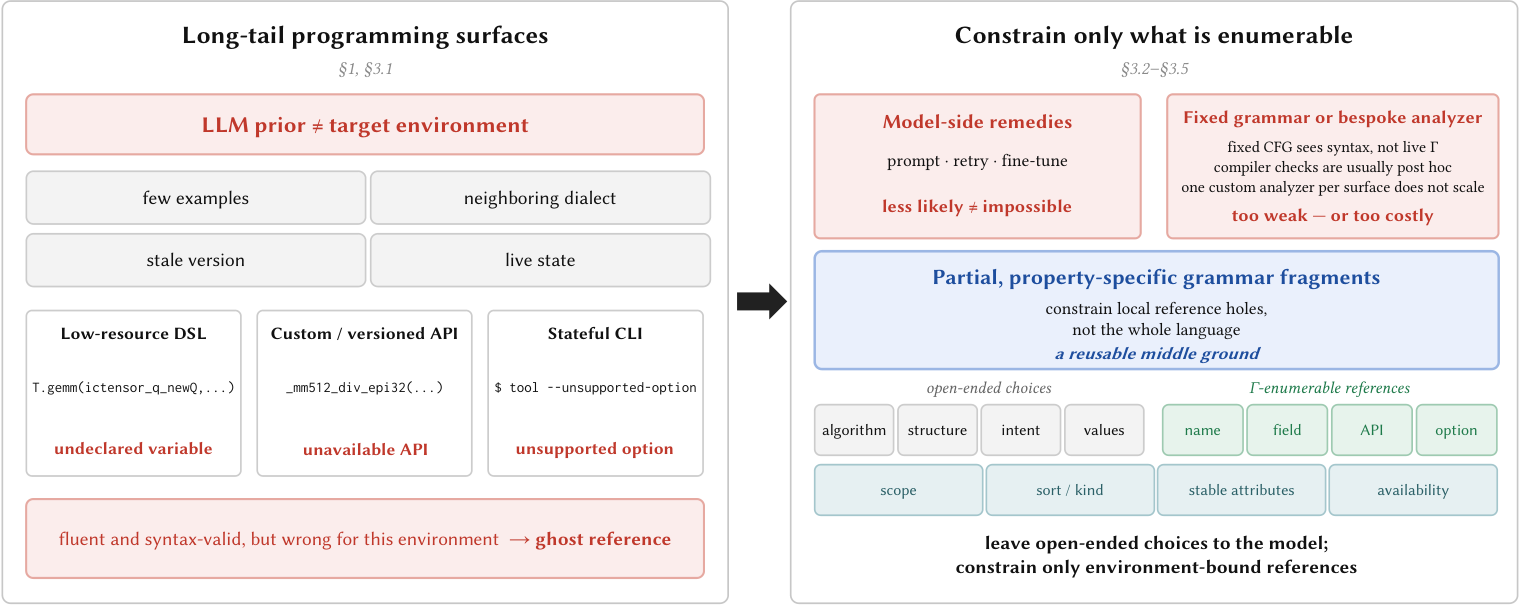
这类错误被称为“幽灵引用”(Ghost Reference)。生成的代码在语法结构上完全合法,甚至非常符合该语言的语法定义,但它调用的变量名、缓冲区、数据库列名或库函数,在当前执行环境中根本不存在。比如,在生成一段高性能矩阵乘法算子时,模型自信地调用了 T.gemm(ictensor_q_newQ, ...),然而 ictensor_q_newQ 这个缓冲区从未被声明过;或者在写 SQL 时,模型凭空捏造了一个并不在当前数据表 Schema 中的列。在传统的程序分析视角下,这是典型的符号未定义错误;在生成式大模型视角下,则是一种机械可判定的幻觉。
面对这种错误,现有的语法约束解码(Grammar-Constrained Decoding, GCD)引擎显得无能为力。无论是基于上下文无关文法(CFG)的 Token 掩码,还是各类 JSON/SQL 结构化生成工具,其约束大多是在推理前静态编译好的。它们能确保括号闭合、关键字合法,但在面对“变量名必须在当前作用域内已声明”这一动态要求时,只能将标识符位置视作开放类别,从而放任幽灵引用产生。
针对这一根本局限,来自中国科学院计算技术研究所(ICT, CAS)与利兹大学的研究团队提出了 Decode-Time Grammars(解码期语法),并实现了端到端系统 gproj。该工作将代码生成过程中的前缀与运行期环境深度绑定:模型在生成过程中声明的新符号会实时注入环境 $\Gamma$;而在生成引用位置时,语法引擎通过动态收紧算子 $\tau_\Gamma$ 实时实例化语法片段,仅将当前合法存在的符号保留在 Token 采样的支撑集(Support Set)中。在涵盖 0.6B 到 236B 参数量的多类模型测试中,gproj 在构造层面将幽灵引用降至零,并在 SQL 基准测试中将执行匹配率直接从 76% 提升至 100%,同时保持了可控的推理开销。
幽灵引用:负迁移与静态语法的天然盲区
幽灵引用的产生,往往不是因为模型“无知”,而是源于“负迁移”。在长尾和低资源编程领域,模型在海量预训练中吸收的大多是相近方言、邻近版本或标准 API 的知识。
例如,当模型被要求编写 TileLang 算子时,DeepSeek 等模型往往会习惯性地输出 TVM 原生语法中的 T.Buffer,而这一写法在 TileLang 中早已被弃用并替换为 T.Tensor。类似地,模型在编写底层代码时,可能自发拼凑出看似合理的指令宏如 _mm512_div_epi32,但该指令在硬件指令集中根本不存在。这种负迁移导致的错误之所以顽固,是因为对模型而言,这些错误候选不仅语法正确,而且在局部上下文的预测概率极高,即属于“非常流畅但错误的延续”。
依赖提示词工程(Prompting)、微调(Fine-tuning)或 Logit 偏置调整,只能在概率层面上降低错误概率,却无法将非法引用的采样概率彻底归零。更致命的是,传统的语法约束解码无法从根本上消除这一隐患。
从形式语言理论来看,静态的上下文无关文法存在天然的表达力上限。要断言“后文所引用的标识符必须是前文已声明过的标识符”,在形式语言上等价于要求语言识别类似 ${w#w}$ 形式的复制语言(Copy Language)。早自 1960 年代 Robert Floyd 对 ALGOL 60 语言的研究开始,程序语言理论就已确证:这种依赖上下文符号声明的性质绝非上下文无关文法所能刻画。
因此,现有的语法约束引擎不得不把变量名位置定义为一个通用的标识符产生式 identifier。这个产生式能够放行合法的变量名,但也必然放行任意拼写合法、但在当前程序符号表中未声明的幽灵变量。既然静态文法无法捕捉动态环境,唯一的出路就是将约束本身的构建推迟到解码期,让语法随着模型的生成过程动态演进。
解码期语法:用 $\tau_\Gamma$ 算子收紧动态支撑集
Decode-Time Grammars 的核心洞见在于:将逐步生成的代码前缀视为环境约束的输入源。
系统维护一个随生成逐步演进的运行期环境 $\Gamma$。对于张量算子 DSL 而言,$\Gamma$ 记录着当前作用域已分配的缓冲区块(Buffer)及其形状、类型;对于 SQL 而言,$\Gamma$ 是数据库当前的表结构与字段列表;对于工具调用和命令行接口,$\Gamma$ 则是当前环境暴露的可用子命令、分支状态及系统标志。
整个生成流程被划分为不同类型的代码区域与“空洞”(Holes)。当解码进行到声明区域时,模型自由生成新的符号,一旦声明完毕,新符号立即被吸纳入环境 $\Gamma$;当解码推进到引用位置时,关键算子 $\tau_\Gamma$ 启动:
\[\tau_\Gamma: \text{Open Reference Slot} \longrightarrow \Gamma\text{-typed Slot}\]该算子将原本无约束的开放标识符产生式,即时收紧为一个由当前环境 $\Gamma$ 严格限定的有限枚举产生式。如果当前符号表中仅有 A_shared、B_shared 和 C_local 三个缓冲区,那么在下一个操作数位置,Token 掩码所保留的合法延续将严格收缩在这三个符号构成的集合内。
这意味着,那些由模型预训练权重自发倾向输出的近邻方言、幻觉标识符,将在采样前的掩码步骤被强行剔除出支撑集。在经典的受限解码中,首步 Token 的候选空间可能多达数万个;而在 $\tau_\Gamma$ 生效后,首步候选集被瞬间截断至仅与当前环境符号相匹配的极少数路径。幽灵引用不再是“概率极小”,而是在构造层面上直接变得“不可能产生”。
语法片段与精化序:在自由度与安全性之间建立分工
完全将代码生成限制在硬编码的模版中,会扼杀大语言模型的推理能力与代码泛化性。因此,该研究进一步提出了基于语义域的语法片段精化序(Refinement Order $\sqsubseteq$),系统地确立了模型与语法约束之间的“劳动力分工”。
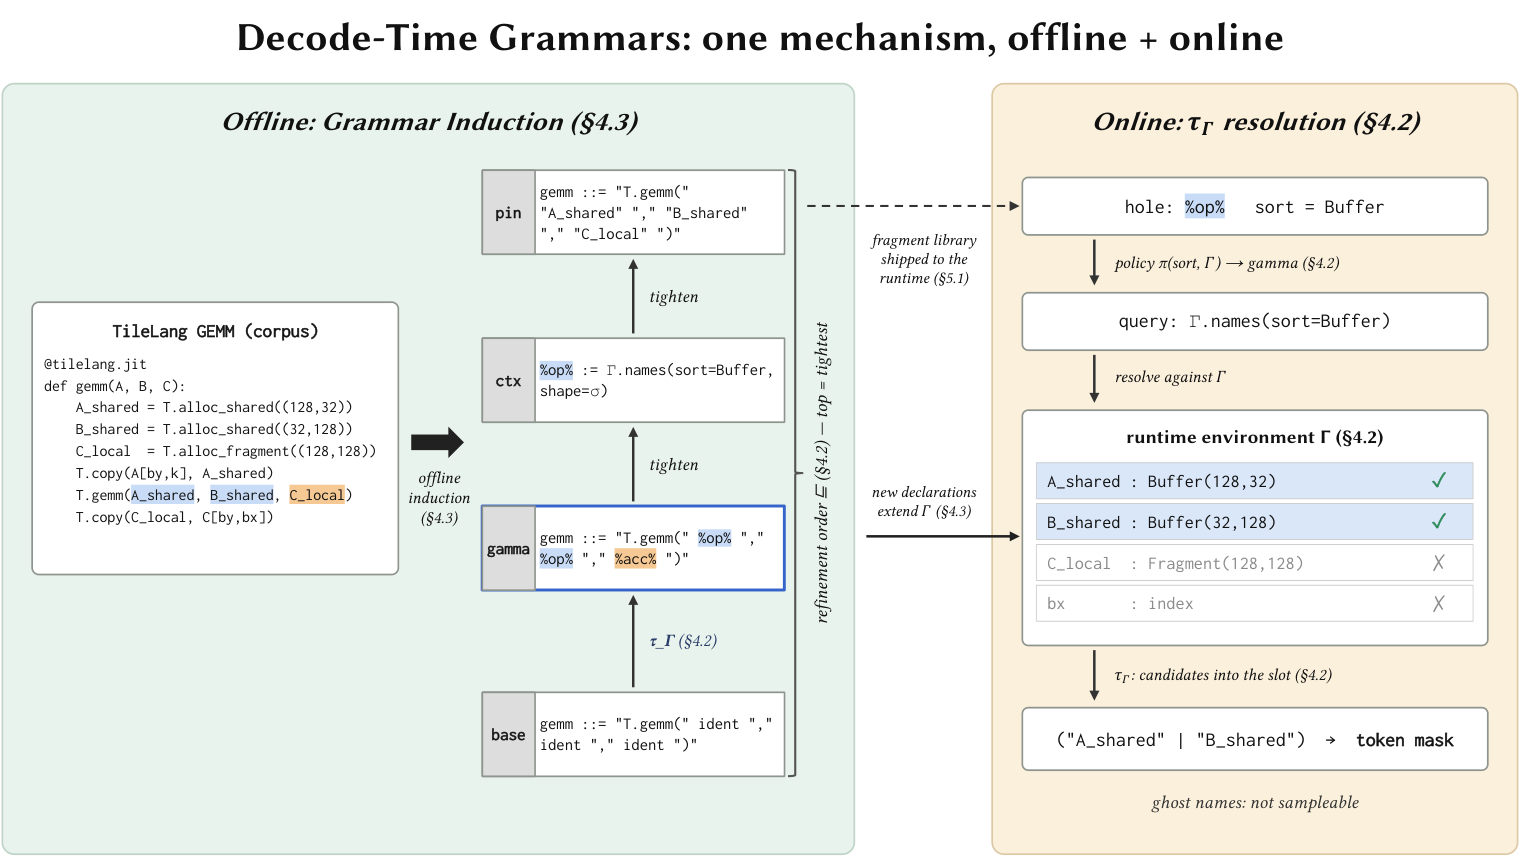
在这一体系中,程序构造被投射到一个多排序项代数(Many-Sorted Term Algebra)所定义的共享语义域 $\mathcal{S}$ 中。对于同一个计算意图(例如矩阵乘法 T.gemm 或内存搬运 T.copy),可以存在多级强度不同的语法片段,它们沿着精化序自上而下排列:
-
顶层粗粒度片段:保留极高的生成自由度,操作数位置采用开放标识符,允许模型进行不受限的代码探索;
-
环境绑定片段:引入 $\tau_\Gamma$ 算子,操作数被收缩为 $\Gamma$ 环境插槽,仅接受环境中合法声明的符号,消除幽灵引用的安全性保证在此处正式激活;
-
类型与属性精化片段:在合法符号的基础上,进一步根据张量维度(Shape)、数据类型(DType)或存储空间(Shared/Global)进行过滤匹配;
-
完全固定片段:对特定算子实施硬编码引脚,自由度降为零。
通过设计基于区域的自适应策略 $\pi(s, \Gamma)$,生成系统可以在解码的每一个空洞处选择最适配的语法层级。如果当前环境信息完备且需要高度精确的引用安全,策略就下沉到更紧密的精化层;若缺乏高阶类型约束,则回退到基础的环境绑定层,但始终守住无幽灵引用的安全底线。
这确立了一种清晰的技术分工:大模型全权负责开放式的算法选择、循环展开深度、平铺策略设计及业务逻辑意图;而解码期语法则全权承包机械式的符号表合法性与环境闭包检查。 这种分工具有能力正交性:即使更换更强大的前沿大模型,其提升的是更优的算法结构生成能力,而底层的环境安全保障无需改动,依然稳固生效。
系统实现:gproj 与离线归纳引擎
为了验证这一理论设计,作者团队开发了包含离线与在线双阶段的原型系统:
-
离线归纳器 TemplateInductor:
无需人工繁琐地手工编写各级文法,TemplateInductor 可以从目标 DSL 或特定库的小规模语料库中,自动抽取代码骨架并推导候选的语法片段阶梯。它通过静态 AST 解析识别出声明点与引用点,建立起从具体代码到语义抽象项的映射,并通过验证网关筛选出结构合法的片段集合。
-
在线掩码执行器 gproj:
在在线服务阶段,gproj 作为解码运行时介于底层推理引擎(如兼容 XGrammar 架构)与大模型之间。它实时追踪解码生成的代码文本,当遇到符号声明时,即时解析并扩充符号表 $\Gamma$;当遇到待填充的空洞时,策略模块 $\pi$ 动态获取对应的语法片段,并通过即时(JIT)编译技术将带有 $\Gamma$ 约束的文法编译为 Token 状态机,生成对应步的二进制掩码直接作用于 Logit 分布。
由于 $\Gamma$ 的变更仅发生在特定的声明边界,而大部分 token 解码依然复用高效的高性能掩码识别器,因此动态 JIT 编译并不会引发不可承受的延迟停顿。
实验评测:确定性的引用安全与可控开销
评估系统在三种极具代表性的长尾及结构化编程表面上展开:高性能算子语言 TileLang、关系型数据库查询语言 SQL(基于 Spider 复杂模式数据集)以及网络数据面语言 P4。测试覆盖的模型参数跨度极大,既包括适合本地低延迟部署的小模型(如 Qwen 系列 0.6B、1.5B),也涵盖高达 236B 参数量的前沿开源大模型。
实验首先揭示了一个清晰的“性能跃迁断崖”:在未引入 $\tau_\Gamma$ 算子的开放产生式层级下,即便是能力较强的大模型,由于邻近方言和常见模式的干扰,其生成的 TileLang 算子也频繁在 JIT 编译阶段因未声明变量而崩溃,作用域安全性得分极低;而一旦生成策略跨过精化序中的关键边、激活 $\Gamma$ 插槽约束,所有测试模型的幽灵引用发生率在所有测试集上全部归零,作用域安全率实现 100% 的确定性闭环。
在 SQL 评测场景中,模型生成查询语句时引用了非目标数据表字段是导致执行失败的核心诱因。在基线受限解码下,由于表结构名称未与动态生成绑定,模型的执行匹配率(Execution Match)停留在 76%;而启用 gproj 后,由于所有的列名与表名均被强制约束在当前连接数据库的实时 Schema 中,非法字段彻底消失,执行匹配率直接跃升至 100%。
在兼顾确定性安全的同时,gproj 的吞吐表现保持在工程可用区间。与高度优化的现代静态语法受限解码方案(如 XGrammar)相比,gproj 引入的在线状态跟踪与动态 JIT 语法编译仅导致端到端吞吐下降 10.6% 至 17.8%;相比于没有任何约束的标准自回归解码,其平均吞吐开销约为 17.3%。相比其带来的免于编译崩溃和免于重试的系统收益,这一性能折损具有极高的实用性价比。
从单纯语法约束到环境协同的范式演进
过去几年里,社区对大模型结构化输出的探索主要停留在“语法形态”的规整上——让模型别漏掉括号、让 JSON 键值对合法。然而,随着大模型深度接入编译器、数据库、操作系统终端以及自动化工作流,仅保证“语法合法”已经远远不够。代码是运行在具体环境里的,脱离环境的合法性毫无意义。
中科院计算所与利兹大学提出的这项工作表明,将运行期环境引入约束解码不仅理论完备,而且在工程实现上完全可行。通过将计算任务明确划分为“模型的创造性生成”与“系统的机械性环境闭包约束”,它为解决大模型在代码和工具调用领域的幻觉问题开辟了一条兼具形式化保证与实用性的新路径。对于未来构建高可靠的自动化编程智能体、软硬件协同代码生成流水线而言,这种在解码阶段就将环境不变量焊死在支撑集中的设计,提供了不可或缺的基础设施支撑。