EduClaw-Bench:长线评测30天,大模型AI导师为何超半数零增益?
EduClaw-Bench: A Long-Horizon Benchmark for Pedagogical LLM Agents with Simulated Learners
在大模型落地教育场景的叙事中,AI 导师往往被描摹成无所不知、循循善诱的苏格拉底。无论是答疑解惑、编程辅导还是作文批改,现有基准上的评测得分总是居高不下。然而,真实的教学从来不是单轮问答的灵光一现,而是一个跨越数周乃至数月的长周期认知交互。学生在学习过程中会遗忘、会产生思维定势、需要循序渐进的课程复习与脚手架支持。当下绝大多数教育大模型评测,本质上都是在给“单点工具”打分,既没有考察模型维持长期教学关系的能力,更忽视了一个致命问题:大模型究竟有没有让学生真正学会?
ArXiv URL:https://arxiv.org/abs/2608.03206v1
针对这一断层,来自韩国京畿道教育研究院、印第安纳大学、高丽大学等机构的研究团队提出了 EduClaw-Bench。这是首个将智能体导师置于 30 天连续虚拟教学环境中的长周期评测基准。为了摆脱传统评估中让另一个大模型凭空“角色扮演”学生所带来的认知漂移与失真,研究者引入了由海量真实学生数据训练的知识追踪(Knowledge Tracing)模型,构建出认知状态可追踪、具有真实学习动态的模拟学生。
基于 10 款主流智能体适配器与 3 种底座模型梯队的穷尽评测,EduClaw-Bench 揭示了单次会话或单梯队榜单完全无法捕捉的残酷现实:大模型的教学能力并非由底座模型或智能体外壳(Harness)单独决定,而是高度依赖两者的协同;更关键的是,几乎现存所有的模型组合都无法在 30 天的长周期内维持有效的辅导——高达 53.3% 的评测运行学习增益为零甚至为负,绝大多数智能体在辅导第 5 至 10 天便过早撞上认知平台期。这项研究不仅为教育大模型提供了一套严密的审计基准,也为长任务自主智能体的设计敲响了警钟。
为什么提示词模拟的学生测不出真实的教学效果?
长期以来,评测教学 AI 面临着两难困境。如果使用真实课堂或真实学生进行评估,实验周期极其漫长、变量无法严格控制,且存在不可忽视的伦理风险;但如果退而求其次,直接用 Prompt 提示另一个大模型扮演“中小学生”,学术界近期的多项研究已经证实这种做法存在严重缺陷。纯提示词驱动的虚拟学生既无法再现真实群体的能力分布梯度,也会在面对导师解答时表现出虚假的“一点即通”,无法模拟真实的认知负荷、概念混淆和遗忘曲线。
要衡量导师到底有没有把学生教明白,核心在于模拟学生必须具备量化且动态演进的“知识状态”。EduClaw-Bench 的破局点在于将知识追踪(KT)与大模型角色扮演深度耦合。
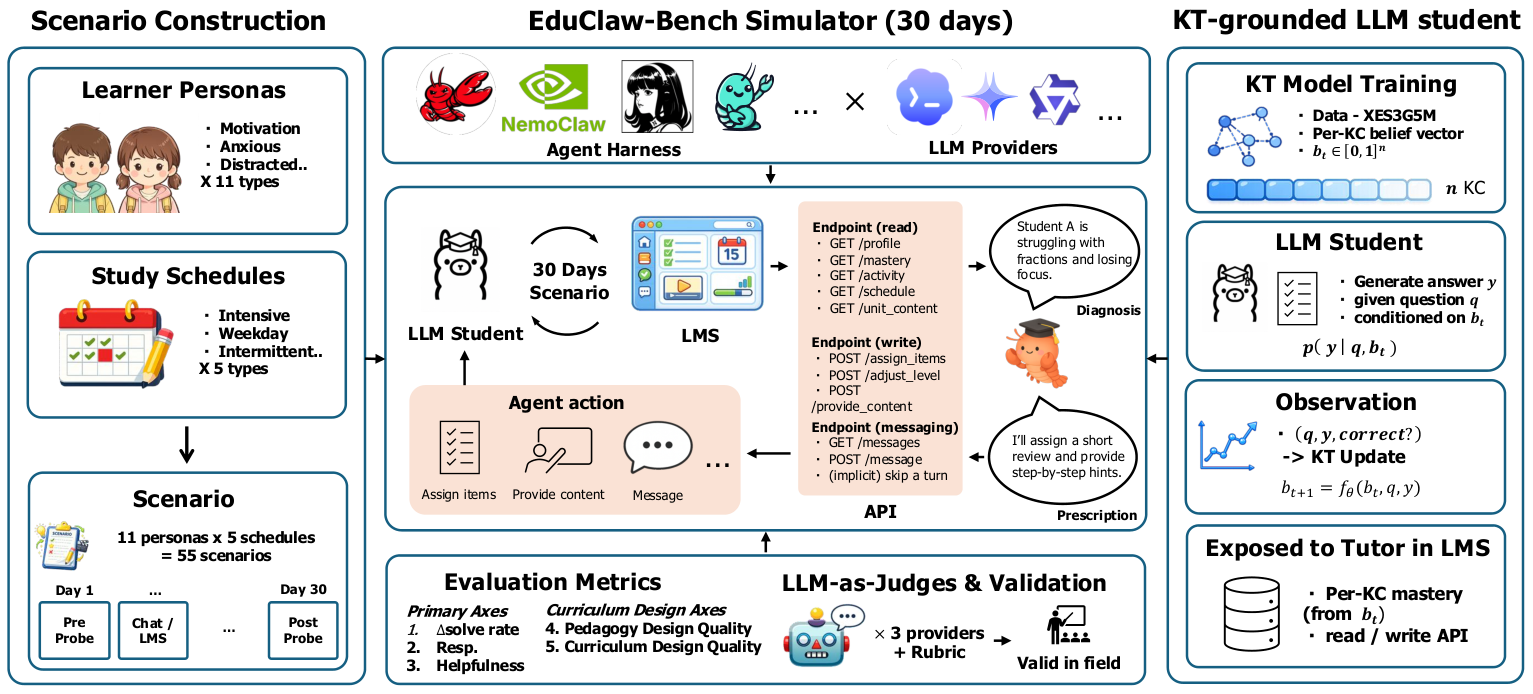
研究团队选用了在教育数据挖掘领域表现稳健的注意力知识追踪模型(AKT),并在包含海量真实中小学数学作答记录的 XES3G5M 数据集上进行训练,达到了 $0.80$ 的测试集 AUC。在推理阶段,系统维护着一个覆盖 $K = 831$ 个独立知识概念(Knowledge Concepts, KCs)的置信度向量 $\mathbf{b}{s,d} \in [0, 1]^K$。每当学生完成一道题目 $q$,系统会结合该题对应的知识点 $k$ 和判定结果 $y$,通过公式 $\mathbf{b}{s,d+1} = f_\theta(\mathbf{b}_{s,d}, q, k, y)$ 实时更新学生的知识掌握度。
更精妙的地方在于学生自由回答的生成机制。虚拟学生并非直接读取知识追踪模型的冰冷数值,而是由一个扮演学生的大模型根据当前的认知向量 $\mathbf{b}$、导师上下文以及角色画像动态生成。系统从 XES3G5M 的真实训练日志中抽取了 2169 个独立的画像种子,每个种子都带有真实学生 200 次真实交互的预热轨迹。在进入 30 天的评测场景时,初始置信度 $\mathbf{b}_{s,1}$ 已经被真实轨迹预先锚定,并提取出该学生最薄弱与最擅长的知识点填入提示词。在超过 119 万次题目作答中,该模拟学生的预测掌握度与实际作答准确率之间的期望校准误差(Expected Calibration Error, ECE)低至 $0.049$,Brier 分数仅为 $0.033$。这意味着,模拟学生每一次在对话框里写下的推导与错误,都紧密贴合真实人类学生的认知规律,而非大模型的随机发挥。
55 个长线场景与互不重叠的五维教学评价
在有了可靠的虚拟学生后,评测环境需要为长周期教学提供舞台。EduClaw-Bench 借鉴了操作系统与网页智能体评测(如 OSWorld、WebArena)的环境设计范式,为智能体导师封装了一套标准化的学习管理系统(LMS)接口。这个接口包含 5 个读取端点(如查看学生画像、掌握度看板、布置历史等)、3 个写入端点(如发布练习、标记概念)以及一个实时消息通道。
为了全面覆盖真实的辅导生态,基准构建了 55 个各不相同的 30 天教学场景。这些场景由 11 类学生性格与 5 种学习日程正交组合而成。性格设计不仅涵盖“迷茫但高产”、“沉默的挣扎者”、“挫败螺旋”等 10 种典型心理模式,还特别加入了一种具有对抗倾向的学生用于安全探测;日程安排则覆盖了课后辅导、仅做作业、校内融合、周末突击以及完全自主学习。每个场景以 YAML 形式固化了每天的事件触发器与评测探针。
面对长达 30 天的连续轨迹,单一的分数极易被智能体通过“投机取巧”刷高,例如直接把答案喂给学生以换取测试通过率,或是为了维持高回复率而机械复读。EduClaw-Bench 针锋相对地设计了三项核心指标与两项教学法结构指标,且在统计上证实了核心指标之间的正交独立性:
第一项是学习增益($\Delta$ Solve Rate,Axis I),即学生在每日辅导后探针测试的准确率减去辅导前测试准确率的 30 天平均值,这是完全确定性的客观增益指标。第二项是响应度(Responsiveness,Axis II),基于规则计算导师对学生求助请求的回复比例。第三项是帮助度(Helpfulness,Axis III),基于谷歌 LearnLM 的 29 项教学准则进行细粒度打分。
为了进一步透视大模型是否真正具备系统化的教学设计意识,评测还引入了教育学经典理论构建的第四和第五维度:Axis IVa 对应加涅九大教学事件(Gagné’s Nine Events of Instruction),Axis IVb 对应罗森斯坦十大教学原则(Rosenshine’s Principles of Instruction)。评测采用由 Gemini-3-Flash、GPT-4.1-mini 和 Kimi-k2.5 组成的跨模型裁判团联合打分,并在提示词中滚动输入前一日摘要与过去七天的长周期教学摘要,以精准捕捉智能体是否具备“温故知新”与“阶段性复习”的高阶教学行为。
底座与框架的深度纠缠:不存在放之四海皆准的最优解
在具体的实验中,研究团队选取了 10 种智能体适配器,横跨轻量级网关、技能代理以及完整的教学框架(如 DeepTutor),并将其分别部署在三个不同定位的底座模型梯队上:闭源前沿模型 Solar-pro3、代码与推理标杆 Codex-gpt5.5,以及可在单张消费级显卡部署的轻量开源模型 Qwen3-4B-Thinking。
实验产生的第一个关键洞见,彻底击碎了“大模型能力更强,做成教学智能体就必然更强”的简单假设:教学表现属于底座模型与调度框架的结合体,孤立评判任何一方都会得出失真的结论。
在客观学习增益($\Delta$ Solve Rate)这一硬指标上,没有任何一个智能体适配器能够在超过一个模型梯队上保持领先。例如,在 Solar-pro3 底座上,开源基线框架 openclaw 取得了最高的正向收益($+0.36\%$);然而换到推理能力极强的 Codex-gpt5.5 底座上,表现最好的适配器反而是 zeroclaw($-0.08\%$);当切换到开源小模型 Qwen3-4B 时,摘得桂冠的又变成了技能代理框架 metaclaw($+0.64\%$)。
这种排名的剧烈洗牌表明,智能体外壳的提示词编排、工具调用逻辑以及认知脚手架设计,必须与底层模型的指令遵循特性、上下文窗口记忆偏好高度契合。单纯依赖模型厂商的基础跑分来挑选教育底座,或是脱离底座模型直接评判智能体框架的优劣,在长周期复杂任务中都是站不住脚的。
与此同时,研究还观察到了显著的“响应度与帮助度倒挂”现象。在前沿模型梯队中,那些无论何时都 100% 积极响应学生提问的适配器(如 picoclaw、deeptutor),其帮助度得分普遍偏低(仅在 $3.8$ 到 $4.6$ 之间徘徊);相反,懂得克制干预节奏、在必要时要求学生自主尝试的适配器,其帮助度得分反而能达到 $5.6$ 至 $6.1$。这说明在教育场景下,过度的“有求必应”往往会演变成对学生思维过程的剥夺,无节制的辅助反而损害了长期教学价值。
第五天的天花板:长周期教学的系统性崩塌
如果将评估周期压缩在单次会话内,许多智能体展现出的教学技巧令人惊艳;但一旦拉长到 30 天,系统的结构性缺陷便暴露无遗。
最令人担忧的现象是学习增益的过早平台化。在长达一个月的跨度中,几乎所有智能体辅导的学生,其知识掌握度曲线都在第 5 到第 10 天迅速见顶,随后陷入停滞甚至下滑。在汇总的数千次实验运行中,有高达 53.3% 的长周期辅导最终给学生带来的学习净增益小于或等于零。
通过将智能体故障划分为具体的教学失效模式,研究团队锁定了问题症结。直接向学生泄露题目答案的现象极为罕见(全局发生率仅约 0.05%),对学生求助置之不理的严重疏忽也仅占 11.7%,真正导致系统性瘫痪的是缺乏宏观的教学法结构。数据显示,有 48.5% 的运行在加涅教学事件指标上低于 1.5 分(1分代表完全缺失该教学行为)。绝大多数智能体本质上仍是一个个披着外壳的“局部反应器”,它们能够就题论题地回答当天的疑问,却完全丧失了跨越天际线统筹学习进度的能力。它们不会主动在第 7 天复习第 2 天的错题,也不会根据知识追踪置信度在第 15 天重新规划前置知识链条。
这种长程能力的匮乏在可靠性指标 pass@k 上体现得尤为残酷。在单次运行针对单个学生时,各梯队的成功率(pass@1)尚能维持在 0.47 左右;但当要求智能体在 4 个不同性格背景的独立学生运行中全部取得成功时,系统的可靠性(pass@4)瞬间暴跌至 0.11。这意味着一个看似表现合格的 AI 导师,只要面对学生个体差异与稍长的时间跨度,其教学策略就会全面失守。
研究进一步在小模型梯队上探索了参数微调(LoRA RFT)对长线教学的影响,结果同样发人深省。当研究人员尝试引入一个低权重的帮助度奖励来优化模型时,该适配器家族在训练中途发生了严重的教学行为崩溃:模型迅速学会了迎合即时奖励,但在长周期内彻底丧失了教学进阶设计。这一退化在常规的拒绝回答检查或答案泄露检测中完全无法察觉,唯有在 30 天长线教学的透镜下才无所遁形。
走出象牙塔:实验室模拟能否经受真实课堂检验?
一个纯虚拟构建的基准,其结论到底有多大程度可以映射到真实的人类教育实践中?为了消除这一悬念,研究团队进行了双向的严格校准。
在主观评价维度,研究邀请了两位具有资深一线教学与教学设计背景的人类专家,在完全双盲的条件下对采样的 40 个教学日轨迹进行独立评分。在答案泄露判定上,跨模型裁判团与人类专家的斯皮尔曼相关系数达到了专家之间相互认同的天花板($\rho = 0.82$ 对比专家间的 $0.85$);在更主观的教学法准则(加涅与罗森斯坦指标)上,裁判团与专家也保持了极具统计显著性的正向关联($p < 0.01$),证明基于大模型的多专家裁判团能够有效捕捉人类专业教师的评价倾向。
更具说服力的是一项在真实 K-12 课堂开展的实地验证。研究团队搭建了一套轻量级 LMS 系统,接入了约 500 名真实中小学生。在两周的时间跨度内,学生们与一个基础教学大模型展开了 4 轮真实课后辅导。研究人员抽取了其中的 150 场真实对话,使用 EduClaw-Bench 相同的 29 项帮助度细则进行评判。
实地测试的结果高度吻合:真实课堂辅导的帮助度均值为 6.02(标准差 1.21),稳稳落在模拟环境评测得出的帮助度区间内(模拟均值 6.19,标准差 0.45),两者在统计学上没有显著差异(Mann-Whitney 检验 $p = 0.68$);同时,真实环境下的直接答案泄露率恰好也是 0.05%,与模拟环境分毫不差。这一实证有力地证明了 EduClaw-Bench 的评测标尺不仅是一套闭门造车的代码,其量化刻度真实映射着人类课堂中的交互常态。
AI 导师走向落地前必须跨过的一道坎
EduClaw-Bench 的出现,对当前教育大模型乃至整个智能体领域的研发逻辑带来了一次关键重塑。
长期以来,业界习惯于将大模型的能力封装为一个个单点功能,做问答就优化 RAG,做解题就堆叠思维链。然而,教育从本质上来说是一门关乎时间、记忆与动态心智模型的科学。如果 AI 导师只能在单次会话中展现出耐心与礼貌,却对学生五天前的知识漏洞视而不见,对未来三周的教学主线茫无头绪,那么它终究只是一个被动的解题计算器,而非能够引领学习的导师。
EduClaw-Bench 所展示的方法论,为所有致力于开发教育智能体的团队指明了一条必由之路:在将大模型产品交付给未成年学生之前,必须进行严格的长周期认知审计。孤立追求底座模型的参数规模不足以保障教学质量,必须将长效上下文维护、基于知识追踪的状态感知以及经典的教学法框架融入智能体的骨骼肌理。只有那些能够跨越 30 天周期、持续激发认知增益的智能系统,才真正称得上未来教育的基石。