ForestBench:告别裁判大模型,用参考森林实现多智能体毫秒级评测
ForestBench: A Unified Graph Framework for Evaluating Multi-Agent Collaboration
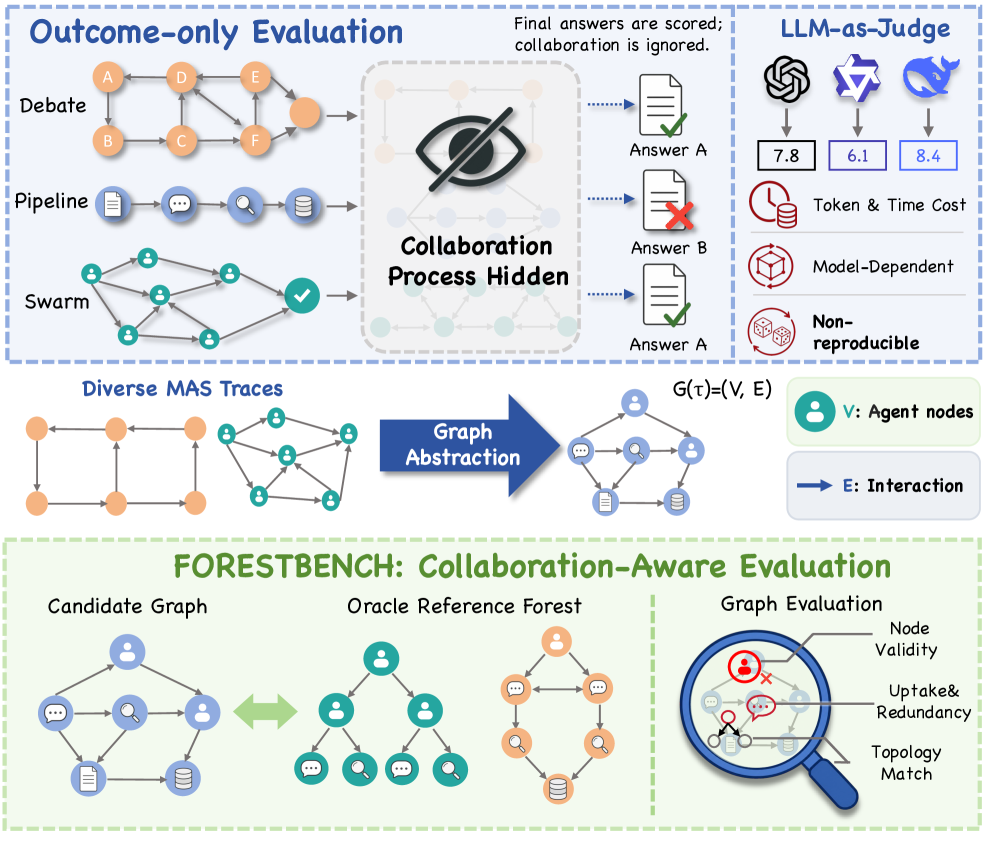
在大语言模型(LLM)驱动的多智能体系统(Multi-Agent Systems, MAS)爆发式增长的今天,各种协作范式层出不穷:从 MetaGPT 这类严格分工的软件工程流水线,到 Multi-agent Debate 这样的多轮辩论,再到 OpenAI Swarm 和 AFlow 等动态编排网络。然而,繁荣的背后隐藏着一个尴尬的行业痛点——我们缺乏一个公平、统一且低成本的评测方法来衡量“智能体之间到底协作得怎么样”。
ArXiv URL:https://arxiv.org/abs/2608.08605v2
现有的评估方法往往走向两个极端:要么只看最终答案对错(Outcome-only),把复杂的中间协作全部压缩成一个二元对错,完全抹杀了多智能体协同的价值与过程细节;要么依赖“大模型当裁判”(LLM-as-Judge),让 GPT-4 等强模型通读成千上万行的原生日志去打分。后者不仅推理开销昂贵、耗时漫长,还会因裁判模型的偏见、提示词的微调而出现打分飘移,评测结果极难复现。更麻烦的是,不同框架的日志规范、事件模式和角色命名截然不同,使得跨框架的横向公平对比寸步难行。
来自中国科学院、西南大学和腾讯的研究团队在论文中提出了全新评测基准 ForestBench。该方案跳出了大模型主观判分的窠臼,将异构的多智能体原生执行轨迹映射到统一的有向无环协作图(DAG)空间中,并提出了“参考森林”(Reference Forest)的概念。通过把待测轨迹与基准预先生成的多元成功解法森林进行拓扑比对,ForestBench 在完成基准构建后,对任意候选轨迹的打分仅需毫秒级确定性计算,实现了零额外 LLM 推理开销。
从无序日志到统一图:消解框架间的异构隔阂
要实现横向对比,首要挑战是消除框架特异性。不同 MAS 框架的代码风格和日志输出差异极大:有的记录详尽的思考与环境反馈,有的只记录消息总线广播,有的使用树状规划,有的使用事件驱动状态机。如果直接拿原始日志进行比对,无异于拿苹果比香蕉。
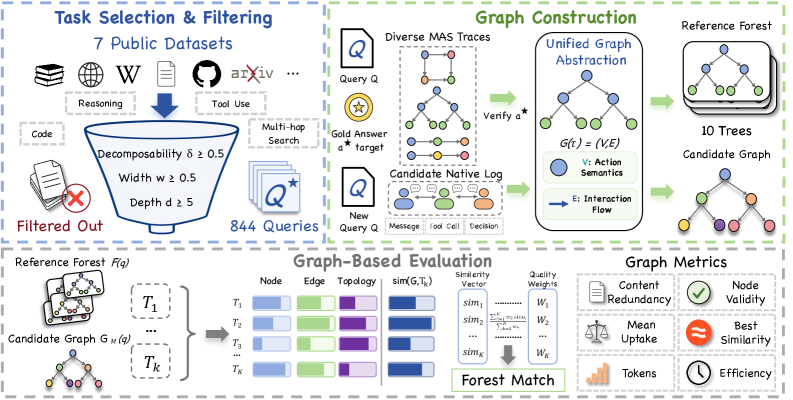
ForestBench 的解决之道是建立通用的图抽象。系统将每一次多智能体执行轨迹 $\tau$ 投影为一个有向无环协作图:
\[G(\tau)=(V,E,\phi)\]在这一抽象下,节点集合 $V$ 代表智能体执行的原子动作(涵盖 agent_message、tool_call 与 decision),每个动作都会被打上发射时间戳,并通过跨框架别名表映射到统一的角色语义词表 $\mathcal{R}$(如规划者、执行者、代码评审者等)。边集合 $E$ 则精确刻画了动作之间的依赖关系与信息流动。由于每个动作只能消费已经发射的信息,且动作严格带有时间戳,所有边都严格指向未来,从而在根本上杜绝了循环依赖,确保构图必定为有向无环图(DAG)。
这种投影是一种“蓄意的有损压缩”。它抛弃了框架内部繁杂的运行时底层状态和偶发的毫秒级物理乱序,精准保留了“谁参与了协作”、“谁消费了谁的产出”以及“信息在拓扑结构中如何流动”。如此一来,不论是 AutoGen 还是 MetaGPT,它们的原生运行记录都被拉平到了同一个数学结构空间内。
为什么不是“参考树”,而是“参考森林”?
将轨迹变成图之后,如何判定一个协作图是好是坏?过去很多评估往往假定存在一个所谓的“标准执行路径”(Gold Process)。但多智能体协作的本质魅力在于其解题路径的多样性:同一个多步骤复杂问题,既可以通过三方辩论互相纠错来解决,也可以通过“主架构师-细分专家”的串行流水线完成,亦或是依靠去中心化的 Swarm 集群动态分流搞定。如果硬性指定某种流程为唯一真理,必然会带有偏见地偏袒某种特定的组织范式。
ForestBench 由此引入了“参考森林”(Reference Forest)机制。对于每一个复杂任务查询 $q$,基准并不提供单一的黄金参考轨迹,而是构建一个由多棵“参考树”(即已验证为成功的协作图)组成的森林 $\mathcal{F}(q)$。每棵树代表一种成功抵达正确答案 $a^\star$ 的可行协作范式。
候选系统的得分不再取决于它是否复刻了某一个固定的标准答案,而是衡量其生成的协作图与这片参考森林中各种经过验证的成功范式的结构对齐程度。该设计既保留了成功协作范式在拓扑层面的多样性,又提供了一个固定、确定且可复现的对照参照系。
为了从图结构、语义流动和系统开销等多个维度立体解剖系统行为,ForestBench 建立了一套无需 LLM 介入的确定性指标面板:
-
Forest Match(FM,森林匹配度):衡量候选图 $G$ 与参考森林 $\mathcal{F}(q)$ 的加权平均结构相似度。单图相似度 $\mathrm{sim}(G, G’)$ 综合了节点角色重合度 $s_{\mathrm{node}}$、动作边重合度 $s_{\mathrm{edge}}$ 以及拓扑规模比例 $s_{\mathrm{topo}}$:
\[\mathrm{sim}(G,G^{\prime})=\alpha\,s\_{\mathrm{node}}+\beta\,s\_{\mathrm{edge}}+\gamma\,s\_{\mathrm{topo}}\] \[\mathrm{FM}(G,\mathcal{F}(q))=\frac{\sum\_{k=1}^{K(q)}w\_{k}\,\mathrm{sim}(G,G\_{k})}{\sum\_{k=1}^{K(q)}w\_{k}}\] -
Node Validity(NV,节点有效性):度量在所有非终端动作节点中,有多少节点的输出被后续节点实际消费。如果一个动作发生后从未被下游引用,说明产生了未被消费的无用行为:
\[\mathrm{NV}(G)=\frac{\lvert \{v\in V^{-}:\exists(v,u)\in E\} \rvert}{\lvert V^{-} \rvert}\] -
Information Uptake(信息吸收率):通过轻量 Embedding 计算存在依赖关系的相邻节点之间的余弦相似度,判断下游节点是否真正继承并吸收了上游节点的语义内容。
-
Content Redundancy(CR,内容冗余度):基于归一化内容哈希计算全图动作文本的重复比例,直接反映智能体之间是否存在大量无意义的复读与机械重试:
\[\mathrm{CR}(G)=1-\frac{\lvert \mathrm{unique}(\{h(x\_{v}):v\in V\}) \rvert}{\lvert V \rvert}\] -
Topology Efficiency(拓扑效率)与 Tokens:拓扑效率计算每个活跃智能体平均承载的图并行度,结合整体消耗的 Token 数量,精准度量协作在通信与算力上的性价比。
数据集构建:筛选真正需要协作的难题
多智能体评测中一个长期存在的误区在于:许多常规评测集题目过于简单,一个 Prompt 得当的单智能体(如搭载强力基座模型的单一 Agent)一轮推理就能直接做对。在这种任务上堆砌多个智能体,往往只是平白增加调用次数和 Token 浪费,根本无法激发真实的协作行为。
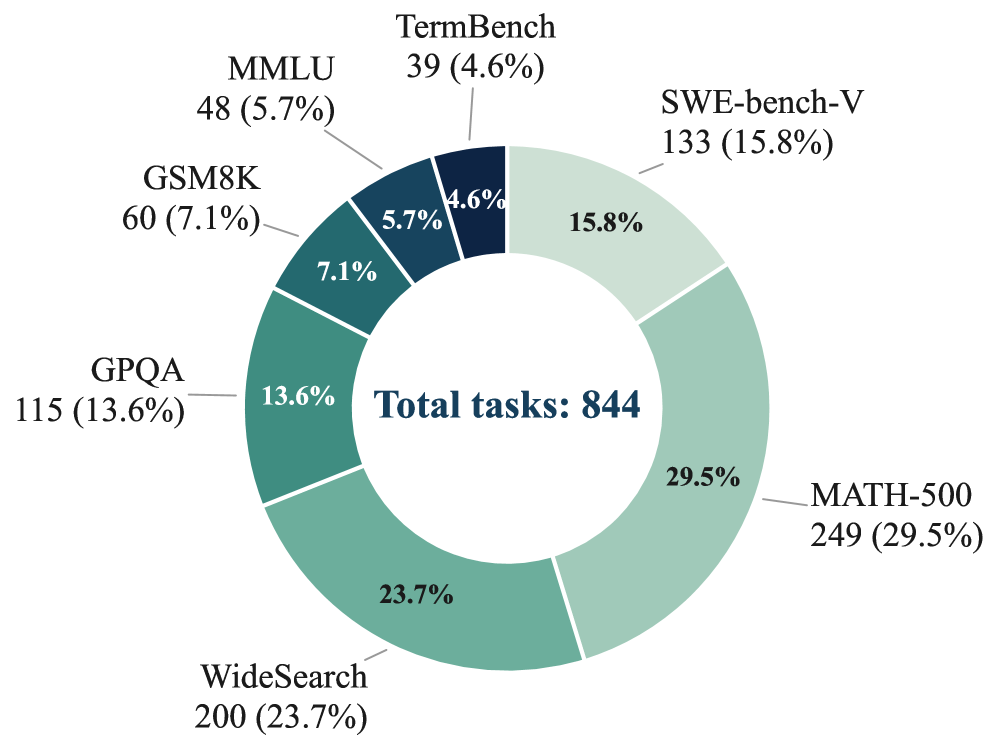
为了过滤掉这部分“伪协作”题目,ForestBench 建立了一套严苛的 Trace-Suitability Pipeline(TSP,轨迹适用性流水线)。研究团队从 WideSearch、SWE-bench-V 等涵盖多跳搜索、代码修复和复杂逻辑推理的 7 个公开数据集中收集了初始候选池 $\mathcal{Q}_0$,并设置了三个核心过滤维度:
\[d(q)\geq\theta\_{d},\quad w(q)\geq\theta\_{w},\quad\delta(q)\geq\theta\_{\delta}\]其中 $d(q)$ 约束任务求解的最少依赖步数(深度,防止过浅的直接问答),$w(q)$ 约束问题可并行的子任务分支数(宽度,确保存在并行协作空间),而 $\delta(q)$ 则是多智能体相较于单智能体强基线的性能增益(可分解性)。只有同时满足深度足够深、宽度足够广、且单智能体确实难以独立高效解决的问题,才会被保留进最终数据集 $\mathcal{Q}_\star$。
经过这套机制过滤,最终保留了 $844$ 个真正必须依靠多智能体协作的代表性查询。
针对这 $844$ 个题目,研究团队利用 Multi-agent Debate、Swarm、AutoGen、MetaGPT、MAS-GPT 和 AFlow 六种截然不同的代表性 MAS 框架,在已知正确答案的目标约束引导下充分采样,筛选出经过验证完全正确的轨迹并聚类,最终为每个查询预先计算了 $10$ 个成功的拓扑参考图(全数据集共计 $8440$ 个参考图),形成了随时可供评测对比的基准参考森林。
实验发现:终局准确率掩盖了怎样的协作真相?
在统一使用 DeepSeek-V4-Flash 作为候选系统和参考森林基座的控制实验中,研究团队横向评测了六大主流多智能体框架,共采集并分析了超过 $15000$ 条执行轨迹。
最引人深思的核心发现在于:终局任务准确率(Accuracy)极具欺骗性,几乎完全掩盖了不同框架底层协作机制的巨大鸿沟。
在基准测试中,六个框架的整体任务准确率极其接近,最低与最高之间的极差仅有 $0.038$。如果只看传统跑分,人们很容易得出“这些框架协作效能大同小异”的结论。然而,ForestBench 的图指标面板却瞬间拆解出截然不同的行为特征:
Multi-agent Debate 表现出明显的“离群”特征,其与参考森林中最佳单图的相似度(Best Similarity)仅为 $0.284$,显著低于其他框架。这说明辩论机制虽然能把最终答案磨练正确,并且内容冗余较低、拓扑效率极高,但其依靠交锋质疑的拓扑模式,与工程落地中主流的分解-执行流程在结构上有极大偏离。
与之相对的是 AFlow,其内容冗余度(CR)高达 $0.167$,几乎是其他所有对比框架的近三倍。这意味着 AFlow 依靠其动态并行搜索机制虽然捞到了正确的解答,但代价是在并行分支中产生了海量重复生成和无效重试,计算资源浪费严重。
OpenAI Swarm 则暴露出独特的协调缺陷,它是唯一一个节点有效性(NV)低于 1 的框架(降至 $0.968$)。在严密的图依赖分析下,这清晰表明 Swarm 中部分由智能体调用工具或发出的消息,在后续流程中被下游完全丢弃或无视,产生了事实上的“无效动作”。
这些深藏在执行轨迹中的病态行为和架构权衡,绝非一个单纯的 Accuracy 能够揭示。
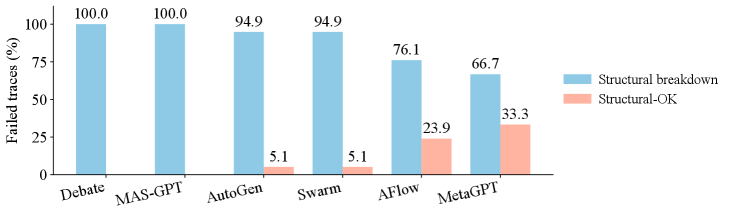
解剖多智能体崩溃:是结构走样,还是内容幻觉?
当一个多智能体系统在复杂任务上失败时,开发者往往无从下手:到底是因为系统角色安排错了、拓扑流程崩了,还是智能体本身在具体某一步推理时产生了幻觉?
ForestBench 提供了一种解耦问题根因的诊断视角。研究团队在准确率与 Forest Match 构成的象限中抽样了 $300$ 条失败轨迹,对其展开深层解剖:
-
结构性失败(Structural Mismatch):表现为 Forest Match 指标极低。这通常意味着智能体系统在最开始的宏观任务分解、角色调度或上下游信息分发上就走偏了。例如串行链路中断、关键审查角色缺失,或者错误地将复杂流程压缩为草率的单步输出。针对这类失败,单纯增强基座模型的上下文长度或推理能力无济于事,必须重构编排流图或角色 Prompt。
-
内容性失败(Content-level Error):表现为拥有很高的 Forest Match,但终局准确率依然为 0。这意味着智能体系统的分工机制非常健全,各个角色完美就位,消息传递链路与成功的范式完全一致,然而在某一个具体节点的执行中,模型做出了错误的计算或产生了事实幻觉,并将错误顺着拓扑向下传递。对于这种失败,优化的重点应当是节点的具体 Prompt、少样本示例注入或调用工具的准确率。
这种分层诊断能力,让 MAS 开发者第一次拥有了类似“软件性能 Profiler”一样的透视工具,能够针对性地进行系统修补。
毫秒级评测:将评估推理成本彻底归零
在多智能体系统评测中,大家苦“LLM-as-Judge”久矣。使用强模型对长篇累牍的多智能体交互日志进行分析判分,不仅每次跑基准都要耗费巨额的 API 账单,而且受限于大模型的生成速度,评测几百条轨迹往往需要数小时甚至几天。
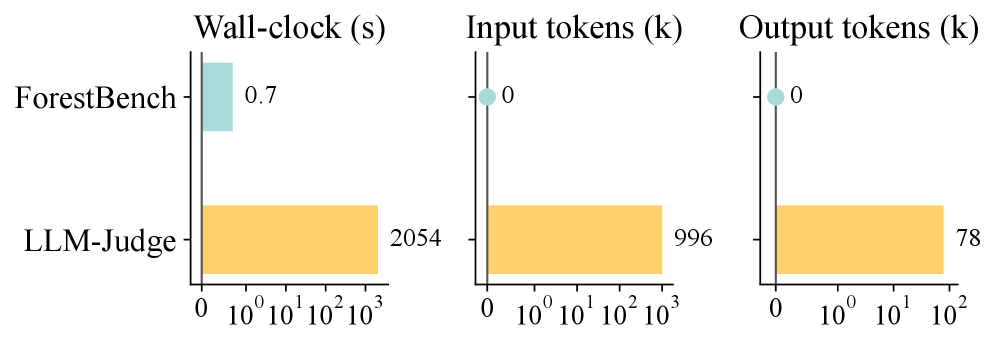
ForestBench 彻底颠覆了评测的成本结构。构建包含 $8440$ 个成功图的参考森林确实是一次性工作,耗费了约 $20.5\text{M}$ Tokens;但一旦这套参考森林作为基准资产固化发布后,其边际评估成本直接降为零。
在后续对任意新提出的多智能体框架进行评估时,评测程序仅需运行解析适配器将日志转为 DAG 图,然后通过纯数学和图算法计算 Jaccard 相似度、图编辑比例和哈希碰撞。每一条复杂执行轨迹的打分耗时缩短至毫秒级,且完全不需要发起任何一次 LLM 推理请求。无论开发者在本地调整提示词、更换微调模型还是重构路由逻辑,都可以在几秒钟内跑完整个基准集的协作结构评估。
开启多智能体拓扑演进的新范式
从结果导向的粗暴打分,到主观易变的裁判模型,再到如今规范化、确定性的图结构匹配,ForestBench 为多智能体系统的健康发展填补了一块关键的拼图。
它明确告诉我们:协作并非抽象的玄学概念,而是一种客观存在、可被数学形式化表征的拓扑与信息流动。当我们将目光从孤立的 Prompt 调优转向多智能体拓扑工程时,拥有一个客观、快速且能提供结构归因反馈的评测尺码,将成为从“智能体玩具”走向“高可靠企业级工作流”的必由之路。随着该基准及其参考森林的开源,未来的多智能体算法迭代将不再盲目,一个用拓扑度量协作效能的新阶段正在到来。