Full-bandwidth Transformer:打通隐状态,近零开销追平1.5倍数据
Full-bandwidth transformer
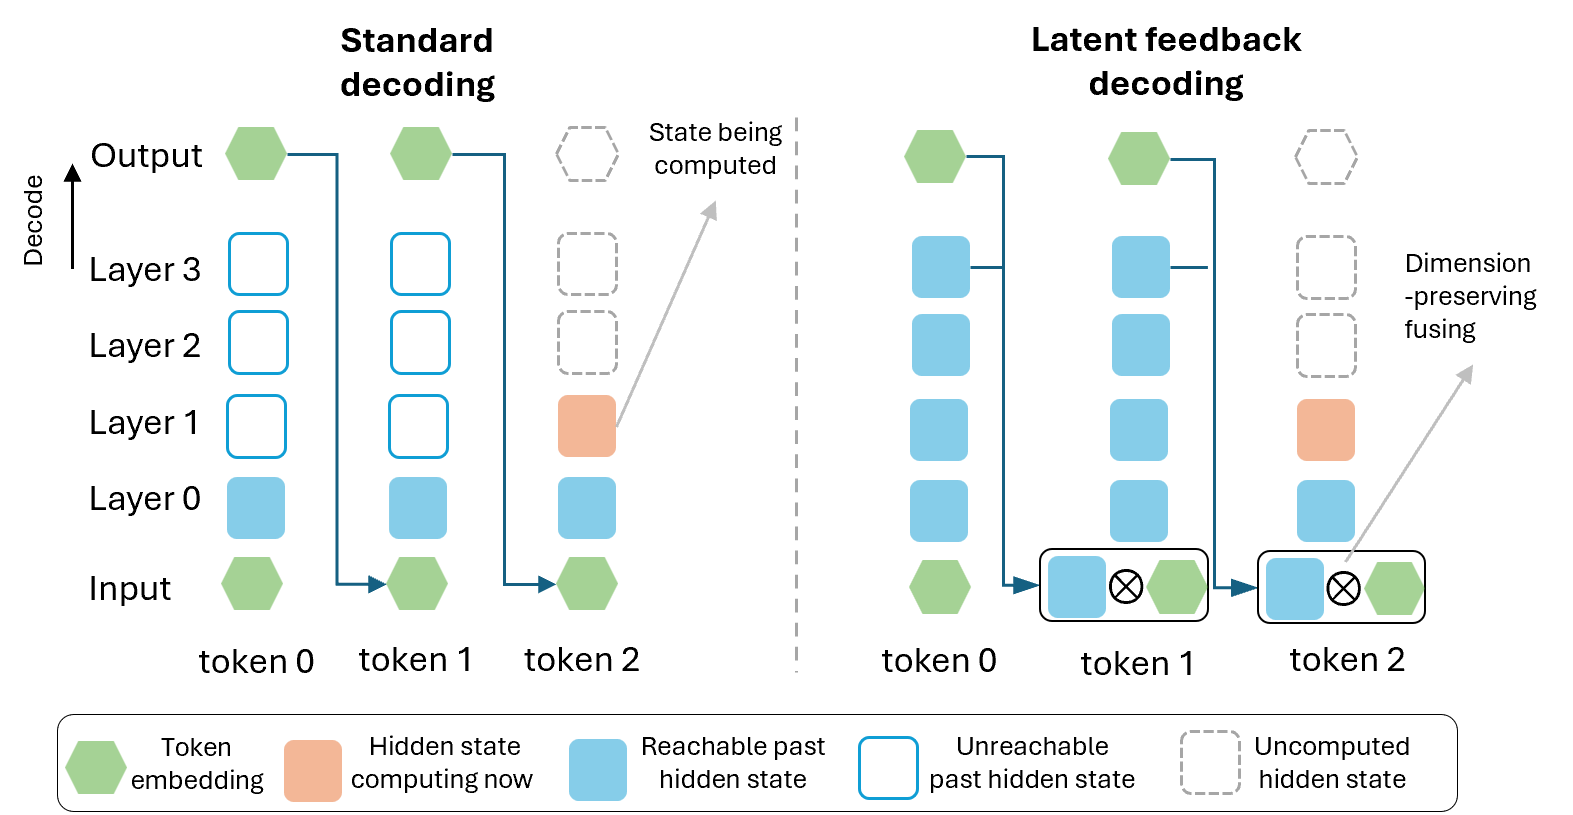
在过去几年大模型的发展历程中,自回归 Transformer(Autoregressive Transformer)几乎垄断了所有语言建模架构。然而,如果仔细审视自回归生成的信息流,会发现一个长期被大家习以为常、却极为别扭的“带宽不对称”现象:在水平时间轴上,模型通过密集的注意力机制(Dense Attention)和庞大的 KV Cache,可以自由调取过去数千甚至数万个 Token 的所有历史表征,水平信道近乎无限宽阔;但在垂直的计算深度上,前一步生成的全部计算结果,在迈入下一步时却被强行压缩成了一个孤零零的 Token ID。
ArXiv URL:https://arxiv.org/abs/2608.08888v1
换句话说,模型在顶层耗费数千亿次浮点运算提炼出的高维向量(Hidden State),在采样结束的一瞬间就被彻底丢弃了。进入下一个时间步时,底层的输入仅仅是这个离散 Token 的基础词嵌入(Embedding)。
来自约翰斯·霍普金斯大学、微软研究院(Microsoft AI Frontiers)与普林斯顿大学的研究团队,在最新论文中直击这一结构性缺陷,提出了 Full-bandwidth Transformer。该架构引入了一种名为隐状态反馈(Latent Feedback)的机制,把上一时间步模型顶层的隐状态与当前采样出的 Token 嵌入融合,重新送回模型底层。
这一改进打破了长久以来的垂直信息瓶颈:模型不再被迫把所有中间思考、不确定性和潜在推导“硬挤”进离散 Token 里,也无需在每个新位置从零开始重建高层语义。实验表明,在几乎不改变原生模型架构、完全保留 KV Cache、且解码计算开销增加不足 1% 的前提下,1B 参数量的 Full-bandwidth Transformer 在多项常识推理、数学与代码任务中,均能够追平甚至超越消耗 1.5 倍至 2 倍预训练数据量的标准 Transformer 基线,并且在推理时展现出“思考更短、答案更准”的高效表达能力。
自回归模型的“窄信道”困境
要理解这项工作的巧妙之处,必须先回到标准 Transformer 的计算拓扑结构中。
语言模型本质上在二维网格中展开计算:水平方向是时间序列(Sequence Tokens),垂直方向是网络层深(Layers)。当我们讨论思维链(Chain of Thought, CoT)为什么能提升模型的推理能力时,核心逻辑通常被解释为“测试时计算扩展(Test-time Compute)”——通过生成更多的中间 Token,模型把串行计算的深度沿着时间轴展开,使得可用计算图的深度与生成的 Token 数量成正比。
但这种深度的延伸代价极其昂贵。因为步与步之间唯一的通信中介,是一个取值范围仅为词表大小 $\lvert V \rvert$ 的离散符号,其信息承载量最高不过 $\log_2 \lvert V \rvert$ 个比特。一个维度为 $D$(通常为数千维)的连续向量,被硬生生压成了离散标量。
这导致了两个严重的计算局限:
第一是深度的冻结(Depth-frozen)。在标准解码过程中,历史 Token 在第 $\ell$ 层产生的中间激活值会保存在 KV Cache 中,但该缓存只能被后续时间步中大于或等于 $\ell$ 的更高层读取,永远无法倒流回底层。最致命的是,代表了全模型最深、最抽象语义的顶层输出,在预测出当前 Token 后直接随风而去,连进入 KV Cache 的资格都没有。
第二是强迫性的离散外化(Forced Verbalization)。因为高维状态无法在步间传递,模型若想维持某个复杂的不确定性状态、推演计划或半成品结论,就必须在文本中把它们字面化地“写出来”;或者,它就只能在下一个时间步依靠浅层网络去重新猜、重新算。模型在生成文本时耗费的大量冗长废话,本质上可能只是它为了跨时间步传递微小信息而不得不付出的“通信税”。
门控隐状态反馈:把宽通道做成“强制通路”
Full-bandwidth Transformer 的核心思路,就是把这个被人为截断的垂直信道重新接通。
在每一步解码时,系统不再仅仅把采样出的 Token 嵌入向量 $\mathbf{e}t$ 喂给网络底层,而是将上一时间步顶层输出的隐状态 $\mathbf{h}{t-1}^L$ 与 $\mathbf{e}_t$ 进行特征融合,将融合后的混合向量送入第 1 层:
\[\mathbf{e}_t \otimes \mathbf{h}_{t-1} = \mathbf{W}^U \mathbf{h}_{t-1} \odot \sigma(\mathbf{W}^G \mathbf{e}_t)\]这里的计算设计非常值得玩味。作者并没有采用直觉上更常见的简单相加(如 $\mathbf{e}t + \mathbf{W}\mathbf{h}{t-1}$)或拼接降维,而是构造了一个非对称门控线性单元(GLU)。
在这一公式中,高维连续隐状态 $\mathbf{h}_{t-1}$ 占据了主值通道(Value Pathway),而离散的 Token 嵌入 $\mathbf{e}_t$ 则经由投影与 Sigmoid 激活函数 $\sigma(\cdot)$,退化充当乘法门控(Gating Pathway)。
这种非对称设计的背后,隐藏着深刻的训练动力学考量。在实际工程落地中,我们往往希望在已有标准预训练模型的基础上快速做适应性训练。如果采用加法融合,模型很容易学会在残差流中将高维隐状态的权重直接置零,从而“走捷径”退化回标准的无反馈模式,以此直接复现原始预训练阶段的低损失。
而在乘法门控下,模型如果强行忽略上一层的隐状态 $\mathbf{h}_{t-1}$,就会导致整个输入流被直接清零,连当前的 Token 身份也会随之泯灭。这种“置之死地而后生”的结构设计彻底封死了模型退回标准自回归的逃避路径,强迫网络底层必须学会认真阅读上一步沉淀下来的顶层高维信息。
更关键的是,这种修改对推理系统极端友好。由于融合操作保留了向量维度 $D$,且仅涉及两个 $D \times D$ 的矩阵乘法,相比整个 Transformer 堆栈几十层的前向计算,它的计算占比甚至不足 1%。底层的自注意力机制、MLP 块、KV Cache 缓存布局不需要任何魔改,现有的 vLLM 等高效推理框架可以通过复用多 Token 预测(Multi-token Prediction)的缓冲区机制,仅用两行代码的调整就能无缝兼容。
如何在并行训练中解开时间依赖?
尽管推理阶段极其顺滑,但将隐状态反馈引入语言模型,最棘手的难题其实出在预训练阶段。
标准 Transformer 之所以能在大规模数据上高效训练,全靠教师强制(Teacher Forcing)带来的“全序列时间并行”。每个位置的输入仅取决于真实的真实文本 Token,因此整个长度为 $T$ 的序列可以一次性通过前向传播完成计算。但一旦允许第 $t$ 步的底层输入依赖于第 $t-1$ 步的顶层输出,网络内部就形成了一个真正的跨时间步循环连接(Recurrence)。如果直接按照循环神经网络(RNN)的方式去逐步反传,自回归训练的大规模并行优势将荡然无存。
为了在保留全序列并行的同时训练这个反馈回路,作者提出了一套基于时间并行(Temporal Parallelism)的渐进式多遍次(Multi-pass)训练范式。
其核心逻辑借用了数值计算中的雅可比(Jacobi)迭代思想:
在第 1 遍前向传播中,按照标准 Transformer 处理,输入全为离散 Token,模型在所有位置并行产出一组顶层隐状态 $\mathbf{h}^{(1)}$;
在第 2 遍前向传播中,将 $\mathbf{h}^{(1)}$ 整体向右平移一个位置(对应因果时序),与真实 Token 嵌入进行非对称门控融合,再并行送入网络,产生更新后的隐状态 $\mathbf{h}^{(2)}$;
依此类推,进行第 $k$ 遍计算。
在这一机制下,每一次额外的全局前向 Pass,都相当于让隐状态在时间轴上向前推进了一步反馈距离。如果模型进行了 $k$ 遍计算,就意味着顶层状态的信息能够跨越时间步,影响到后续 $k-1$ 个位置的底层输入。原本需要在整个序列长度 $T$ 上串行展开的循环图,被压缩成了 $k$ 次并行的全序列前向计算。虽然单批次的计算量变成了标准的 $k$ 倍,但在工程上依然完全保持着现代 GPU 集群最擅长的矩阵并行吞吐。
然而,训练不可能无限制地堆叠 Pass。如果训练阶段只跑了 2 遍或 3 遍,而在实际部署生成一个数百 Token 的回答时,隐状态反馈会被循环迭代几百甚至上千次。这种“只见过短程展开、却要在长程中自闭环迭代”的分布偏移,会不会导致整个动力学系统崩溃发散?
3%的魔法:从发散震荡到不动点收缩
研究团队在消融实验中发现了一个极其惊人、又具有深刻数学美感的动力学现象。
在最初的设定中,作者尝试采用混合训练方案:75% 的训练批次采用常规单遍(Single-pass),25% 的训练批次采用双遍(Two-pass)。在训练步数对应的局部深度内,这个模型表现优异;但当他们在评估阶段将反馈环路推向更深层时,灾难发生了:模型在推演超过训练步数后,验证集损失剧烈飙升,连续两遍隐状态之间的差值范数 $|\mathbf{h}^{(k)}-\mathbf{h}^{(k-1)}|$ 开始剧烈震荡。这表明反馈映射本身是不稳定的,迭代迅速脱离了模型所能理解的状态流形。
为了压制这种发散,作者做了一个极为轻量的尝试:在保持 75% 单遍批次不变的前提下,仅仅把双遍批次从 25% 微调为 22%,并将剩余的 3% 批次分配给三遍(Three-pass)计算。
就这微不足道的 3% 数据混合,彻底扭转了整个系统的动力学性质。
引入极少量的深度反馈后,模型学到的反馈变换矩阵从“向外扩散”转变成了数学意义上的收缩映射(Contraction Mapping)。随着反馈遍数的持续增加,状态的变化量不再发散震荡,而是迅速衰减并收敛至一个极其稳定的小平台。在后续测试中,即便将反馈展开强制推演到多达 30 步、甚至极端外推至 1000 步时,模型的验证损失依然保持平缓,毫无崩塌迹象。这一发现至关重要,它证明了隐状态反馈并不需要昂贵的全程深度反传,通过在预训练后期以极低比例混入高阶前向更新,就足以驯服这个长程非线性动力系统。
为了进一步抹平推理与训练的分布差异,团队还配套设计了前缀混淆(Prefix Mixin)策略。在真实场景中,Prompt 部分通常是预先存在的离散文本,而随后的回答部分才具有连续反馈。通过在多遍训练中有策略地随机截断序列,强制将前 $p$ 个位置保持为普通 Token 嵌入,只对后缀位置进行门控融合,模型得以原生适应从“无反馈 Prompt”到“有反馈 Generation”的平滑过渡。
实验印证:1B模型越级对标的底气
基于这一套严密的方法论,研究人员使用与 Phi-4 相同的优质数据集,从零预训练了 1B 参数规模的 Full-bandwidth Transformer,并与消耗同等或数倍计算资源的基线进行了全方位对比。
在涵盖多项常识问答与推理任务的标准评测集上,Full-bandwidth Transformer 展现出极高的数据转换效率。利用带有反馈机制的预填充(Fused Prefill),该模型在无须生成文本的选择题评测与验证集困惑度上,直接抹平了与花费 2 倍 Token 训练的标准模型之间的鸿沟。这意味着,传统自回归模型必须依赖吞入海量语料才能间接凝练出的深层特征关联,现在直接通过架构内部开放的垂直信道被更高效地消化了。
在开放式生成任务(如数学推理 GSM8K、Math500,以及代码生成 HumanEval、MBPP)上,隐状态反馈的威力展现得更为直观。评测对比了三种模式:完全不加反馈的标准解码(Standard)、仅在生成阶段开启隐状态反馈的软解码(Soft),以及在 Prompt 阶段增加一次反馈计算的融合解码(Fused)。
结果显示,在完全相同的网络权重下,仅仅通过切换解码机制开启隐状态反馈(Soft 模式),数学推理性能便迎来了极其显著的阶跃;而在代码类任务中,在预填充阶段多跑一次融合计算(Fused 模式)则带来了最大涨幅。在某些特定子项中,仅消耗约 400B Token 训练的 1B 模型,甚至逼近了耗费高达 1T Token(2.5倍以上数据量)训练的标准基线。更具实用价值的是,这一优势在经历长上下文扩展(Long-context Extension)和后续的指令微调(Instruction Tuning)后依然被完整保留,证明了它不是某种脆弱的预训练巧合,而是稳固的基础表征增强。
“想明白再写”:隐状态如何精简思维链
除了基准数字的全面上涨,实验中还观察到一个极具启发性的现象:开启隐状态反馈后,模型在推理任务中生成的回答长度显著缩短了。
在传统大模型的 CoT 过程中,我们常常能看到模型为了维持一个中间推演,不得不写下一长串用于自我提示的过渡短语(例如“让我想想……”“因为前一步得到了X,所以接下来……”)。这种现象曾被许多研究者视为模型具备“思考过程”的象征,但在底层机制上,它其实暴露了模型的无奈——既然顶层向量在下一步就灰飞烟灭,它只能借由生成显式 Token 的方式,把思考成果重新打印在屏幕上,以便下一步底层重新读回。
Full-bandwidth Transformer 改变了这一游戏规则。高维的连续隐状态现在可以直接伴随着每一步生成,像一个隐形暂存区(Scratchpad)一样,在底层与顶层之间循环流转。模型获得了“一边在连续空间里深化未定结论,一边在离散空间里输出关键答案”的双通道工作能力。
分析深层残差流的探测实验也进一步印证了这一点:在 Full-bandwidth 架构中,甚至在网络最底部的浅层残差中,就已经能够探测到与最终答案高度相关的丰富语义信息。模型不再需要把全部计算压力堆叠到高层,也不再需要用冗长的时间步去换取计算深度。这种“更短的思考链条,换来更高或持平的准确度”的表现,恰恰从正面证明了计算范式的改变——非离散的思考过程真正留在了潜在空间,只有最终的结论才被呈现在词表上。
架构演进的启示
Full-bandwidth Transformer 带来的启示,超越了单一架构改动本身。
长久以来,Scaling Law 的叙事轴心高度倾斜于“堆参数、堆语料、拉长文本”。然而,当数据质量与工程吞吐逐渐触及物理边际,人们开始反思自回归架构内部那些“为了并行而妥协”的历史包袱。Transformer 在水平注意力上的奢侈,与它在垂直跨步通信上的吝啬,形成了极其尖锐的矛盾。
这项研究证明了一件事:自回归解码本就是天然串行的,在这个串行的过程中,刻意维持网络层级之间的单向信息隔离,不仅毫无推理加速的收益,反而白白倒掉了每一轮前向计算中最宝贵的高层状态资产。
通过极低成本的非对称门控,把丢弃的隐状态捞回输入端;配合极具巧思的 3% 深度训练调度,将复杂的反馈系统稳定为收缩映射——Full-bandwidth Transformer 以极小的工程改动,在不破坏现有生态框架的前提下,完成了对经典解码流的一次优雅修正。当大模型从“被迫自言自语”走向真正的“隐空间深思”,模型在参数与数据之外的第三条效率增长曲线,或许才刚刚展开。