Code2Skill:从2万开源仓库提炼百万执行级技能,Agent表现提升11.7%
Grounded Skill Synthesis from Code at Scale for Agentic Intelligence
让大语言模型(LLM)驱动的智能体(Agent)具备跨任务迁移的“技能”(Skills),一直是迈向通用智能的核心瓶颈。在现有的技术路线中,构建 Agent 技能库主要存在两个互为掣肘的极端:一种是依赖环境轨迹(Trajectory-based),即让智能体在特定沙盒环境中跌跌撞撞地试错,将成功或失败的交互记录蒸馏为经验;另一种是依赖静态文档(Document-based),从开发文档或自然语言指南中总结操作流程。然而,前者高度受限于特定环境、工具接口以及智能体本身薄弱的探索能力,甚至随着模型迭代极易失效;后者虽易于大规模收集,却缺乏底层的可执行凭证,经常产生无法落地的“空中楼阁”。
ArXiv URL:https://arxiv.org/abs/2609.05571
蚂蚁国际(Ant International)团队在最新研究中提出了全新的破局思路:将真实世界中庞大且经过人类反复调试的源代码作为程序性知识(Procedural Knowledge)的终极载体。源代码天生具备可执行、易验证、自带版本控制且涵盖复杂边界处理的特性。研究团队推出了名为 Code2Skill 的全自动技能提炼框架,并基于 19,769 个高星活跃 GitHub 仓库,成功构建出包含 1,006,822 条经过严格一致性验证的技能库——CodeSkillBank。
在跨越 9 种主流模型设置和 8 大权威评测基准(涵盖软件工程、终端控制及前沿数学科学推理)的 72 组配对测试中,接入 CodeSkillBank 的智能体平均性能相对基线提升达 11.7%,在 57 组测试中显著超越对照组。更值得注意的是,在统一的下游执行接口下,该方案在全部 7 个共享基准上正面击败了包括 Trace2Skill、ExpeL 在内的基于探索轨迹的传统技能库。这项工作不仅打破了“技能必须依靠智能体自身盲目试错才能获得”的固有范式,还证明了 AI 生成的代码同样能以高达 93.5% 的合成通过率持续喂养技能库,为智能体系统的扩展开辟了全新的数据尺度。
为什么代码才是程序性知识的天然土壤?
在经典的智能体构架中,技能(Skill)本质上是程序性知识与触发条件的封装体。它告诉 Agent 在特定状态或目标下应该采取何种执行策略、遵循哪些不变式(Invariants),以及如何规避边缘错误。此前学界普遍热衷于基于交互轨迹自学习,但这种模式存在显著的“冷启动”上限:一个尚未具备熟练操作能力的 Agent,很难在长程复杂环境中探索出高难度任务的黄金轨迹。
软件代码库则截然相反。开源社区数十年积累的代码资产,本质上是人类程序员将业务逻辑、状态流转、约束校验与容错机制高度抽象后的实体结晶。这里不仅有完整的执行路径,还有处理边缘情况的断言与分支。然而,把代码直接喂给 Agent 作为 Prompt 并不现实,因为工业级代码往往充斥着项目特定的局部变量、胶水代码和繁琐的框架依赖。
这就引出了 Code2Skill 的核心问题定义:如何在彻底剥离项目特异性细节、提升泛化抽象能力的同时,依然保留源自底层实现的可执行证据?
针对这一要求,Code2Skill 确立了合格技能记录的三大刚性准则:首先是落地性(Grounded),技能中陈述的每一步逻辑和规则,必须能追溯到底层真实的代码片段;其次是可迁移性(Transferable),必须剔除特定命名和局部依赖,提炼出可复用的前置条件、状态变迁逻辑与“反目标(Anti-goals)”;最后是可维护性(Maintainable),保留完整的出处(Provenance)元数据,确保随着底层仓库代码的更新,上层技能能够被审查、失效标记或自动重构。
四阶流水线:从原始仓库到百万级结构化技能
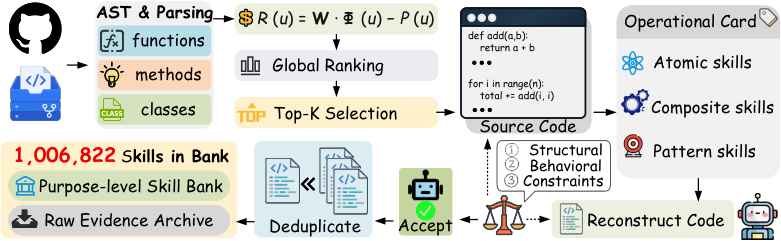
为了将海量非结构化的代码库自动提炼为高质量技能,Code2Skill 建立了一套严密的多阶段流水线,涵盖了从筛选、抽象抽取,到“盲体重构校验”和检索视图构建的完整闭环。
1. 候选程序性证据的严格初筛
流水线首先从 GitHub 抓取了 19,769 个 Stars 超过 500 的长期维护活跃项目。Code2Skill 解析出函数、方法、CLI 入口点以及文件级组件。为了防止将无关紧要的工具函数或纯配置片段误收录,系统引入基于 LLM 的意图标注器,专门识别具备明确操作意图、包含完整流程结构且执行约束清晰的高价值单元,剔除缺乏可复用价值的死代码。
2. 三种粒度的结构化提炼
不同复杂度的程序性知识不能混为一谈。如果用单一粒度抽取,要么会导致复杂的多步协作逻辑被割裂,要么会导致简单操作被过度泛化。Code2Skill 创新性地将技能划分为三个层级:
-
原子操作(Atomic-operation):聚焦于单一函数或方法内部高度凝练的操作,如特定的状态校验或数据转换;
-
复合工作流(Composite-workflow):捕捉协调多个操作的有序流程,记录步骤间的依赖与控制分支;
-
重现模式(Recurring-pattern):提炼超出单一局部实现的更高维度设计范式与状态机流转。
每条提炼出的技能记录不仅包含自然语言描述,还显式记录了适用场景、执行步骤、核心不变式、典型失败情况、不可逾越的“反目标”以及支撑该结论的源代码跨度。
3. 创新机制:代码盲体重构与一致性判决
这是 Code2Skill 确保技能质量最为关键的一环。以往的文本摘要往往“报喜不报忧”,容易出现抽取时丢失关键条件或产生幻觉。为了彻底暴露出技能描述是否遗漏关键细节,Code2Skill 设计了源盲体重构机制(Source-body-blind Reconstruction)。
具体而言,系统让一个独立的 LLM 充当重构者,只允许查看生成的技能卡片,完全遮蔽原始源代码的实现体,要求其仅凭技能描述反向写出代码。随后,一个能够同时看到原始代码和重构代码的“评判者(Judge)”对二者进行细致比对。如果重构出的代码能高度还原原代码的步骤、逻辑不变式与错误分支,说明该技能卡片扎实可信,予以直接采纳;如果存在分歧,则提交裁决模块区分究竟是重构模型的代码生成缺陷,还是技能记录本身存在事实缺漏。只有通过这道“闭卷考试”的技能,才能进入最终的技能库,并附带完整的重构过程与判定理由。
4. 检索优化与意图索引
为了适配下游 Agent 的高并发、低延迟调用,通过验证的技能被进一步提炼出特征标签,并进行确定性意图聚类(Purpose Indexing)。系统会过滤掉重复候选,为每个相似意图簇选出最具代表性的标准卡片,同时完整保留底层的证据归档,以供随时追溯审计。
百万技能的真实质量如何?
经过上述管线的全自动化清洗与提炼,研究团队最终构建出了规模达 1,006,822 条有效记录的 CodeSkillBank。从分布特征来看,这些技能高度集中在数据变换、系统状态更新、复杂输入解析、参数校验、状态机流转控制以及第三方 API 的标准交互上,绝大多数记录都涉及多步操作和严谨的约束推理。
人工抽样评测(覆盖直接采纳、裁决采纳、价值过滤剔除、终审拒绝四种状态)展现出令人信服的对比数据:
-
在 CodeSkillBank 最终保留的直接采纳记录中,人类专家判定技能描述准确率高达 92%,80% 的记录具有极高的留存复用价值,且 84% 的技能卡片能成功支撑无盲区的代码逆向重构;
-
形成鲜明反差的是,被流水线拒绝的候选样本中,描述准确率仅有 32%,留存价值仅为 28%,且完全无法成功支持反向代码重构。
这一断崖式差距表明,代码盲体重构与双重视角裁决机制,极其有效地将滥竽充数的“虚假抽象”隔离在外,确保了入库知识的高纯度。
全面对比:代码提炼技能为何能碾压轨迹反思?
为了验证 CodeSkillBank 是否真的能给前沿智能体带来泛化收益,实验覆盖了包括 DeepSeek-V3(DS4-Flash)、Qwen 3.5、Qwen 3.6、Gemini 2.5 Pro 以及 GPT 5.2 在内的多款顶级大模型,横跨软件工程(SWE-bench Verified、BigCodeBench)、系统交互与终端指令(TerminalBench、LongCLI-Bench、AgentBench-OS)以及数理逻辑推理(AIME 2026、HMMT 2025、GPQA)等 8 大主流基准。
在所有测试中,智能体默认采用成熟的“草拟方案 - 审查反馈 - 迭代修正”的反思工作流。在基准对比中,保持底层提示词与流程完全一致,唯一变量是 Agent 在特定阶段能否检索并参考 CodeSkillBank 中的技能。
1. 跨场景能力全线提升
在 72 组严格协议匹配的实验中,引入 CodeSkillBank 使得宏观平均分从无技能辅助的 42.90 直接跃升至 47.90,取得了 11.7% 的相对提升。特别是在 SWE-bench Verified 榜单上,所有 9 种不同模型基线的评测无一例外全部录得正向收益。在 TerminalBench 等高度依赖长程复杂命令行状态交互的任务中,提升尤为显著。原因在于,系统级操作面临着极其严苛的执行前置条件,而源自真实代码的技能卡片精准地提供了诸如路径合法性预检、退出码判定、状态隔离等关键执行依据。
而在 AIME 和 GPQA 等数理任务上的提升,则说明 CodeSkillBank 中提炼的不变式检查、参数区间约束等元逻辑,能够天然跨越编程领域,迁移赋能给通用的科学符号推理。
2. 与轨迹派技能库的正面对决
这是本项研究最具冲击力的实验结论。以往学界普遍认为,在特定任务环境中由 Agent 探索出的轨迹技能库最懂“实战”。研究团队将 Code2Skill 提炼的技能库与当前最具代表性的三款基于轨迹的技能生成系统——Trace2Skill、ExpeL 和 SkillRL-Bank 放置在完全统一的下游调度接口下比拼。
各系统在跨基准综合评测中的表现高下立判:
-
Code2Skill 达到了 49.5 的平均得分;
-
SkillRL-Bank 仅取得 32.8 分;
-
Trace2Skill 取得 31.0 分;
-
ExpeL 仅取得 27.9 分。
在全部 7 个共享评测基准上,Code2Skill 均取得绝对领先,在单项基准上对最强轨迹基线的绝对超越幅度达到 6.6 至 13.3 分。实验结果有力证明:在智能体尚未通过自身交互积累出海量、高质量的领域经验之前,直接源自人类成熟代码库的程序性技能,能够提供更完备、更正确、泛化能力强得多的先验指导。 轨迹蒸馏不仅容易陷入局部次优,还易受 Agent 自身当前能力的局限,而代码库本身就是人类工业界数百万人年经验的结晶。
关键设计剖析:技能应该在何时、以何种形式注入?
除了验证“有效性”,这项研究还给 Agent 系统的工程落地提供了两项极具价值的实操洞见。
洞见一:技能注入规划与评审,远胜直接介入初次生成
研究团队系统探究了技能在 Agent 生命周期中的切入节点(RQ3):分别测试了在首轮生成(Generation)、高层规划(Planning)以及方案评审与反思(Reviewing / Critique)阶段注入技能的效果。
实验显示,在规划(Planning)阶段提供技能卡片,8 项基准测评全线飘红;在方案审查(Reviewing)阶段注入技能,收益表现最为稳固和持久;但在首轮直接生成(Generation)时引入技能,模型表现却参差不齐。这表明,技能卡片本质上是抽象的规则与约束边界,将其作为规划时的蓝图约束,或作为评审已有解法时的“检查清单(Checklist)”,能让模型最大化发挥其逻辑严密性;相反,如果在第一阶段强行让模型在理解原始输入的同时消化冗长技能并直接翻译成最终代码,容易给上下文引入过载的注意力干扰。
洞见二:精简摘要渲染击败大深度检索
在长上下文模型盛行的当下,Agent 面对大量检索到的技能卡片极易遭遇“大海捞针”困境或上下文爆炸。实验表明(RQ4),相比于检索 5 条乃至 10 条包含完整背景证据的原版卡片,将技能压缩渲染为仅保留核心逻辑、不变式与步骤的极简版卡片(去除近 90% 的上下文占用),模型保留了绝大部分的下游性能增益。这一取舍证实,Agent 在执行时最迫切需要的不是具体的代码实现细节,而是高度提炼的执行规约。
自我演进的新通路:AI 代码能否反哺技能库?
论文在最后一节提出了一个极具前瞻性的问题:随着未来 AI 生成代码的占比呈指数级增长,Code2Skill 的模式能否持续运作,还是会陷入“模型近亲繁殖导致质量劣化”的困境?
研究团队使用测试通过的 AI 生成代码(基于 LiveCodeBench 的 400 个真实任务)与人类编写的代码分别运行 Code2Skill 管线。令人惊喜的实验数据显示:从经过自动化测试校验的 AI 生成代码中,提炼出技能并通过源盲体重构检验的合格率达到了 93.50%,甚至略微高出人类代码提炼的 93.00%。
这一现象说明,只要底层代码具备确定的测试用例验证,AI 编写的代码往往具有结构更规整、命名更直白、设计模式更典型的特征,反而极其利于自动化流水线提取标准技能。这意味着,Code2Skill 不仅是一个静态挖掘已有开源软件遗产的工具,更能无缝衔接未来的 AI 自我编程生态,实现“代码生成 - 测试验证 - 技能提炼 - 技能库扩增 - 赋能更强 Agent”的正向飞轮闭环。
总结与展望
Code2Skill 为智能体智能(Agentic Intelligence)的规模化发展提供了一个全新的支点。长久以来,业界在思考 Agent 能力扩展时,往往聚焦于两端:要么通过预训练堆叠模型参数,要么通过强化学习(RL)在特定虚拟沙盒中猛刷交互步数。而 Code2Skill 证明,在模型参数和单纯的强化学习探索之外,存在第三个高性价比的扩展维度——将海量已有的、高质量的软件实现资产,转化为经过严密语义验证的即插即用型程序知识库。
这不仅让 Agent 具备了跨越自身经验受限的底气,也为未来工业级复杂智能体系统的持续维护、模块化更新与低成本部署,树立了一个切实可行的工程与理论标杆。