万字长文拆解大模型“听话”的秘密:指令微调(IT/SFT)前沿全景综述
Instruction Tuning for Large Language Models: A Survey
大型语言模型(LLM)的原始形态,本质上是一个极其庞大的“文字接龙”机器。 它们通过海量语料学会了预测下一个词,却并不知道如何满足用户的真实业务需求。 当用户输入“帮我写一封辞职信”时,原始模型可能会补充“,你需要注意以下几点”。 它在机械地续写句子,而不是在执行人类的命令。 如何让这个满腹经纶却不懂规矩的“学术怪才”,变成听懂人话的“全能私人助手”?
ArXiv URL:http://arxiv.org/abs/2308.10792v8
论文原图:用于辅助理解核心方法或实验结果。
答案正是指令微调(Instruction Tuning, IT),或称监督微调(Supervised Fine-Tuning, SFT)。 本文基于最新发布的全面综述论文,深入剖析这一前沿领域的最新演进与核心机制。
核心机制探秘
理解指令微调,可以将其视作大模型正式入职前的“职场礼仪与规范培训”。 预训练阶段,模型已经读完了世界上大部分书籍,拥有了庞大但杂乱的原始知识储备。 但在微调阶段,我们通过提供海量的 (instruction, output) 数据对进行强制纠偏。 这就好比给模型发了一本《职场沟通指南》。 指南里明确规定了面对“总结文章”、“翻译法文”等具体指令时,应该以何种格式回复。
从数学本质上看,指令微调通过最大化目标序列的似然估计来更新模型参数。 对于给定的输入指令序列 $X$,模型需要学习生成完美的目标响应 $Y$。 其核心优化目标即为最大化条件概率 $P(Y|X)$。 这种训练方式不仅计算效率极高,而且不需要修改模型底层的 Transformer 架构。 它能迅速将人类意图与模型输出强力对齐,构建起人机交互的基石。
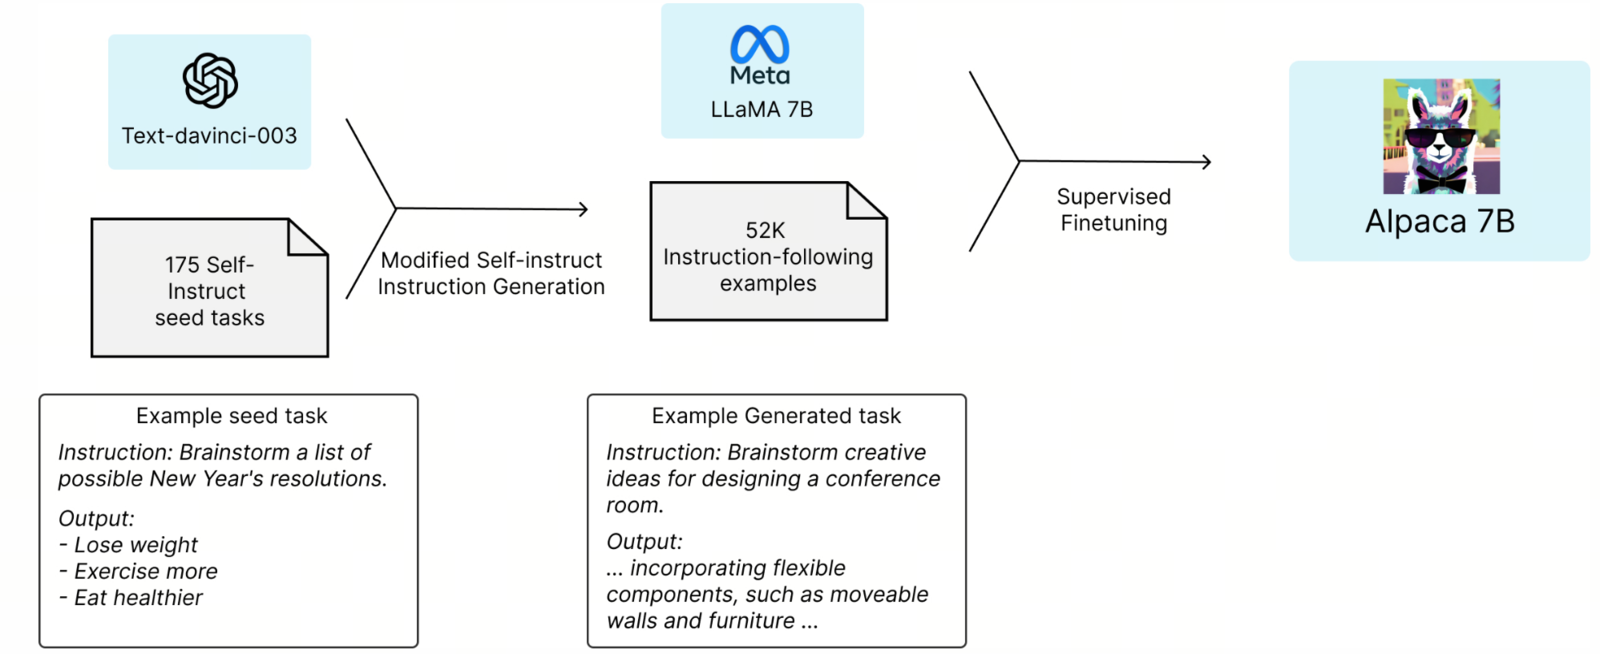
图中展示了指令微调的标准流水线,清晰展现了从指令输入到预期输出的映射过程。
数据集构建:三大核心流派
构建高质量的 SFT 数据集是整个模型对齐环节中绝对的核心壁垒。 本文将数据集获取策略划分为三大流派,每种流派都有其独特的工程价值。
纯人工构建数据
纯人工构建的人类制作数据(Human-crafted Data)虽然规模受限,但逻辑严密。 这类数据完全杜绝了机器生成的幻觉问题。 其中 LIMA 数据集便是极简主义的巅峰代表。 它仅包含了从社区问答和人工精心编写中筛选出的 1000 条高质量问答对。 实验强有力地证明,单靠这极少量的完美数据,大模型就能展现出惊人的对齐效果。
而 Super-Natural Instructions 数据集则走向了规模化统合的另一极。 它涵盖了 1616 个传统的 NLP 任务,包含超过 500 万个具体的任务实例。 P3 数据集整合了 170 个英文任务,并通过 2052 个提示词将其转化为统一问答格式。 xP3 更是将这一理念跨界扩展,覆盖了 46 种语言,使得多语言指令跟随成为现实。
蒸馏合成数据
如果雇佣大量行业专家进行人工标注成本过于高昂,破局之道在哪里? 通过蒸馏合成数据(Synthetic Data via Distillation)成为了开源社区的主流。 继续前面的比喻,“职场新人”(开源小模型)开始跟在“业务骨干”(顶尖闭源模型)身后偷师学艺。
 斯坦福的 Alpaca 模型正是这一低成本路线的开创者。 它通过向参数庞大的模型发送多样化指令,收集生成的 5.2 万条高质量回复作为教材。 WizardLM 则更进一步,独创了 Evol-Instruct 进阶机制。 它不满足于简单的提问,而是让指令的复杂度在多个逻辑维度上不断自我演化。 微软主导的 Orca 系列更是将知识蒸馏推向了更深层次。 它不仅要求模型输出最终答案,还强制要求输出类似于“一步步思考”的详尽推理过程。 这让小模型不仅学会了最终答案,更深度复刻了“业务骨干”底层的思考链路。 Baize 数据集则巧妙利用了多轮自我对话机制。 它让顶尖模型同时扮演用户和 AI 助手,在自我对弈中沉淀出连贯的多轮交互语料。
自我提升机制
当模型自身能力跨越特定的临界阈值后,它还可以通过自我提升(Self-Improvement)合成新数据。 这就如同职场老手在深夜独处时进行“复盘”,通过对着镜子自我对练来发现破绽。
 SPIN 机制让语言模型在无需外部干预的自我博弈中进行多轮迭代微调。 它不断尝试区分自己上一轮生成的低质回复与理想目标数据分布的细微差异。 这种无需依赖昂贵人类反馈的强化过程,极大提升了模型的独立进化上限。 指令回译(Instruction Back-translation)则是另一种极为巧妙的逆向工程。 它对着收集来的高质量长篇网页文本,逆向推导出可能生成这些文本的“原始提问指令”。 这种自我闭环操作,为获取长尾冷门领域数据提供了前所未有的解题思路。
推理强化:攻克深层逻辑
随着大模型应用逐渐步入深水区,单纯的排版和语气对齐已经无法满足复杂的业务需求。 面向高难度逻辑的推理数据集,成为了拉开顶尖模型与普通模型差距的核心阵地。
PRM800K 数据集通过引入极其昂贵且精细的步骤级人类反馈机制打破了僵局。 它不再只关注最终答案对错,而是对多步数学推理中的每一个中间步骤进行精准定性。 特别是针对“看似合理实则荒谬”的伪装解答,给予了极高的惩罚权重。 O1-Journey 则构建了一个包含树状深度探索与多智能体动态博弈的推理集合。 其中一个智能体负责生成探索路径,另一个则扮演严苛的导师提供纠错反馈。 这种高度拟合人类自我反思与试错修正的过程,大幅拔高了模型的逻辑韧性。
MathGenie 深度结合了自然语言推导与计算机代码执行的双重验证能力。 它通过对基础题库进行反向翻译,凭空合成了海量的异构数学难题,并用代码兜底验证。 DeepSeekMath 更是豪掷算力,构建了规模高达 1200 亿 Token 的多语言数学语料库。 它依托极其复杂的迭代爬虫策略,从浩如烟海的网络文本中精准提纯了深度的代数奥秘。
代表模型演进路径
在浩如烟海的指令微调模型库中,有几座无法绕过的里程碑。 InstructGPT 彻底确立了 SFT 叠加奖励模型优化的标准强化学习范式。 它无可辩驳地证明了,仅靠极小规模的高质量人工排序数据,就能驯服千亿参数巨兽。 FLAN-T5 则向下级探索了指令微调在较小参数量模型上的恐怖泛化潜力。 仅通过将 62 种传统 NLP 数据集统一转化为指令模板,11B 的模型便能在零样本测试中大放异彩。 GPT-4-LLM 则是利用巅峰模型生成高质量指令对,直接对底层开源模型降维打击。 Vicuna 通过海量吸收真实的野生用户对话记录,在角色扮演和日常闲聊中脱颖而出。 这深刻说明了,真实世界的数据分布对于打磨极致的用户体验具有不可替代的价值。
当前技术局限探讨
然而,指令微调绝非包治百病的万能神药,学术界的审视目光正变得日益严苛。 最尖锐的质疑直指核心:SFT 到底是在传授新知识,还是仅仅在教模型“如何高分通过图灵测试”?
大量底层探测研究表明,SFT 模型往往只是死记硬背了人类偏好的输出格式与礼貌句式。 它们在表层行为模式上极力迎合人类,却并未在深层逻辑网络中发生本质的突触重组。 换言之,模型学会了“看似专业”的表达,却并未真正理解任务背后的硬核机理。 此外,SFT 模型表现出严重的“数据分布依赖症”。 一旦用户输入的指令组合超出了微调数据集覆盖的预设领域,模型极易全盘崩溃。 它不仅无法灵活变通,甚至会用极其自信的播音腔生成看似无懈可击的错误幻觉。 这种遭遇未知突发情况时的极度脆弱性,凸显了当前范式亟待突破的技术天花板。
工程实践启示
对于一线的 AI 架构师和算法工程师而言,本文的系统梳理给出了极具穿透力的实战指引。 首要铁律便是:数据质量永远呈现压倒性的优势凌驾于数据数量之上。 盲目使用爬虫堆砌上百万条低质量、充满杂讯的合成对话,纯属算力浪费。 精心打磨一千条覆盖核心业务边界、历经多轮交叉验证的专家指令,才是破局核心。
在构建企业级垂直领域大模型时,应当坚决摒弃浅尝辄止的通用闲聊数据。 务必优先构建包含中间思考路径、代码验证逻辑的链式多步数据。 只有彻底打破对表层格式的浅薄模仿,深入长程逻辑推理的泥潭,才能真正唤醒大模型的生产力。