ISO:继承奇异谱只优化框架,RLVR步数缩减2.7倍且性能反超
ISO: An RLVR-Native Optimization Stack
在大语言模型通往深度推理的演进路径上,强化学习与可验证奖励(RLVR,Reinforcement Learning with Verifiable Rewards)已经成为最核心的推动力。无论是数学求解还是复杂代码生成,RLVR 都展现出了激发现有模型推理潜力的惊人能力。然而,在算法与算力飞速扩展的表象之下,一个底层的结构性矛盾始终被业内忽视:当前几乎所有 RLVR 训练,依然沿用着直接从预训练阶段照搬过来的优化器(如 AdamW 或 Muon)与欧几里得权重参数化方式。
ArXiv URL:https://arxiv.org/abs/2607.19331v1
预训练面对的是海量语料上高密度的 Token 级监督信号,其核心任务是在白纸上刻画全新的知识表征;而 RLVR 则是在一个已经具备完备语言与常识能力的基座模型上,依靠极其稀疏的结果级标量奖励(0 或 1 的正确性验证)进行策略微调。将面向“无中生有”的优化工具直接套用到“已有能力的定向重塑”上,这种做法在机制层面并不自然。来自 ELLIS、UIUC、Together AI 以及德克萨斯大学奥斯汀分校等机构的联合研究团队,在最新论文中揭开了这一缺失的优化层,并提出了一种专为后训练量身定制的新范式:等谱优化(Isospectral Optimization,简称 ISO)。
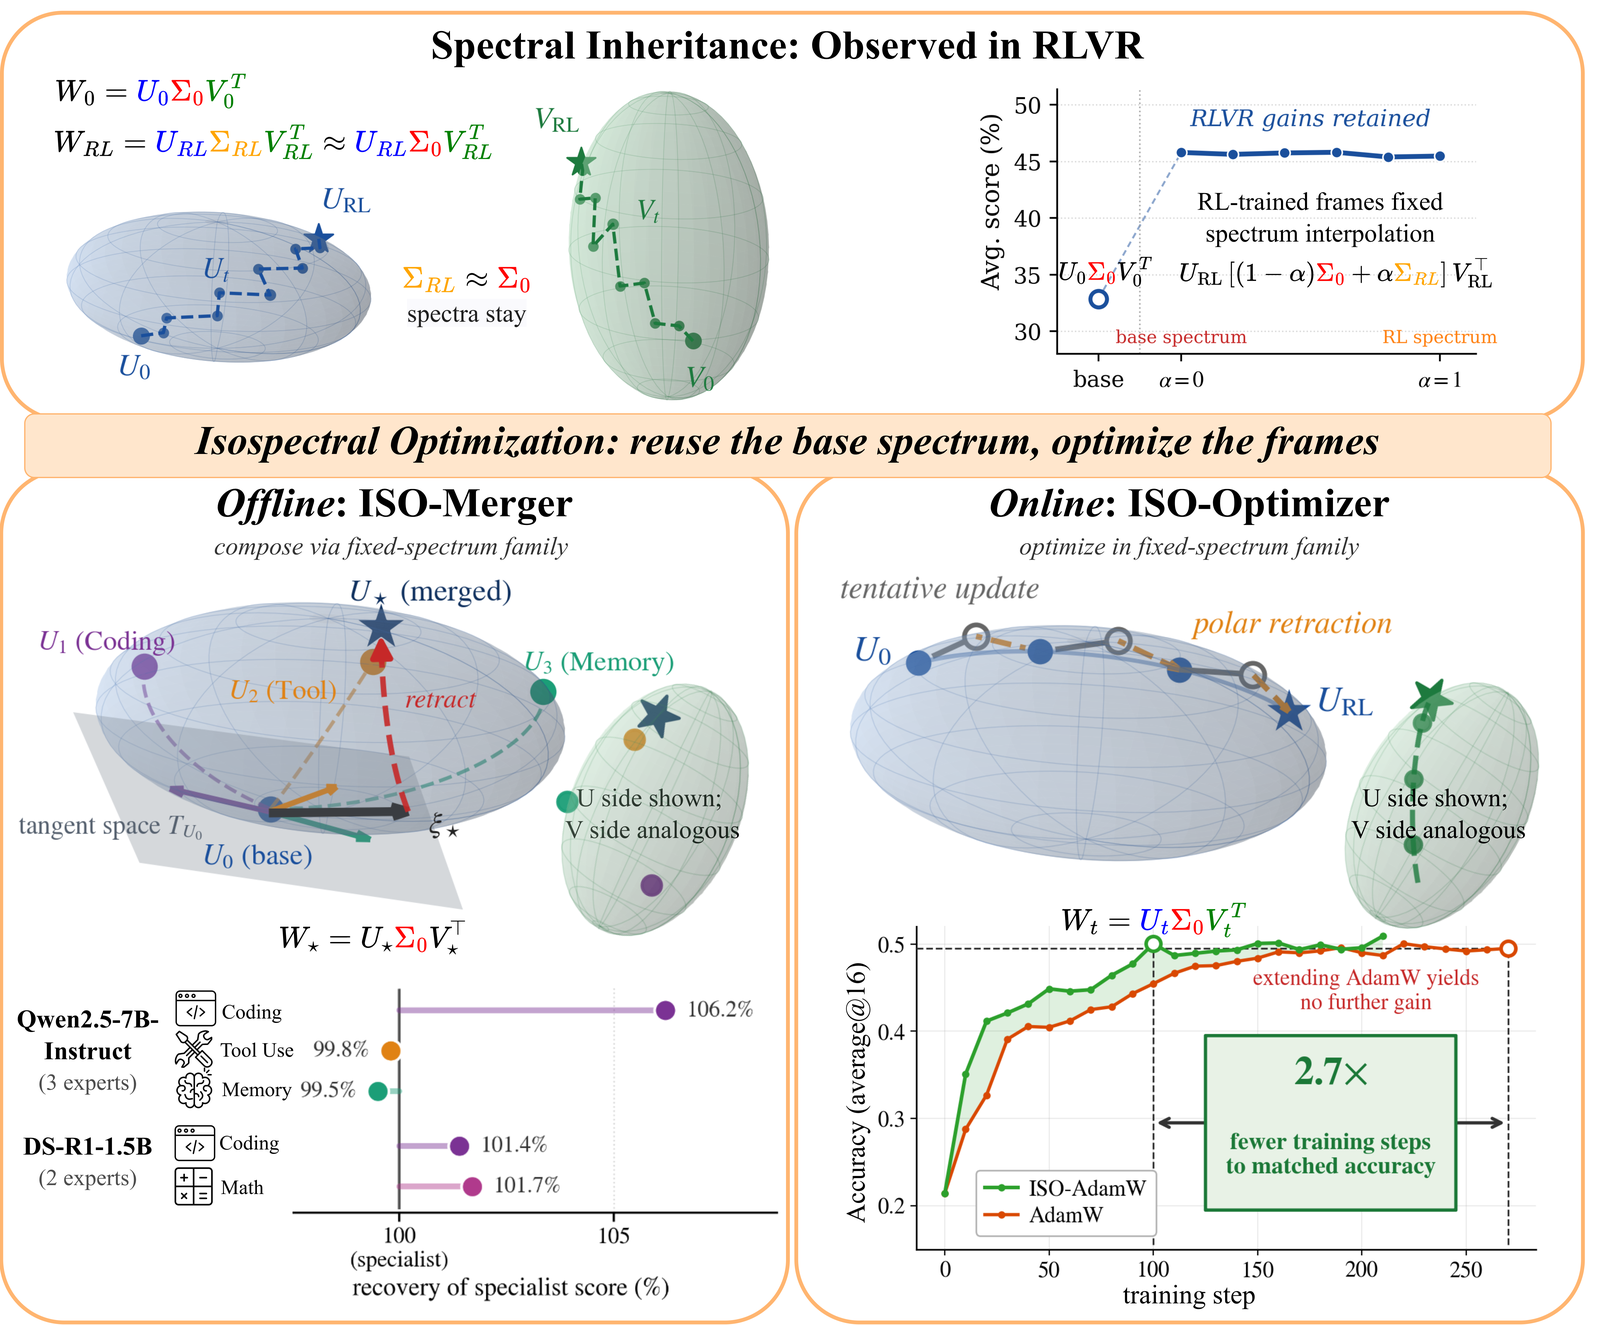
研究团队通过奇异值分解(SVD)的几何视角发现了一个颠覆直觉的现象——谱继承(Spectral Inheritance)。在 RLVR 训练过程中,模型各层权重矩阵的奇异值谱(即代表各模态尺度的数值)与基座模型几乎完全重合;真正发生剧烈迁移并驱动推理能力跃迁的,是输入与输出的奇异框架(Singular Frames,即奇异向量构成的正交基底)。基于这一发现,ISO 提出了极其简练的优化公理:“继承原始谱,优化奇异框架”。实验表明,在线训练中,ISO 仅需常规 AdamW 约 $1/2.7$ 的训练步数即可达到相同推理精度,并在同等算力下实现最终得分的反超;离线合并多领域专家时,ISO-Merger 亦能在完全不需要额外数据、采样与蒸馏的前提下,实现极高水准的能力聚合。
权重几何的谜题:为什么奇异值几乎纹丝不动?
在以往的后训练分析中,学界通常在欧几里得空间内审视权重的变化,发现 RLVR 的梯度更新呈现出稀疏、非主成分主导且在同底模下高度重叠的特性。然而,欧几里得坐标无法回答一个核心问题:在模型参数演化时,究竟哪些结构被原封不动地保留,哪些结构被彻底重构?
为了理清这一层次,研究团队将任意权重矩阵分解为薄奇异值分解形式:$W_t = U_t \Sigma_t V_t^\top$。在此定义下,对角矩阵 $\Sigma_t$ 决定了奇异模态的尺度(即“谱”),而正交矩阵对 $(U_t, V_t)$ 则分别定义了输出和输入的空间方向(即“框架”)。对应地,任意基座权重 $W_0 = U_0 \Sigma_0 V_0^\top$ 都可以自然导出一个“等谱家族”(Fixed-Spectrum Family):
\[\mathcal{F}(W_0) := \left\{ U \Sigma_0 V^\top : U \in \mathrm{St}(d_{\mathrm{out}}, q), \, V \in \mathrm{St}(d_{\mathrm{in}}, q) \right\}\]其中 $\mathrm{St}(d, q)$ 表示 Stiefel 流形,$q = \min{d_{\mathrm{out}}, d_{\mathrm{in}}}$。数学上可以严格证明,任意矩阵 $W$ 到该等谱家族的弗罗贝尼乌斯距离,严格等于二者奇异值向量之间的欧氏距离:$\operatorname{dist}_F(W, \mathcal{F}(W_0)) = |\sigma(W) - \sigma(W_0)|_2$。这就为衡量模型在训练中偏离基座“谱”的程度提供了确定性的几何标尺。
研究人员对长程 RLVR 训练检查点(例如历经 3000 多次更新的 DeepSeek-R1-Distill-Qwen-1.5B 演进序列)进行了逐层测量,结果令人震惊:整个强化学习阶段产生的层均相对谱漂移 $\delta_\Sigma$ 仅在 $10^{-2}\%$ 数量级,相对谱残差 $\rho_\Sigma$ 平均仅占总权重位移的约 $3\%$。换言之,学成端点到基座等谱家族的距离,在整个位移中几乎可以忽略不计。与此形成极其鲜明对比的是监督微调(SFT)阶段——SFT 的相对谱残差高达约 $35\%$,奇异值发生明显的收缩与重塑。
但这是否只是超高维矩阵空间的巧合?在一个高维矩阵中,能够在一阶导数上改变奇异值的坐标维度非常有限,仅为 $q$ 维。团队设计了维度归一化的变谱能量指标 $\kappa_{\mathrm{spec}}$ 来校准高维效应。结果显示,RLVR 的 $\kappa_{\mathrm{spec}}$ 始终稳定在 1.0 至 1.4 之间,这意味着强化学习并没有刻意“压制”谱的改变,其在谱方向上的扰动纯粹类似于各向同性的随机漫步;而 SFT 的 $\kappa_{\mathrm{spec}}$ 却高出随机基准两到三个数量级。这一结论极为精细:RLVR 并没有主动抵制改变奇异谱,而是强化学习的奖励驱动机制根本不需要大幅重写奇异谱。
功能验证:那些微小的谱漂移到底有用吗?
观察到几何上的“近等谱性”(Near-Isospectrality),引出了更具决定性的功能性追问:RLVR 中发生的微小谱漂移,究竟是不是模型习得复杂推理所必需的?
为了彻底厘清因果关系,研究团队设计了两项严苛的干预实验。第一项干预是“事后强行重置谱”。将一个已经完成 RLVR 训练的模型端点权重 $W_{\mathrm{RL}} = U_{\mathrm{RL}} \Sigma_{\mathrm{RL}} V_{\mathrm{RL}}^\top$ 进行谱插值:
\[\widetilde{W}(\alpha) = U_{\mathrm{RL}} \left[ (1 - \alpha) \Sigma_0 + \alpha \Sigma_{\mathrm{RL}} \right] V_{\mathrm{RL}}^\top\]当 $\alpha = 0$ 时,模型完全剥离了 RLVR 阶段学到的所有奇异值变化,强行恢复至训练前的基座奇异谱 $\Sigma_0$,而保留 RL 训练出的正交框架 $(U_{\mathrm{RL}}, V_{\mathrm{RL}})$。评测结果表明,在数学推理基准 AMC23 上,将谱完全重置回 $\Sigma_0$ 后,模型的得分曲线几乎水平,原本在 RLVR 阶段获得的绝大部分推理能力完好无损地得到了保留。相反,如果进行反向替换——将基座模型的谱换成 RLVR 训练后的谱,而保持基座框架不动,模型性能没有任何提升。
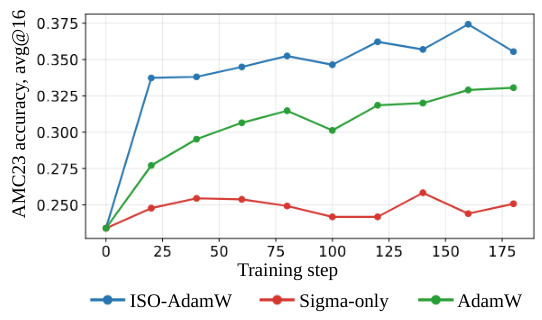
第二项干预则更为严苛:在训练一开始就“锁死”基座谱 $\Sigma_0$,强制模型在整个强化学习训练过程中只能更新奇异框架变量 $(U, V)$。如上图所示,固定谱训练的模型完全复现甚至略微超越了自由更新模型的推理表现。而与之对照的“仅更新谱、冻结框架”实验组,性能几乎完全停滞。
这确凿地证实了“谱继承”的真实存在:基座模型早已在预训练阶段确立了权重的奇异模态尺度与动态范围,RLVR 并不需要重新调整各模态的能量分布,它需要做的,仅仅是通过旋转和重排奇异框架,将预训练模型中原本未对齐或隐藏的表征通路重新编排。
结构约束:仅靠部分旋转或子空间重组够不够?
既然奇异谱可以被完全继承,那么模型架构是否可以进一步简化?例如,我们能否把更新限制在基座权重已有的输入输出子空间内进行重组(Remixing),或者仅仅允许其中单侧框架(仅输入端或仅输出端)自由变化?
论文在数学上严格推导了四种受限重构类在弗罗贝尼乌斯范数下的最优解,并定义了“未解释更新比率” $u_h$(Unexplained-Update Ratio)来量化不同约束对模型实际更新轨迹的拟合能力:
-
子空间内重组($\widehat{W}_{\mathrm{mix}}$):将更新严格约束在基座模型的输入和输出子空间内部,允许核心矩阵自由旋转缩放。
-
单侧保持($\widehat{W}_L$ 与 $\widehat{W}_R$):分别保留基座模型的左侧输出子空间或右侧输入子空间,另一侧完全自由。
-
等谱约束($\widehat{W}_{\mathrm{iso}}$):继承基座模型的全部奇异谱 $\Sigma_0$,但允许输入和输出框架 $(U, V)$ 在整个空间中完全自适应旋转。
在多模态与多阶段具身强化学习(视觉推理到具身操作)的连续目标迁移压力测试中,数据给出了残酷的裁决:子空间重组($\widehat{W}_{\mathrm{mix}}$)留下了高达中位数 $87\%$ 的更新无法被解释;单侧保持($\widehat{W}_L$ 与 $\widehat{W}_R$)也留下了超过 $40\%$ 的未解释更新。这意味着低秩适配(如常规 LoRA)或单侧投影等结构限制,严重制约了模型适应新任务的能力。
唯独等谱重构($\widehat{W}_{\mathrm{iso}}$)展现出了近乎完美的表征能力,其未解释更新比率仅有区区几个百分点。这一系列诊断形成了闭环判定:在 RLVR 中,奇异谱完全可以固化继承,但输入与输出两个奇异框架必须保持完全的可适应性,缺一不可。
从理论到系统:ISO 优化技术栈的在线与离线落地
上述理论洞察并不是停留在纸面上的几何玩具,而是直接催生了一套专为 RLVR 打造的原生优化栈——Isospectral Optimization(ISO)。ISO 在参数表示上直接废除传统的无约束矩阵更新,将每一层权重重构为:
\[W(U, V) = U \Sigma_0 V^\top, \quad U \in \mathrm{St}(d_{\mathrm{out}}, q), \, V \in \mathrm{St}(d_{\mathrm{in}}, q)\]这一参数化天然满足了两个互补的落地场景:
在线训练:ISO-Optimizer
在线 RLVR 训练中,ISO 并不发明全新的数值优化步长规则,而是作为一种框架变量的流形调度器,可以直接包裹主流的基础优化器(如 AdamW 或 Muon)。传统优化器直接作用在扁平化的全局参数矩阵 $W$ 上,容易在谱空间产生无意义的高频抖动;而 ISO-Optimizer 将更新解耦,将优化变量锚定在正交框架 $(U, V)$ 上,在保持 $\Sigma_0$ 绝对静止的同时,驱使框架向量高效对齐奖励信号。
在跨越 1.5B 到 8B 参数、涵盖数学与编程的多项实验中,ISO 展现出了令人瞩目的样本与算力效率。在最具说服力的 Qwen3-8B-Base 模型推理训练中,标准 AdamW 需要迭代 270 个训练步才能使聚合准确率达到 0.495;而搭载了相同超参数配置的 ISO-AdamW,仅需 100 个训练步便达到了相同的准确率,步数效率提升了整整 2.7 倍。不仅如此,当训练继续推进至 210 步时,ISO-AdamW 的聚合准确率进一步攀升至 0.509,显著超越了传统未受限优化的天花板。这意味着等谱约束并不是性能妥协的妥协解,它通过剔除多余的参数自由度,实质上为强化学习提供了极其强烈的结构归纳偏置(Inductive Bias)。
离线模型融合:ISO-Merger
在后训练工作流中,多任务或多领域专家的合并往往需要面对灾难性遗忘或参数干涉。常见的解决手段往往高度依赖合并后的再次微调、在线采样或同策略蒸馏(On-Policy Distillation),系统成本高昂。
ISO-Merger 提供了一种免数据(Data-Free)的高纯度解决方案。由于来自同一基座的所有专家模型都在理论上继承了相同的 $\Sigma_0$,它们的领域差异纯粹体现为框架的几何旋转。ISO-Merger 采用“投影–掩码–融合–回缩”(Project-Mask-Merge-Retract)流程,将多个共享底模专家的奇异框架变动进行正交化合并,重新嵌合回基座谱 $\Sigma_0$ 中,直接组装成一个新的等谱模型。在完全不使用任何后合并数据、不进行任何梯度回传与前向采样的前提下,ISO-Merger 在多项对比测试中取得了超越现有免数据合并算法的最优综合性能,完整保全了互补专家的技能树。
范式转移:为什么后训练优化理应与预训练解耦?
长期以来,大模型领域的惯性思维倾向于在整条生命周期中复用相同的优化范式。无论是两万亿 Token 的预训练,还是数千步的强化学习,从业者习惯性地调小学习率,换上相同的 AdamW。
ISO 的提出,本质上是对这种粗放工程惯性的一次深刻反思。预训练是一次重塑表征空间的“热力学膨胀过程”,它必须通过调整奇异谱来为各类概念分配不同的维度重要性与能量尺度;但当大模型进入 RLVR 阶段时,其本质不再是“学习什么是世界”,而是“学会如何在已有认知空间内进行准确搜索与推理”。在这个意义上,策略的演变只需要旋转思考的角度(输入输出投影框架),而根本不需要改变世界模型的度量基础(奇异谱)。
从实用角度看,ISO 为长久以来面临训练崩溃、策略退化与算力瓶颈的后训练工程指明了极具性价比的演进方向。通过将“谱继承”从纯粹的统计规律提升为优化架构的先验约束,模型团队不仅能在强化学习中节省数倍的步数与显卡时间,更能在参数高效微调(PEFT)与分布式多智能体协作中,找到更坚固的几何支点。后训练优化的新篇章,或许正是从承认预训练的谱基础、专心旋转框架开始。