SALT:动作对齐语言,机器人控制成功率从42.7%提升至71.9%
Lost in Reconstruction: Aligning Action Representations with Language in Vision-Language-Action Models
在具身大模型(Vision-Language-Action, VLA)的研究浪潮中,人们习惯将注意力集中在“视觉与语言如何对齐”上:用海量的图文对预训练模型识别物体、理解空间关系,再把机器人动作(Action)变成纯粹的数值回归或离散 Token 预测。然而,来自卡耐基梅隆大学(CMU)的最新研究揭示了一个长期被忽视的基础缺陷:现有的动作表征几乎全靠欧氏空间下的物理重构损失(如 L1 或 L2 损失)进行无监督压缩,数值上的接近并不代表语言层面的等价。这种“纯重构”的动作分词(Tokenization)正在系统性地破坏动作轨迹中内含的语言动词信号。
ArXiv URL:https://arxiv.org/abs/2608.10484v1
为了解决这一隐蔽的表征瓶颈,本文提出了 SALT(Semantically ALigned action Tokenizer,语义对齐动作分词器)。它打破了传统动作分词器只顾拟合轨迹坐标的范式,通过引入一个冻结的视觉语言模型(VLM)监督量化后的动作潜在表征,要求其反向推断出任务指令。实验结果极具说服力:在基准评测 SimplerEnv 中,搭载 SALT 分词器的策略平均任务成功率达到 71.9%,相比纯重构 VQ-VAE 的 42.7% 与基于频率压缩的 FAST 的 31.2%,实现了巨大的性能飞跃。这表明,机器人动作轨迹不仅是执行的载荷,更是语言落地的天然来源;让动作理解语言,才能真正解开具身控制的锁链。
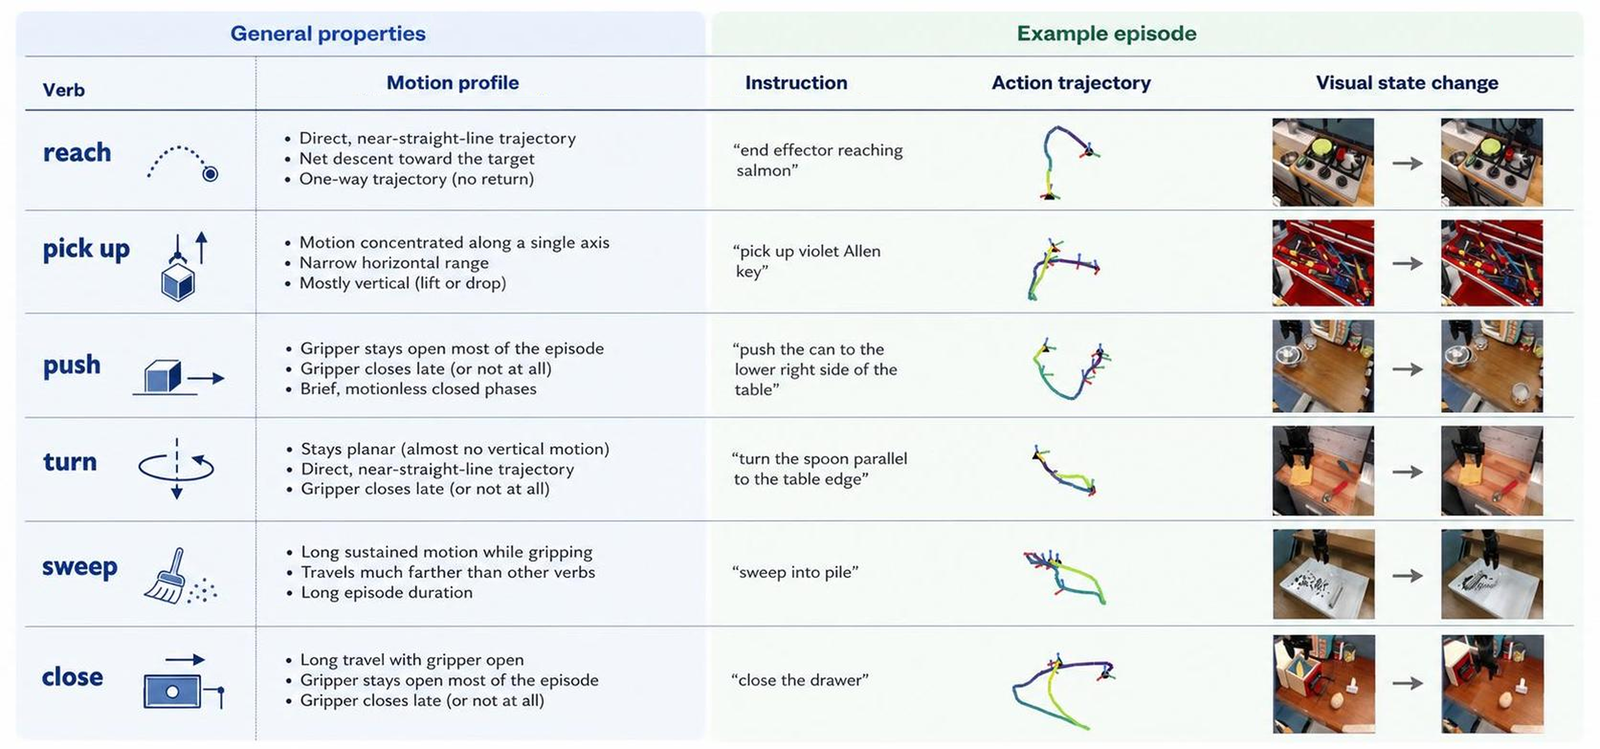
动词不仅描述“结果”,更规定了“怎么做”
自然语言指令在物理世界中究竟扮演着什么角色?传统的具身机器人研究大多将语言简化为“目标调节器(Goal Conditioning)”:比如指令里的“红色积木”“左侧抽屉”,主要通过名词和形容词引导视觉编码器定位物体与最终状态。然而,在语言学与物理现实中,动词(Verbs)承载着双重内涵:它不仅定义了物理状态的改变(Action Goal),更严格规约了动作的发生过程与动力学特征(Motion Dynamics)——即所谓的方式(Manner)与结果(Result)。
通过解构真实机械臂遥操作数据集 BridgeV2 中的 17 类核心动词(覆盖 27,271 个演示片段),研究者做出了关键的实证测算:把任务的最终视觉变化(首尾两帧的差异)定义为“目标”,把 7 自由度(7-DoF)的机械臂轨迹定义为“动力学”。通过互信息 $I(Y;X)$ 的分解计算,发现轨迹本身包含大量无法被视觉起止状态涵盖的动词信息。
如上图所示,像 push(推)、flip(翻转)、fold(折叠)这类动词,绝非简单的起止坐标位移。它们表现出极为鲜明的运动模式:特殊的轨迹曲率、特定轴向的角速度爆发、以及精准的夹爪开合时序(Gripper Timing)。视觉变化固然能提供环境状态改变的线索,但在轨迹维度上,纯机械运动数据依然贡献了不可替代的语言落地信号($\Delta_{\text{motion}}$ 达到显著正值)。换句话说,如果动作模块只负责冷冰冰的逆运动学执行,而无法理解动作序列所对应的语言抽象,模型在面对“轻轻推”还是“顺时针转”时,就会失去底层动作层面的判别力。
纯重构分词:离散化过程中的语义坍塌
为了让机械臂动作能复用主流 VLM 的自回归架构,业界普遍将连续轨迹离散化为动作 Token(Action Tokens)。主流方案大体分为三类:基于各维度均匀分桶的 Bin Tokenization(如 RT-1、RT-2、OpenVLA)、基于频域分解和字节对编码的 FAST,以及基于矢量量化自编码器的 VQ-VAE。
这三类方案无论数学结构如何变化,其优化目标几乎完全锁定在欧氏空间下的轨迹重建:
\[\mathcal{L}_{\mathrm{recon}} = \|a - \hat{a}\|\]研究者指出,这里的核心矛盾在于:物理空间里的微小数值误差,在语义上可能是致命的;而物理空间里的大幅变化,在语义上可能毫无差异。 例如,稍微改变夹爪闭合的角度可能导致“抓取”退化成“擦碰”,这是本质上的动作类别突变;反之,机械臂在空旷处画一条略有弯曲的轨迹,其“移动”的语义却完全未变。
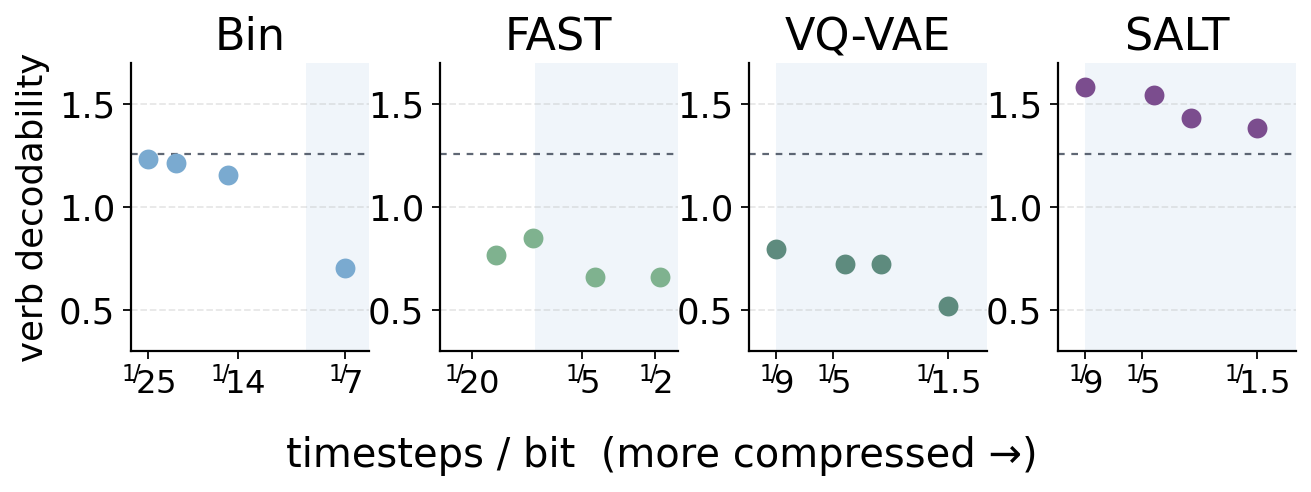
通过率失真(Rate-Distortion)的分析框架,研究者系统评估了不同分词策略对动词信息的保留能力。如上图所示,横轴表示动作轨迹的压缩率(单位比特对应的时间步,越往右压缩越激进),纵轴表示 Token 中能够解码出的动词互信息量。可以观察到一条普遍规律:
-
信息随压缩急剧衰减:无论是 Bin、FAST 还是纯重构 VQ-VAE,其动词可解码性均大幅低于未量化的连续轨迹基准(1.26 bits),且随着压缩比提升,语义信息单调加速下坠。
-
下游训练无法挽回损失:即使后续在策略模型上用语言指令进行微调,下游策略也无法从已经被破坏的离散 Token 字典中还原丢失的动词几何结构。这证明,当前的离散动作接口已经成为限制 VLA 理解力与执行力的核心瓶颈。
SALT:用生成式语言监督重塑动作空间
为了让分词器既能保留物理轨迹的控制精度,又能内化语言的语义边界,研究团队提出了 SALT(Semantically ALigned action Tokenizer)。
SALT 的构思极其优雅:它没有推翻成熟的残差矢量量化(Residual-VQ)架构,也没有在下游策略训练时增加额外的推理负担,而是在分词器的预训练阶段,植入了一道跨模态的“生成式对齐压力”。
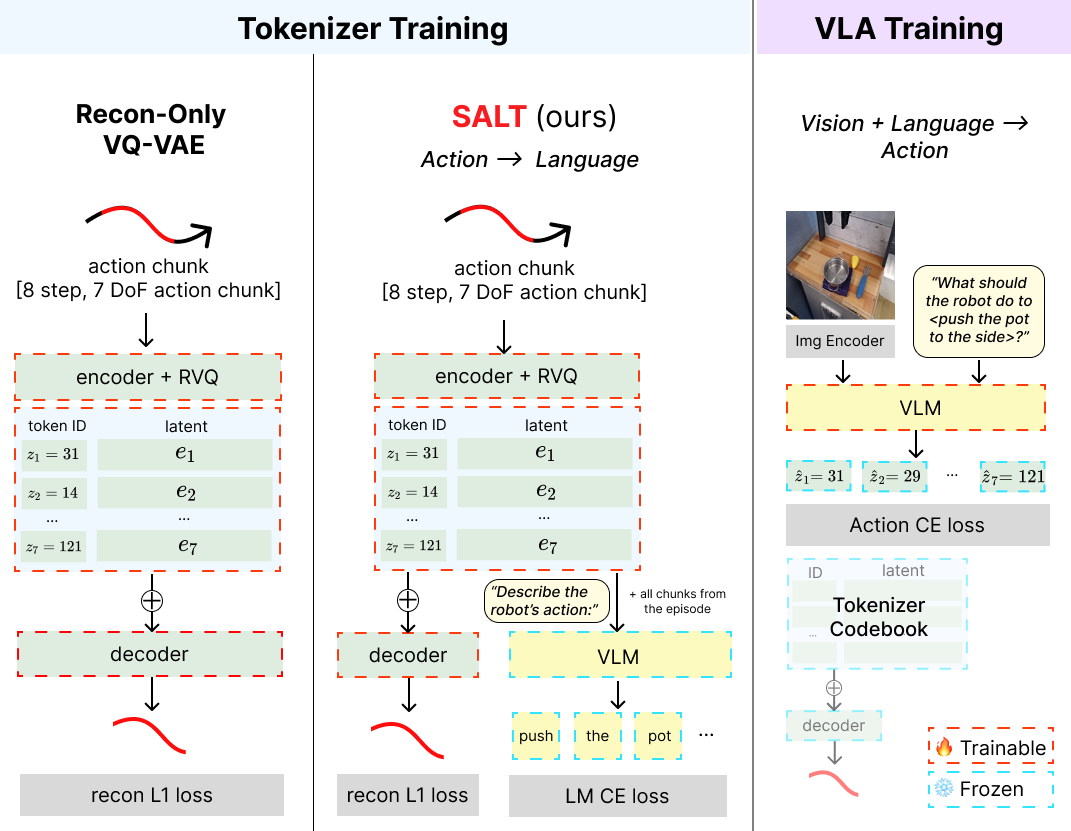
整体流程分为三个紧密结合的步骤:
首先,连续的动作轨迹块 $a_{1:H} \in \mathbb{R}^{H \times d_a}$(例如长度 $H=8$ 的 7 自由度轨迹)被送入残差矢量量化编码器,生成量化潜在表征:
\[\mathbf{q}_i = \sum_{k=1}^K \mathbf{e}_{z_{i,k}}^{(k)}\]其中 $K$ 为残差量化深度,$\mathbf{e}$ 为码本向量,$z_{i,k}$ 为对应的离散索引。
其次,也是 SALT 的关键创新所在:在计算传统的轨迹重建损失 $\mathcal{L}{\mathrm{recon}}$ 与量化损失 $\mathcal{L}{\mathrm{VQ}}$ 之外,引入辅助生成对齐损失 $\mathcal{L}_{\mathrm{align}}$。具体而言,系统将一个完整动作片段中所有动作块的量化向量 $\mathbf{q}_i$ 加上位置编码 $\mathrm{PE}(i)$,映射为一个序列 $\mathbf{P}$,并作为 Prompt 喂给一个参数完全冻结的预训练视觉语言模型(VLM)。该 VLM 的目标是自回归生成该演示轨迹最初对应的自然语言任务指令:
\[\mathcal{L}_{\mathrm{align}} = -\frac{1}{L} \sum_{t=1}^L \log p_{\mathrm{LM}}\left(w_t \mid w_{<t}, \mathbf{P}, s\right)\]通过直通估计器(Straight-Through Estimator),语言模型产生的交叉熵梯度反向穿过滤元与码本,直接塑造了动作分词器的潜空间。
这一机制带来了极为深刻的几何改变:那些由相似语言描述的物理动作(即便具体运动坐标存在波动),被迫向潜空间中相近的吸引子靠拢;而那些看似轨迹坐标相近、但在语言定义中属于截然不同意图的动作,则被强行推开。
最后,在分词器训练完成后,辅助的语言模型被直接丢弃,分词器被完全冻结。在后续训练下游 VLA 策略(如 miniVLA)时,流程与常规策略训练毫无二致:主干网络输入视觉与语言,自回归预测动作 Token ID,再由 SALT 解码器一次性将其还原为连续可执行的关节轨迹。
实验评测:大比分超越传统方案的控制表现
为了严格检验语义对齐动作分词器的泛化性能,研究者在基于真实环境模拟的 SimplerEnv(WidowX 臂环境)中进行了闭环控制评估。策略主干采用 Prismatic 风格的 miniVLA(Qwen2.5-0.5B),并在 BridgeV2 数据集上进行了标准训练。除动作分词器完全不同外,所有模型的参数规模、数据配比与训练步数(15k steps)完全一致。
1. 闭环控制成功率:全任务大幅领先
在涵盖毛巾放勺子、盘子装胡萝卜、积木堆叠(Stack)、篮子放茄子等多样化操作任务中,评测结果呈现出碾压态势:
| 方法 | 分词器机制 | Spoon on Towel | Carrot on Plate | Stack Green Block | Put Eggplant in Basket | 平均成功率 |
|---|---|---|---|---|---|---|
| FAST | 频域压缩 + BPE | 54.2% | 29.2% | 20.8% | 20.8% | 31.2% |
| VQ-VAE | 纯重构残差量化 | 58.3% | 45.8% | 33.3% | 33.3% | 42.7% |
| SALT (本文) | 语义对齐残差量化 | 75.0% | 62.5% | 70.8% | 79.2% | 71.9% |
如上表所示,SALT 驱动的策略取得了 71.9% 的平均成功率,不仅相较于基线 VQ-VAE 提升了近 30 个百分点,更大幅超越了 FAST 的 31.2%。
尤为关键的是,在动作复杂度最高、极度依赖动态时序判断的两个长程任务——积木堆叠与篮子放茄子中,基线模型的成功率均跌至 33.3% 左右,而 SALT 依然保持了 70.8% 和 79.2% 的高可靠性。由于 SALT 与 VQ-VAE 采用完全相同的网络结构、码本容量与压缩比例,这种性能代差完全源自于码本空间与语言对齐所带来的归纳偏置。
2. 动词可解码性与特征穿透力
分词器内部的语言结构是否真正传递给了下游网络?针对离散 Token ID(TokID)以及下游策略网络学到的动作输入嵌入($E_{\text{in}}$),作者通过多折交叉验证探测了动词的宏观 F1 分数(Macro-F1)。
结果显示,SALT 在 Token ID 层面的动词探测 F1 达到 39.1(基线 VQ-VAE 为 37.3,FAST 仅为 30.3);而在下游策略学习到的动作嵌入 $E_{\text{in}}$ 上,SALT 进一步扩大优势至 43.7(基线分别为 38.3 与 36.3)。更令人惊讶的是,SALT 离散 Token 的动词分类准确率达到了 58.7%,甚至反超了未压缩连续真实轨迹的 58.0%。这表明,语言监督不仅对抗了量化过程中的信息损失,还起到了一种“语义去噪”的作用,提炼出了最本质的动作意图。
与此同时,这种语义对齐并未破坏轨迹控制本身的物理保真度。在保留测试集上,SALT 的连续重构 L1 误差(0.088)依然与纯重构 VQ-VAE(0.080)处于同一微小量级;在 63 个可解释轨迹运动学特征(如角速度峰值、夹爪开合时机)上,SALT 重构轨迹的效应量秩相关性高达 0.92。换言之,物理保真度丝毫未损,语义结构却已脱胎换骨。
深入潜空间:专用动作码元的自主涌现
为了彻底避开外加分类探测器可能带来的评估偏差,论文进一步直接可视化了码本单元与任务动词之间的无监督共现分布。
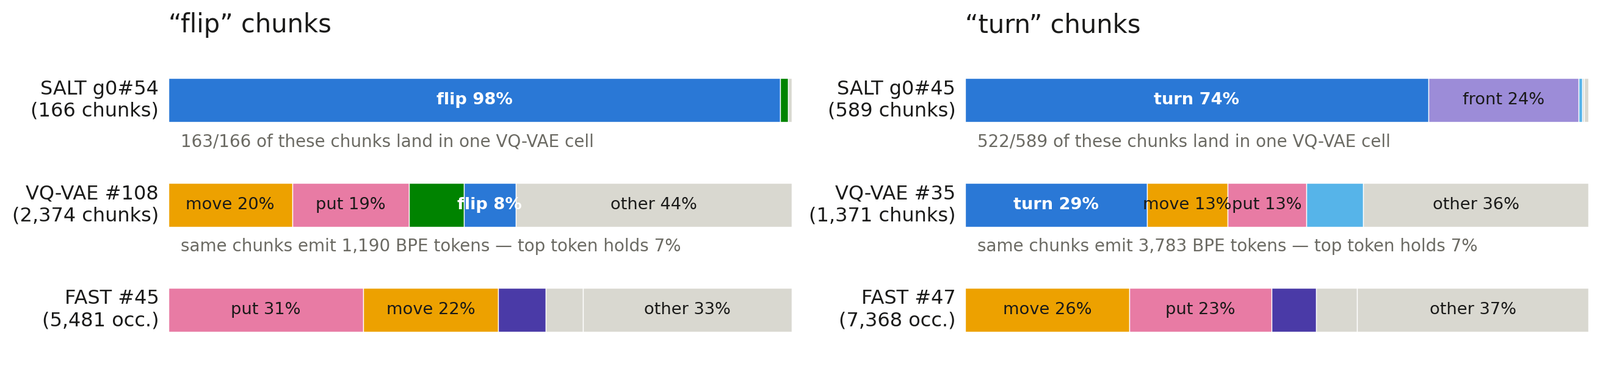
如上图展示的典型案例:
-
当面对 flip(翻转)这一高度依赖旋转力矩与末端姿态变化的复杂动作时,SALT 几乎将该动作的所有片段分配到了一个专属的代码(Dedicated Code)中。而传统的 VQ-VAE 则把这些片段揉杂进了一个充斥着各种无关动作的“通用混合单元”;FAST 更是将其离散碎片化地甩到了数十个无规律的 Token 里。
-
在 turn(旋转/扭转)动作上,现象更为深刻。SALT 分配给 turn 的专用代码中,除了绝大多数纯粹标注为 turn 的轨迹外,还稳定捕获了一批文字标注为 “lever vertical to front”(将拉杆垂直扳向前方)的轨迹。虽然表面文本完全没有出现“turn”这个词,但两者在物理动作上是完全等效的扳动操作。这证明 SALT 习得的表征捕捉的是深层动作语义,而非单纯的表面词汇匹配。
这种无需显式指定动词标签、单纯靠 VLM 生成指令自然催生的“动词专用码元”,从根本上解释了下游策略在复杂指令控制下的稳健表现:对策略而言,语言指令与底层动作 Token 之间建立起了清晰、正交的语义射影,消除了大量的多义性混淆。
总结与具身智能的新启示
长期以来,具身多模态模型的研究重心主要偏向感知侧——人们花费巨大的算力让视觉编码器理解几何拓扑与语义属性,却默许动作生成端停留在一个没有语言灵魂的纯数值物理空间。这种“单向对齐”使得模型虽然具备聪明的“眼睛”和强大的“大脑”,却连着一双无法理解词义逻辑的“机械手”。
卡耐基梅隆大学的这项工作用扎实的理论分解与极其亮眼的实验数据(成功率自 42.7% 提升至 71.9%)证明:机械臂轨迹本身就是具身语言落地的关键承载体,动作分词绝不能仅仅是一场针对欧氏坐标的冷酷有损压缩。
SALT 的核心突破,在于证明了“保持物理执行精度”与“融入语言语义拓扑”不仅不冲突,反而能够相互增强。通过一个在预训练后即可抛弃的轻量级语言监督环节,动作分词器得以生成兼具物理可执行性与语言抽象能力的离散码本。对于未来追求更大规模、更强泛化能力的通用机器人大模型(VLA)而言,这种将动作与语言深度咬合的设计原则,极有可能成为具身智能底层架构演进的标准范式。