LT-Mem:三层时空记忆打破机器人时间遗忘,Token消耗降低一个量级
LT-Mem: Volatility-Aware Spatio-Temporal Memory for Lifelong Scene Understanding
当移动机器人在同一个物理空间中执行长达数周、数月的日常巡检或管家任务时,它往往面临一个看似简单却极难解决的认知困境:昨天被挪开的椅子、上周被收进柜子的工具箱、或者在屋里四处走动的机器狗,在机器人的脑海中究竟留下了什么?
ArXiv URL:https://arxiv.org/abs/2608.19059v1
在现有的长期建图(Lifelong Mapping)与具身记忆(Embodied Scene Memory)体系中,系统的行为往往走向两个极端。一类系统致力于维护一张绝对准确的“当前全局地图”,一旦检测到物体位置发生变化,便通过状态覆盖或点云修剪抹去旧的观测;另一类系统则走向堆砌,将每次巡检记录的大量单帧图像或视点特征一股脑存入向量数据库,但在多次任务重访之间缺乏对物体物理实体身份的显式对齐与追踪。这两种策略共同导致了机器人认知层面的“时间遗忘症”(Temporal Amnesia)——系统不仅无法回答“过去十次巡检中,绿色转椅都去过哪些地方”,甚至连“这台机器狗总共移动过多少次”这种包含时序聚合信息的查询都无从下手。
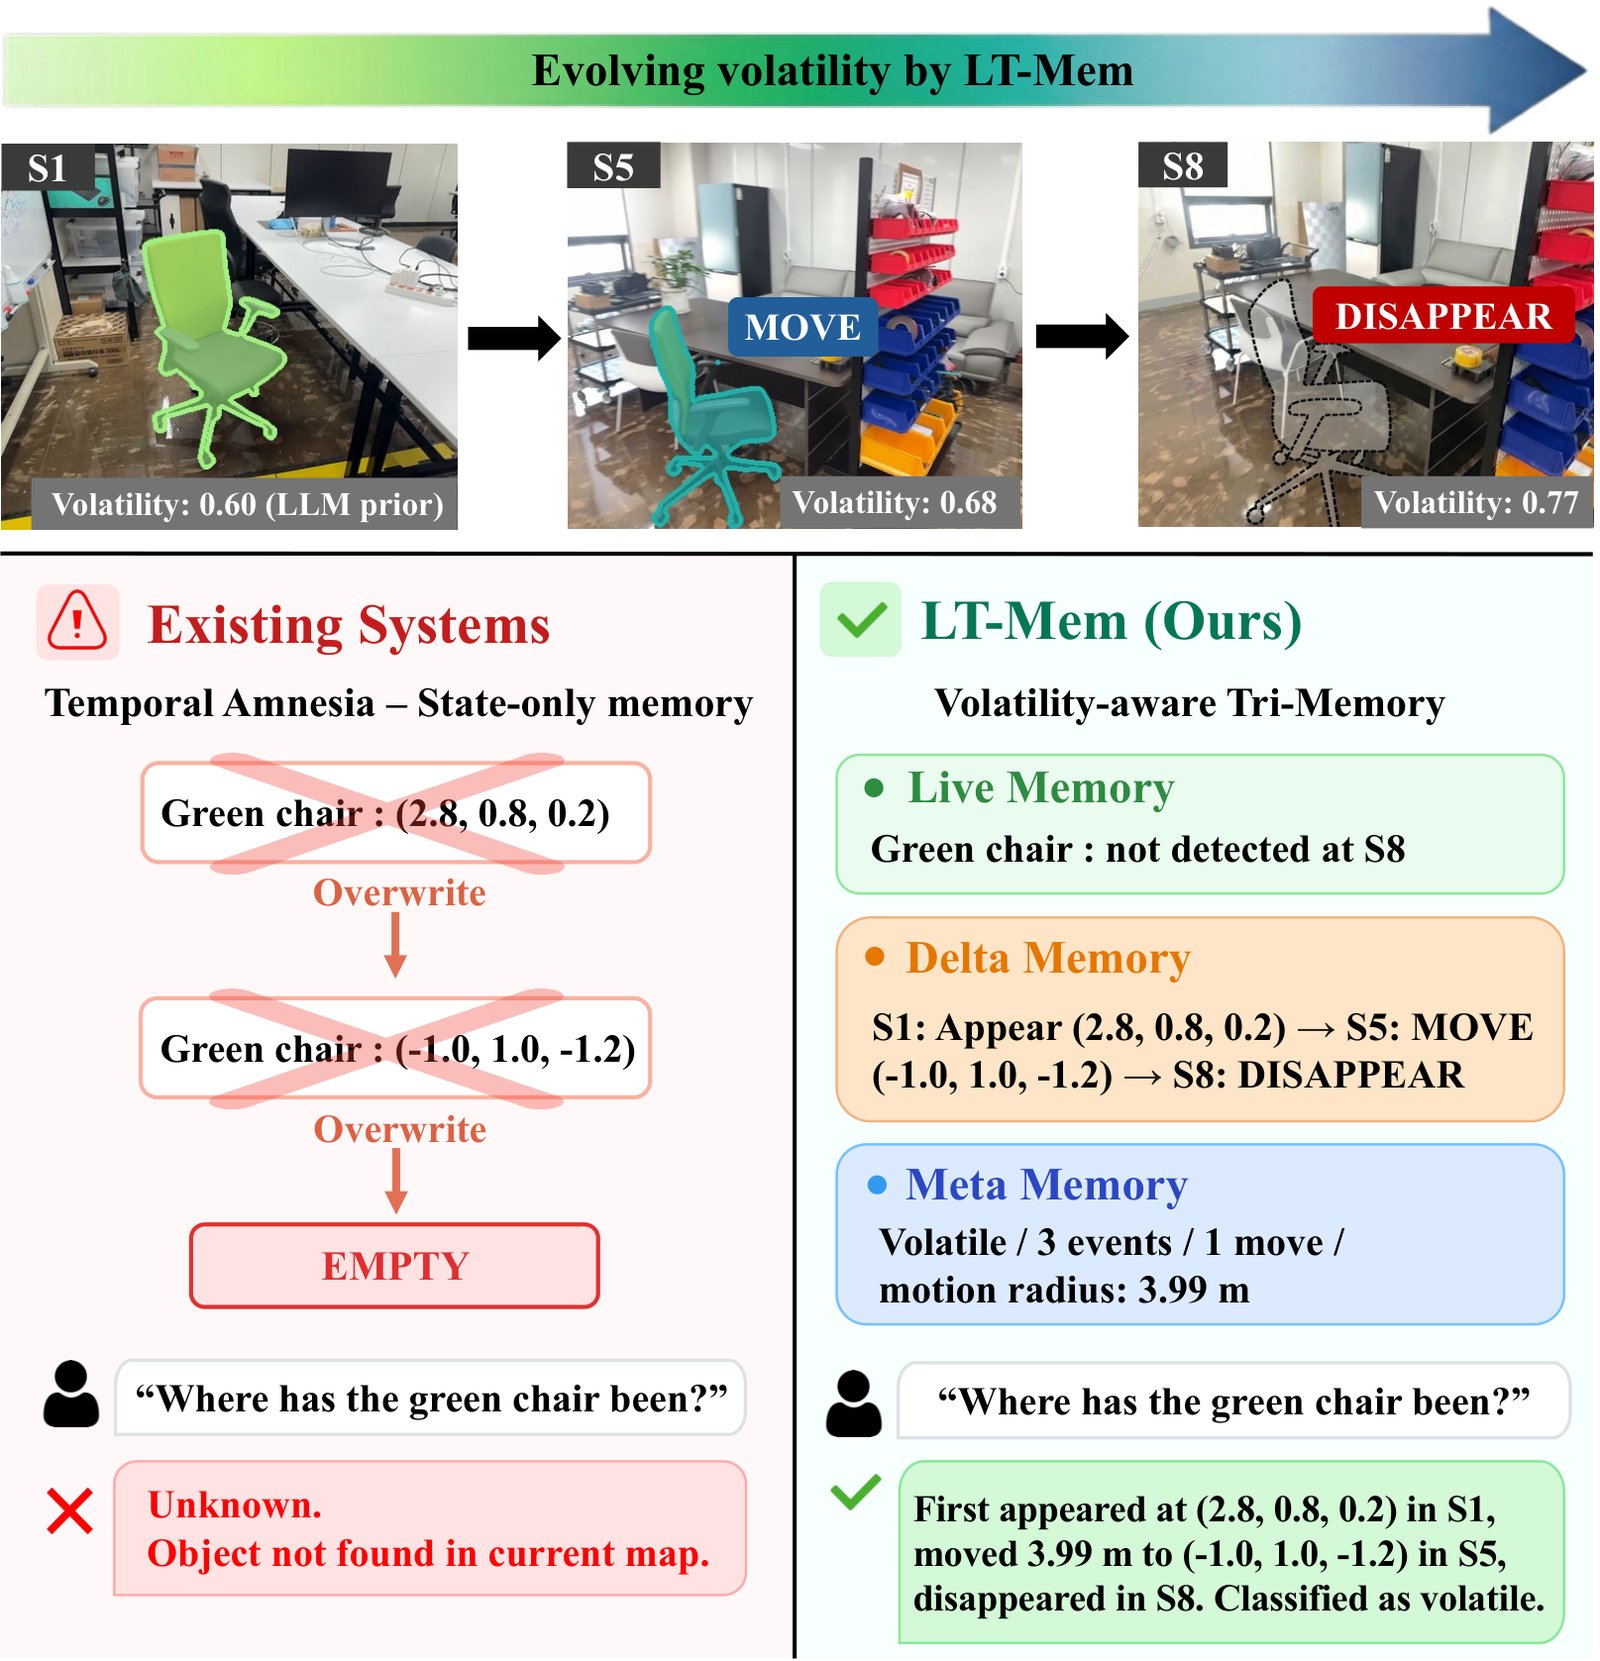
韩国大邱庆北科学技术院(DGIST)的研究团队针对这一长期未解的痛点,提出了名为 LT-Mem 的易变性自适应时空记忆演进框架。该框架不把环境中的所有实体视为静态背景,也不对其进行无差别的纯文本历史流水账记录,而是建立在多会话统一几何对齐的基础上,引入“物体易变性”(Volatility)这一先验动力学评分,驱动一套包含覆盖(Overwrite)、保持(Hold)与多重假设(Multi-hypothesis)的自适应更新策略。这一推理过程沉淀为三种相互解耦又紧密配合的记忆结构——实时记忆(Live Memory)、增量事件记忆(Delta Memory)与元统计记忆(Meta Memory)。
实验结果显示,LT-Mem 在长程时空问答与时序事件追踪任务上显著压制了现存各类基准方案,不仅在事件追踪 $F_1$ 分数与结构化问答准确率上取得大幅领先,更将基于大语言模型(LLM)与大视觉语言模型(VLM)进行历史推导所需的 Token 消耗缩减至原本的十分之一左右。消融实验进一步证实,这种性能飞跃源自物理世界时空记忆结构的合理组织,而非单纯依赖底层基座模型的参数规模。
机器人为何会患上“时间遗忘症”?
传统移动机器人的长期自主导航极度依赖空间一致性。早期的建图框架如 LT-mapper 等,其核心任务是在多次重访中发现地图与当前传感器读数的几何冲突,并以“纠错”的思路将陈旧或发生位移的点云直接剔除。即便近期的先进稠密时空混合语义地图(如 Khronos)能够融合短时动态与长程场景演变,其底层仍未对单个物体的物理实体身份(Identity)建立跨会话的事件化日志。一旦某个物体从位置 A 移动到位置 B,过去的物理状态便从地图表征中被永久抹去,以便为最新状态腾出空间。
与几何地图路线并行的,是近年来基于多模态大模型的语义场景记忆研究。以 ReMEmbR 为代表的视点级(View-based)检索系统选择保留机器人巡检过程中的大量原始多模态观测,并在回答提问时通过 RAG(检索增强生成)机制将相似片段提取给 LLM 分析。这类方案虽然保留了历史,却缺失了最关键的跨会话数据关联(Data Association):机器人上一周看到的“一把木椅”和今天看到的“一把木椅”,在语义检索层面可能高度相似,系统却无法断定它们是否为同一个物理实体在时空中的迁移。
更重要的是,若缺乏底层的多会话全局几何对齐与结构化时序组织,单纯把多模态历史帧作为上下文抛给长文本模型,会遭遇严重的推理开销与上下文膨胀问题。机器人在经历多次长周期巡检后,观测数据呈指数级累积,而多模态模型的上下文窗口极其昂贵,且极易在海量弱相关图像碎片中产生幻觉,无法准确完成“位移距离测量”或“转移频次统计”这类需要精确度量计算的时序任务。
因此,长期空间理解的真正瓶颈不在于感知模型能否切出物体,而在于如何跨越感知与推理之间的结构断层——如何用确定性的多会话几何约束支撑跨时空实体对齐,以及如何根据物理世界中不同物体的动力学特性决定记忆的沉淀形式。
感知对齐:从多会话 SLAM 到实例三维提升
要记录物体的时序迁移,首要前提是将横跨数天乃至数周的多轮独立映射任务统一到同一个全局空间参考系下。如果坐标系本身存在米级漂移或尺度不一致,后续所有的“位移检测”都将失去物理意义。
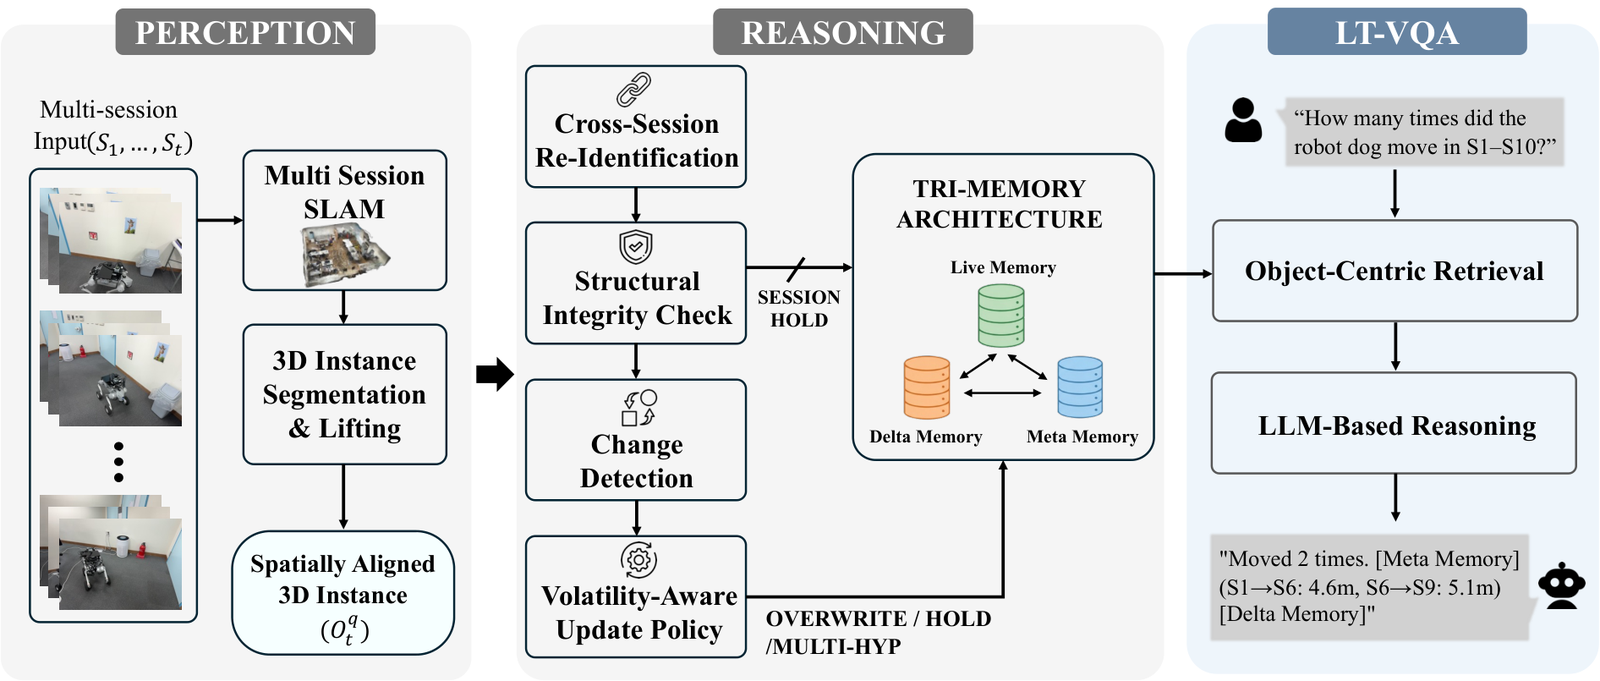
LT-Mem 的感知底层建立在多会话视觉 SLAM 之上。系统采用 MASt3R-SLAM 作为单次巡检的位姿估计与稠密建图基座,同时引入 MR.ScaleMaster 的多尺度全局对齐思想,利用 $\mathrm{Sim}(3)$ 锚点节点(Anchor Nodes)来对齐独立会话。在每次会话 $S_t$ 中,关键帧位姿在局部参考系下表示为 $X_i^t \in \mathrm{Sim}(3)$,而锚点节点 $A^t \in \mathrm{Sim}(3)$ 则负责将局部坐标变换映射至全局世界坐标系,从而保证任意第 $i$ 帧在全局世界系下的位姿可精确表达为:
\[T_i^t = A^t \cdot X_i^t\]为了实现跨会话的绝对闭环,系统在会话之间对关键帧图像执行 MASt3R 特征匹配,通过基于射线的几何优化求解会话间的相对 $\mathrm{Sim}(3)$ 空间变换约束。由会话内部的里程计边和跨会话的闭环边共同构成非线性因子图,并在后端通过 g2o 进行联合全局优化。这套流程确保了多次巡检构建的庞大点云能够精准咬合在米级绝对一致的坐标系统之中。
在统一的几何骨架之上,感知模块在每个关键帧运行通用实例分割模型 SAM3,通过文本提示词精准提取物体二维掩码。得益于稠密点图与精确位姿的投影关系,这些二维掩码被无损提升至三维世界坐标系中,生成实例级的三维点云聚类。最终,在单次会话 $S_t$ 内部,系统将属于同一物体的碎片化局部观测进行空间一致性合并与点云聚类,输出规范化的三维物体观测元组:
\[o_t^q = (\mathbf{c}_t^q,\; v_t^q,\; \mathbf{f}_t^q)\]其中 $\mathbf{c}_t^q \in \mathbb{R}^3$ 为该物体的三维几何质心,$v_t^q$ 为三维包围体体积,而 $\mathbf{f}_t^q$ 则是提取自对应区域的紧凑视觉嵌入特征。这意味着,进入后续认知推理层的输入,不再是冗长无序的视频流,而是经过几何度量提纯的规范化三维实体。
易变性自适应推理:动态更新策略的核心机制
当机器人开启第 $t$ 次巡检并识别出空间中的物体时,推理层必须做出决策:当前看到的物体究竟是此前记录中的哪一个?如果它换了位置,系统应该直接修改当前坐标,还是将其保留为一条历史迁移记录?如果它突然看不到了,是被彻底搬离,还是仅仅由于当前视角的遮挡?
针对跨会话重识别(Cross-Session Re-Identification),LT-Mem 抛弃了仅靠空间就近匹配的脆弱逻辑,而是设计了一套五维归一化确定性证据评分体系($E_1$ 至 $E_5$)。这五项证据涵盖了三维欧式几何距离、语义标签一致性、三维体积形变程度、视觉嵌入余弦相似度以及局部空间拓扑邻域约束。综合重识别置信度由这五项证据加权求和得出:
\[\text{Score} = \sum_{i=1}^5 w_i E_i, \quad \text{其中} \sum_{i=1}^5 w_i = 1\]在实验设定的权重组合中,视觉特征嵌入权重($w_3 = 0.45$)与几何语义约束占据主导地位,使得即便物体发生大幅度位移,系统仍能凭借高维外观表征与语义先验将其重新锚定到历史轨迹上。
在对记忆库执行任何写操作之前,系统会执行严格的“结构完整性检查”(Structural Integrity Check)。在实际环境中,由于光照剧变或特征缺失,个别会话可能发生局部定位降级。LT-Mem 通过比对当前会话中观测到的静态背景锚点质心与实时记忆中的预存基准位置,计算平均锚点漂移量 $\bar{d}{\text{anchor}}$。一旦 $\bar{d}{\text{anchor}}$ 超过容忍阈值 $\tau_{\text{align}}$(实验设为 0.3 米),系统将立刻触发“会话级挂起”(Session Hold):放弃本轮巡检产生的所有记忆覆写,仅仅写入一条定位异常日志。这种机制构筑了一道安全防火墙,阻断了传感器误差向长期记忆库的连锁污染。
通过完整性检查后,系统进入状态转移与易变性更新阶段。物理世界中的物体有着天然的运动倾向差异:冰箱、沙发几乎常年静止;而剪刀、咖啡杯和扫地机器人则频繁移动。如果使用固定的距离阈值来判定物体是否发生位移,要么会对易动小件产生漏检,要么会对静止大件产生频繁的假阳性漂移记录。
LT-Mem 为每个物体维持一个处于 $[0, 1]$ 区间内的易变性得分 $V_t$。该分值的演化基于严格的贝叶斯证据累积规则:
\[V_t = \frac{P(E_t \mid V_{t-1})\, V_{t-1}}{P(E_t \mid V_{t-1})\, V_{t-1} + P(E_t \mid 1 - V_{t-1})(1 - V_{t-1})}\]其中 $E_t$ 代表当前会话中该物体是否发生位移的观测证据。只要物体表现出持续静止,$V_t$ 便会快速衰减;而只要物体发生迁移,$V_t$ 就会迅速上升。
在执行记忆更新时,易变性得分直接控制着位移容忍阈值与假设生成策略:
-
高置信覆盖与保持:对于易变性极低(趋于完全静止)的物体,系统赋予其极窄的容差空间;而一旦发生大尺度物理搬运且旧位置确认变空,系统触发覆写动作更新当前坐标,并在事件日志中追加移动记录。
-
多重假设维持(Multi-hypothesis):当遇到观测证据不充分(例如在某一未知位置检测到高度相似物体,但旧位置未被充分视野覆盖)或物体易变性处于临界状态时,系统不急于做破坏性改写,而是分叉出多个位置候选状态并维持各自的置信度分支。当连续多个会话在某一主导位置积累了足够的显著优势差 $\Delta$ 时,系统才会执行假设合并(Consolidation),将次要分支剪除并提交最终事件。
Tri-Memory 架构:解耦当前状态、时序事件与统计规律
多会话巡检产生的输出信息在物理本质上是异构的:机器人既需要知道“这个物体现在在哪”,又需要回忆“它过去五次会话经历了什么”,还需要掌握“它在统计意义上容不容易被挪动”。如果将所有信息混杂在一个单层地图或纯文本库中,不可避免地会再次诱发信息覆灭或检索混乱。
因此,LT-Mem 在后端自然沉淀出 Tri-Memory(三层时空记忆)架构,将推理输出规范化为三类功能明确的子结构:
-
实时记忆(Live Memory):只追踪当前环境的最新全局确信状态。它记录每个存活实体的当前三维质心坐标 $\mathbf{c}_t^q$、包围盒体积、最新外观嵌入以及活跃假设。它的核心职责是服务于机器人当前的实时避障、操作定位与空间导航。
-
增量事件记忆(Delta Memory):以显式时间戳和物体唯一身份 ID 为索引的结构化离散事件日志。每当实体经历出现(Appear)、消失(Disappear)、移动(Move)或重现(Re-appear)时,该层便会生成一条具有公制空间上下文(如起点坐标、终点坐标、三维欧式位移数值)的事件记录。
-
元统计记忆(Meta Memory):提取自 Delta Memory 长期累积模式的高阶特征库。它不记录细碎轨迹,而是记录实体的行为画像——例如动态收敛后的易变性分值 $V_t$、平均搬动频率、常驻区域热点分布,以及整个场景在不同时间段的占用率统计。
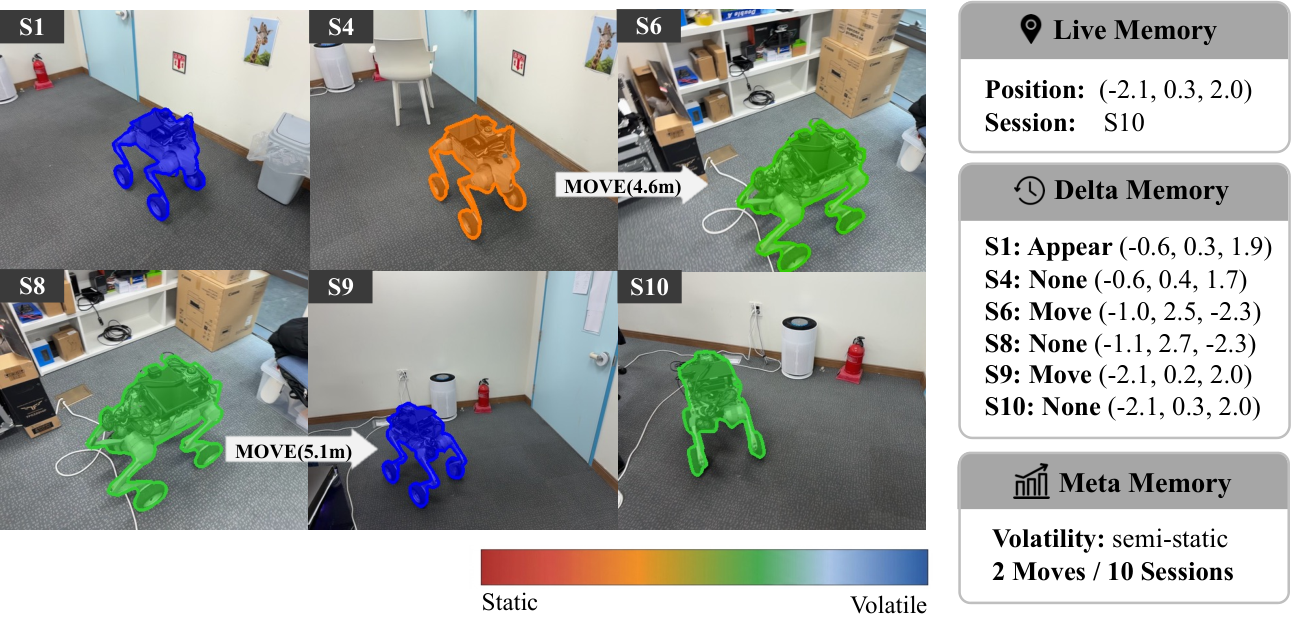
在上图所示的 Lab-S 场景示例中,机器狗在 10 次巡检中展现了生动的记忆演化。随着会话推进,其易变性得分 $V_t$(通过色彩冷暖表示)动态起伏:在发生两次大尺度位移(第 6 会话和第 9 会话)时,系统在 Delta Memory 中分别提交了两次明确的移动事件,并附带了精确的三维空间位移矢量。而在第 4、第 8 和第 10 会话期间,由于微小的姿态波动处于易变性自适应的位移容差内部,系统将其判定为静止并记录为无事件(None),从而避免了噪声累积。到第 10 会话结束时,Live Memory 记录着机器狗的最终精准坐标,而 Meta Memory 则将其归类为半静态实体(Semi-static)。
在下游问答检索阶段,系统利用基于轻量级检索模型(BGE-small-en-v1.5 + ChromaDB)构建的物体级路由机制,完全无需让 LLM 介入检索过程。当用户询问“白椅子现在在什么位置?”时,路由器直接命中 Live Memory;当询问“机器狗一共换过几次位置?”时,路由器从 Delta Memory 提取结构化条目并进行确定性计数运算;而当询问“这间办公室哪个区域物体最常被挪动?”时,查询则直接流向 Meta Memory。对于空间位移距离、发生频次等度量型问题,全部通过在事件日志上执行确定性数值计算直接给出,在根源上杜绝了大模型的数值幻觉。
实验与基准:LT-VQA 数据集上的全面对决
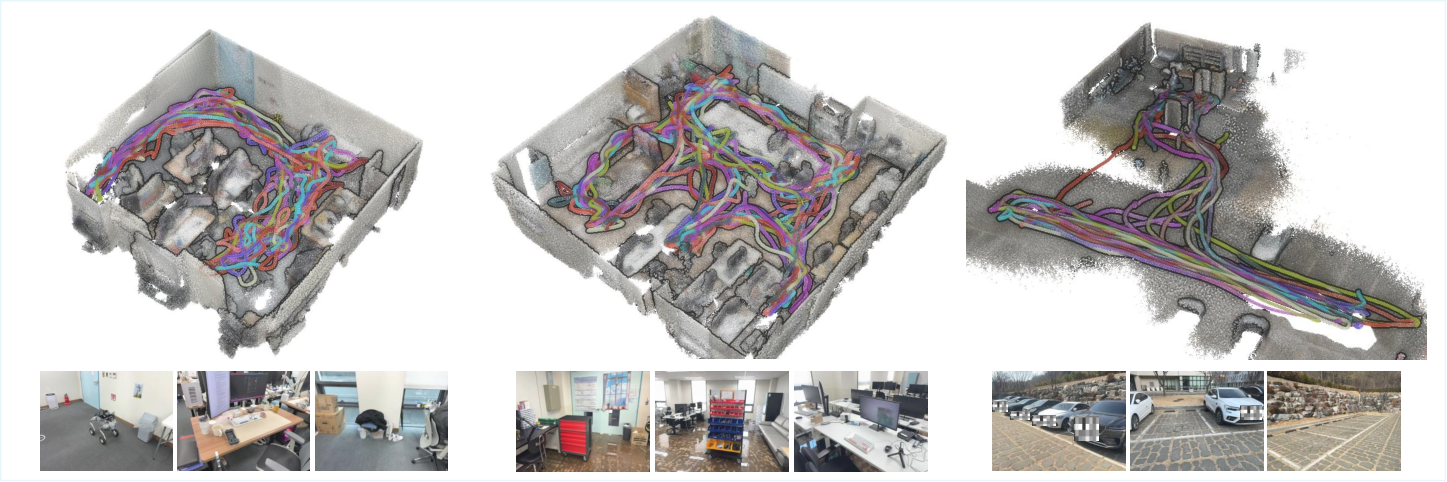
为了科学评估具身系统在长周期动态场景下的记忆表征能力,现有的数据集存在明显的短板。例如 3RScan 虽然提供了环境重扫描的实例级对应关系,但缺乏跨会话的离散事件标注以及细粒度的时序问答数据。DGIST 团队专门构建了 LT-VQA 评估基准,覆盖了两个复杂的室内环境(Lab-S 与 Lab-L,各追踪 10 个跨 10 次会话频繁变化的实体)以及一个多天、多时段采样的室外大场景(Parking Lot)。
评估任务被划分为两大核心维度:实例历史追踪(Instance History Tracking)与宏观空间统计(Spatial Statistics)。前者关注跨会话的物体级状态判别,评估指标包含事件分类 $F_1$ 分数、精确匹配问答准确率(QA-Exact)以及时序数值问答准确率;后者则关注区域级的宏观演进趋势分析。
在与纯几何差分基准(Geometry-only)、批量文本字幕检索(Text-Batch)、全模态视觉语言基准(VLM-Batch)以及前沿长程推理智能体 STAR 的横向评测中,LT-Mem 展现出了压倒性的优势:
纯几何基准依靠刚性距离阈值虽然能够检测出部分位移(获得适度的 Event $F_1$),但由于内部没有实体身份的事件日志,面对任何需要时序跨度理解的问答(如“移动了多少次”)全部输出 N/A,完美印证了时间遗忘症的本质。基于纯文本字幕的方法(Text-Batch)由于缺乏精确的三维几何空间锚定,在面对具有复杂干扰物的室内场景时彻底失真,准确率跌落至极低水平。
多模态批处理方案(VLM-Batch)在输入极度冗余的视觉信息后虽然能够回答部分问题,但代价是极其沉重的 Token 开销——其完成单轮评测所需的上下文开销比 LT-Mem 高出一个数量级。更具有讽刺意味的是前沿检索智能体 STAR:由于它在未建立底层实体身份对齐的前提下,在海量原始多模态历史中进行启发式 RAG 搜索,缺乏对跨会话事件的结构化规约能力,其不仅 Token 消耗量攀升至顶峰,还在事件追踪指标上录得惨淡成绩,对于需要严格次数统计的频次查询同样无法给出可信答案。
反观 LT-Mem,其不仅在所有时序事件识别与长程问答指标上拔得头筹,而且在推理过程中几乎只将高度凝练的结构化记忆片段作为 Prompt 输入给 Gemini 2.5 Pro,以极低的 Token 消耗完成了更高精度的推理闭环。
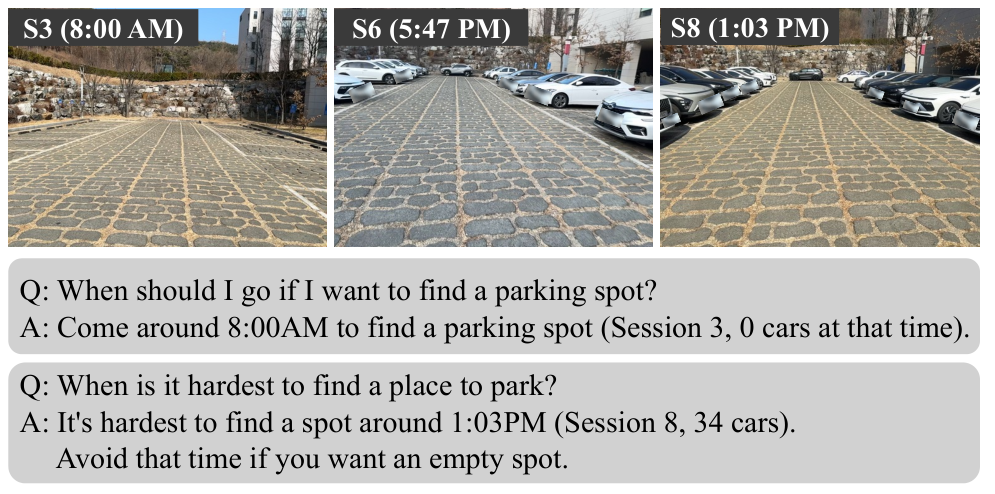
在宏观空间统计维度,停车场序列的评测呈现了另一种截然不同的长程理解形态。如图所示,系统关注的不再是某一辆具体汽车的轨迹,而是通过 Meta Memory 自动聚合每一轮会话中不同车位的被占用概率与车辆总体密度。当人类发出“如果我想找车位,应该几点去?”或者“什么时候找车位最困难?”这种高级决策咨询时,系统直接调取 Meta Memory 中预先固化的泊位时空占用曲线进行极值索引,无需在长视频序列中重复消耗任何复杂的视觉推理。
消融实验进一步验证了系统各模块设计的必要性:
-
当移除跨会话重识别模块(w/o Re-ID),让系统将每次重访检测到的物体赋予全新的独立身份时,下游所有时序评测指标遭遇断崖式崩塌。这证明,持久且一致的物理身份关联是长程时间理解不可动摇的基石;没有对齐,后续的 Delta 与 Meta 记忆便成了无源之水。
-
当移除了易变性自适应机制(w/o Volatility),退回至使用全局固定阈值更新状态时,由于无法平衡不同物体的动力学特异性,系统不可避免地生成了大量的虚假位移事件,直接造成 Delta Memory 垃圾信息泛滥,进而显著拉低了 Meta Memory 的统计质量与问答精度。
总结与具身长程记忆的演进路径
LT-Mem 的技术突破,本质上是对具身智能“长期记忆应当如何存在”这一根本问题的一次重新反思。长期以来,学术界容易产生一种倾向,即希望单纯依靠多模态大模型的长上下文窗口去硬抗物理世界的时空复杂度,或者依赖传统的 SLAM 地图去不断抹去历史以维持单一的当前视图。
这项工作用详实的系统工程和实验数据证明:物理世界中的时间是具有结构的,机器人的记忆也必须具有结构。通过将精密的跨会话三维几何建图作为底层地基,依托贝叶斯动力学推导将物体的物理易变性引入更新逻辑,最终沉淀出 Live、Delta 与 Meta 互相解耦的三层空间记忆,系统不仅成功根除了长久以来困扰自主机器人的“时间遗忘症”,更探索出了一条兼具高精度、强可解释性与极高 Token 运行效率的具身长程认知范式。
尽管当空间中存在大量外观近乎完全孪生、局部拓扑高度对称的物体时,跨会话实体对齐依然面临严峻挑战,但 LT-Mem 所展示的这种“几何对齐筑基、动力学策略调谐、分层事件日志沉淀”的技术架构,无疑为未来巡检机器人、家用具身管家乃至大型数字孪生系统迈向数月甚至数年周期的真正自主认知,指明了极具实用价值的方向。