Macaron-V1:用MoL架构冻结744B基座,模型存储降低74%
Macaron-V1: Towards Open Continual Learning with Self-Improvement and Mixture-of-LoRA
在大模型技术从通用预训练全面转向后训练(Post-training)的今天,智能体(Agent)所面临的真正瓶颈正在迅速转移。很多团队发现,单纯把代码生成、工具调用、复杂多轮对话与界面交互等异构任务塞进同一个检查点进行端到端对齐,往往会引发严重的参数竞争与多任务干扰。更严峻的挑战在于,传统模式将模型视作发布即固化的静态工件,一旦脱离训练环境部署到真实世界,面对不断涌现的新工具、新接口和个性化交互,模型很难将运行中的经验转化为持续的系统迭代。
ArXiv URL:https://arxiv.org/abs/2608.09819v1
针对这一困境,AI 研究机构 Mind Lab 正式发布了开源智能体模型家族 Macaron-V1。Macaron-V1 放弃了将全部能力融为一体的传统单体后训练路线,确立了以“经验智能”(Experiential Intelligence)为核心的演进目标:让模型能够在真实环境中积累经验,并在部署后实现持续学习。为了在系统工程上支撑这一目标,Macaron-V1 提出了 Mixture-of-LoRA(MoL)架构,将一个超大规模基座模型完全冻结,在其上挂载并动态调度多个领域专精的 LoRA 适配器。其旗舰版本 Macaron-V1-Venti 基于 744B 参数的 GLM-5.2 基座构建,配合四个分别针对对话、智能体工具、代码与动态界面生成的 LoRA 适配器,不仅在各类智能体与个人助理基准上展现出顶尖能力,更在系统部署层面实现了多专精模型合并部署相比独立部署减少 74.0% 存储开销的巨大飞跃。
放弃单体合并:能力扩展的三种路径
要理解 Macaron-V1 的设计初衷,必须先审视当前扩展模型能力的主流技术路线。在构建具备复合技能的 Agent 时,业界通常面临三种不同的架构取舍。
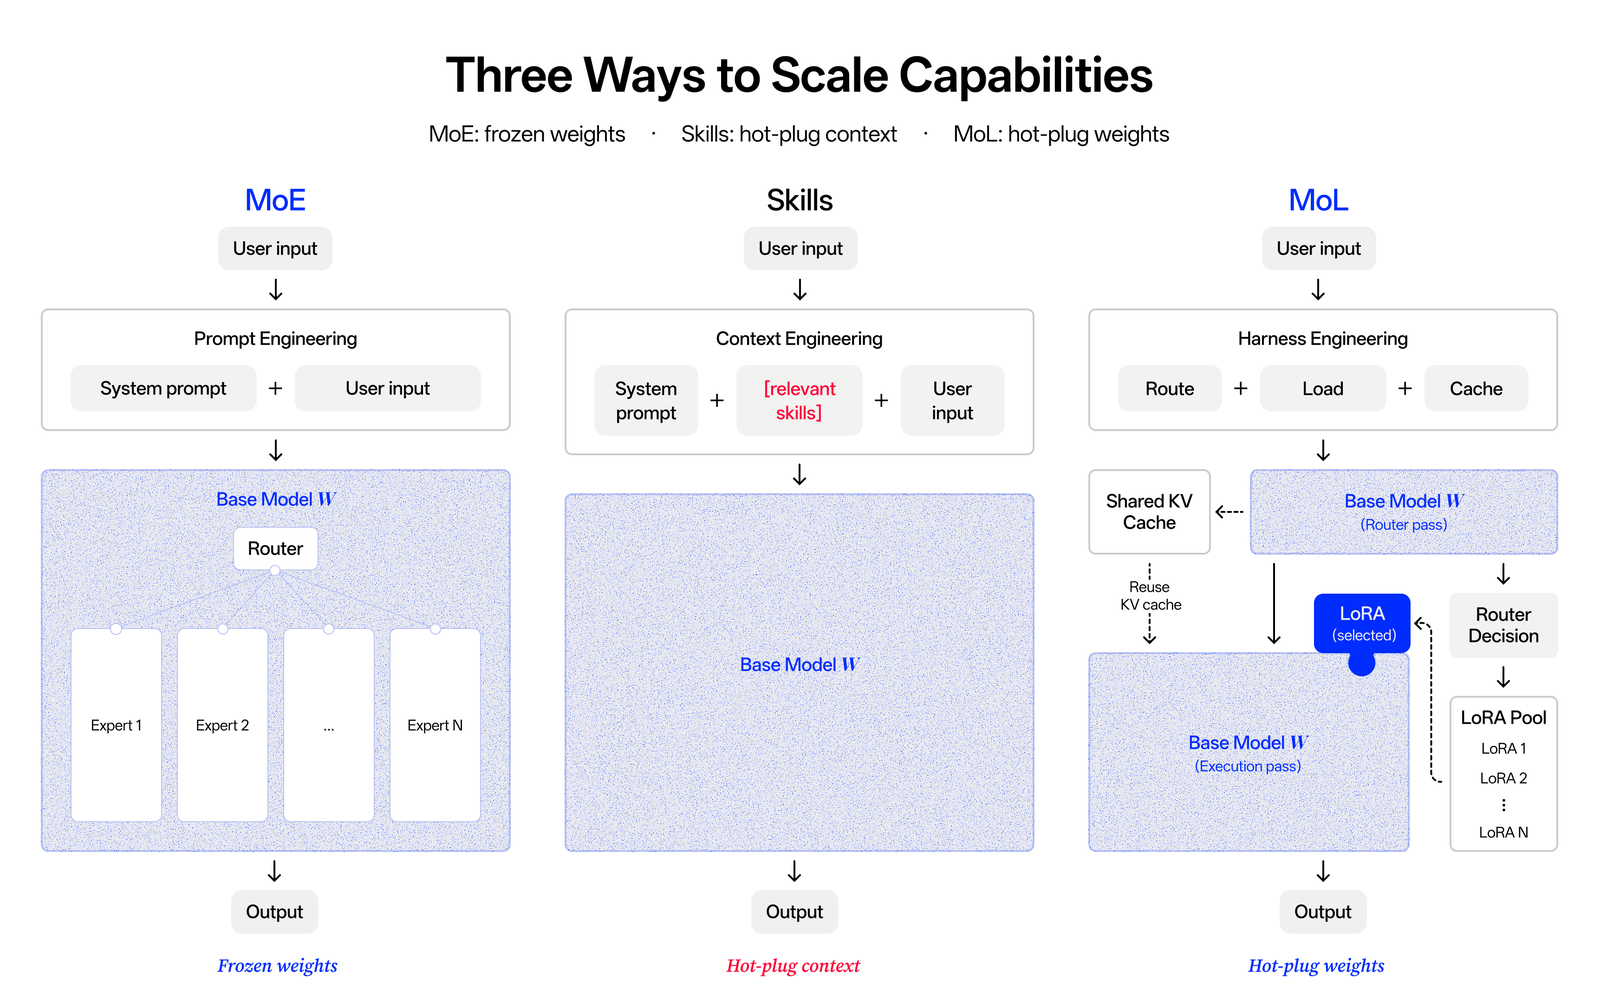
如上图所示,第一种路径是混合专家系统(MoE),它直接在底层修改预训练基座结构,在模型内部的 FFN 层引入稀疏路由。这种做法扩展的是基座本身的容量,但改动极深,且一旦预训练完成,模型的结构就被焊死,很难在部署后为新能力单独做轻量化解耦演进。第二种路径是脚手架扩展(Skills / Scaffolding),模型权重保持完全不动,仅依靠外部工程框架拼接提示词、外部工作流与工具链。这种方案虽然灵活,但模型内部认知并没有针对特定交互深度特化,常常受制于上下文窗口长度与推理调用的脆弱性。
Macaron-V1 所确立的 Mixture-of-LoRA(MoL)则开辟了第三种路径。它的核心逻辑是“编排优于合并”(Orchestration over Merging):基座模型保持绝对冻结,上方挂载一组专精的 LoRA 适配器,通过一个中介代理层(MoL Proxy)在推理时依据用户每轮交互动态调度单适配器介入。
这种架构的直观优势在于消除了异构任务间的梯度干扰。当一个模型需要同时处理需要极其严谨形式化推理的代码编写、需要柔性共情的人格化多轮对话,以及需要严格遵循 JSON Schema 的工具调用时,强行在同一组全量参数中进行强化学习极其容易导致能力退化。将专精能力拆分进独立的 LoRA 模块,既保护了超大基座沉淀的通识推理基础,又赋予了各个垂直领域独立快速迭代、分别做强化学习对齐的自由度。
Macaron-V1 家族:从 748B 旗舰到 50B 端侧部署
在具体实现上,Macaron-V1 并不是一个孤立的模型检查点,而是一个具有统一架构范式的模型家族。旗舰版本 Macaron-V1-Venti 选用了 744B 参数规模的 GLM-5.2 作为冻结基座,在上层部署了四个专精 LoRA(分别记为 L0、L1、L2、L3):
-
L0 (Chat):负责日常高情商对话、交互引导,同时兼任系统的入口路由决策器;
-
L1 (Agent):负责环境感知、工具规划与执行,吸收了此前预览版中专门的自动化工具适配器能力;
-
L2 (Coding):专注于代码补全、重构、调试与 REPL 环境下的复杂程序交互;
-
L3 (GenUI):负责组件级原生动态界面生成(UI4A),驱动用户交互界面的实时渲染与重组。
在权重规格上,Macaron-V1-Venti 的四个适配器均采用 Rank 16、LoRA Alpha 32 配置,针对 Attention 与 MLP 模块进行参数注入,每个 LoRA 独立包含约 76.9 亿个存储参数值。对外公布的 748B 标签正是源于基座与适配器规模的工程命名。除了顶配的 Venti 之外,该家族还提供面向本地与私有化部署的 Macaron-V1-Tall,它基于 Qwen3.6-35B-A3B 基座打造,适配器采用 Rank 64、LoRA Alpha 128 设计,整体有效逻辑参数量约为 50.1B。无论尺寸大小,二者严格共享相同的路由范式与交互契约。
在多专精模型的传统工程部署中,如果不进行模型合并,通常的做法是为每个专业领域单独部署一份完整的模型实例,即复制四份 744B 基座并分别合入 LoRA。这会导致存储和显存占用膨胀至接近 2.98 万亿参数(2.976T)。MoL 架构通过完全共享底层 744B 显存驻留,仅在运行时并发维护四个专精 LoRA(合计约 30.8B 适配器参数),使整体逻辑存储需求压缩至 774.8B,一举砍掉了 74.0% 的存储占用。这使得在集群中利用有限的高带宽显存留出大量空间给超长上下文的 KV Cache 与高并发吞吐成为可能。
自身即路由:99.12% 精准度的极简决策环
引入多适配器后,系统首当其冲的问题就是:如何确定当前对话轮次应该交给哪一个 LoRA 执行?许多早期混合系统倾向于在最外层额外训练一个轻量级的小型分类模型,或者依赖一套庞大且脆弱的关键词规则库。然而,外部小型分类器往往缺乏大模型本身的深度语义理解力,极易在边界模糊的人机交互中做出误判。
Macaron-V1 采取了截然不同的方案:让入口适配器 L0 自己做路由器。
当用户请求抵达 MoL Proxy 时,系统会启动一个结构清晰的三阶段生命周期:路由(Route)、执行(Answer)与总结(Summary)。在第一阶段,系统直接调用处于活跃状态的 L0 适配器,由 L0 阅读用户最新的输入请求,在受限解码语法(Constrained-decoding Grammar)的约束下,直接自回归吐出合法的目标适配器标签(L0-L3)。在这一步中,没有外部模型参与,也没有关键词匹配拦截,做决策的就是通用对话适配器本身的推理能力。
为了防止多轮工具交互被打断,MoL 设计了“工具结果粘性”(Tool-result Stickiness)机制:如果某一轮中选中的适配器(例如 L1 Agent)最终生成了一次工具调用,那么当外部环境执行完毕并返回工具结果时,Proxy 会强制将后续调用锁定在同一个适配器上,直接跳过路由和总结开销。同时,Proxy 维护着事务回滚机制,如果执行中遭遇节点故障或客户端断开,未成功交付的交互状态会被自动剥离,防止污染上下文历史。
评测数据显示,在包含 6448 个样本的诊断追踪集上,L0 自带的路由准确率达到了惊人的 99.12%,且语法合规率为 100%。在混淆矩阵中,错误几乎完全局限在 L0(通用闲聊)与 L1(个人助手与工具)这两类语义极其邻近的边界地带,而代码(L2)和动态 UI(L3)的路由准确率则逼近 100%。
当然,动态路由并非零成本。在 Macaron-V1-Venti 上,通过 24 token 预算约束的 L0 路由决策耗时约 0.54 秒,后续单轮生成完成后的 192 token 压缩总结耗时约 0.97 秒,两者相加产生的系统调度开销约为 1.51 秒,占单轮完整请求平均总耗时(约 4.68 秒)的 32% 左右。在更小尺寸的 Macaron-V1-Tall 上,该开销的绝对时长缩短至 0.52 秒,但整体时间占比依然稳定在 30% 上下。Mind Lab 团队在 Vita 任务上的多随机种子实验表明,相较于无路由的直连单模型,经由 MoL 路由循环后(奖励值 0.650 对比 0.636),任务本身的完成质量不仅未见劣化,反而在统计上体现出极佳的稳定性。这笔调度延迟开销,换来的是模块化解耦与可解释性的巨大工程收益。
独创专属视图:让 KV Cache 复用自然发生
在多适配器共存的复杂对话中,另一个致命痛点是推理引擎的缓存效率。不同 LoRA 适配器如果共享完全相同的上下文历史,不同角色吐出的多轮内部思考过程(Chain-of-Thought)不仅会导致历史窗口急剧膨胀,还会相互干扰各自的注意力机制。更关键的是,如果每轮交互的历史内容不断发生动态拼接,底层推理框架(如 vLLM 或 SGLang)引以为傲的前缀缓存(Prefix Caching)就会频繁失效,导致显卡算力被大量的重复 Prefill 计算榨干。
为了攻克这一难题,Macaron-V1 设计了一套极为精妙的“专属视图”(Own-view)状态构建机制。
在 MoL Proxy 内部,全局维护着一条只增不减(Append-only)的物理时间线。但在把上下文喂给选中的特定 LoRA 时,Proxy 会对消息列表进行确定性重组。重组遵循以下规则:目标 LoRA 在过去轮次中所产生的原始推理轨迹、工具调用及工具返回被原封不动地全量保留;而所有其他 LoRA 在过去轮次中的工作,则被一律折叠为对应轮次生成的那个不超过 192 token 的简短摘要;最后,再拼上用户当前最新的一轮提问。
这种设计带来了两大直接效益:
首先,在认知层面,它实现了“专精隔离与必要协同”。每一个专精 LoRA 都能看到自己此前完整的逻辑推导脉络,不用担心被其他专精模块的冗长推理噪音所误导;同时,它又能借助精炼的系统级摘要,清晰获知其他同事之前干了什么,从而维持整体任务的连贯性。
其次,在底层性能层面,它创造了“确定性前缀复用”。因为全局时间线是严格追加的,当对话再次轮转回某个曾经运行过的 LoRA 时,Proxy 重构出的历史消息前缀与上一次访问该 LoRA 时的前缀字节是完全相同的。这意味着,系统无需对 vLLM 或 SGLang 的显存管理核心做任何侵入性魔改,底层框架原生提供的 Prefix Cache 就能直接命中旧有前缀,引擎只需要对最新追加的几条消息做增量 Prefill。这一机制使跨轮次的高性能 KV Cache 复用成为稳定提示词下自然涌现的技术红利。
基准表现与系统协同设计的工程启示
在验证这一套复杂系统工程的有效性时,论文展示了 Macaron-V1-Venti 面对当前顶尖基线模型时的综合竞争力。
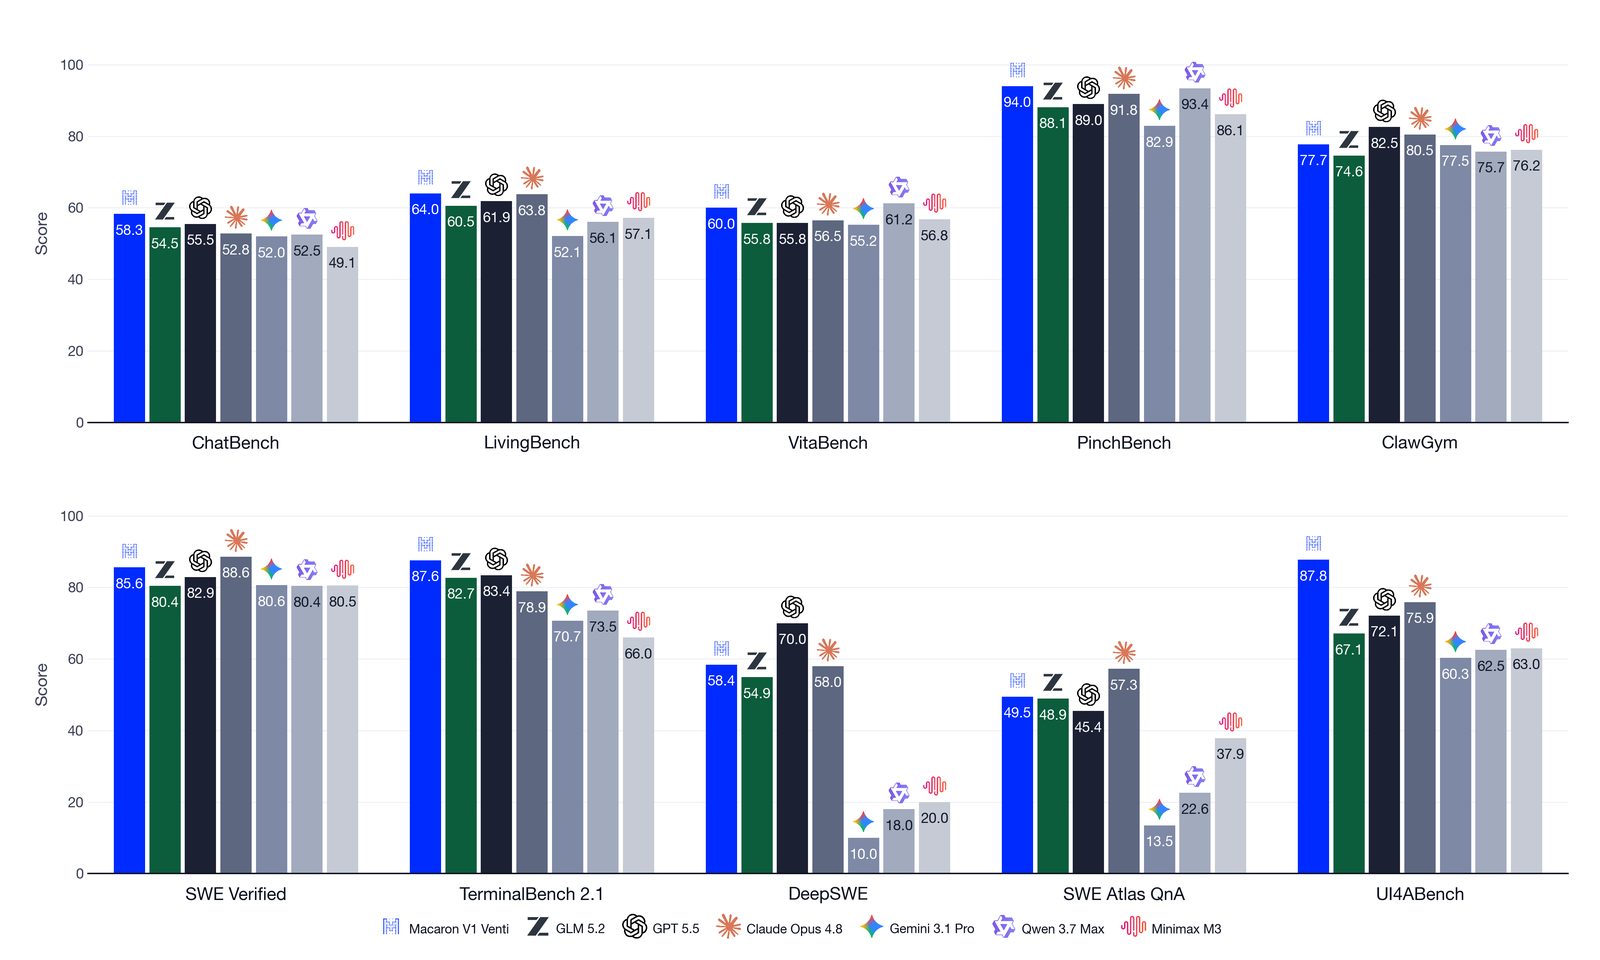
从官方披露的多项基准评估数据来看,Macaron-V1-Venti 在个人智能(Personal Intelligence)专项赛道(包括 Macaron ChatBench 与 LivingBench)、Agent 任务、通用代码编写以及动态界面生成(GenUI)等多个维度,展现出了高度均衡且强悍的性能表现。它不仅超越了大量同尺寸的开源模型基线,在部分垂直 Agent 交互场景中,其综合能力甚至能够对标部分前沿商业闭源系统。
这一表现的背后,并非仅仅依赖模型层面的巧妙,更得益于其贯穿算法与基础设施的“模型-环境协同设计”(Model-Harness Co-design):
-
交互环境的原生解耦:引入了 UI4A 组件级动态界面生成协议与带状态的 REPL 运行基质,配合严格的版本化 Harness Context Protocol(HCP)契约,让模型生成的不再是单纯的文本,而是能够直接与客户端宿主深度绑定的交互指令。
-
长上下文强化学习与训练基底:在后训练基座 MindForge 平台上,团队采用了 LongStraw 长上下文强化学习方案,并攻克了稀疏注意力(Sparse MoE 与 DSA)在超长序列下的梯度不稳定问题,使得模型在 900K 级别的超长上下文场景下,首字生成延迟(TTFT)依然能大幅缩减,确保了极长链条 Agent 推理的鲁棒性。
迈向经验智能与持续进化的开放生态
长期以来,开源社区在与闭源巨头的竞争中,往往受困于算力规模与单体训练预算的差距。Macaron-V1 提供了一种令人兴奋的新思路:不要试图一次性训练一个全知全能的庞大怪物,而是通过优秀的基础设施契约,将模型基座变成一个开放的、即插即用的协同操作系统。
通过 MoL 架构,每一个开发者或研究团队都可以独立维护、演进自己的专业 LoRA,并通过标准的 HCP 契约将其接入生态。模型的每一次部署执行,其成功与失败的轨迹日志都可以精准归因到特定的适配器上,进而通过递归自我改进循环转化为下一代版本的微调数据。这种将参数冻结与局部动态演进相结合的范式,第一次让大模型系统有了真正意义上的“持续学习”与“群体智能”实现地基。
从“训练完即定格”到“在真实环境中经受交互并不断重构演化”,Macaron-V1 的发布不仅是一次系统工程架构的创新,更是通往真正具备适应性与自主进化能力的经验智能体的重要一步。