ModularRSI:拆解五大交互模块,对比轨迹自进化打破Agent泛化瓶颈
ModularRSI: Modular and Generalizable Recursive Harness Self-Improvement
在过去一年多的大模型智能体(Agent)研究中,一个愈发清晰的共识是:决定复杂代码编写和终端任务成败的,往往不仅是底层基础模型(Foundation Model)本身的推理能力,还有包裹在模型外层的运行支撑系统——也就是通常所称的 Agent Harness(运行脚手架)。Harness 负责控制交互循环、组装工具调用指令、截断与过滤环境观察、修剪上下文以及判断任务是否终止。一个设计拙劣的 Harness,哪怕搭配顶尖的基础模型,也容易陷入无限死循环或被超长报错信息吞噬;而一个设计精良的 Harness,能让中等规模的模型展现出惊人的长程任务执行力。
ArXiv URL:https://arxiv.org/abs/2609.14857
顺理成章地,研究界开始探索递归自我改进(Recursive Self-Improvement, RSI)在 Harness 上的应用:让 Agent 在执行终端和编程任务的过程中积累经验,进而自动修改、优化自身的 Harness 代码。然而,现有关于 Harness RSI 的尝试大多停留在“看似很强,实则脆弱”的阶段。近期由北京航空航天大学、河海大学、IQuest Research、澜舟科技、M-A-P 以及曼彻斯特大学等机构联合提出的 ModularRSI,直击了这一领域长期存在的痛点,提出了首个解耦、对比驱动且真正面向泛化能力的 Harness 自进化框架。
该工作表明,盲目让大模型重写整个运行脚本不仅极易造成灾难性过拟合,还会让机制归因变得不可能。通过将 Harness 解构为五大独立进化的功能模块,并基于同任务成功与失败轨迹的对比分析,ModularRSI 在完全未见过的 TerminalBench 2.0 和 SWE-Bench Verified 评测中实现了全面提升,不仅显著拉高了多轮一致性指标 $\text{Pass}^3$,还展现了出色的跨基础模型迁移能力。
为什么现有 Harness 自进化常常“一跑就崩”?
要理解 ModularRSI 的贡献,必须先厘清现有 Harness 自进化方法为何难以在真实场景中泛化。论文指出了当前技术路径中三个相互交织的致命瓶颈。
首先是数据层面的虚假繁荣与基准泄漏(Data Leakage)。Harness 自进化需要大量可交互、带可靠判定逻辑的真实环境。构造这样一套任务的成本极高,导致现有的多数 Harness RSI 工作(例如 AHE、Meta-Harness 等)直接把 downstream 测试基准(如 SWE-Bench 的子集)当作自进化的训练场。这种做法本质上是在把评测集当微调集用,Agent 进化出的很多机制其实是针对特定评测基准输出格式、报错习惯或题目特性的“作弊补丁”,根本无法迁移到真实的未知任务中。
其次是轨迹层面的归因歧义(Trajectory-level Ambiguity)。如果仅仅依赖单个成功或失败的轨迹来指导更新,LLM 极难分清:这个任务之所以失败,究竟是因为 Harness 缺乏超时重试机制,还是因为模型对某个具体的 Python 库用法理解有误?单轨迹更新很容易将特定任务的业务推理逻辑与系统通用的运行机制杂糅在一起,最终修改出的 Harness 往往充斥着针对个别实例的狭隘规则。
最后是机制层面的责任分配难题(Credit Assignment Problem)。传统的 Harness 往往是一个单体式(Monolithic)代码脚本。当任务报错时,让负责改进的 Agent 直接去全局重写代码,就像让一个新手程序员在没有任何模块边界的情况下重构整个操作系统。这种全 Harness 尺度的优化会导致不相关的机制相互纠缠,一个旨在改进上下文截断的改动,很可能无意中破坏了工具返回值的解析逻辑,使得整个系统的稳定性和可维护性急剧恶化。
ModularRSI 的核心设计:解耦、对比与模块化闭环
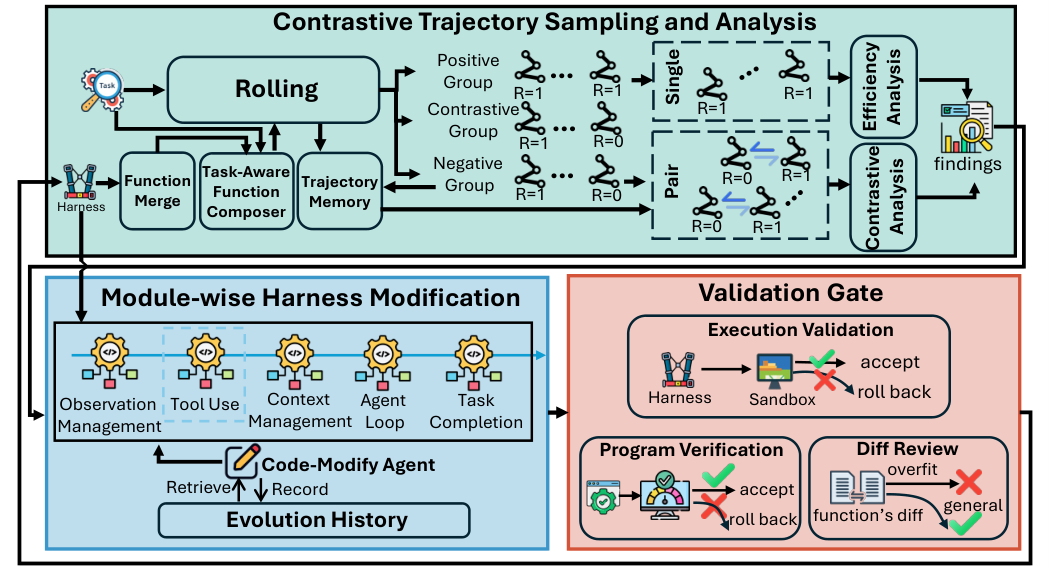
针对上述困局,ModularRSI 提出了三位一体的解决方案:完全隔离的自进化环境、同任务对比轨迹分析,以及严格受限的五大模块化自进化。
1. 彻底隔离的 2,000 个可执行进化任务
为了从根源上杜绝向测试集过拟合,研究团队从外部独立构建了一个包含 2,000 个任务的可执行进化数据集。该数据集完全独立于下游的评估基准(如 TerminalBench 2.0 和 SWE-Bench Verified)。团队应用了严格的实例相似度过滤和细粒度领域分析,确保在进化过程中 Agent 绝不会提前窥见下游评测的影子,从而建立了一个真正检验“可迁移通用改进”的标准实验平台。
2. 对比轨迹采样与跨任务证据聚合
针对归因歧义,ModularRSI 引入了对比轨迹分析(Contrastive Trajectory Analysis)。在进化过程中,针对每个任务实例 $x_i$,系统会让 Agent 独立执行 $K$ 次采样,生成多条轨迹。根据各轨迹的二元评判结果,任务被划分为三类:
-
全胜组(Positive):$K$ 次执行全部成功;
-
全败组(Negative):$K$ 次执行全部失败;
-
对比组(Contrastive):部分成功、部分失败($0 < \sum r_i^k < K$)。
其中,对比组是整个自进化机制最宝贵的信息金矿。在相同的任务要求和相同的模型配置下,为什么轨迹 A 能成功而轨迹 B 却陷入停滞?通过让专门的 Code-Modify Agent 重点对比分析同一任务内部的成功与失败差异,系统可以迅速过滤掉属于任务本身的特定知识点,精准剥离出 Harness 在交互层面的行为缺陷(例如:失败轨迹往往因为一次截断丢失了关键上下文,而成功轨迹恰好在截断前执行了保存)。随后,系统在整个 Batch 的多任务间聚合这些现象,只有跨任务反复出现的共性缺陷,才会被沉淀为结构化的修改建议。
3. 将行为机制解耦为五大独立模块
为了解决全局重写带来的混乱,ModularRSI 明确将系统底层的冷启动、沙盒初始化、网络通讯等基础架构,与直接介导 Agent 与环境交互的行为机制区分开来,并将后者解耦为五个职责明确的功能模块:
-
Agent Loop(执行循环):管理单步状态转换、重试策略、最大轮次限制与异常捕获。
-
Tool Use(工具使用):定义工具接口规范、参数解析逻辑以及命令行调用的组装与分发。
-
Observation Management(观察管理):处理环境返回信息的清洗、截断、报错摘要提取以及关键输出高亮。
-
Context Management(上下文管理):动态调度历史交互记忆,决定哪些内容保留在活动窗口、哪些内容归档或丢弃。
-
Task Completion Detection(完成检测):监控任务状态,准确识别何时应该主动声明完成,防止无意义的过度执行或过早退出。
在进化阶段,每个模块都在其严格限定的代码作用域内独立进化,彼此互不干扰。这就将原本不可控的全局代码重写,收敛为高内聚、低耦合的局部函数更新。
4. 严苛的验证门控与跨模块集成
提出的代码修改不会直接上线,而是必须依次通过三道门禁:程序静态检查(确保语法无误、接口签名兼容)、面向泛化的 Diff 审查(自动审查代码变动是否包含硬编码的文件名、特定库名称或任务特异性 Hack,一旦发现直接否决),以及实际执行验证(随机抽取任务试跑,出现异常立即回滚)。
在所有模块独立进化 3 个 Epoch 后,系统进入“跨模块集成(Cross-Module Integration)”阶段。此时,各个模块积累的最佳函数会被组装进统一的 Harness,由集成 Agent 专门排查可能出现的接口冲突与逻辑冗余。最后,整套函数库被彻底冻结(Frozen),直接投入下游评测,杜绝下游测试时的任何动态作弊。
实验评测:在未见过的真实基准上见真章
为了验证这套框架带来的改进究竟是不是通用的机制提升,研究团队在两大极具挑战性的真实基准上进行了评估:涵盖 89 个长程命令行任务的 TerminalBench 2.0 (TB2.0),以及包含 500 个真实开源项目 issue 的 SWE-Bench Verified。初始基础脚手架统一选用 Harbor 体系下的 Terminus-2,核心进化过程由 DeepSeek-V4 系列模型支撑。
1. 突破单次偶然性:Pass^3 可靠性的大幅跃升
在 TerminalBench 2.0 的评测中,ModularRSI 最引人注目的并非单纯的单次准确率提升,而是执行一致性的显著强化。实验引入了衡量可靠性的 $\text{Pass}^3$ 指标(即同一个任务必须在连续 3 次独立 Rollout 中全部成功,才算真正攻克)。
结果显示,在完全隔离的进化协议下,ModularRSI 让 Agent 在 TB2.0 上的 $\text{Pass}^3$ 从原始基线的 30.34% 提升到了 35.96%(绝对增益达到 5.62 个百分点),最终 Acc 也稳步升至 52.43%。在长程任务中,Agent 经常因为随机采样或环境轻微抖动而崩溃,$\text{Pass}^3$ 的显著增长直接证明了 Harness 机制层面的健壮化——系统不再依赖模型碰运气,而是具备了抵抗随机执行扰动的兜底能力。
2. 隔离评测下,传统 RSI 方案的集体失灵
这项研究最具批判性价值的实验,在于将 ModularRSI 与现有的代表性 Harness RSI 方法(如 AHE 和 Meta-Harness)放在同一起跑线上进行横向对比。
在以往论文中,这些方法由于在基准内部演化,往往能报出非常亮眼的分数。但在 ModularRSI 建立的“基准完全隔离”严格设定下,它们的表现发生了断崖式下滑:AHE 和 Meta-Harness 的准确率仅比 Terminus-2 原生基线微调了不到 1 个百分点,几乎原地踏步。这一对比犀利地揭示了现有大部分自进化方法的本质——它们此前获取的高分,很大程度上是由于捕获了评测集的局部伪影;一旦失去基准数据的反向浸润,传统的全局重写框架根本无法提炼出能泛化的执行策略。而 ModularRSI 凭借五模块独立演化和对比归因,在隔离协议下依然取得了超 5 个百分点的坚实提升。
3. 各模块各司其职:准确率看 Loop,效率看 Observation
消融实验揭示了各个功能模块对系统整体能力的差异化贡献:
-
Agent Loop 模块在单模块进化中带来了最高的独立准确率提升。这说明合理的状态流转、死循环中断与重试调度,是保证任务顺利走通的底座。
-
Observation Management 模块则展现了极强的“降本增效”特质。它大幅压降了平均交互步数(StepNum),让 Agent 能够用更精炼的交互轮次拿到结果。这主要得益于该模块自动进化出的错误信息提炼与长输出滚动截断能力,避免模型在冗余的 Terminal 输出中迷航。
-
当把五个独立进化的模块集成在一起时,系统的表现(Acc 52.43,$\text{Pass}^3$ 35.96)全面超越了任何单一模块,同时也大幅击败了不解耦的“全量联合进化(Joint Evolution)”。数据有力地证实:模块间捕获的改进具有优良的互补性,解耦演化再统一集成是目前最为健壮的工程路径。
4. 进化信号从何而来:对比组与任务难度的玄机
论文还深入探讨了自进化过程中数据的质量问题。在轨迹演化中,任务的难度分布直接决定了进化天花板。
如果演化集中充斥着过多极度困难(全军覆没)或极度简单(全员通过)的任务,模型产生的轨迹绝大多数会落入 Positive 组或 Negative 组。分析发现,在这些极端组别中,Agent 很难抽象出通用的运行逻辑,修改建议容易退化为无意义的代码微调。相反,当数据以中等难度(Medium-centered)为主时,能够激发最高比例的 Contrastive(半成半败)轨迹对。正是这些成功与失败并存的执行轨迹,为 Agent 提供了最清晰的对照实验样本,推动最终进化的 Harness 在 SWE-Bench Verified 上拿到了 76.45% 的高分,明显优于在难易两极化数据下演化的版本(74.25%)。
5. 跨越基础模型:学到的是通用执行哲学
另一个核心问题在于:用模型 A 进化出的 Harness,换给模型 B 用,还灵不灵?如果进化的产物仅仅是迎合了特定基础模型的生成偏好,其工程价值将大打折扣。实验证明,ModularRSI 进化出的模块在不同基础模型之间具有高度的迁移性。无论是用于指导自身进化的模型,还是未参与进化的其他变体,换上 ModularRSI 改进后的 Harness 后,均录得了一致的性能增益和步数下降。这表明该框架挖掘出的是与具体模型推理缺陷互补的、通用的外部协调机制。
机制演化重塑 Agent 系统工程
ModularRSI 的工作不仅是一次漂亮的基准刷分,更为长程任务 Agent 的工程落地提供了一个极具启发性的思路:在模型参数本身难以无限扩展或训练成本过高时,围绕模型构筑的运行脚手架同样拥有巨大的、可自动化的优化空间。
过往人们要么把 Harness 当作静态的工程外壳,要么以一种黑盒、粗放的方式让 LLM 去全局盲改。ModularRSI 证明了:
-
约束即泛化:限定修改边界、拆解功能模块,不仅没有限制 Agent 的创造力,反而通过消除机制冲突保护了演化的稳定性;
-
对照出真知:单向的成功复盘或失败检讨往往伴随严重的幸存者偏差,同场景下的成败轨迹差分才是定位系统缺陷的黄金探针;
-
拒绝基准自嗨:只有坚持演化环境与下游评测基准在物理层面的彻底隔离,自我改进的研究才能走出“过拟合基准”的假象,走向真正的通用智能体系统工程。
随着复杂软件工程与全自动运维场景的推进,如何让 Agent 自主演化出一套越来越鲁棒、越来越懂如何与环境打交道的脚手架,将成为模型落地阶段的关键命题。ModularRSI 所确立的模块化自进化范式,无疑为这一前沿方向铺设了一条兼具学术严谨性与工程可行性的道路。