MoRSE:耶鲁破解多Agent同质化,以双层混合专家实现参数特化
MoRSE: Task-Oriented Multi-Agent System with Mixture of Role-Subtask Experts
在大语言模型驱动的多智能体系统(MAS)中,让不同智能体扮演不同角色(如架构师、程序员、代码测试员)来协作解决复杂长程任务,已经成为当前最主流的技术路线之一。然而,现有系统普遍遭遇一个明显的边际效用递减问题:仅仅在同一个冻结基座模型上堆叠更多智能体、填充更丰富的角色提示词,并不能持续带来性能突破。很多时候,智能体之间的协作会退化为相互重复的冗余发言,甚至在上下文传递中不断放大误差。
ArXiv URL:https://arxiv.org/abs/2608.09251v1
出现这种现象的本质在于智能体之间的异质性(Heterogeneity)不足。过去的研究大多停留在提示词层面的粗粒度角色分工,或者仅在单一维度上针对固定角色微调参数。然而,真实软件工程或复杂科学计算任务通常包含大量异质子任务,这些子任务对模型能力维度的需求千差万别,单一共享基座模型在参数表征上根本无法兼顾。
针对这一瓶颈,耶鲁大学的研究团队提出了名为 MoRSE(Task-Oriented Multi-Agent System with Mixture of Role-Subtask Experts)的新型多智能体框架。MoRSE 不再局限于表面上的提示词工程,而是将智能体特化推进到任务结构与模型参数两个更底层的维度。框架将复杂长程任务解构为有向无环图(DAG),并为每个节点分配精确的“角色-子任务”对应关系;同时在共享基座之上挂载动态角色与子任务 LoRA 专家池,由原型语义路由器实现软性分发。此外,为了解决强化学习在稀疏奖励下联合优化路由器与专家导致的方差膨胀难题,作者提出了分层组相对策略优化算法(HGRPO),从数学上隔离路由决策与生成质量的方差,实现了极其稳定的端到端协同进化。
诊断多智能体退化的两大致命根源
为了明确传统多智能体协作失效的内在机制,研究团队首先在基准软件工程数据集 SRDD 上使用 Qwen3-4B 进行了针对性的实证诊断。诊断聚焦于两个核心维度:任务结构层面的输出冗余度,以及参数表征层面的能力适配冲突。
第一个实验评估了基于提示词引导的角色型图结构多智能体系统在协作过程中的表征相似度。团队利用冻结的文本编码器,计算整个多智能体协作管线中各节点提示词之间以及实际生成输出之间的平均两两余弦相似度。结果令人吃惊:尽管系统设计者在输入端精心编写了差异化的角色提示词,但在智能体实际生成的输出端,相似度不仅没有发散,反而显著上升。正向的漂移指标表明,现有的管线在执行过程中严重放大了智能体输出的冗余度,各智能体的工作责任边界模糊,导致“多体协作”在实质上退化成了“多人同音”。
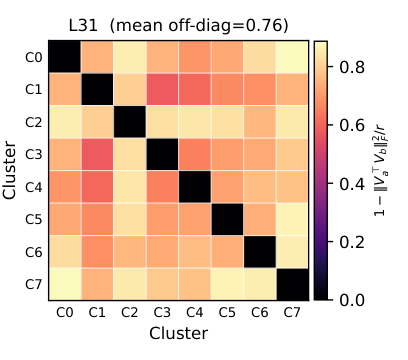
第二个实验进一步深入大语言模型的参数表征子空间。研究人员提出一个根本问题:不同的执行角色以及同一角色面对的不同子任务,是否真的能够由单一低秩自适应(LoRA)模块完美承载?团队借鉴了子空间表示分析方法,对比了真实角色标签与随机打乱标签在 Transformer 各层中的主子空间发散度。实验发现,在集中承载高阶任务语义的深层网络(例如第24至31层)中,真实角色之间的子空间发散度比随机基线高出约 0.40;而在固定执行者角色、仅改变子任务语义时,通过聚类分析得到的真实子任务类别之间的发散度更是高达 0.75,显著高于随机扰动的 0.45,且置信区间在深层网络完全不重叠。
这一诊断在理论与经验两端同时击碎了“单一共享 LoRA 就能胜任多智能体所有协作环节”的幻想。不同角色需要完全不同的行为模式,而面对多样化子任务时,模型参数所需要的适应方向具有高度正交性。如果强行把所有异质需求塞进同一个低秩瓶颈内,必然引发严重的参数干扰与容量冲突。
MoRSE 的三层核心架构设计
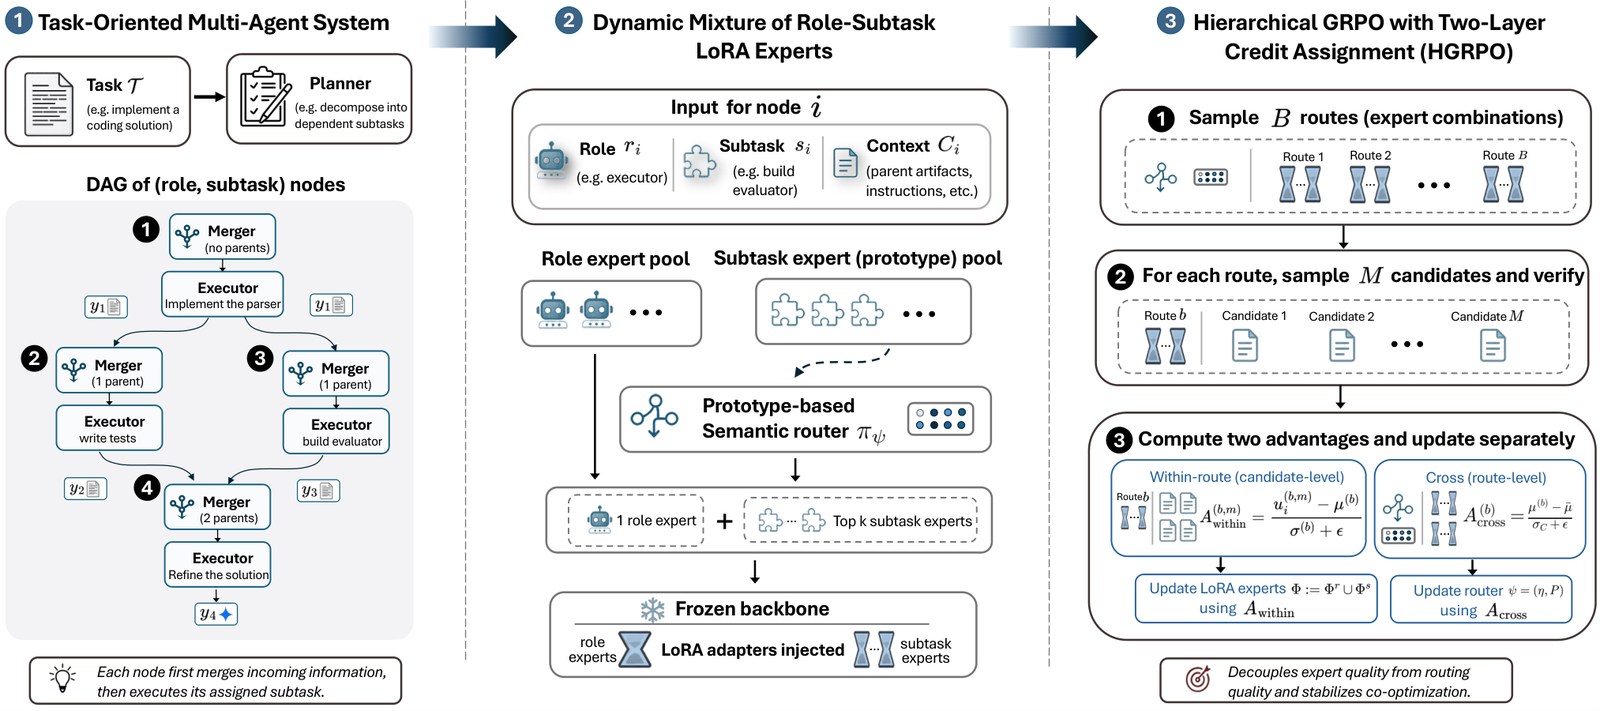
为了从结构与参数两个层面彻底打破上述异质性不足,MoRSE 构筑了包含任务解构、动态混合专家和双层策略优化的三位一体技术架构。
1. 面向任务的图结构解耦(ToMAS)
MoRSE 放弃了传统多智能体中松散的角色聊天模式,转向更严谨的面向任务的多智能体系统(ToMAS)。对于输入的复杂长程任务实例,规划器首先动态生成一个感知依赖关系的有向无环图(DAG),其中每个节点代表一个独立的子任务单元,包含明确的自然语言子任务描述;有向边则清晰定义了数据流和逻辑依赖关系。
在 DAG 的执行逻辑上,MoRSE 将每个节点的处理拆分为两阶段:合并(Merger)与执行(Executor)。当一个节点存在多个前置依赖时,Merger 负责汇聚、去重并提炼上游产物,输出连贯的上下文信息;随后,Executor 结合当前子任务的具体目标与上下文产出当前阶段的代码或逻辑构件。为了阻断错误沿图结构的级联放大,每个节点均配备了基于规则的逐步验证器。验证器不仅对输出构件的语法、格式及基础正确性进行校验,提供逐步标量奖励,更会在验证失败时实施阻断,防止受污染的有毒上下文继续向下游扩散。
2. 原型路由的角色与子任务 LoRA 专家混合(MoLE)
在底层参数特化设计上,MoRSE 提出了原型路由的角色-子任务 LoRA 专家混合模块(MoLE)。整个系统共享一个冻结的大语言模型基座,以将显存开销和训练成本严格控制在单模型级别;所有的参数异质性完全由轻量化的动态 LoRA 专家提供。
该专家池被严格拆解为两组解耦的参数集合:
-
角色专家池:为每个离散角色分配固定的 LoRA 专家模块,专注于捕获流程控制级别的通用行为模式(如上下文归纳总结、代码编写、单元测试等);
-
子任务专家池:包含多个供灵活调度的子任务 LoRA 专家,用于承载细粒度的领域语义特化。
面对自然语言描述构成的开放式、不可穷举的子任务空间,传统的硬性分类路由无法泛化。MoRSE 引入了可学习的语义原型路由器:首先利用冻结编码器提取子任务的自然语言表征,再通过可训练的线性映射将其投射至原型潜空间,计算其与各个专家语义原型的余弦相似度,从而生成全局软性概率分布。在具体执行某一节点时,系统激活对应的角色专家,并根据路由器分布选取 Top-$K$ 个子任务专家,通过均匀权重与基座权重合并。值得一提的是,在 Merger 汇聚节点处,子任务专家直接继承自所有前置依赖节点的 Executor 激活集合,确保模型在整合上下文时天然具备与上游构件相匹配的特化解码视角。
3. 解耦专家与路由器的双层分层强化学习(HGRPO)
将专家参数与语义路由器放在端到端强化学习中共同训练,面临着严峻的方差失控挑战。在实际训练中,某个专家表现糟糕,可能是因为它本身的参数没有学好,也可能是因为路由器在当前子任务下错误地调用了它;反过来,路由器的判别信号也会受到专家偶然失误的严重污染。如果在单层组相对策略优化(GRPO)中直接使用任务奖励计算统一优势,梯度的交互耦合会导致方差爆炸。
MoRSE 创新性地提出了具备两层信用分配机制的分层 GRPO(HGRPO):
在每个 DAG 节点训练采样时,路由器首先采样 $B$ 条路由路径(即确定不同的子任务专家组合),随后在每个专家组合内部并发采样 $M$ 个候选输出,交由规则验证器打分。算法据此构造两个在统计上严格隔离的优势信号:
-
组内优势(Within-Route Advantage):以特定路由内部多次采样的平均表现作为条件基线,衡量当前候选输出在该专家组合内部的相对优劣。该信号专用于更新 LoRA 专家参数,从而彻底从专家梯度的方差中剔除了路由决策带来的跨组方差。
-
跨组优势(Cross-Route Advantage):以所有路由候选均值的全局平均为基线,衡量各个专家组合整体表现的相对优劣,该信号专门用于更新语义路由器的映射矩阵与原型向量。
论文在理论上给出了严格证明:相较于传统单一优势函数,HGRPO 保持了期望梯度的无偏性,同时将 LoRA 专家梯度的方差严格削减了与跨路径方差相关的非负项。这一数学特性使得系统在面对稀疏、开箱即用的任务奖励时,依然能够保持极其稳定的参数协同进化。
实验结果与深度分析
研究团队在两个极具挑战性的代码生成基准上对 MoRSE 展开了全面评测:一个是面向大型软件工程需求的 SRDD(包含40个应用类别的1200个软件需求说明),另一个是科学计算与算法基准 SciCode(包含来自5大科学领域的80个复杂问题,细化为338个带单元测试的子任务)。评估跨越了三个不同规模的主流开源基座模型:Qwen3-4B-Instruct、Llama-3.1-8B-Instruct 以及 Gemma-4-31B-IT。
在多基准横向对比中,MoRSE 的表现全面超越了包括经典角色链式管线 ChatChain、网状拓扑协作系统 MacNet、以及基于蒙特卡洛树搜索架构优化的 AFlow 在内的所有主流基线。
以端到端可执行率(Exec)与综合有效性指标(ECI)为核心的 SRDD 评测中,即便是不经过任何强化学习训练的初级版本 MoRSE-base,凭借基于 DAG 的精准责任划分与分步阻断机制,其表现就已经稳定压制了传统多智能体系统;而在经过 MoLE 与 HGRPO 的联合训练特化后,完整的 MoRSE 系统在三个基座模型上均斩获了最优的端到端编译运行率。更关键的是在保留测试集(Held-out Test)上的表现:由于测试集包含更复杂且训练时完全不可见的任务需求,传统模型性能通常会出现滑坡,但 MoRSE 凭借动态原型路由的平滑泛化能力,在保留集上对各基线保持了显著的领先优势。
在 SciCode 科学计算基准的严苛测试中,MoRSE 展现出从单步推理到全题通过率的全面突破。科学计算任务要求多步骤数值推导与严谨代码实现的环环相扣,单步微小误差即会导致全局溃败。MoRSE 在微观子问题通过率(Step Pass)与宏观全题通过率(Problem Pass)上均大幅刷新了历史成绩。以 Llama-3.1-8B-Instruct 为例,MoRSE 显著提升了全部子任务测试用例均通过的比例,验证了结构解耦与参数特化在对抗多阶段长程误差累积时的强大鲁棒性。
消融实验进一步印证了各项机制设计的必要性:
如果将 HGRPO 降级为常规的单层 GRPO,由于专家与路由器的方差相互污染,策略训练过程频繁震荡,最终测试收敛性能明显下滑;若移除子任务专家池而仅保留角色专家,模型在面对长尾复杂算法时再次表现出容量瓶颈;而若将原型路由器替换为固定的静态聚类硬分配,模型在面对未见过的任务分布时性能出现剧烈退化。
在冗余度重测实验中,MoRSE 彻底逆转了图结构多智能体系统中“提示词相似、输出更相似”的同质化困境。从输入到输出,各智能体表征向量之间的相似度呈现出持续发散的健康态势。每个节点上的智能体真正做到了“在其位、司其职、用其专”,不仅承担着明确的子任务责任,其模型底层激活的参数子空间也呈现出清晰的功能分离。
总结与展望
MoRSE 的成功给当前大模型多智能体系统的技术路线带来了一个极其重要的启示:多智能体系统的扩展性上限,从来不在于智能体数量的无序堆砌,而在于智能体之间异质性的有效深度。
在过去相当长一段时间里,社区习惯于依赖提示词工程为冻结的模型反复灌注角色设定,试图借此诱导复杂协作。然而,无论是表征子空间的数学约束,还是多轮交互中的语义漂移,都在反复证明纯提示词分工的脆弱与低效。MoRSE 将多智能体系统推进到了结构工程与参数微调深度咬合的新阶段:
-
在结构层面,用严谨的 DAG 与责任制解耦取代了模糊的群体闲聊;
-
在参数层面,用轻量可组合的动态混合专家打破了单一 LoRA 的容量壁垒;
-
在算法层面,用方差可控的分层信用分配解决了混合系统端到端对齐的稳定性难题。
这种在共享单模型推理成本的前提下实现高异质协作的设计范式,不仅为复杂软件工程与科研级多步推理任务提供了全新的落地解法,也为未来多智能体系统的规模化演进指明了更务实的演进路径。