OmniScientist:直接感知多模态原始证据,端到端科研胜率达85%
OmniScientist: An Omni-Modal Omni-Discipline AI Scientist
在过去一年里,AI 驱动的自动化科学研究取得了令人瞩目的进展。从最初根据提示词生成假设,到编写并运行测试代码,再到排版出包含图表的 LaTeX 论文,各类“AI 科学家”(AI Scientist)系统的出现,让外界看到了一种全自动化的科研未来。然而,如果仔细审视现有系统的底层逻辑,会发现一个普遍存在却常被忽视的硬伤:它们绝大多数是“工作流完整”,却在“证据链上极度残缺”。
ArXiv URL:https://arxiv.org/abs/2608.13558v1
目前的自动化科研框架,通常只能吞吐纯文本、预先清洗好的表格、代码或人工提取的标量特征。这意味着在科研流程启动前,人类就已经替模型过滤掉了绝大部分信息。一旦面对显微图像中微妙的局部形态、时序脑电信号中的跨通道异常,或是材料晶体三维结构中的对称性破缺,这些系统便无能为力。模型并不是在直接审视真实世界的科学数据,而是在对人类嚼碎后的摘要进行符号推演。
针对这一本质局限,新加坡国立大学与牛津大学的研究团队联合推出了首个全模态、跨学科的端到端自主科研框架 OmniScientist。该框架的核心设计是将多模态感知能力贯穿于科研的整个生命周期——从直接审阅显微图像与波形图来构思研究假设,到编写代码验证数据,再到基于实验记录撰写论文,全部无需人工特征工程。
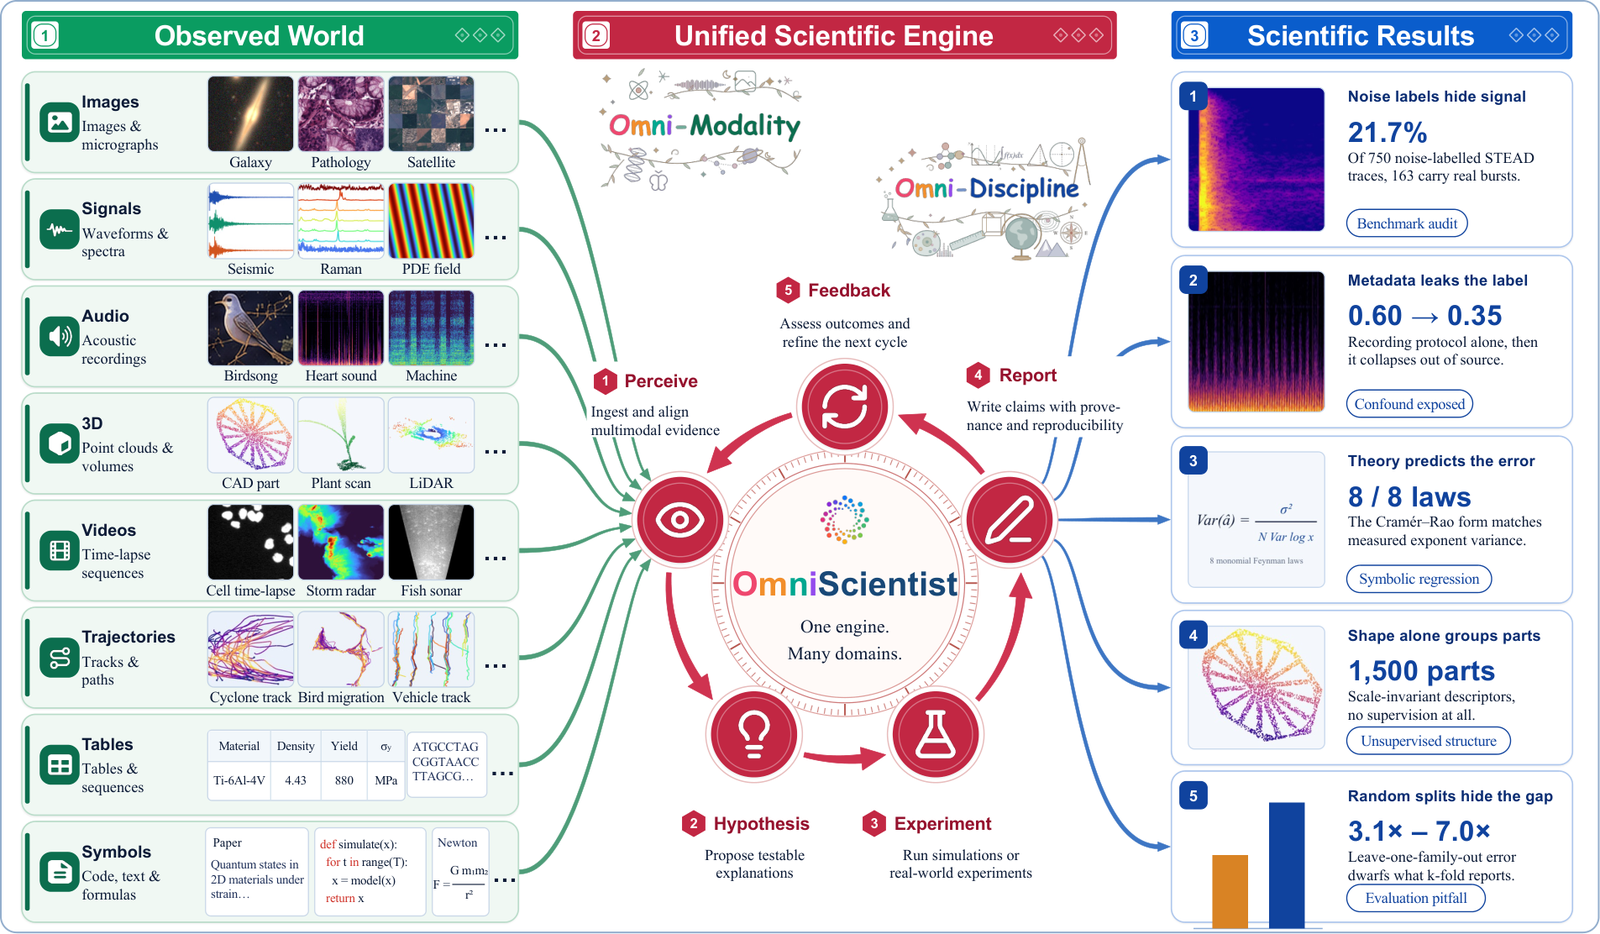
在涵盖地球物理、生物医药、天体物理、材料科学等 5 大学科族、12 种数据模态的 36 个真实科学案例中,OmniScientist 全部独立走通了“从原始数据到完整论文”的全流程,并在与传统“盲眼”(仅接收预处理标量)基线的头对头评测中斩获了 85% 的胜率。这一成果表明,只有让智能体直接“看到”原始数据,AI 驱动的科学发现才可能真正触及科学探索的核心。
为什么工作流完整不等于证据完整?
科学发现的源头往往并不在于既定表格中的数值大小,而在于对反常现象的直接捕捉。显微图像中细胞边缘的异常浸润、引力波探测器输出波形中的相位微扰,抑或是反应过程视频中液滴飞溅的非稳态动态,这些关键的科学线索天生具有高度复杂的空间、时间、跨通道与因果拓扑关系。
如果把显微图像退化成几条特征描述文本,或者将高频传感器信号压缩为均值与方差,隐藏在原始分布中的异常便被彻底抹杀。以往的 AI 科研系统之所以倾向于处理文本与标量,是因为语言模型在处理一维离散符号序列时表现最优。然而,这导致模型继承了人类预设的认知偏差:它只能在人类认为有价值的几个预设维度里打转,根本不可能发现意料之外的规律。
即使近来有些系统引入了多模态大模型,也通常只是将其用在孤立环节,例如在最后阶段检查一下代码生成的统计图好不好看,或者在自动化实验室里充当监控探头。这种“局部插拔式”的感知,并没有让观察结果倒逼假设的推倒重来。
真正的科学研究是一个动态闭环:对原始实验数据的直接观察决定了提出什么假说;实验执行后的原始曲线又决定了下一步如何修正方案;最终论文里的每一个主张,都必须严格回溯到观测细节。缺乏端到端感知的自动化系统,本质上只是一个高阶的代码执行器和论文生成模板,难以完成真正具有原创性的科学洞察。
四大证据家族:建立学科无关的通用感知底座
为了让同一个系统能够无缝处理地震波、蛋白质三维构型以及生物医学知识图谱,研究团队没有针对每个具体学科编写孤立的处理插件,而是从信息解读的认知范式出发,提出了一个面向科学证据的底层抽象框架。
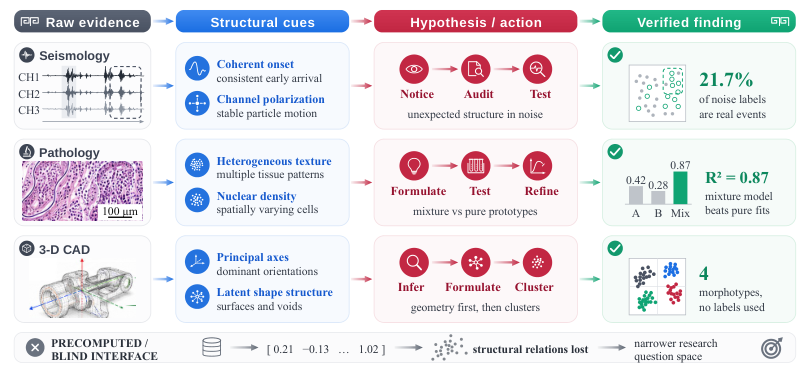
OmniScientist 将纷繁复杂的跨学科数据归纳为 4 个与具体学科解耦的“证据家族”:
第一类是感知型证据(Perceptual Family),涵盖显微图像、光谱、电生理波形、声学信号、高动态视频以及三维空间结构等。这类数据的共性在于其物理意义高度依赖局部的几何形态、时序周期性或跨通道相位差,必须借助多模态视觉与序列模型进行原真感应。
第二类是符号型证据(Symbolic Family),包含学术文献、数学公式、基因序列和知识图谱。这类数据以形式化符号和逻辑图元编码,承载着结构化的因果与定义关系。
第三类是定量统计型证据(Quantitative-Statistical Family),包括多维测量表格、参数矩阵和概率分布,强调统计显著性、自由度与协方差结构。
第四类是过程型证据(Procedural Family),记录动力学轨迹、数值模拟演化路径以及实验操作的历史追踪,侧重于系统状态在时间轴上的状态演变。
通过这套四分法,OmniScientist 抹平了不同自然科学门类之间的技术鸿沟。当研究人员输入一个包含原始文件、研究目标与学科背景的配置规范时,底层的通用感知层会自动调取匹配的工具栈来检查这些证据。扩展一个全新的研究领域,只需增加一份描述任务元数据的规范文件,系统的核心引擎和执行逻辑不需要更改任何代码。
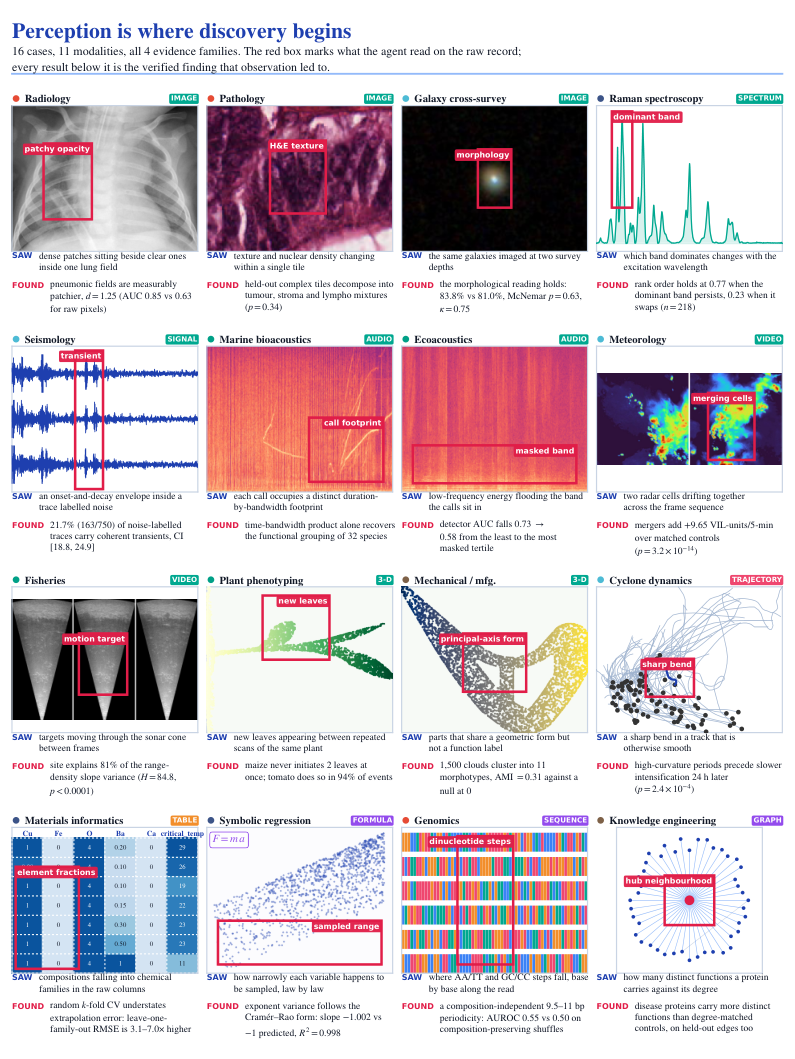
上图展示了 OmniScientist 的感知层在 16 个真实案例中的工作状态。面对脑电波信号,系统直接标记出异常微放电的波形低谷;面对晶体显微断层切片,它准确定位局部晶格错位;面对流体力学仿真轨迹,它敏锐捕捉到涡旋演化的临界分岔。这种对原始数据的直观洞察,构成了后续所有科学假设与实验设计的真正基石。
三智能体协同与严格的代码质检门禁
有了感知底座之后,OmniScientist 将整个科研闭环拆解为三个自主智能体:构思智能体(Ideation Agent)、实验智能体(Experiment Agent)和写作智能体(Writeup Agent)。三个智能体基于 ReAct(Reasoning + Action)范式进行多轮探索,但在智能体之间的生命周期流转上,研究团队坚决摒弃了单纯依靠提示词与自然语言约定的松散架构,而是引入了确定性的、由底层代码强制执行的门禁系统。
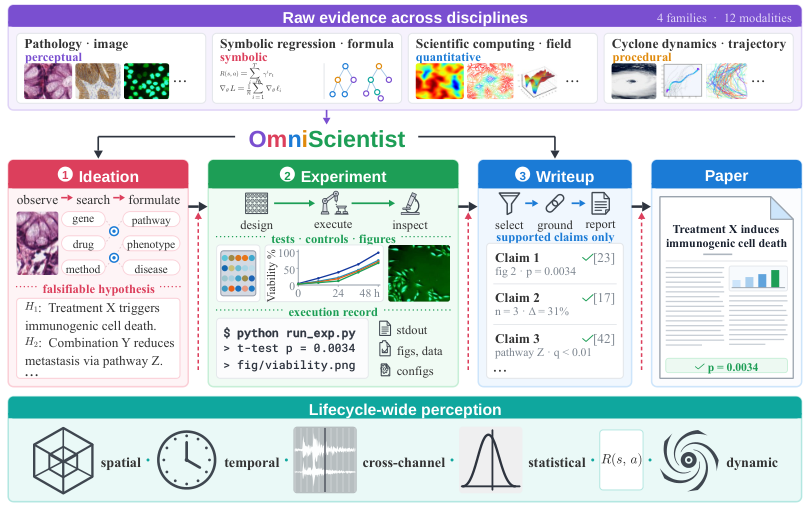
在构思阶段,智能体首先必须通过感知层对原始数据做全局摸底,随后调用学术文献检索接口检索现有文献。为了防止模型在概念空间里发散出无法落地的空想,系统设置了严格的“构思质检门禁”:智能体必须独立提出至少 5 个备选假设并做可行性筛查;每个假设必须自带可证伪标准;方案必须仅依赖计算即可完成,杜绝提出模型无法执行的物理操作;同时,系统在底层以代码扫描的方式过滤绝对化表述,将大模型经常信口开河的“本工作首次发现”等用词,硬性替换为更符合学术规范的审慎陈述。
进入实验阶段后,实验智能体负责生成数据分析、统计检验与可视化的可执行代码。大模型做科研最严重的风险之一是 HARKing(Hypothesizing After Results are Known,即在得知数据运行结果后反向迎合假设)以及多重假设检验导致的数据泄露。
为彻底阻断这一学术不端隐患,OmniScientist 部署了“严谨性代码检查”(Rigour Check)。在沙盒中运行代码后,系统会建立一个不可篡改的“执行记录底册”(Execution Record),完备记录下所有尝试过的检验。一旦发现数据划分泄漏、有效样本量不足、或者由于代码反复调试导致的多重比较假阳性,系统会直接判定该次实验失效;若实验彻底崩溃或得出无法支持初始假说的零结果(Null Result),代码流水线将强行触发回退机制,迫使系统退回构思阶段重新立项,杜绝在失败结果上粉饰太平。
最终的写作阶段同样由代码门禁层层把关。为了让论文符合不同学科的学术共同体习惯,系统预设了 5 种论文结构模板。更重要的是,在把实验记录扩展为成段文字时,系统启动了“主张核查门禁”(Claim Check):论文正文和摘要中出现的每一个具体数值指标 $n_1 \dots n_k$,都必须在执行底册的运行日志中找到一模一样的来源凭据;正文提出的每一条结论主张 $C_1 \dots C_m$,必须严格映射到被质检系统认证过的分析步骤 $E_1 \dots E_m$。任何无法在执行记录中溯源的数字或外推的主张,都会被代码检测拦截并拒绝编译,从而在底层根除了幻觉数据的可能。
36 个跨学科真实案例:85% 胜率背后的质变
为了检验这套端到端系统的真实战斗力,研究团队搭建了一个极具挑战性的评估基准,囊括 36 个基于开源真实科学数据集构建的案例。这些案例横跨图像、时序信号、光谱、音频、视频、三维几何、动力学轨迹等 12 种模态,数据规模从包含 12 个公式的符号回归,一直跨越到拥有 500 万条三元组的生物医药知识图谱。
所有测试均从提供给系统的单一任务规范和原始文件开始,让 OmniScientist 自行运转。结果显示,在使用 Claude Sonnet 5 作为推理骨干网络时,OmniScientist 在全部 36 个案例中均 100% 独立完成了从原始数据读取、代码编写、数据分析到最终编译输出标准 PDF 论文的全过程。
在由独立评审大模型组成的盲审打分中,生成的论文在包含清晰度、技术严谨性、论点溯源性、科学重要性等 7 个维度的综合评分中,取得了 6.3 分(满分 10 分)的平均分。需要指出的是,该评分是由完全独立于推理骨干的评测模型给出,这一分数对于全自动产出的科研论文而言已经表现出相当高的完整度。而在更换不同的推理底座时(如对比 GPT-5.6、GLM-5.2、Kimi K2.7 以及 Qwen、Gemma 等开源大模型),论文的写作结构清晰度往往保持稳定,但论据的严密性与事实准确度则与底层推理模型的逻辑能力高度正相关。
更具说服力的是针对“感知能力”本身的严格消融实验。研究人员构建了一个“盲眼对照组”(Blind Variant):该变体完全剥离了直接感知层,不给模型查看任何原始显微图或时间序列,而是仅向其提供人工预先计算好的常规统计标量(如平均值、标准差、峰值等)。
在两两配对的盲审对决中,拥有全生命周期感知能力的 OmniScientist 取得了高达 85% 的绝对胜率。分析显示,感知能力带来的提升不仅体现在图表展示与细节描述上,更直接作用于研究的科学实质:由于能够直接观察到原始数据中的微细异常,完整版系统所挑选的研究问题更具探索价值,设计的分析代码更贴合数据本身的物理与拓扑特征,最终在正文中得到严谨支撑的科学结论也更具分量。
自主科研智能体的分水岭
长期以来,许多人对“AI 科学家”的期待容易走向两个极端:要么认为它只是大模型拼凑论文套路的“玩具”,要么期待它立刻能独立斩获诺贝尔奖。OmniScientist 的工作提供了一个极为清醒且扎实的视角。
它证明了全自动科研的核心瓶颈,往往并不在于大语言模型能否多写几页漂亮的综述,而在于模型与客观现实世界数据之间的物理接口是否完备。过去几年语言模型的飞跃,给智能体装上了处理符号的强大逻辑大脑;但如果切断了直接触碰丰富多模态现实数据的触角,AI 的研究就只能在人类预设好的有限概念里原地打转。
通过构建通用的跨模态感知底座,并将工程代码视作一种确定性的科研制度约束,OmniScientist 让大模型自由发散的构思与实验冲动,被牢牢约束在可复现、可溯源、防作弊的科学范式轨道之内。从只看预提取特征的“半盲推演”,到直面原始观测的“全模态探索”,这种研究范式的转变,或许正是自主科学智能体从完成作业走向产生真正科学发现的关键分水岭。