PoTRE:多拓扑推理打破群体思维,让轻量模型在HLE达到49.92%
PoTRE: Test-Time Reasoning inspired by Cognitive Heterogeneity
在大模型推理能力的演进中,利用推理期算力(Test-Time Compute)换取更高准确率已成为共识。无论是思维链(Chain of Thought)、自洽性采样(Self-Consistency),还是基于树或图的搜索框架,基本都遵循一条隐性假设:只要让模型沿着既定的生成风格重复多次,或者将同一个提示模板复制多份展开采样,就能靠大数定律滤除偶然的逻辑幻觉。
ArXiv URL:https://arxiv.org/abs/2607.20268
然而,在面对需要跨领域极端规划、严密形式验证或全新抽象感知的任务时,这种同质化集成暴露出致命缺陷。来自相同模型先验的多个采样副本,在面对困难问题时往往会沿着同一条错误的直觉路径滑落,形成“群体思维”(Groupthink),学术上称之为拓扑模式崩溃(Topological Mode Collapse)。即便扩大采样规模,错误的逻辑依然会在看似合理的表述中被同类 Agent 相互强化。
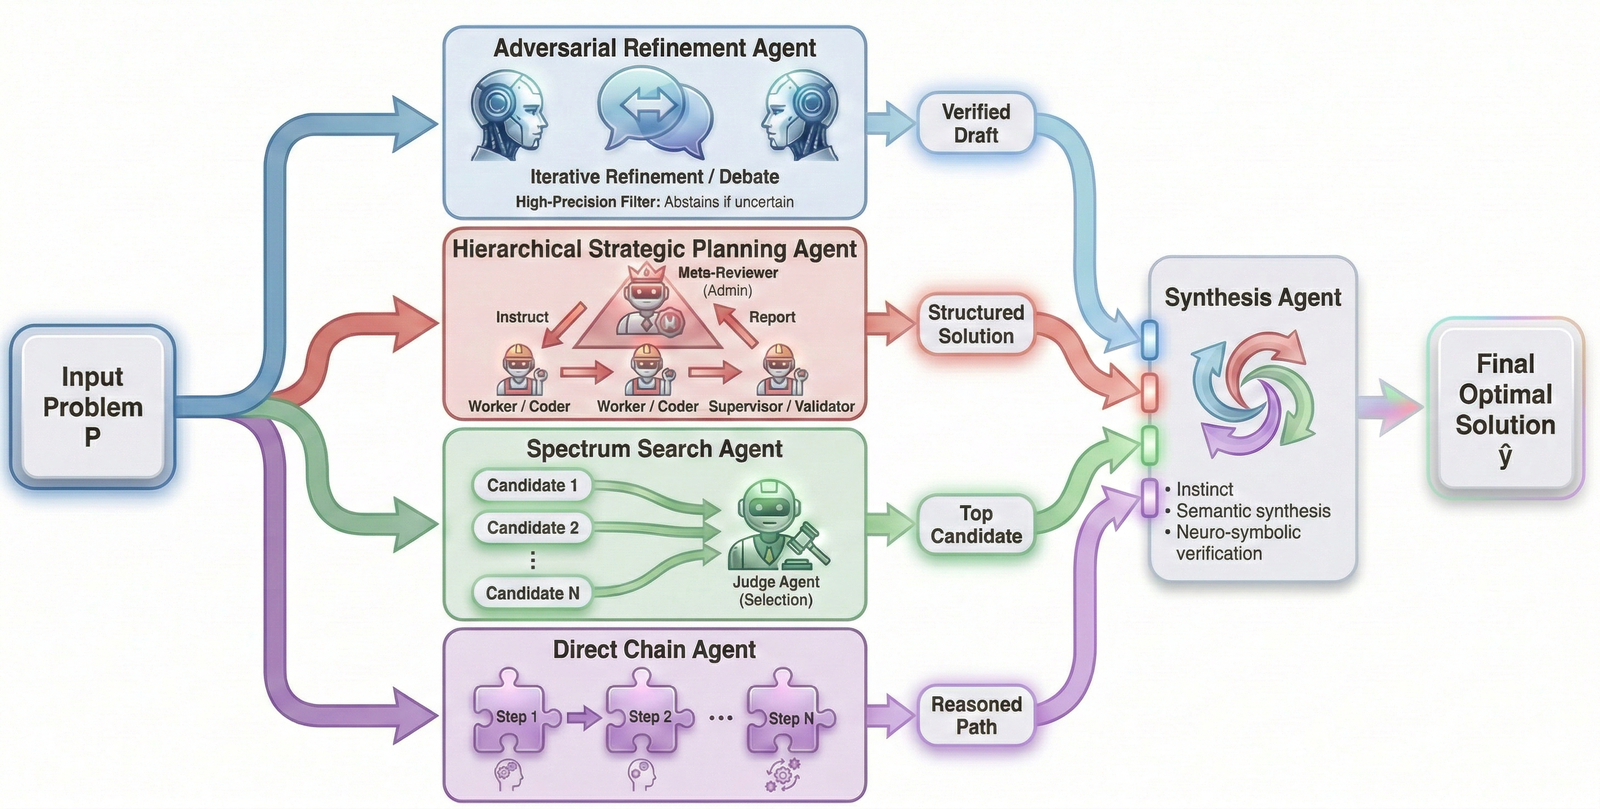
针对这一瓶颈,研究人员提出了 PoTRE(Poly-Topological Reasoning Ensembles)框架。该工作受到人类“认知异质性”(Cognitive Heterogeneity)的启发,认为复杂难题的攻克从来不依赖单一思维模式的无限重复,而取决于互补认知策略的协同碰撞。PoTRE 将推理过程解耦为四个拓扑机制截然不同的专门 Agent,并由自适应任务聚合层统一调度,从而在机制层面确保候选答案具备真正的语义发散度。实验表明,基于轻量模型 Gemini-3-Flash-Preview 构建的 PoTRE,在多个硬核基准上全面击败了未经脚手架强化的重型前沿模型 Gemini-3-Pro-Preview;而在 Gemini-3.1-Pro-Preview 加持下,PoTRE 在学术终极评测 Humanity’s Last Exam(HLE)上取得 49.92% 的准确率,刷新了公开测试榜单纪录。
同质采样的死胡同与认知异质性
当前提升大模型复杂推理的主流做法,往往局限在“加深序列长度”或“加大同质采样宽度”。前者的代表是长上下文深度推理系统,在单一链条中进行漫长的自省纠错;后者的代表是常规 Self-Consistency,让模型以固定温度采样数十次后做多数投票(Majority Vote)。
问题在于,当基础模型遇到陌生的符号抽象(如 ARC-AGI-2)或需要高精尖专家判断的前沿命题(如 HLE 和金融法律评测 PRBench)时,单一的认知拓扑会迅速陷入局部最优。如果模型对某个核心概念的初始联想出现偏差,单纯增加同质生成的采样数量,只会产生几十个“措辞不同但错误根源完全一致”的平庸解。最终,多数投票直接将错误答案推上神坛。
人类在解决极其复杂的工程或战略决策时,通常需要分工演练:有人负责发散脑暴寻找冷门方案,有人负责充当红军寻找漏洞,有人负责自顶向下规划里程碑,还有人直觉执行。PoTRE 的核心主张正是将这种认知异质性工程化:不是让多份相同机制的模型去盲目投票,而是让具备不同失败模式(Failure Modes)的专门 Agent 并行求解。只要各个 Agent 的错误是不相关的,甚至在分布上是彼此正交的,最终的聚合层就有可能在混乱中拼凑出全局最优解。
四大异质 Agent 的拓扑设计
PoTRE 在推理端解耦出四种截然不同的拓扑分支,分别对抗大模型推理中最容易出现的四类退化现象:
-
对抗细化 Agent(Adversarial Refinement Agent):专治未经推敲的表面幻觉。该组件构建了提议者(Proposer)与验证者(Verifier)之间的多轮对抗辩论(最多进行 $T=5$ 轮)。验证者并非被动过滤,而是必须提出建设性批判反推提议者修正缺陷。更关键的设计在于“选择性弃权(Selective Abstention)”机制:如果在最大轮次内验证者依然无法确认推导无误,该 Agent 将直接返回空集 $\emptyset$,宁可放弃作答也不向后续阶段输送受污染的低置信度噪声。
-
分层战略规划 Agent(Hierarchical Strategic Planning Agent):对抗无序的长程规划迷失。面对步骤极其繁冗的任务,普通模型极易在局部代码或细节逻辑中陷入无限调试循环。该组件引入元推理层面的“监督者(Overseer)”,持续监控工作 Agent 的状态转移空间。一旦检测到工作者在同一错误点打转或缺乏全局进展,监督者将果断切断当前路径,强行触发自顶向下的战略重规划,迫使整个系统跳出局部微调、重构解题骨架。
-
频谱搜索 Agent(Spectrum Search Agent):对抗确定性贪婪解码带来的视野狭隘。该分支牺牲部分局部推理深度,完全转向解空间的广度探索。系统并行唤起 $N$ 个独立的轻量工作线程,在非零采样温度下全面发散生成异质候选。这种随机广度探索让系统有极大概率跳出局部陷阱。在无外部执行器反馈的开放式任务中,该分支辅以 LLM 裁判进行语义一致性初筛,挑选出逻辑最自洽的探针样本。
-
直接链 Agent(Direct Chain Agent):负责维持直觉基准的锚定。过于复杂的结构化多 Agent 有时会引入不必要的调度损耗。PoTRE 保留了一个标准思维链作为朴素对照分支,对开放性问答采用 Zero-Shot CoT 避免先入为主的提示偏见,对归纳式任务则使用 Few-Shot CoT 注入格式先验。
这四个分支构成了拓扑异质的基础网络。消融分析证明,这种分工带来了极其鲜明的“特异性贡献”。在 ARC-AGI-2 空间几何推理评测中,频谱搜索分支的平均表现虽然并非全场最优,但它却以“专家特异性”独立解出了其他所有 Agent 均告失败的 14% 难题。正是这种不同分支的非对称长板,构成了整体异质性集成的坚实底座。
任务自适应聚合:超越多数投票的神经符号校验
如果只是将不同风格的 Agent 输出简单打包,随后套用传统的多数投票,那么多拓扑的优势将会被大打折扣。面对四个 Agent 产生的冲突候选项,PoTRE 部署了任务自适应聚合层(Task-Adaptive Aggregation Layer),根据目标任务的模态特征匹配最合适的裁决策略。
对于规则高度严谨、模式基于归纳抽象的任务(如 ARC-AGI-2),PoTRE 启用了神经符号验证机制(Neuro-Symbolic Verifier)。聚合模型不会依赖直觉打分,而是被要求直接将存活候选的变换规则,带入任务自带的示例输入输出对中进行回测验证。系统会严格核对候选网格是否一致无误地执行了核心规则。在此过程中,聚合层甚至被允许抛弃纯文本解释,直接输出严格的 JSON 格式数据,从机制上根除了自圆其说的文本幻觉。
而在高自由度的金融与法律任务(如 PRBench)中,聚合层则转变为“专家法官”,采取建设性综合(Semantic Synthesis)路线。它不是在几个答案中二选一,而是从各个 Agent 的推导中抽取最严谨的计算步骤、最规范的合规陈述以及最清晰的格式结构,并在检测到数据矛盾时主动发起逻辑审查,重构出一份超越任何单一 Agent 水平的“超级综合解”。至于严格闭卷的客观题目,聚合层则利用提议的推导依据(Rationales)进行跨 Agent 交叉质询,精准挑选论证链条最完整的那一项。
实验印证:轻量模型的“脚手架跃升”
在评测设计上,PoTRE 选取了三项公认难以通过单纯记忆作弊的顶级基准:考察人类跨学科知识巅峰的 Humanity’s Last Exam(HLE)、考察流体智力与新颖视觉抽象的 ARC-AGI-2,以及考察极端金融专业决策的 PRBench Finance Hard。
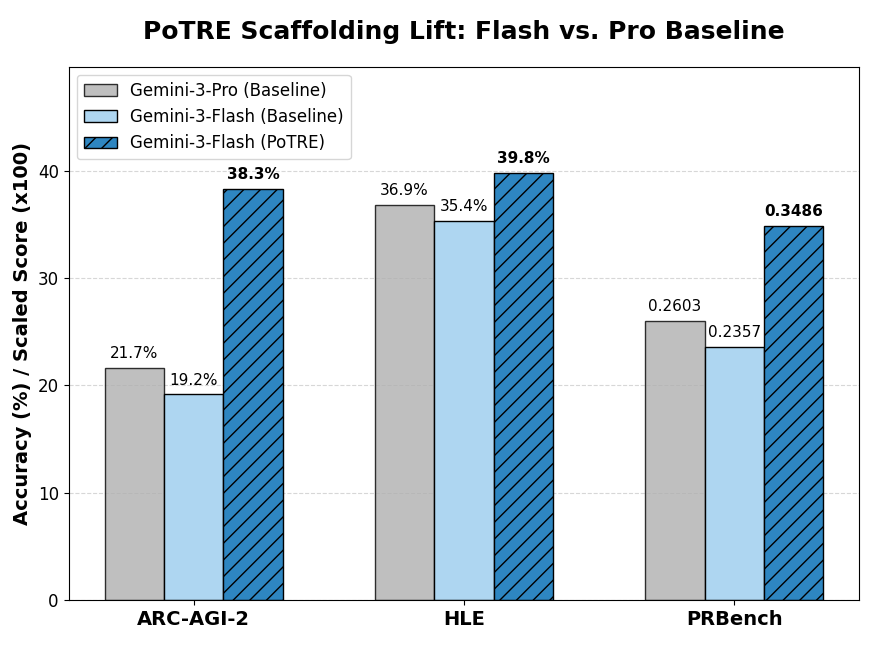
基准对比中最引人注目的发现,是研究团队总结的“脚手架跃升”(Scaffolding Lift)现象。在过去的认知中,大参数模型在深层推理上的优势几乎不可逾越。然而测试数据显示,当参数更轻、运行成本低廉的 Gemini-3-Flash-Preview 挂载了 PoTRE 异质脚手架后,其实际表现全面超越了未挂载脚手架的大参数旗舰 Gemini-3-Pro-Preview。
在 ARC-AGI-2 上,原生的 Gemini-3-Flash-Preview 准确率仅有 19.16%,即便加大计算量采样 16 次自洽解,准确率也停留在 36.67%。但在 PoTRE 的四分支协同与符号检验下,该模型的得分直接跃升至 38.33%,实现翻倍,并击败了 Gemini-3-Pro-Preview 的单次通过表现(21.66%)。在 Pass@2 的规则评测下,搭载 PoTRE 的最新 Gemini-3.1-Pro-Preview 更是从 78.33% 飙升至 86.66% 的公开评测新高。
在极具挑战的 Humanity’s Last Exam(HLE)上,未强化的 Gemini-3.1-Pro-Preview 基线成绩为 42.15%,而接入 PoTRE 框架后得分达到 49.92%,实现了 7.77 个百分点的实质性提升。即便是使用 Gemini-3-Flash-Preview 运行 PoTRE,其成绩也达到了 39.80%,逼近了许多常规大模型的水平。
而在需要严苛逻辑计算与文本推断的 PRBench Finance Hard 上,评分标准采用 Scale AI 的平均截断分(Average Clipped Score)。原本大参数模型 Gemini-3-Pro-Preview 的得分仅为 0.3266,但在 PoTRE 的构架赋能下,轻量的 Gemini-3-Flash-Preview 实现了 0.3486 的得分,反超了前者的基线水准。这一组实验充分说明:推理阶段合理的拓扑结构编排,在特定边界内足以弥补底层原始参数量的差距。
异质性的本质:救回被误杀的“少数派”
为什么打破同质性能够带来如此显著的收益?研究团队在 HLE 数据集上针对多 Agent 候选分歧展开了定量剖析。
他们将题目按 Agent 输出的分散程度划分为低分歧(1–2 个独特答案)与高分歧(3–4 个独特答案)。统计表明,在高分歧场景下,“至少有一个 Agent 生成正确答案”的比例(Oracle 覆盖率)大幅提升。这证明 Agent 之间的观点撕裂并不是盲目的噪声扩散,而是系统确实在未知空间里踩中了正确的真理孤岛。
更加直击痛点的验证在于“少数派挽救率”(Minority Recovery Rate)。团队筛选出了最具挑战的对抗性切片:在这些样本中,至少有一个 Agent 得出了正确结论,但在数量上被其余错误 Agent 组成的虚假联盟绝对压制(例如 1 对 3,或 1 对 2 对 1 的局面)。在传统的多数投票规则下,这种样本的通过率必然为 0%。
然而,依靠具备推理反思能力的自适应聚合层,PoTRE 展现出了惊人的纠错韧性。测试表明,在完全不同风格的聚合提示词下,系统均能保持约 29.21%(标准差仅 4.13%)的概率力排众议,从被否决的少数派中精准捞出正确的逻辑。这表明该框架的优越性并非源自某种特定 Prompt 带来的巧合,而是认知异质性生成的候选池为聚合层提供了足够丰富的辨析线索,使得依靠逻辑论证击败数量优势成为可能。
推理效率与未来范式
在推理期算力极其昂贵的工业落地上,PoTRE 展现出了弹性的帕累托优化空间。研究指出,PoTRE 并非必须在所有场景下完整运行全量分支。通过模块化分析特定任务的错误类型,开发者可以实施定向剪枝。例如,在某些特定的计算密集型任务中,合理剔除容易引起综合干扰的子分支,不仅能缩减高达 85% 的 Token 消耗,还能因为减少了低效噪声对聚合层的误导,反向提升最终准确率。
长期以来,业界对推理能力的探索往往偏向单一维度的纵向堆叠:要么通过后训练(RLVR)把模型的思维链越拉越长,要么通过长上下文大一统模型集中吸收海量背景。PoTRE 则给出了另一种横向的工程哲学:大模型的推理困境并不全因模型“不够大”,而是因为思考方式“太单一”。通过解耦对抗细化、分层重构、广度探索与基础直觉,并以自适应的逻辑层完成跨视角整合,轻量模型同样能够在最前沿的智力基准上展现出超越重型模型的推理韧性。这种以拓扑异质性换取深层逻辑可靠性的路线,为下一代 Agent 架构和推理期算力的高效配置提供了一条极具说服力的可行路径。