RAGEN-2揭秘:打破Agent强化学习“模板坍塌”,SNR过滤机制破局
RAGEN-2: Reasoning Collapse in Agentic RL
当你满怀期待地用强化学习训练多轮大语言模型 Agent 时,监控大屏上的指标可能正在欺骗你。 通常业界习惯用“熵”来衡量模型推理的多样性与稳定性。 当熵稳如泰山时,你以为模型正在积极探索不同的解题路径。 然而在实际测试中,Agent 却常常表现得像一个背诵万能公式的机器人。 面对千变万化的输入问题,它吐出的推理过程看似丰富,实则毫无针对性。
ArXiv URL:http://arxiv.org/abs/2604.06268v1
这种诡异的“伪多样性”究竟是怎么回事? 近期,来自帝国理工、微软等顶尖机构的研究团队在 RAGEN-2 论文中揭露了这一未解之谜。 该研究精准定义了这种名为 模板坍塌(Template Collapse)的系统性失效模式。 本文将带您深入剖析这一现象的微观机制,并解读研究团队如何巧用信噪比视角力挽狂澜。
破除虚假繁荣的监测盲区
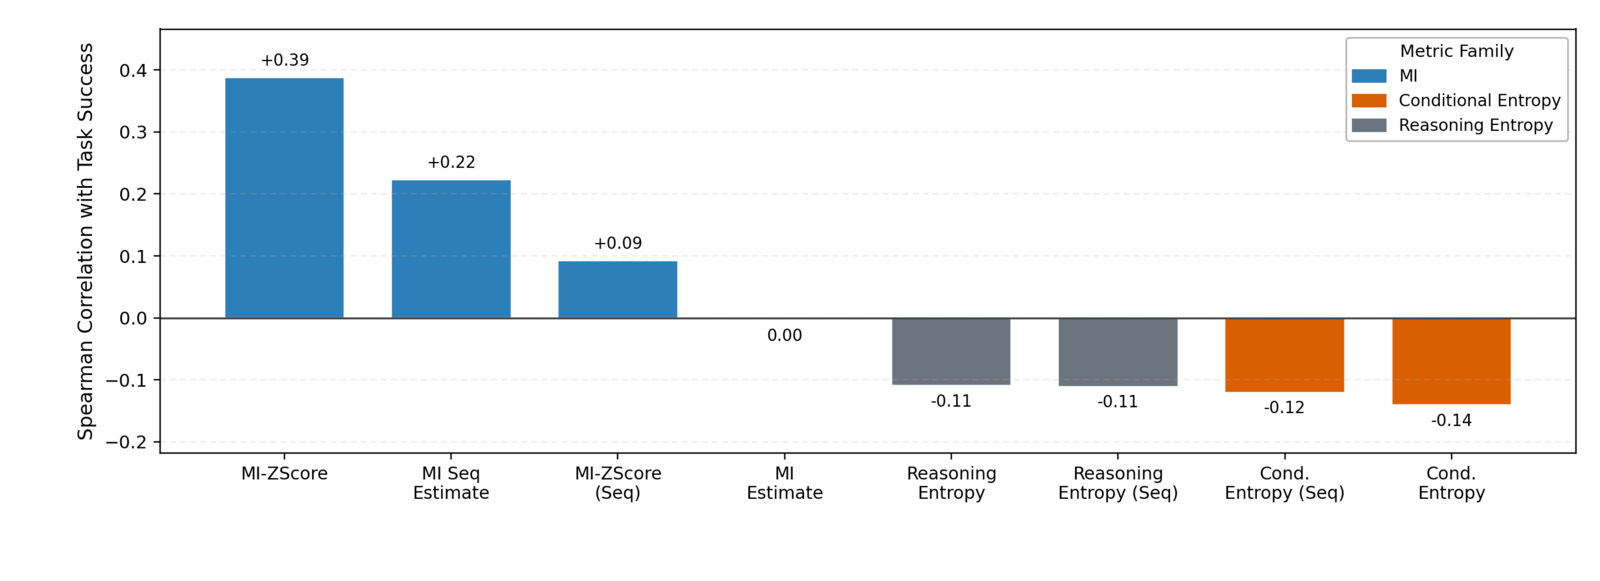
在多轮强化学习训练中,为了保证策略不至于过快收敛到次优解,研究者常持续监控熵值。 只要熵没掉,似乎就证明模型的思维依然活跃。 但该研究一针见血地指出,传统的条件熵仅仅衡量了单一输入下的内部多样性 $H(Z\mid X)$。 它对跨越不同输入的推理差异毫无察觉。
在长期的参数更新中,模型摸索出了一条捷径。 它学会了生成一套在自身逻辑上看似多变,但实际上与外部输入完全脱节的通用模板。 现有的监控指标根本无法识别这种高级别的“偷懒”行为。 为了彻底撕下这层伪装,研究人员将推理质量进行了降维拆解。 他们引入了信息论中的经典概念构建诊断代理:互信息(Mutual Information, MI)。
互信息 $I(X;Z)$ 犹如一台高精度的透视仪。 它直接测量模型的推理链条与初始 Prompt 之间的绑定深度。 为了在训练时实现在线诊断,研究设计了一套基于批次内交叉评分的互信息代理指标体系。 在多领域的跨任务测试中,数据显示,互信息与最终任务成功率的相关性具有压倒性优势。 它证明了只有互信息才是反映真实推理能力波动的金标准。
信噪比博弈视角的机制拆解
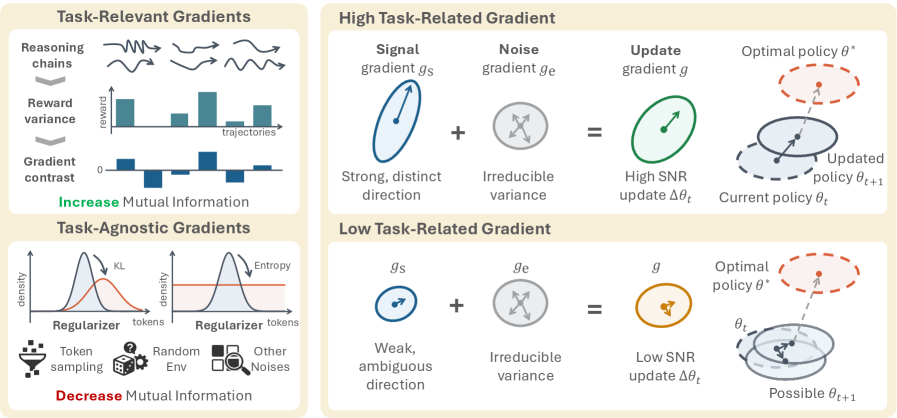
仅仅发现问题是不够的,为何强大的 RL 算法会陷入如此尴尬的境地? 本文巧妙地引入了 信噪比(Signal-to-Noise Ratio, SNR)的视角。 我们不妨将强化学习的策略梯度更新比作一场依靠回声定位的暗夜航行。
在这场航行中,“任务梯度”就是指引模型逼近正确答案的回声信号。 而为了维持输出流畅和防止崩溃所加入的各种正则化项(如 KL 散度和熵正则化),则是无处不在的环境风暴噪音。 当模型针对同一个问题生成了多个回答,且这些回答的得分差异极小时,问题就出现了。 这意味着 内部奖励方差(Reward Variance)极低,使得引导模型的任务信号变得极为微弱。
此时,导航系统彻底陷入了低信噪比状态。 微弱的回声信号被震耳欲聋的风暴噪音彻底淹没。 每一次参数更新,模型听从的不再是任务本身的指引,而是正则化项那种无差别的均值收缩拉力。 日积月累,模型彻底放弃了对具体输入的思考,开始用同一套万能模板应付所有任务。 这就是模板坍塌在梯度层面的微观物理过程。
轻量级应对策略的工程突围
既然病根在于低奖励方差带来的信噪比失衡,解法自然也就呼之欲出。 我们无法轻易消除正则化噪音,因为那是维持模型不崩溃的底线。 但我们可以主动选择在信号最强的时刻进行航向修正。 基于此,研究团队提出了一种极具工程美学的干预手段:信噪比感知过滤(SNR-Aware Filtering)。
该机制在每次迭代进行策略更新前介入管线。 当系统收集完当前批次的轨迹后,它会快速计算每个 Prompt 对应的内部奖励方差。 在这里,奖励方差被精妙地用作衡量信噪比的轻量级探针。 系统将所有 Prompt 按方差大小排序,无情剔除那些方差低、噪音大的劣质样本。 只保留排名前列的高信号 Prompt 参与后续的策略参数更新计算。
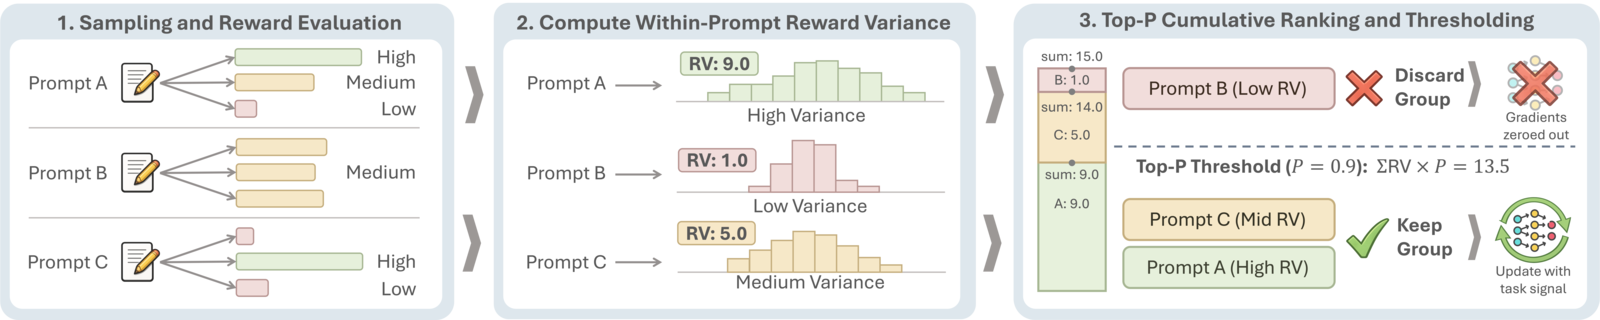
这种做法极其优雅且成本低廉。 它不需要训练额外的昂贵奖励模型,也不消耗宝贵的推理算力去生成新的验证轨迹。 只需在现有的大模型强化学习流水线中增加一层轻量级的过滤逻辑,就能切断模板坍塌的病理循环。
跨领域评估的实证支撑
为了验证这一机制的普适性,研究团队在 RAGEN 测试平台上进行了严苛的考验。 实验环境横跨了四个差异巨大的核心决策领域: 其中包括具有不可逆动作特性的推箱子游戏,以及充满随机状态转移的 FrozenLake 导航。 还包含了需要严密逻辑的 MetaMathQA 符号推理,甚至扩展到了基于代码执行的 DeepCoder 任务。
在 Qwen2.5-3B 模型的基座上,无论是传统的 PPO 还是近期火热的 GRPO 算法,都未能幸免于模板坍塌的魔咒。 随着训练步数的增加,模型的推理长度往往出现断崖式下跌,互信息指标也随之萎缩。 然而,一旦部署了 SNR 感知过滤,整个训练局势迎来了戏剧性的扭转。
数据显示,在同样的采样预算下,采用过滤机制的模型成功率实现了跨越式的攀升。 更为关键的是,模型真正学会了“对症下药”。 通过追踪不同干预手段下的动态指标轨迹,研究人员发现了更为深刻的训练规律。
单纯地调节 KL 惩罚系数或者放大熵正则化的权重,往往是徒劳无功的。 这些常规的“头痛医头”操作确实能让熵值产生波动,但互信息指标却如同死水一潭。 这意味着模型只是换了更花哨的废话模板,并没有真正深入理解任务约束。 相比之下,SNR 感知过滤犹如一记精准的手术刀,成功牵引着模型沿着互信息和性能双重增长的正确轨迹演进。
落地考量边界探索
任何优雅的学术理论在工程落地时都需要面对现实的摩擦力。 尽管 SNR 感知过滤在多数场景下展现了降维打击般的优势,研究团队也坦诚指出了其应用边界。
首先,利用奖励方差作为信噪比探针的前提是环境反馈具备一定的信度。 如果在极端恶劣的场景中,比如环境本身充满了海量的随机噪音,奖励方差就会失效。 实验表明,在 FrozenLake 中将环境随机性拉满至极限时,高奖励方差往往只是因为运气好,而非推理质量高。 此时过滤机制带来的性能增益就会被严重侵蚀。
其次,对于过滤阈值的把控也是一门工程艺术。 如果在训练初期采用过于激进的过滤策略,极易扼杀模型探索庞大状态空间的积极性。 这种对初期多样性的过度破坏,反而可能将模型推向更早期的局部最优解。 因此,探索动态调整过滤比例的退火策略,将是后续将该机制规模化落地的关键一环。
结语
随着多轮对话与复杂 Agent 任务步入深水区,传统强化学习算法在监督信号稀疏时的缺陷正在被无限放大。 RAGEN-2 论文为广大算法工程师提供了一份极其宝贵的避坑指南。 它深刻警告我们,千万不要被监控看板上平稳的传统指标蒙蔽了双眼。 引入跨输入的互信息诊断,并在参数更新环节坚决扼守信噪比底线。 这不仅是对现有训练管线的一次重要修补,更是通向具备真实逻辑推理能力智能体的必经之路。