SCAFFOLD:打破两层浅层抽象,递归技能蒸馏让Web Agent狂飙17分
SCAFFOLD: Self-Improving Web Agents via Recursive Parametric Skill Abstraction
现有的网页智能体(Web Agent)在执行跨页面、长流程任务时,往往陷入一个尴尬的怪圈:完成一次航班预订或商品下单后,智能体积累的过程性经验就被直接丢弃;下一次面对结构极其相似的任务,它依然要从最底层的点击、输入、滚动重新试错。
ArXiv URL:https://arxiv.org/abs/2609.05511
近年来,以技能归纳(Skill Induction)为代表的自进化框架试图改变这一现状,通过为智能体建立“技能库”来复用动作序列。但这些方案很快遇到了瓶颈。现有的技能库大多只是扁平的 Prompt 缓存或简陋的“通用/专用”两层结构,既不支持技能之间的递归调用,也缺乏冗余压缩机制,导致技能库随着探索极速膨胀、充斥大量死记硬背选择器的无效代码。更致命的是,这些经验只停留在外挂上下文里,底座模型的权重毫无长进。
针对这些根本缺陷,来自 MBZUAI、麦吉尔大学等机构的研究团队提出了 SCAFFOLD 框架。通过多实例参数化抽象、递归组合、基于最小描述长度(MDL)的库压缩,以及周期性的权重蒸馏,SCAFFOLD 彻底打通了从“动作轨迹”到“深层程序抽象”再到“模型内生能力”的自进化闭环。
在 WebArena、VisualWebArena 以及 Online-Mind2Web 测试集上,SCAFFOLD 相比此前最强的技能强化学习基线实现了 $11.1$ 至 $17.2$ 个百分点的绝对成功率提升,且在连续 5 轮自进化迭代中保持单调增长,彻底打破了以往智能体在 2 到 3 轮迭代后迅速饱和的“自进化魔咒”。
为什么扁平的技能缓存走不远?
要理解 SCAFFOLD 的改变,需要先厘清目前网页智能体在经验积累上的三种主流范式:轨迹回放、工作流总结与技能合成。
轨迹回放通过 RAG 机制检索历史相似成功样本,但原始轨迹充斥特定页面的噪声;工作流总结将其抽象为自然语言提示词,但模糊的文本提示在面对复杂交互时缺乏执行精度。技能合成方法向前推进了一大步——它直接将交互序列转化为可执行的参数化程序或 API,使得行为复用变成了确定性的程序调用。
然而,现存的技能合成体系存在三大约束:
第一,抽象层次严重受限。现存方法要么将所有生成的 API 塞进同一个扁平池子(如 SkillWeaver),要么人为划定死板的两层架构(如 SkillRL),技能无法递归调用其他技能,抽象深度天然被锁死在 1 级或 2 级。面对“跨平台比价后下单”这类长程任务,智能体无法像人类程序员一样进行模块化拆解。
第二,缺乏原则性的技能库压缩与维护机制。持续学习过程中,智能体不断将新探索固化为技能,导致大量只有细微选择器差异的重复技能塞满上下文(例如出现针对不同页面的数种登录技能),不仅拖垮检索效率,还在提示词中引入严重干扰。
第三,经验外挂而底座停滞。所有程序经验都停留在上下文提示词中,底座视觉语言模型(VLM)本身的策略权重自始至终没有改变。当上下文窗口被占满、遇到从未见过的交互形态时,底座模型依旧脆弱不堪。
五步闭环:SCAFFOLD 如何实现真正的自进化?
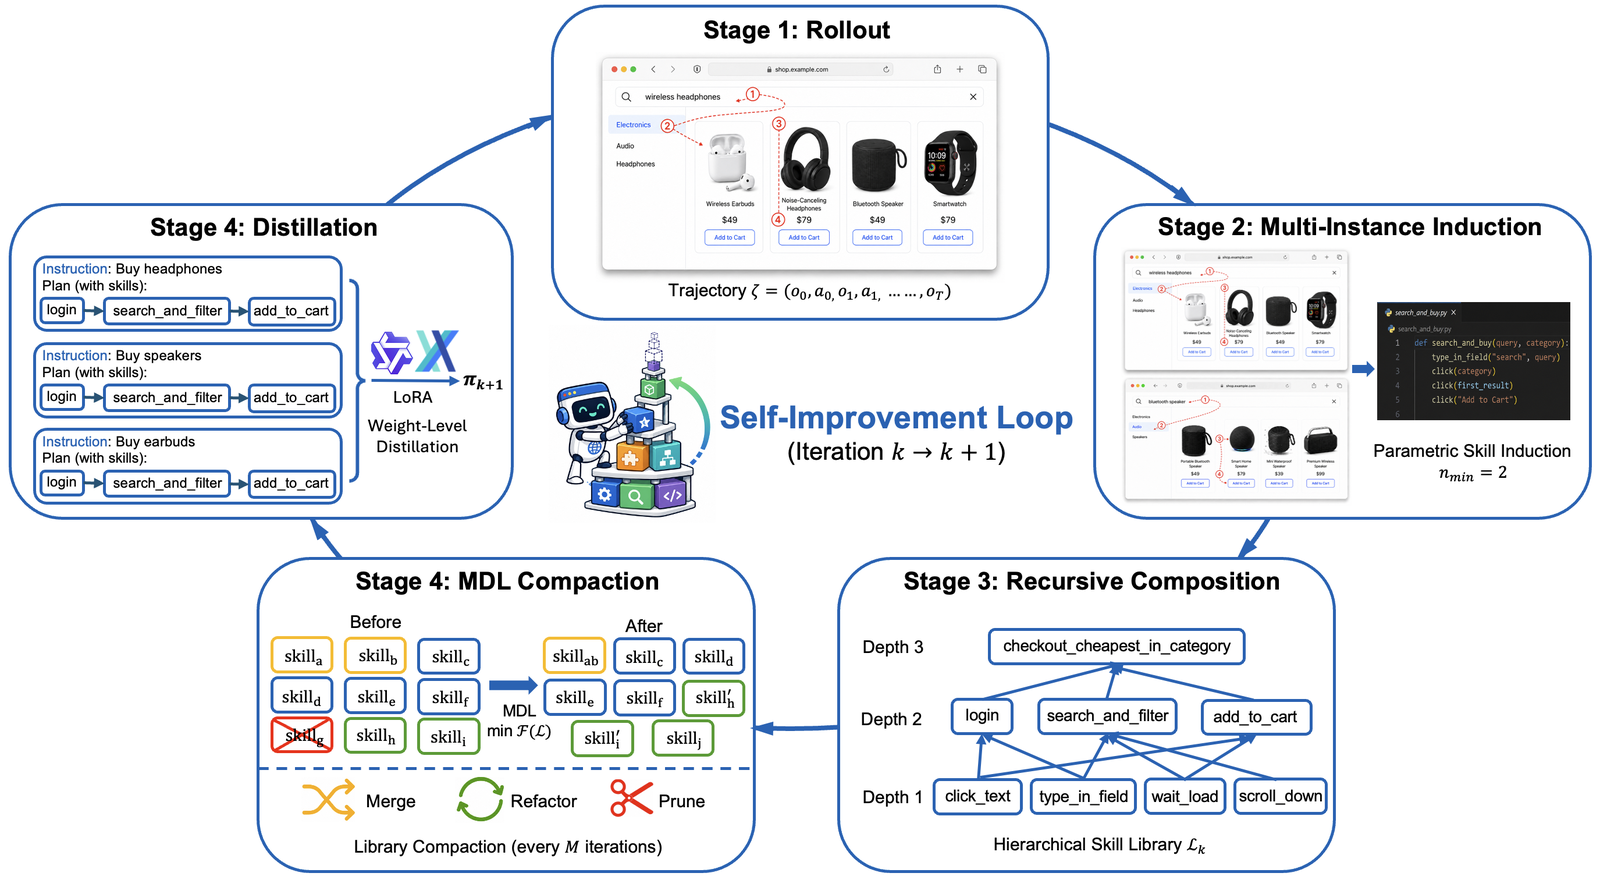
为了从根本上化解上述矛盾,SCAFFOLD 将每一次自进化迭代拆解为严格时序推进的五个阶段(如上图所示):环境交互采样、多实例技能归纳、递归技能组合、MDL 驱动的技能库压缩,以及最终的策略蒸馏。
1. 约束归纳:杜绝偶发细节的伪抽象
以往工作流归纳极易过拟合:智能体仅凭单次成功轨迹就仓促提炼出一个技能,把特定页面硬编码的元素 ID 或临时文本写进逻辑,换个页面直接报错。SCAFFOLD 引入了多实例参数归纳约束(Multi-Instance Parameter Induction)。
一个候选技能要想被接纳,必须至少在 $n_{\min}$(实验中设为 2)条语义相似的成功轨迹中同时得到验证。提炼出的技能定义为半参数化元组,包含前置条件、执行体、后置条件以及抽象深度 $d_\sigma$。其中控制流由轻量程序保证,而参数中的语义元素描述(如“搜索输入框”)在运行时交由小型 VLM 结合当前视线进行运行时动态定位,兼顾了程序流的确定性与视觉界面的泛化性。
2. 递归组合:允许高阶技能调用低阶技能
在第 $k$ 轮迭代中,归纳器在合成新技能时,被允许自由调用前 $1, \dots, k$ 轮中沉淀下来的任意已有技能。新技能的抽象深度被显式建模为:
\[d_{\sigma} = 1 + \max_{\sigma^{\prime} \in \text{calls}(\sigma)} d_{\sigma^{\prime}}\]这意味着,智能体可以在第 1 轮提炼出基础的 search_dates,在第 2 轮提炼出 fill_passenger_info,并在第 3 轮将它们与新生成的 confirm_payment 组装成高阶的 book_flight 复合技能。长链条交互得以被层层封装为简洁的高层调用,彻底释放了智能体在超长交互周期下的规划能力。
3. MDL 压缩:用最小描述长度重构技能库
为了防止技能库像滚雪球一样无限冗余,SCAFFOLD 引入了信息论中的最小描述长度(Minimum Description Length, MDL)准则。每隔固定周期($M=2$),系统会优化一个目标函数:
\[\mathcal{F}(\mathcal{L}) = \sum_{\sigma \in \mathcal{L}} \lvert \sigma \rvert + \sum_{\zeta \in \mathcal{Z}^{+}} \min_{\text{parse}(\zeta \mid \mathcal{L})} \lvert \text{parse}(\zeta \mid \mathcal{L}) \rvert\]该目标在“技能库自身体积”与“使用该库解析所有成功轨迹的数据复杂度”之间寻找帕累托最优。具体实现中,SCAFFOLD 结合了行为等价性校验:在多种扰动状态下测试两个技能是否表现一致,只有功能完全重合的技能才会被合并;同时提取重复出现的底层操作子序列重构成新的中层技能,并无情剔除滚动成功率低于 60% 或长期未被调用的僵尸技能。
4. 权重蒸馏:把外挂经验刻进模型参数
这是 SCAFFOLD 实现滚雪球式超越的核心一步。在获得紧凑的技能库后,智能体将带有高阶技能调用记录的成功轨迹转化为结构化训练数据 $(I, \text{plan}_{\sigma}, \zeta)$。
底座模型不仅通过监督微调(SFT)学习这些执行轨迹,还引入了一个辅助损失函数:仅基于用户指令 $I$ 与当前历史观测 $o_{0:t}$,直接预测下一个应该调用的技能名称。这一设计迫使底座模型将“何时调用何种高阶抽象”的认知完全内化。随着底座模型在第 $k+1$ 轮变得更强,它能够攻克此前无法解决的困难任务,进而为归纳器提供更长、更复杂的优质轨迹,驱动下一轮更高阶的技能抽象。
突破性能天花板:迭代不饱和,泛化无死角
研究团队在包含高度复杂交互的 WebArena、强化视觉推理的 VisualWebArena,以及跨越真实多站点的 Online-Mind2Web 上进行了全面评测,底座模型统一采用 Qwen2.5-VL-7B-Instruct。
实验表明,SCAFFOLD 在三大基准上全面拉开了与已有方案的差距:在 WebArena 上达到 $42.7\%$ 的成功率,在 VisualWebArena 达到 $36.3\%$,在 Online-Mind2Web 留出测试集上达到 $43.5\%$,比最强基准 SkillRL 分别高出 11.1、13.6 和 17.2 个绝对百分点。当底座替换为专为 GUI 优化的 UI-TARS-7B 时,平均表现还能再获得 7.5 个点的增益。
更具说服力的是其在演进动力学上的表现。以往的自进化系统通常在第 2 轮迭代就遭遇瓶颈,随着错误和冗余的累积,性能迅速走平甚至发生“技能库崩溃”。而 SCAFFOLD 在连续 5 轮迭代中,成功率曲线始终保持陡峭的向上走势。
这种单调增长的背后,正是递归组合与 MDL 压缩的相互支撑:
在未经压缩的对照实验中,技能库在第 5 轮时急剧膨胀至近 470 个碎片化技能;而在 MDL 治理下,技能总数平稳收敛在 181 个左右。与此同时,技能的平均调用深度从第 1 轮的 1.05 持续攀升至第 5 轮的 2.71(最大深度达到 5),技能复用率高达 64%(未经压缩的体系中该数字仅为 21%)。组合创造了长程执行所需的深度,压缩则捍卫了深度的纯粹性。
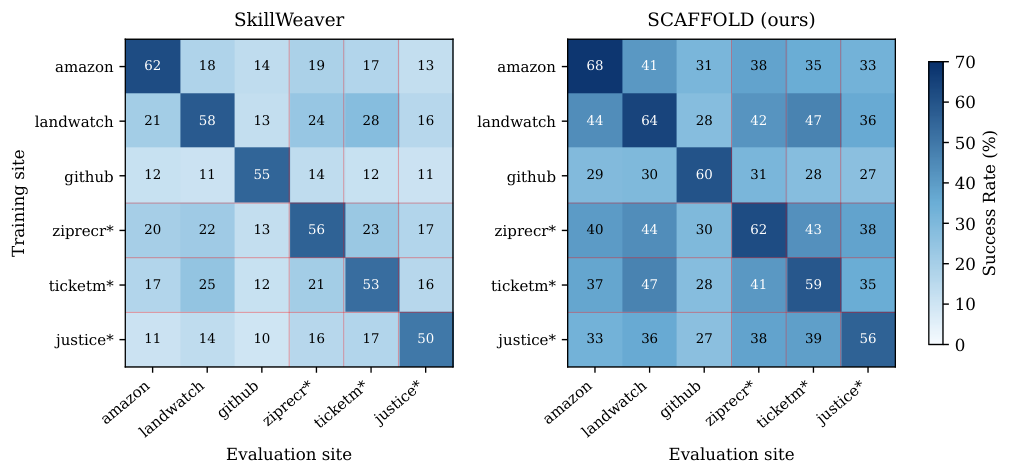
在评估模型泛化能力的跨站点迁移测试中,SCAFFOLD 同样展现出压倒性优势。如上图所示,在单站点训练并直接在未见站点零样本评估的 30 个非对角单元格中,SCAFFOLD 取得了 $35.9\%$ 的平均迁移成功率,比 SkillWeaver 的 $16.6\%$ 足足高出 $19.3$ 个百分点。
从深入分析来看,SkillWeaver 提炼出的代码深度绑定了具体站点的 DOM 选择器,一旦页面改版或换站直接失效;SCAFFOLD 归纳出的则是诸如 filter_results(query, sort_by, max_price)、paginate_until(condition) 这类具有清晰业务逻辑、且依靠语义属性动态绑定的参数化技能。例如从电商平台 Amazon 迁移到招聘网站 ZipRecruiter,尽管 DOM 与排版迥异,但“搜索 $\to$ 过滤 $\to$ 选择 $\to$ 确认”的程序框架完全一致,技能得以无缝复用。
消融实验进一步厘清了各模块的不可或缺性:剔除蒸馏环节导致 WebArena 上的成功率大跌 $8.0$ 个点,证明仅靠提示词外挂经验确实无法突破底座策略的表达上限;去掉递归组合能力则带来 $6.3$ 个点的下滑;而多实例归纳与 MDL 压缩虽然在单次评估上的绝对跌幅相对温和,却是维系系统在 5 轮长时间自进化中不发生雪崩的定海神针。四者协同所释放的红利,远大于各模块单打独斗的简单线性叠加。
总结
SCAFFOLD 的价值不仅在于刷新了几个基准榜单的分数,更在于为构建长期自主进化的复杂智能体提供了一套扎实的工程范式。
它表明,大模型智能体的自进化不能简单等同于“把历史轨迹当做上下文拼回去”,也不能局限于“机械地用强化学习刷短步轨迹”。真正的程序性知识沉淀,需要严谨的代码抽象、能够逐层嵌套的调用图谱、以及定期基于奥卡姆剃刀原理的重构与精简;而最终,这些在交互中淬炼出的高阶智慧,必须重新沉淀进模型的神经元权重之中。这套“探索—抽象—压缩—内化”的路径,或许正是通向真正通用 Web Agent 的必经之路。