SciCodePile:128GB多学科科学代码库与可执行基准,最强模型Pass@1仅12.30%
SciCodePile: A 128GB Corpus and Executable Benchmark for Challenging Scientific Code Generation
通用代码大模型在 HumanEval、MBPP 等主流基准上刷出 80% 甚至 90% 以上的高分早已屡见不鲜,但在计算生物学、量子化学、高能物理或材料模拟等科研计算场景中,这些“写代码高手”的表现却常常让人失望。科学计算的代码编写不仅仅要求语法正确,还深刻依赖复杂数值逻辑、特定学科语义以及跨模块的数据流规范。一段看起来完全合规的 Python 脚本,极有可能在矩阵维度对齐、能量单位换算或分子构型处理中出现隐蔽错误。
ArXiv URL:https://arxiv.org/abs/2607.19104v1
导致这一现状的核心瓶颈在于数据的两端脱节:在训练端,缺乏大规模、多学科覆盖且保留项目级语义的科学代码预训练语料;在评测端,现有的少数科学代码基准要么规模极小(如 SciCode 仅有 80 个核心任务),要么只测文本相似度而非真实运行验证。来自南京大学、新加坡管理大学、中山大学等机构的研究团队推出了 SciCodePile,构建了迄今为止规模最大的 128GB 多学科科学代码语料库,并配套推出了包含 200 个任务的可执行沙箱评测基准。
评测结果揭示了当前大模型在严谨科学编程领域的真实断层:在覆盖前缀补全、代码中间填充(FIM)及自然语言指令生成等任务中,哪怕是闭源的最强模型,在可执行基准上的 Pass@1 正确率也仅有 12.30%。
从 130 万仓库中淘金:多级过滤与四层对齐
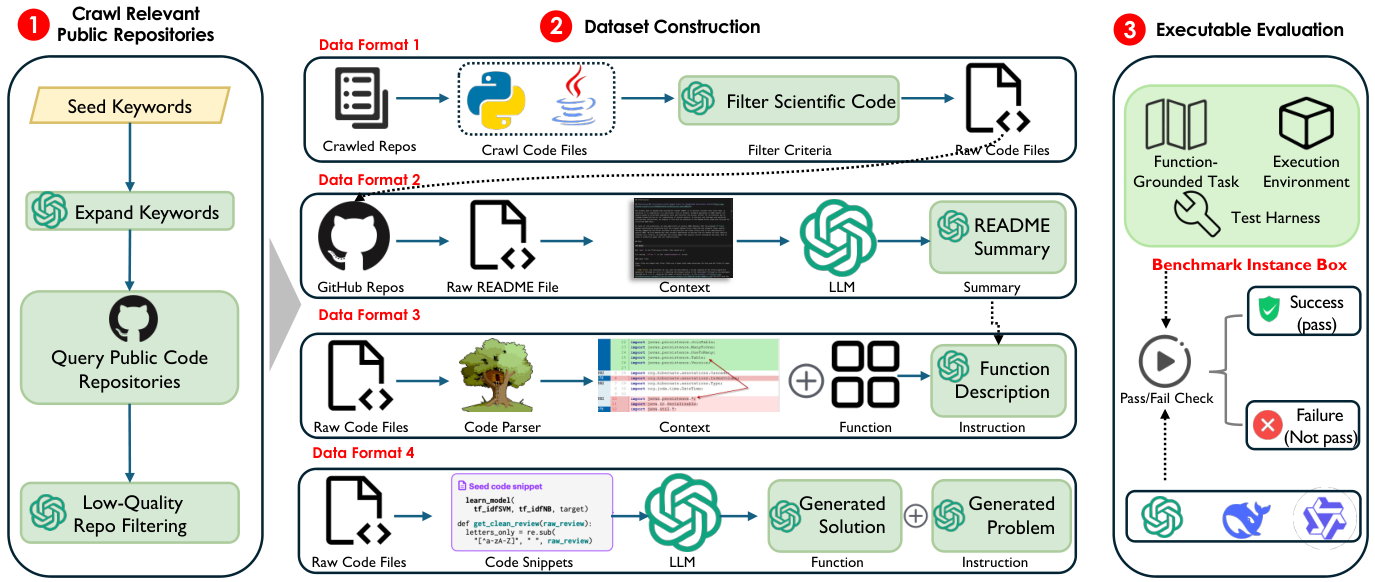
公开代码仓库(如 GitHub)固然包含了海量的开源项目,但单纯依靠关键词检索会引入海量噪声,例如作业库、纯说明文档或仅在 README 里提了一句科学名词的通用前端项目。为解决这一问题,研究团队设计了一套“检索-过滤”的高精度管道。
该管道始于研究者基于计算科学分类学制定的 198 个种子关键词,涵盖量子化学、生物信息学、药物代谢动力学、有限元分析以及科学 AI 建模等分支。通过大语言模型进行近义词、缩写与派生词扩展后,检索词库扩充至 213 个,最终在 GitHub API 中检索到 1,311,568 个候选仓库。研究人员通过硬性指标过滤掉低星(少于 10 星)和非源码项目,并引入 Qwen3-32B 对项目 README 进行深层语义判断,剔除挂羊头卖狗肉的虚假科学项目,最终保留了 37,737 个真正实现了计算科学算法与工作流的高质量仓库。
与以往仅仅切分代码文本的做法不同,SciCodePile 强调项目意图与代码实现的跨层级对齐,最终将数据重构为四种互补的格式(F1 至 F4):
-
F1(原始代码文件,125GB):包含 326 万个源代码文件,支持 Python、C/C++、Fortran、Julia 等核心科学编程语言。经过去除构建缓存、空白规范化以及 SimHash 近似去重后,专门用于大模型的领域继续预训练。
-
F2(README 结构化摘要,37,737 篇):利用大模型将冗长杂乱的项目说明文档提炼为五维结构化信息,包括项目目标、核心算法、依赖库、输入输出形式及运行时环境,为后续代码语义提供宏观锚点。
-
F3(函数级指令,50 万条,2.84GB):通过 Tree-sitter 语法树解析出真实函数,并使用领域嵌入模型计算“README 关键词相似度 $\times$ 函数体关键词相似度”作为综合分 $Final_{score}$。结合 F2 上下文,利用 ChatGPT-5 生成受控描述,并由科学领域专用模型 NatureLM 进行双向一致性验证。
-
F4(问题-解答对,2 万条,496MB):借鉴 OSS-Instruct 思想,从 F3 中抽样函数切片,结合上下文意图合成多样化的自然语言编程指令及实现方案,配合代码风格改写和多样化解码,专攻后续的指令微调。
这种多粒度数据组织方式,打破了以往大模型学习开源代码时“只见函数实现、不见工程意图”的信息孤岛。
拒绝文本匹配:打造可执行的科学代码沙箱
代码评估领域长期存在一个误区:过度依赖 CodeBLEU、BLEU 这类基于 token 重合度的指标。在通用领域这尚可作为粗筛,但在科学计算场景中,变量重命名、数学公式等价变换或中间变量缓存都会严重拉低文本分数,而一段语法正确但数值收敛条件写错的代码却可能拿到极高的 CodeBLEU。
为了评估代码的真实功能有效性,研究团队从高分 F3 函数中提炼出纯函数,转换为类似 HumanEval 形式的提示词,并配套自动合成了最小化执行环境与测试套件。测试断言由专门模型生成并替换了复杂的外部庞大依赖为轻量级桩代码(Stubs),确保所有任务均可在标准库支持的隔离子进程沙箱内自动执行。
经过严格的端到端运行验证与人工抽检审计,基准保留了 200 个完全可执行的挑战性任务,平均每个任务包含 7.3 个断言测试,彻底杜绝了依靠平庸实现侥幸过关的可能。
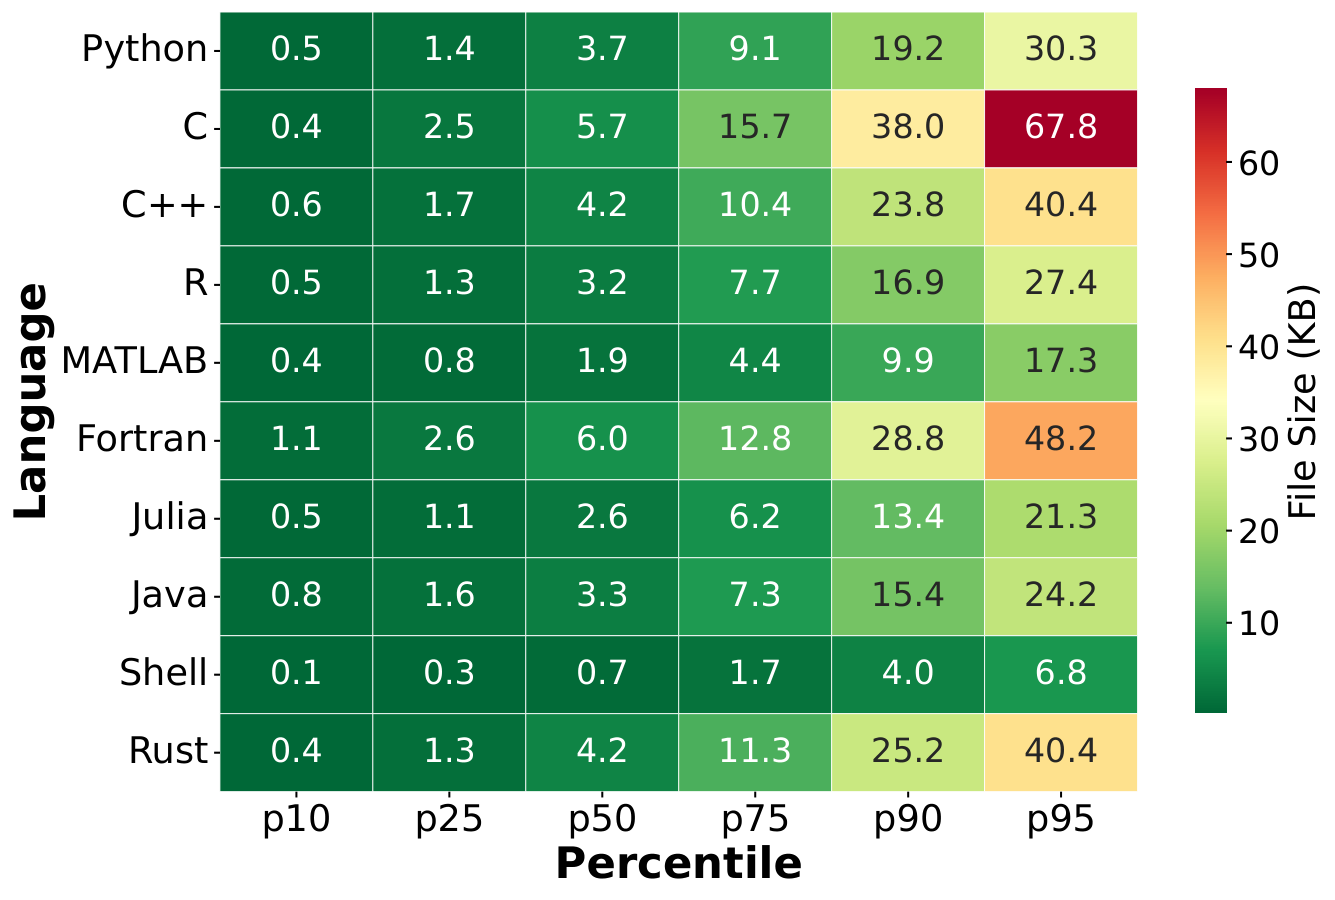
从统计特征来看,这一基准与传统通用编程测试存在质的差异。HumanEval 的提示词中位数仅为 51 个单词,且只有 3.7% 的题目含有科学术语;而 SciCodePile 的可执行任务提示词中位数达到 304 个单词,98.5% 的任务包含密集的专业术语(如 protein 出现了 103 次,pdb 出现了 65 次)。在语言与文件规模上,数据呈现出明显的科学计算特征:主导性能计算的 C 和 Fortran 文件的中位数代码行数在 200 行左右,95 分位数文件大小分别达到 67.8KB 和 48.2KB;而作为主流调度与胶水语言的 Python,以及 Shell、MATLAB 则展现出轻量分散的长尾分布。
15 款大模型实测:可执行通过率遭遇断崖式下跌
研究团队系统评测了 15 款涵盖开源与闭源的代表性大模型,任务涵盖前缀补全(PTS)、中间填充(FIM)以及基于自然语言描述的可执行代码生成。
在针对代码本身的重构与补全测试中(1,000 个采样文件),当前最先进模型的 CodeBLEU 分数停留在 38 分左右(前缀补全最高 38.13,中间填充最高 38.37),表明模型在面对复杂的科学算法流程和特定数学抽象时,生成参考级代码的难度远高于常规业务系统。
真正展现巨大鸿沟的是可执行基准测试。在必须通过所有断言测试才判定为正确的 Pass@1 指标下,即使是综合编程能力出众的闭源商业模型,表现最好的 GPT-5.4-mini 也仅仅取得了 12.30% 的 Pass@1 以及 15.50% 的 Pass@5。绝大多数主流代码模型在此基准下的通过率甚至徘徊在个位数。
错误分析表明,模型在科学编程任务中的失利很少是因为 Python 基础语法报错,主要失败原因集中在以下三类:
-
缺乏领域先验导致的数学及物理逻辑错误,例如在坐标转换、张量旋转矩阵或分子构象更新时混淆了空间维度;
-
对特定科学计算库的 API 接口约定、参数量纲以及隐式广播规则理解不准确;
-
无法在长链条的多步推演中维护复杂数据结构的中间约束状态。
这一惨淡的基准测试结果证明,通用代码领域的“大力出奇迹”并没有自然迁移为严谨的科学计算能力。表面流畅的代码,距离科研生产环境中真正可跑通、出正确结果的程序,仍有相当遥远的距离。
领域适配的威力:低成本微调带来显著增益
在揭示性能短板的同时,论文也验证了 SciCodePile 语料库作为训练养料的实际效用。受限于算力,团队进行了两组轻量级的适配验证实验:
其一是在通用小模型 GPT-2(124M)上,使用 125GB 的 F1 源码语料进行领域继续预训练(Continued Pretraining)。实验显示,该模型在科学代码补全任务上的 CodeBLEU 直接提升了 2.84 倍。这表明底层科学代码独特的符号分布、变量命名习惯与数值实现模式,能够通过继续预训练被模型快速捕获。
其二是在开源代码小模型 Qwen2.5-Coder-0.5B 上,利用多粒度对齐构建的 F3 与 F4 指令微调数据进行对齐训练。在 200 个沙箱任务的可执行基准上,该模型的 Pass@1 通过率从原先的 1.90% 直接跃升至 9.10%,实现了 4.79 倍 的性能增长。
这一结果传递出明确的技术信号:现阶段大模型在科学计算上的低能,核心症结并不在于模型结构本身,而在于预训练与后训练阶段严重缺乏高纯度、结构化且包含工程意图约束的领域数据。即便只是参数量极小的 0.5B 模型,在注入高质量科学代码指令对后,也能表现出逼近甚至超越部分数倍于其体积的通用模型。
随着 AI for Science 逐步由理论算法研究转向日常科研工程落地,构建能够辅助科学家编写严谨仿真脚本、分子动力学模拟插件和数据分析管道的专用辅助工具已是必然趋势。SciCodePile 开源的 128GB 多学科清洗语料、对齐指令集以及这套配备沙箱测试用例的评测基准,为后续科学代码大模型的研发铺设了扎实的基础设施。