SCOUT:超长第一人称视频理解新机制,自检恢复打破单向缩放提升9.1分
SCOUT: Self-Checking and Recovery-Aware Tool-Thought Agents for Ultra-Long Egocentric Video Reasoning
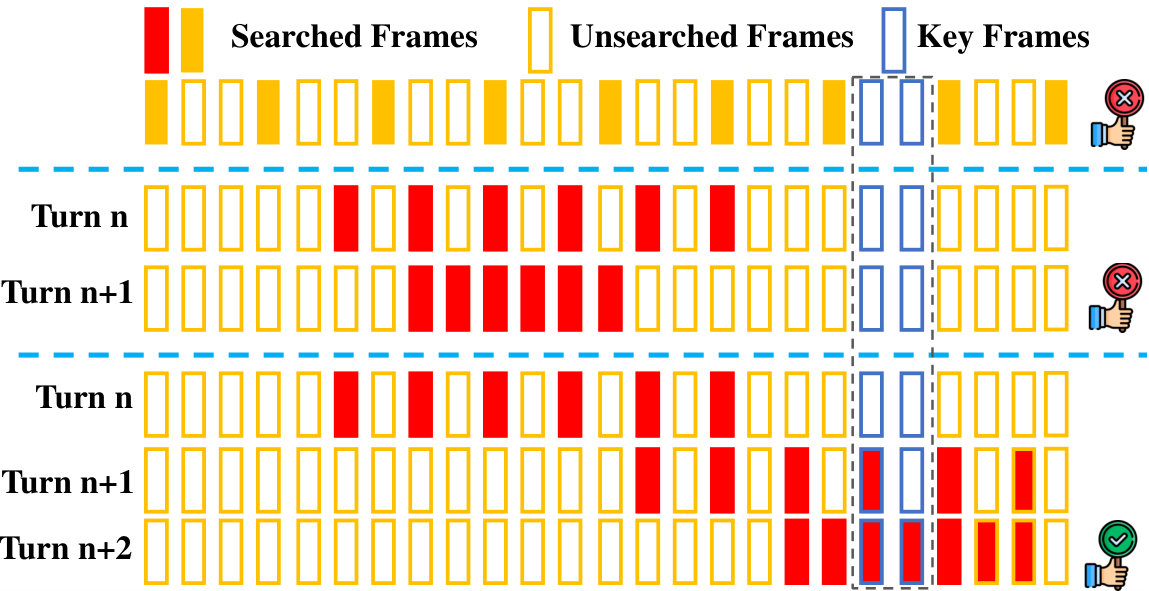
处理数十小时甚至数天的第一人称(Egocentric)视频,正在把多模态大模型推向能力边界。在可穿戴设备持续记录的场景下,与问题直接相关的视觉证据在时间轴上极度稀疏,且往往需要跨越数小时的间隔进行多跳信息聚合。面对有限的上下文窗口,直接将整段视频塞入模型必然伴随严重新息损失;而业界近年来转向的工具思维链(Chain-of-Tool-Thought, CoTT)智能体方案,虽然允许模型按需调用时间检索、片段分析与单帧检测工具,却普遍受困于“过早做出不可逆承诺”的陷阱:一旦前序步骤锁定了错误的时间范围,系统便只会在该区间内单调地“放大”(Zoom-in),导致初始偏差不可逆地蔓延至终点。
ArXiv URL:https://arxiv.org/abs/2608.07959v1
针对这一瓶颈,OPPO 联合深圳河套研究院、中山大学及香港中文大学(深圳)的研究团队提出了名为 SCOUT(Self-Checking Chain-Of-Tool-thought)的具备恢复感知能力的智能体框架。SCOUT 不再将视频时间线检索视为单向的漏斗收缩过程,而是引入显式的动态自检机制,在工具返回的观测证据不足或不一致时,主动放弃当前区域并切换至其他候选区间。为了解决多轮工具交互下传统强化学习奖励稀疏、长程决策信用分配(Credit Assignment)困难的问题,研究团队同步推出了 UPS-GRPO 算法,通过不确定性优先选择策略将探索资源集中在工具调用后的关键决策点,并采用乘性调制的轮次级优势解耦技术,在不破坏全局优化方向的前提下为中间动作提供精准指导。
实验结果显示,以开源模型 Qwen2.5-7B 为底座构建的 SCOUT-7B,在长达 44.3 小时的连续第一人称视频基准测试中展现出极强的鲁棒性:在 EgoLifeQA 与 Ego-R1 Bench 上分别超越此前最强同类智能体基线 Ego-R1 达 9.1 和 6.0 个百分点,并且在 Video-MME 等常规长视频基准上保持稳健竞争力。这一成果证明,超长视频理解的核心不仅在于如何“精细化查找”,更在于当线索走偏时智能体是否具备“推翻假设重新探索”的自我修正能力。
为什么单向缩放会毁掉长程视频推理?
在传统的短视频问答中,视觉信息在密集帧采样下足以完整输入多模态模型;但在动辄持续数小时至数天的第一人称记录中,关键动作往往只持续几秒钟。如果依靠均匀下采样,关键帧大概率被直接漏掉;如果提高采样密度,Token 预算便会瞬间爆表。因此,将长视频理解重构成“智能体按需搜索”已成为共识。智能体利用文本时间检索工具粗筛区间,再调用视频片段工具缩小范围,最后调用单帧工具确认细节,直观上高度契合人类查阅长录像的直觉。
然而,现有智能体系统的致命缺陷恰恰藏在这一“从粗到细”的逻辑惯性中。在形式化定义中,假设智能体在第 $t$ 轮所维护的候选时间区间为 $S_t$,绝大多数 CoTT 系统隐式施加了单调子集约束:
\[S_{t+1} \subseteq S_t\]这意味着系统认定前一步选定的粗略时间窗口必然包含正确答案。但在超长第一人称视频中,初始检索工具面对模糊提问给出的候选区间具有极大的偶然性。一旦智能体在第一轮被伪相关线索误导,进入了错误的时间窗口,单调缩小策略便会导致模型在错误的几分钟内反复打转,甚至强行根据无关画面编造答案。由于缺乏回溯或横向跳转能力,这种“不可逆的早期承诺”(Irreversible Early Commitment)直接切断了模型获取真实证据的可能。
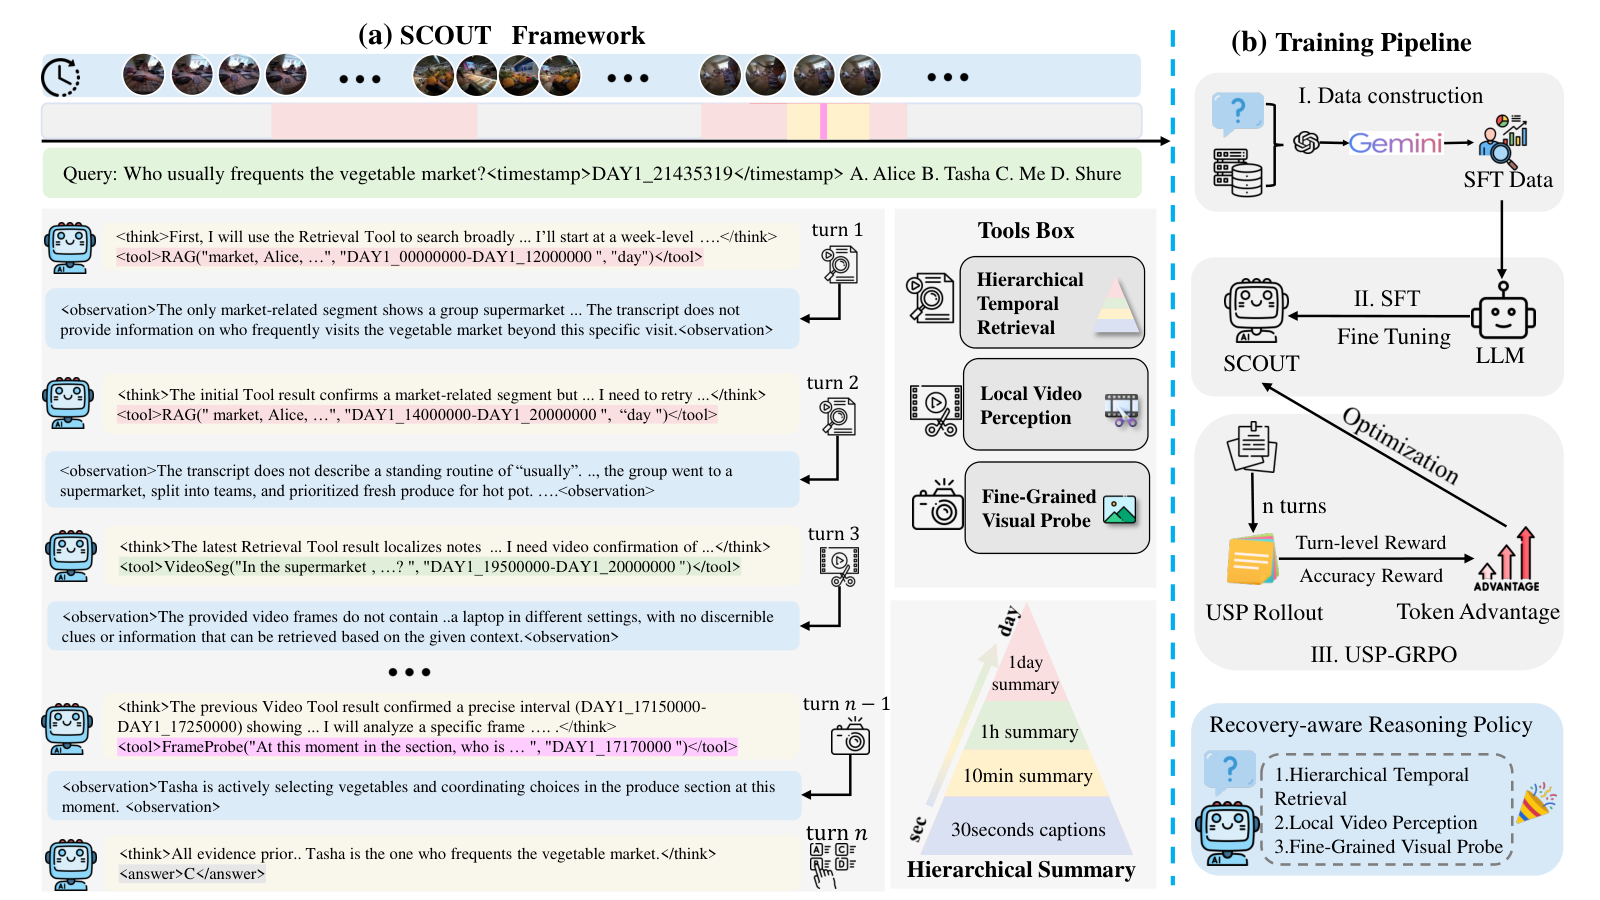
SCOUT 的核心机制:带自检与恢复的搜索策略
SCOUT 改变了状态转移的底层空间。它将动作空间扩展为非单调转换空间:
\[\mathcal{T}(S_{t})=\{S^{\prime}\mid S^{\prime}\subseteq S_{t}\;\;\text{or}\;\;S^{\prime}\sim S_{t}\}\]其中 $S^{\prime}\subseteq S_{t}$ 代表常规的局部放大细化,而 $S^{\prime}\sim S_{t}$ 则代表当前区间并非前序区间的子集,允许系统在时间轴上跳跃、扩张或彻底切换至全新区域。在整个交互回路中,系统配备了三种典型粒度的工具接口:基于文本的粗粒度时间检索工具 RAG、局部短视频片段分析工具 VideoSeg 以及单帧高分辨率图像检验工具 FrameProbe。
使非单调转移生效的核心是“自检策略”(Self-Checking Policy)。智能体在每一轮工具执行后,不仅提取观测结果中的事实信息,还要评估该信息与原始查询之间的相关性、充分性与一致性。如果局部短视频分析工具返回的内容与任务目标存在冲突,或者单帧验证发现目标物体根本未在该时间窗内出现,策略能够显式发出纠偏信号,判定当前时间假设失败,并将注意力切回到全局时间轴上重新探索其他候选段落。这种机制将盲目的单向流水线转变成了具备闭环反馈的假设检验系统。
UPS-GRPO:聚焦高不确定性决策点的强化学习
即便在架构层面赋予了智能体跳出局部最优的自由度,如何训练该策略依然是一大难题。在多轮交互任务中,工具调用的输出直接作为外部观测插入上下文中,造成显著的分布偏移(Distributional Shift)。特别是在工具返回结果之后的“后工具状态”(Post-Tool States),模型必须在“继续深入”还是“跳出重搜”之间做出高风险决断。标准强化学习算法如 GRPO(Group Relative Policy Optimization)在生成轨迹时,往往在整条序列上均匀分配采样算力,且依赖稀疏的终局正确性奖励,这会导致处于关键分叉口的中间动作无法获得有效的探索与精准的梯度反传。
针对这一特性,研究人员提出了 UPS-GRPO(Uncertainty-Prioritized Selection GRPO),从探索机制和信用分配两个维度重构了强化学习过程。
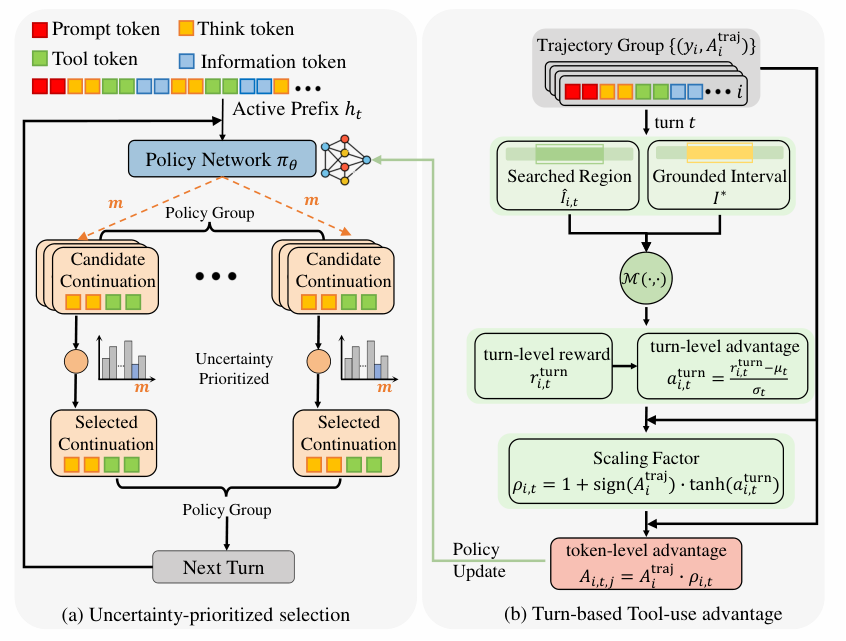
在不确定性优先选择(Uncertainty-Prioritized Selection)阶段,对于前序交互历史 $h_t$,模型首先采样 $m$ 条候选分支延续:
\[y_{t}^{(1)},\ldots,y_{t}^{(m)}\sim\pi_{\theta}(\cdot\mid h_{t})\]随后计算每一条分支在生成 Token 级别上的平均不确定性:
\[U\!\left(y_{t}^{(k)}\right)=-\frac{1}{\lvert y_{t}^{(k)} \rvert}\sum_{j=1}^{\lvert y_{t}^{(k)} \rvert}\log\pi_{\theta}(y_{t,j}^{(k)}\mid h_{t},y_{t<j}^{(k)})\]系统挑选出不确定性最高的那条分支 $k^{\star}=\arg\max_{k}U(y_{t}^{(k)})$ 作为后续交互轨迹继续推进。这种设计的巧妙之处在于,它没有机械膨胀全局 rollout 的样本规模,而是将宝贵的探索预算定点倾斜给那些模型最犹豫不决的决策分支,显著提高了多轮复杂环境下的采样效率。
在信用分配层面,长轨迹推理经常出现两种病态样本:一是最终答案碰巧答对、但中间搜索步骤完全混乱;二是中间检索精准锁定了核心线索、但最终生成答案时出现逻辑偏差。针对此,研究团队提出了“轮次级工具使用优势半解耦”(Turn-Based Tool-Use Advantage Semi-Decoupling)。通过将工具调用的时间区间 $\hat{I}{i,t}$ 与真实线索标注区间 $I^{\star}$ 计算重合度,系统可以为每一个交互轮次分配独立的显式时间对齐奖励 $r{i,t}^{\mathrm{turn}}$,并标准化为局部优势值 $a_{i,t}^{\mathrm{turn}}$。
最关键的权衡在于如何融合轮次奖励与轨迹级最终奖励。常规的加性奖励塑造(Additive Reward Shaping)直接将轮次奖励相加,极易引发局部收益与全局目标的冲突,导致模型为了刷取时间重合奖励而反复无意义调用工具。UPS-GRPO 采用了乘性调制(Multiplicative Modulation)机制:
\[\rho_{i,t}=1+\mathrm{sign}(A_{i}^{\mathrm{traj}})\cdot\tanh\!\left(a_{i,t}^{\mathrm{turn}}\right)\] \[A_{i,t,j}=A_{i}^{\mathrm{traj}}\cdot\rho_{i,t}\]通过利用双曲正切函数 $\tanh$ 将局部优势压缩,并与整条轨迹的优势符号 $\mathrm{sign}(A_{i}^{\mathrm{traj}})$ 绑定,中间工具的准确度只作为缩放系数来放大或抑制轨迹优势。当整条轨迹方向正确时,高重合度的工具步骤获得更强的正向强化;若最终结果彻底错误,优质的中间步骤也不会诱导全局走向歧途。这种软调节机制不仅维持了终局答案的主导地位,更赋予了中间推理步精细的分级反馈。
逆向注入:构建高质量自检与恢复数据集
为了让基础模型在启动强化学习前就掌握工具规范与自检语法,研究人员设计了一套三阶段合成流水线,构建出专用的 RA-CoTT(Recovery-Aware Chain-of-Tool-Thought)数据集。
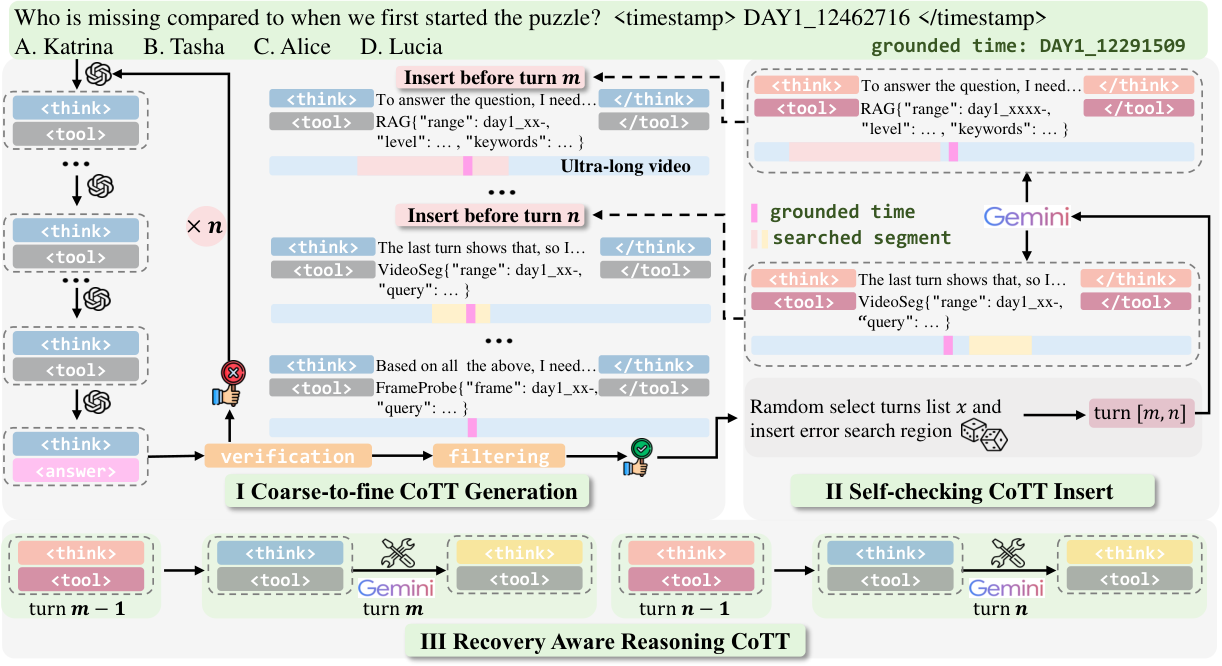
该数据合成流程的核心在于打破目前多模态数据集清一色“顺风顺水”的完美范式,主动向训练样本中植入逼真的失败状态与自愈轨迹:
-
从粗到细的基础轨迹构建:依托包含精准时间戳标注的 Ego-R1 与 CG-Bench 样本,利用 GPT-4o 严格生成符合“粗检-细查-验证”的标准正向轨迹,多次验证筛选出 2k 条终局答案与时间重合度完全正确的黄金样本。
-
人工注入错误搜索片段:借助 Gemini-2.5-Pro 在原有正确轨迹的关键轮次前强行插入与事实区间完全无关的扰动时间段,模拟现实检索中经常遇到的误检与虚假线索,使样本量扩充至约 6k 条。
-
注入恢复感知的自我修正推理:如果仅插入错误,随后的步骤会显得逻辑断裂。第三阶段的核心正是利用高级大模型重构错误轮次后的推理链,引导模型在文字推理中写出“发现该区间未出现目标动作,需重新扩大搜索”等显式自检逻辑,并将检索动作调整回正确区间。
最终生成的 8k 条 RA-CoTT 轨迹在监督微调(SFT)阶段为模型搭建了完备的交互语法骨架,教会了模型如何识别线索失败并在思维链中表达自我纠正。随后的 UPS-GRPO 强化学习则作为关键认知引擎,推动模型突破演示模仿的局限,学会在未知视频分布下灵活权衡探索与深挖。
实验评测与多维度验证
为验证 SCOUT 的综合能力,研究团队在涵盖不同时间跨度与视角的四大代表性长视频基准上进行了评测,包括以超长第一人称视频为主的 EgoLifeQA 和 Ego-R1 Bench、以小时级任务为代表的 HourVideo,以及以常规长视频问答为主的 Video-MME(long)。
在时间长达 44.3 小时的连续第一人称视频基准测试中,SCOUT-7B 的恢复机制展现出决定性优势。在 EgoLifeQA 上,SCOUT-7B 取得了 43.1% 的准确率,相较于此前表现最好的开源基准 Ego-R1(34.0%)大幅提升了 9.1 个百分点;在 Ego-R1 Bench 上同样取得了 49.0% 的优异表现,超越 Ego-R1 达 6.0 个百分点。与之形成鲜明对比的是,现有以单向粗细缩放为核心的智能体(如 TimeSearch-R、LongVT 和 DVD)在此类超长场景下性能发生了剧烈退化。例如,DVD 虽然在时长较短(平均 41 分钟)的 Video-MME(long) 基准上凭借密集的检索工程获得了 67.3% 的高分,但在转入真实的第一人称长视频 EgoLifeQA 时得分暴跌至 32.1%。这种落差直观地表明,静态单向的搜索流在短时长或结构清晰的视频中尚可应付,但一旦面对线索极度稀疏、跨度长达数天的多跳推理任务,缺乏自检与纠错机制的系统将几乎必然崩盘。
消融实验进一步厘清了系统各模块的贡献度。在训练范式层面,移除了 SFT 预热的 RL-only 变体在各项基准上全面垫底,模型甚至无法稳定输出正确的工具调用语法,经常产生格式混乱并误读外部环境的观测内容;而仅采用 SFT 的模型虽然能够按部就班地调用工具,但在面对训练集分布之外的长距离跳跃时泛化表现平平。SFT 提供了语法支架,而强化学习则真正赋予了策略自适应权衡探索深度的决策智能。
在奖励机制的消融对比中,研究人员将乘性优势调制方案换为直接的加性奖励塑造(Turn Additive Reward),结果导致模型在 Video-MME(long) 上性能从 63.0% 跌落至 61.4%,在 Ego-R1 Bench 上从 49.0% 下滑至 47.0%。指标下降的根本原因在于,纯加性奖励引发了轮次目标与终局目标的割裂,模型频繁出现为赚取中间重叠分而过早终止或盲目刷工具调用的投机行为。而在 UPS-GRPO 的算法对比中,移除不确定性优先采样机制后,整体收敛速度与最终准确率均出现了可观的衰减,证明了在长程决策中把采样算力聚焦在关键分歧点上的必要性。
智能体长视频推理范式的重要演进
SCOUT 为超长视频理解带来的核心启示在于,解决长视频建模的瓶颈并非只有一味扩充上下文窗口或堆叠更激进的视觉压缩率这一条路。在物理世界的超长时间流中,稀疏线索的查找本质上是一场动态的假设验证与信息博弈。
过去业界构建的视频工具调用智能体,大多默许了一个过于理想的前提,即“粗略定位总是大致正确的”。SCOUT 正式打破了这一虚妄的假设,通过非单调状态转移赋予了系统承认错误、跳出死胡同的能力;同时借助 UPS-GRPO 在强化学习层面为多轮工具调用的探索效率与信用分配给出了兼顾数学稳定性与工程可行性的方案。当未来的智能眼镜、具身机器人需要面对连绵不断的全天候视觉日志时,这种能够在不确定性中自我检验、动态撤回并重新定位线索的认知机制,将成为从被动视频播放器演变为真正具备行动力与推理能力的自主智能体的关键基石。