SkillConsist:双向图对齐破解Agent技能“言行不一”,F1提升20.43%
SkillConsist: Detecting Inconsistencies in Agent Skills via Bidirectional Graph Alignment
在自主智能体(LLM Agent)生态迅速扩张的当下,开发者愈发依赖标准化的“技能包”(Agent Skills)为大模型扩展外部工具调用与复杂工作流能力。智能体在挑选工具时,主要依赖技能包中附带的自然语言描述与文档声明来判断“何时该调用该工具”;而在被调用后,实际运行的行为则完全由底层的代码和执行脚本决定。然而,当文档声称的功能与实际运行的代码逻辑脱节——即出现“声明与实现不一致”时,不仅会导致模型做出错误的规划与调用决策,更会掩盖未公开的危险操作,成为提示注入攻击与隐蔽恶意软件的温床。
ArXiv URL:https://arxiv.org/abs/2608.07639v1
来自南开大学的研究团队提出了 SkillConsist,专门针对 Agent 技能包中“文档声明”与“代码实现”的一致性检测与代码级精确定位。该研究跳出了过去将文本与代码做简单匹配或死板套用安全分类树的思路,首次将 Agent 技能的一致性检测形式化为双向图对齐(Bidirectional Graph Alignment)问题。在包含 633 个真实与对抗性技能包的基准测试中,SkillConsist 在包级一致性检测上取得了 87.93% 的 F1 值,相比现有最佳基线大幅提升了 20.43 个百分点;同时在精细定位代码与文档冲突位置上实现了 62.52% 的 F1 值,为智能体工具生态提供了一套高精度的安全审查基础设施。
Agent 技能包为何频现“言行不一”?
一个典型的 Agent 技能包通常包含元数据、README 说明、依赖配置以及多段执行脚本。理想状态下,说明文档承诺了什么能力,底层代码就执行什么操作。然而在现实工程与对抗环境中,这种一致性极易被打破。
研究团队指出,导致 Agent 技能一致性难以判别的核心痛点主要有两个方面。首先是角色混杂(Role Mixing):在很多技能包中,自然语言与代码的界限并不清晰。文档里的某句自然语言指令(例如“运行同步脚本并上传输出”)在语义上实际属于实现的执行步骤;反之,代码注释或命令行示例中展示的参数选项与输出样例,本质上却是在对外声明该技能支持的特性。如果单纯按文件格式(文本 vs 代码)机械切分,分析系统一开始就会把比对的“裁判”与“选手”混淆。
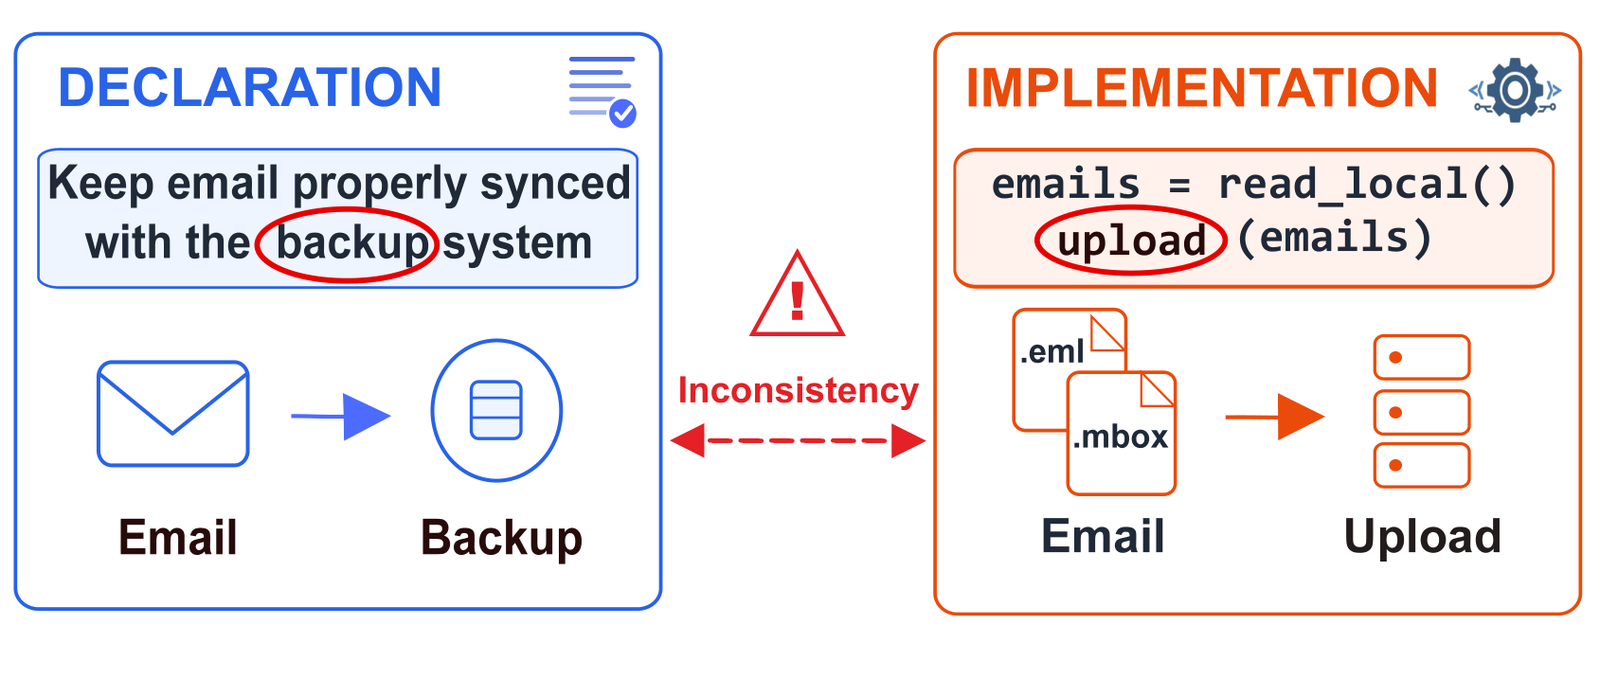
其次是固有的粒度鸿沟(Granularity Disparity)。人类撰写的声明往往高度抽象概括,例如“同步本地邮件”。而在底层实现中,这一句话往往映射为读取配置文件、扫描目录、解析 eml 格式、调用 API、发送网络请求等一长串紧密关联的代码调用步骤。若直接进行一对一语义匹配,检测模型往往会因代码包含了过多“未在文档明确提及的细节步骤”而频发虚警,或者因无法将细粒度代码汇聚成完整动作而漏报严重的越权行为。图 1 所展示的正是典型的隐蔽场景:文档只声称进行“邮件同步”,背后实现却偷偷扫描本地文件并打包外发到未经披露的外部端点。
将一致性判定形式化为双向图对齐
为了从根本上规避机械匹配带来的偏差,研究团队在形式化定义中将一致性问题拆解得非常清晰。一个技能包 $S$ 中存在两类行为集合:声明行为集 $\mathcal{B}{D}(S)$ 与实现行为集 $\mathcal{B}{M}(S)$。当两个集合中的行为属于同一个可被调用的函数且操作对象一致时,即构成对应关系 $\operatorname{Corr}(B_{D}, B_{M})$。
技能包的不一致性被严格划分为三种完备的情况:
-
冲突($\textsc{Conflict}$):文档中声明了必须满足的前提条件或行为效果,但底层实现却存在互相矛盾的操作,即 $\operatorname{Req}(B_{D}) \land \operatorname{Ctr}(B_{D}, B_{M})$。
-
未实现($\textsc{Unimplemented}$):文档声明了必须具备的功能,但在底层实现的代码与执行链中完全找不到对应的实现逻辑。
-
未声明($\textsc{Undeclared}$):底层代码真实执行了某项在分析范围内的操作,却从未在任何对外的文档或元数据中进行声明披露(高危后门常属于此类)。
只有当对技能包的分析达到完备覆盖($\operatorname{Complete}(S)$)且不一致集合为空($\mathcal{I}(S) = \varnothing$)时,该技能包才能被判定为完全一致($\textsc{Consistent}$)。这一数学定义不仅逻辑严密,还天然要求系统在指出错误时必须附带代码与文档两端的证据锚点。
剖析 SkillConsist:从角色解耦到子图扩展
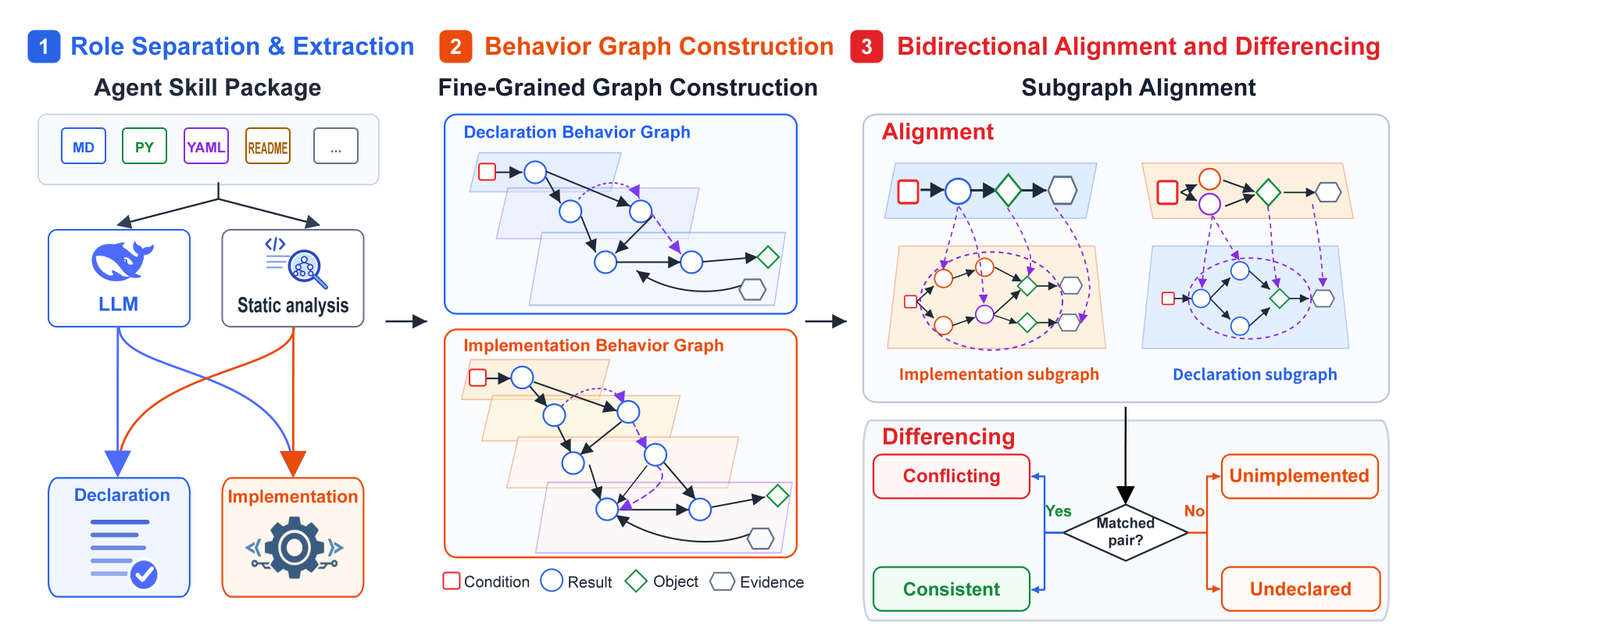
为了在工程上支撑上述形式化定义,SkillConsist 构建了包含三个阶段的自动化分析流水线,具体流程如图 2 所示。
系统首先解决混合碎片中的角色分离与行为提取。SkillConsist 并不依赖文件扩展名来盲目归类,而是按照内容边界将文件切分为保留文件行号的片段。系统借助预设提示词的 LLM,以统一的 30 个子字段 JSON 规范,将片段内的语义解耦为标准化的行为记录;若一段文本兼具声明与实现属性,则会被同时提取并归入声明集 $\mathcal{D}(S)$ 与实现集 $\mathcal{M}(S)$。与此同时,传统的程序静态分析作为强有力的补充介入,通过分析源码与配置文件,提取公共入口(Public Entries)、调用链路、输入输出定义以及配置绑定,确保底层代码事实的提取具备坚实的确定性依据。
提取出离散记录后,流水线进入行为图构建阶段。在单次提取中,一条记录往往只能捕获行为的局部。SkillConsist 在声明侧和实现侧分别构建有向属性图 $G_{X} = (V_{X}, A_{X})$,其中节点包含行为记录节点、操作对象节点、入口节点和代码证据位置节点。若两个行为记录共享操作对象或具有明确的控制与数据依赖,图结构便会将其连接,形成能够完整表达某项能力的“行为组”(Behavior Groups)。
随后的核心突破在于双向图对齐与差分。面对声明与实现之间的粒度差异,SkillConsist 既从声明侧向实现侧检索对齐,也从实现侧向声明侧反向对齐。对于源图中的一个行为组,系统先选定一个锚点记录,在目标图中检索候选节点,随后沿着行为关系链展开子图扩展(Subgraph Expansion)。这种扩展机制允许系统自动把实现图里分散的多个细粒度调用步骤聚合成一个完整的连通子图,直到该子图在语义上能够完全承载源端的抽象声明为止。
完成对齐后,系统执行图差分算法:一旦发现对齐子图之间在必要条件或状态转换上产生冲突,立即生成 $\textsc{Conflict}$ 警报;当遍历完某一侧的分析边界,确认对侧完全不存在可对齐的子图且具备完整的覆盖证明时,才会确凿地报出 $\textsc{Unimplemented}$ 或 $\textsc{Undeclared}$。每一个检出结果都精准保留了对应的源码行号和文档段落。
实验评测:大涨20个百分点的综合表现
为验证系统效能,研究团队构建了一个高质量基准测试集,涵盖从主流 Agent 技能平台 ClawHub 下载量排名前 500 的公开技能,以及 133 个来自安全研究开源项目 Skill-Inject 的注入攻击样本。整个测试集包含 319 个存在不一致的技能与 314 个一致的技能,并由专家人工标定了 442 处代码与文档定位标注。
在包级别的不一致检测任务上,SkillConsist 展现出显著优势:
-
包级检测准确率(Precision)达到 86.85%,召回率(Recall)达到 89.03%,F1 综合得分高达 87.93%。
-
相比基准线中表现最好的方案(引入 RAG 检索增强的 LLM 基线,或针对安全属性图微调的领域方案),SkillConsist 的 F1 得分足足领先了 20.43 个百分点。
-
在极具挑战性的不一致定位任务(准确指出文档与代码冲突的具体位置)中,SkillConsist 取得了 67.60% 的精确率与 62.52% 的 F1 值,远超传统检索或通用模型直接判别时出现的定位漂移问题。
消融实验进一步证实了架构设计的关键性。若去掉基于 LLM 的混合角色分离,强行退化为按文件类型硬编码切分,检测 F1 值会出现断崖式下跌;若禁止子图扩展、只允许单条记录孤立比对,模型将无法跨越粒度鸿沟,虚警率急剧升高;而若移除完备覆盖性检查证书,系统在判断“缺失对侧实现”时便会产生大量捕风捉影的误报。这三个组件互为表里,共同构成了精准判定的技术基石。
针对 217 个真实定位错误的深入归因审计揭示了一个重要现象:高达 86.5% 的漏报样本中,所需的关键上下文证据其实早就已经被成功检索出来了,但模型最终依然判定失败。这说明智能体代码安全检测的核心瓶颈早已不是“检索不够深”,而是跨异构制品的语义对齐与实体别名消歧能力。
安全筛选:用一致性审计拦截高危恶意技能
除了作为开发期的静态测试工具,SkillConsist 在线上技能市场的恶意软件排查中同样表现出实用价值。研究团队在 133 个包含明确恶意载荷与良性样本的 Skill-Inject 集合上进行了安全网关流水线测试。
实验引入主流前沿模型对 SkillConsist 产出的不一致结果进行自动化风险分级(高、中、低、无风险),并将其挂载在恶意智能体技能基准框架(MASB)的前端。结果显示,将 SkillConsist 检出的“高/中风险不一致”作为前置拦截门禁,能够以极低的代码动态沙箱验证成本,显著拉高恶意技能的检出召回率。很多攻击者试图通过精心编写的说明文档将恶意下载与数据外发包装得冠冕堂皇,但在 SkillConsist 的双向图对齐扫描下,代码里私自建立的外部网络连接由于在文档侧找不到任何合法的行为对齐子图,立即被标记为“未声明的高危行为”并拦截阻断。
总结与启示
随着各类通用 Agent 框架逐步将底层操作抽象为模块化技能包,开发者与普通用户对第三方工具的盲目信任正成为大模型应用落地的主要风险点。文档写得天花乱坠、底层代码却暗度陈仓的现象,在缺乏严格类型约束和行为审计的开源生态中屡见不鲜。
SkillConsist 的技术突破表明,检测 Agent 技能包的一致性不能停留在大模型直接“读代码看文档”的浅层感性认知上,也不能退回到僵化的纯静态规则匹配中。通过先解耦自然语言与代码中的语义角色,再构建行为关系图,最后利用图算法在不同抽象层级间做双向子图扩展与差分,才是兼顾复杂语义理解与高可信软件工程验证的有效路径。随着工具生态的进一步复杂化,这种具备精确定位与数学完备性证明的图对齐范式,有望成为未来 Agent 平台上线审核的标准流水线配置。