SkillMemo:给具身大模型装上技能记忆库,OOD泛化超越π0.5
SkillMemo: Expert-guided Skill Memory Framework for Compositional Embodied Manipulation
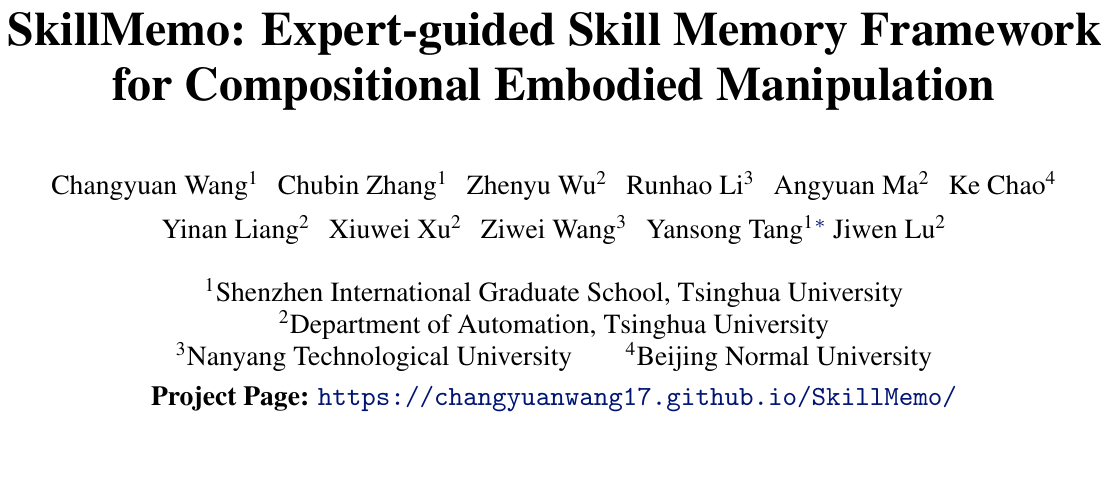
在具身智能领域,基于扩散策略(Diffusion Policy, DP)与视觉-语言-动作模型(Vision-Language-Action, VLA)的操作策略在各类基准上展现了出色的拟合能力。然而,这类模型在迈向真实开放环境时,始终面临着一道难以逾越的高墙:组合泛化(Compositional Generalization)的匮乏。由于高质量机器人示教轨迹数据收集成本高昂,主流模型普遍采用端到端的单一庞大网络(Monolithic Policy)去拟合完整的动作长序列。这种粗放的端到端学习方式极易让策略陷入环境表象与固定动作序列的过拟合,而难以抽象出可复用、可迁移的原子技能(Atomic Skills)。当机器人面对分布外(Out-of-Distribution, OOD)的新场景——哪怕只是将训练时见过的“草莓”放入同样见过的“盘子”(训练时只学过“草莓放碗里”和“柠檬放盘子”),策略也会因为缺乏解耦的行为基元而彻底失效。
ArXiv URL:https://arxiv.org/abs/2608.05970v1
为了打破这种“见过即会、重组即废”的僵局,来自北京师范大学、南洋理工大学与清华大学的研究团队提出了名为 SkillMemo(Skill-Based Memory)的技能记忆增强框架。该框架不再试图强行让端到端网络“硬背”整条动作轨迹,而是将长程示范轨迹隐式分解为底层的潜在原子技能基元,并将这些技能特征结构化存入一个动态的情景记忆库(Episodic Memory Bank)。在推理阶段,面对全新的任务组合,策略能够从记忆库中精准检索并重组相关的技能先验,完成对未见任务零样本式的技能拼装。在仿真与真实机械臂评测中,SkillMemo 跨越多种基座展现了惊人的迁移能力,不仅让基座模型在分布外组合任务上大幅提效,其仿真成功率更是刷新记录,超越了业内标杆 $\pi_{0.5}$(98.0% vs. 96.8%)。
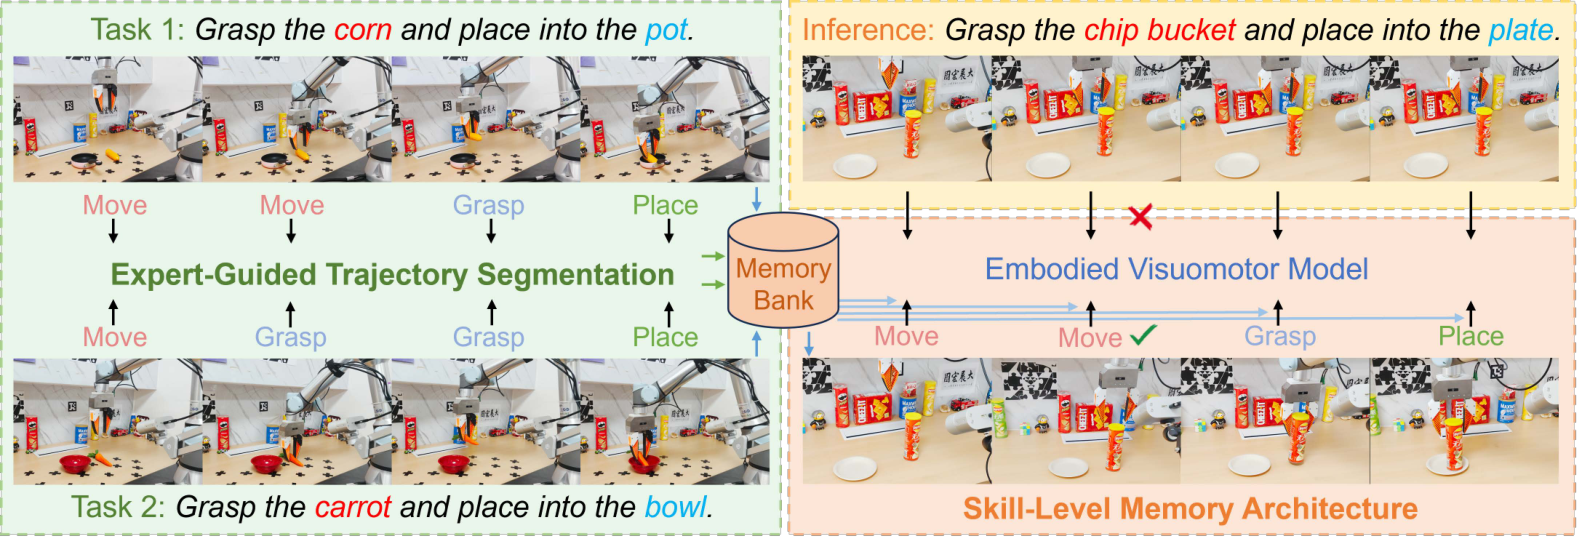
为什么端到端具身策略难以学会“组合”?
人类学习机械操作时,几乎从来不把一个复杂任务当作不可拆解的黑盒。拿“将草莓放进碗里”来说,人的认知系统会自动将其拆解为几个动作基元:定位并接近目标、对齐姿态执行抓取、抬升避障、移动至容器上方、松开夹爪。当遇到新任务“将草莓放进盘子”时,人类大脑只需提取前几个动作基元,再检索并调出“放置于平底盘”的动作末端,即可无缝完成行为组合。
反观现有的具身操作模型,无论是 Diffusion Policy 还是基于大语言模型的 VLA(如 OpenVLA、$\pi_0$ 系列),本质上都属于纯反应式架构(Reactive Policy)。它们仅依赖当前视觉观测与静态网络参数生成下一步动作,缺乏显式的时序经验组织结构。近期的研究试图通过外挂记忆库来缓解长程依赖,例如 MemoryVLA 引入感知与认知双流记忆库,HAMLET 利用时序动量 Token 编码交互历史。但这些方案存储的依然是未经提炼的全局图像特征或粗粒度的语义摘要,缺乏对具体行为动作模式的结构化解耦。机器人在检索记忆时,检索到的往往是“某个视觉场景长什么样”,而不是“这个动作该如何发力与转折”。这种粗糙的记忆机制,使得策略依然无法在未见的新配置下灵活复用底层运动模式。
SkillMemo 的核心见解在于:记忆不应该存一整段没有边界的动作流,而应该存解耦后的“原子技能配置”。只要能够从海量演示中抽取出与具体环境解绑的技能基元,并在面临新任务时动态重构专家的激活分布,机器人就能在不重新训练的前提下实现强大的组合泛化。
专家引导的轨迹分割:用 MoE 隐式提取原子技能
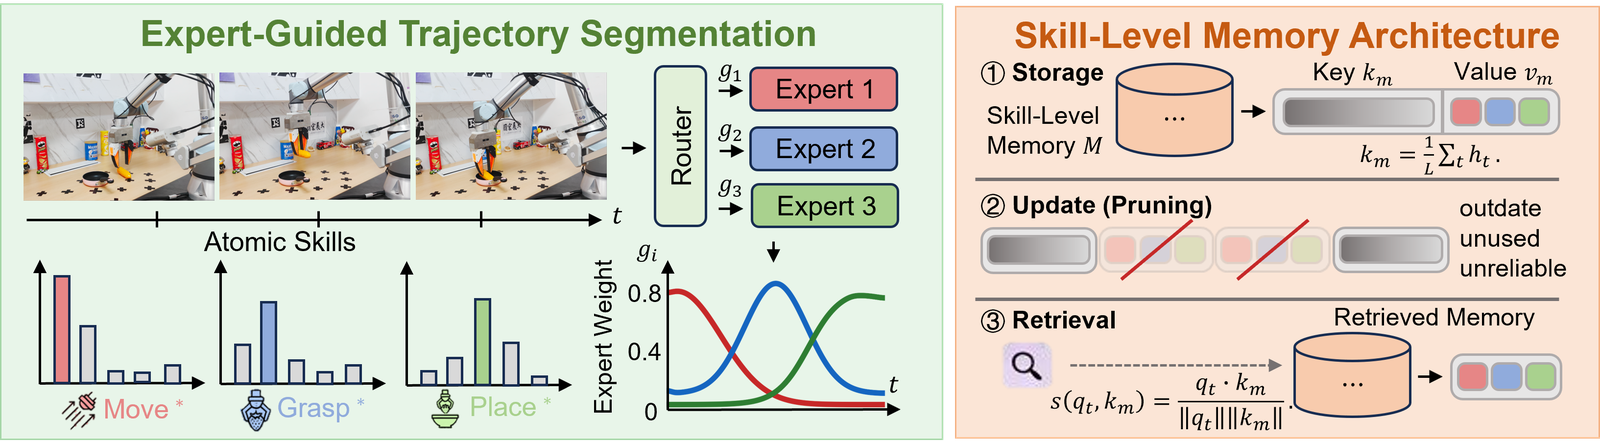
要建立技能记忆库,首要难题是如何从连续、高维的机器人示范轨迹中切分出有物理意义的原子技能。如果依赖人工规则标注打点或预定义运动基元库,不仅成本极高,而且无法覆盖高自由度机械臂复杂的非线性接触动力学。为此,SkillMemo 设计了一套基于混合专家(Mixture-of-Experts, MoE)架构的“专家引导轨迹分割模块”(Expert-Guided Trajectory Segmentation, EGTS),以无监督的方式隐式解耦技能。
给定一段长度为 $T$ 的专家演示轨迹 $\tau={(x_{t},a_{t})}_{t=1}^{T}$,其中包含连续的多模态观测 $x_t$ 与动作 $a_t$。传统方法采用统一的多层感知机或 Transformer 块处理全流程,而 SkillMemo 在策略网络中引入了多专家结构。在时步 $t$,隐藏层表征 $h_t$ 首先被送入门控网络(Gating Network),计算出各专家模块的激活权重 $g_i(h_t)$,整个模块的输出由各专家加权求和得出:
\[y_{t}=\sum_{i=1}^{N}g_{i}(h_{t})\cdot E_{i}(h_{t})\]这里的数学机制至关重要:门控网络输出的权重向量 $g(h_t)=[g_1(h_t), \dots, g_N(h_t)]$ 本质上构成了一个技能标识符。如果某个专家擅长“趋近物体”,而另一个专家擅长“闭合夹爪并抬升”,那么随着机械臂动作的推进,门控分布便会发生阶段性的跳变。
为了强制各专家真正特异化(Specialize)到互补且不重叠的底层技能上,避免多专家退化为简单的特征平均(Expert Collapse),作者引入了基于偏信息分解(Partial Information Decomposition, PID)的互信息约束损失:
\[\mathcal{L}_{\text{PID}}=-\big[I(\{A,B\};{G})-I(A;{G})-I(B;{G})\big]\]在信息论框架下,该目标最大化了各专家联合表征与全局任务表征 $G$ 之间的互信息增益,同时惩罚各个单独专家之间对任务信息的冗余覆盖。配合 Top-k 路由与专家负载均衡机制,网络在反向传播中被赋予了强烈的动力去促成专业化分工:特定专家仅在轨迹的特定运动子阶段被激活。这就完成了一种全自动、端到端、无需任何人工阶段标签的连续轨迹隐式切分。
技能级情景记忆库:存什么、怎么查与动态遗忘
通过专家门控网络完成技能解耦后,如何将这些碎片化的技能沉淀为可被检索的资产?SkillMemo 构建了一套“技能级情景记忆库”(Skill-Level Memory Architecture, SLMA)。
不同于以往检索方法直接保存单帧图像特征,SkillMemo 将记忆条目结构化定义为键值对(Key-Value Pair)。对于一段被识别出的连续技能片段 $\tau_m$(长度为 $L$):
-
键(Key, $\mathbf{k}m$):采用该时间窗口内隐藏层状态特征的时序平均池化,即 $\mathbf{k}_m = \frac{1}{L}\sum{t\in\tau_m}h_t$。这一向量浓缩了当前技能所处阶段的上下文环境与任务意图。
-
值(Value, $\mathbf{v}m$):并非记录原始的绝对位移或关节电机指令,而是完整记录该时间段内门控权重的时序激活谱,即 $\mathbf{v}_m = {g(h_t)}{t\in\tau_m}$。
这一键值对设计的构想极其巧妙。将“门控权重配置”作为 Value,实际上存储的是“如何协同多专家去完成这项动作”的元控制逻辑。绝对动作轨迹会随着物体坐标平移而失效,但调配各专家功能的相对模式(例如“闭合夹爪专家高激活、巡航专家低激活”)却在同类几何交互中保持高度不变性。
在在线执行阶段,机器人每走一步都会根据当前的上下文查询向量 $q_t$ 在记忆库中进行余弦相似度检索:
\[s(q_t, \mathbf{k}_m) = \frac{q_t \cdot \mathbf{k}_m}{\|q_t\| \|\mathbf{k}_m\|}\]策略筛选出与当前情境最相似的 Top-N 个历史技能片段,并将其对应的门控特征值与当前策略网络原生预测出的门控分布进行动态融合修正:
\[g^{\prime}(q_t) = \lambda g(q_t) + (1-\lambda)\frac{1}{N}\sum_{n=1}^{N}\mathbf{v}_n[t^{\prime}]\]融合超参数 $\lambda \in [0, 1]$ 巧妙地在“纯反应式策略的即时反应”与“过往成功经验的结构化先验”之间取得了平衡。即使当前任务的整体语义(如从未见过的水果和盒子配对)超出了策略的全局认知范围,检索出的门控分布依旧能够提供强有力的局部先验,引导模型正确调度对应的控制专家。
由于机械臂在长时交互中积累的示教数据极其庞大,记忆库不可能无限扩张。SkillMemo 还引入了一套模拟生物遗忘机制的动态剪枝策略,根据三个维度淘汰低价值条目:
-
访问时间戳淘汰:移除非强化、长期未访问的古老记忆条目,模拟人类认知对陈旧细节的自然遗忘;
-
低频激活淘汰:清除从未在检索中被成功匹配的冷门孤立条目;
-
质量置信度剪枝:持续过滤在多次检索中相似度均低于设定阈值 $\delta$ 的低质条目,确保记忆库的高信噪比与紧凑容量。
门控权重的动态可视化:专家到底学到了什么?
为了验证这套无监督分解机制是否真正学到了具有物理语义的动作基元,研究团队深入分析了机器人操作过程中的专家激活权重演变。这一消融与可视化结果构成了整篇论文最扎实的理论支撑之一。
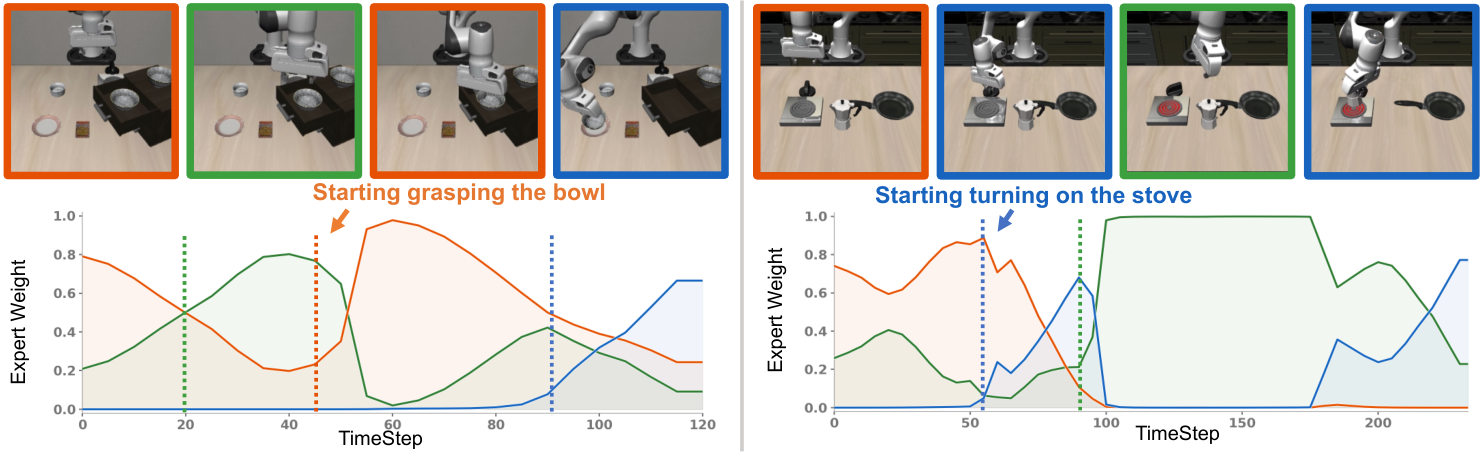
如图 3 所示,在真实的复杂操作序列中(例如在操作台上抓取碗并去旋转燃气灶旋钮),不同专家网络的门控激活系数展现出极具节奏感的脉冲式变化:
-
在机械臂自空闲状态加速向目标碗移动的平稳逼近阶段,负责宏观空间位姿对齐的特定专家占据了绝大多数激活权重;
-
当夹爪逼近物体边缘、接触面力学发生剧烈变化的“触碰并合拢”瞬间,原专家的权重骤降,专注于微调与抓握合拢的专家瞬间拉出峰值;
-
抓取成功后机械臂上抬转场,门控网络又迅速切换至运移专家。
这一观察强有力地证明:在完全没有人工打上“抓取”“拿起”“放置”等动作标签的前提下,信息论正则化下的 MoE 网络自发掌握了对长程连续动作流的临界点判定。每一次物理状态的转折,都精准对应着门控分布在潜在空间的迁移。这也解释了为什么将门控序列存为记忆 Value 能够在未见任务中实现技能的即插即用——因为底层专家所代表的动作形态本身已经与具体物体的全局语义完全解耦。
实验评测:不仅刷新基准,更在未见组合上断层领先
研究团队在仿真环境与实体机械臂上展开了全方位的双重验证。实验骨干网络同时覆盖了低层级高频控制常用的扩散策略(Diffusion Policy, DP),以及具备视觉语言交互能力的大规模基座 UniACT-0.5B 和 UniVLA-7B,基准评测全面覆盖了 LIBERO 系列基准(LIBERO-Spatial, LIBERO-Object, LIBERO-Goal, LIBERO-Long)、Push-T、UR3 Block Push 以及难度极高的 Franka Kitchen。
在仿真实验中,搭载了 SkillMemo 的完整策略表现出了全维度的提升。通过系统性的消融对比(从 Vanilla 基座,到仅加入 EGTS 轨迹分割,再到完整叠加 SLMA 记忆架构),消融数据显示:
-
仅引入 EGTS 专家引导分割,模型在各基准上的成功率即有稳步爬升,证实了隐式解耦相较于单一体网络拟合更不易发生模式崩塌;
-
在进一步集成 SLMA 技能记忆库后,模型在需要组合推理的复杂长程任务(如 LIBERO-Long 和 Franka Kitchen)上取得了最大幅度的跃升;
-
综合仿真评估中,SkillMemo 驱动的 VLA 策略达到了 98.0% 的惊人成功率,明确超越了同规格参数下的行业前沿模型 $\pi_{0.5}$(96.8%)。
然而,衡量具身策略泛化能力最残酷的试金石依然是真机实验。作者采用 UR5e 机械臂搭建了实体评测台,制定了涵盖多种高接触阻抗物体的任务集合(草莓放碗、柠檬放盘、玉米放锅、黄油放锅、薯片桶放桌)。
在单任务独立评估中,SkillMemo 对基座 DP 的提效立竿见影:
-
在较为规则的操作如“草莓放碗”上,成功率稳步上扬;
-
在极度考验精细对齐与接触控制的高难度任务中提升尤为显著,例如“玉米放锅”任务成功率提升了 7.5 个百分点,而涉及异形物体深部抓取的“黄油放锅”任务更是直接提升了 12.5 个百分点。
更具说服力的是针对未见任务的组合泛化测试(Unseen Task Generalization)。这是评估策略是否真正掌握结构化技能的核心协议。实验设置了严苛的交叉验证:
-
策略仅在两个来源任务上联合训练:任务 A(草莓放入碗中)与任务 B(柠檬放入盘中);
-
在评估阶段,直接要求机械臂在未见过的交叉重组场景下执行零样本操作:执行任务 C(草莓放入盘中)或任务 D(柠檬放入碗中)。
在这一极度考验 OOD 适应能力的测试中,传统 Diffusion Policy 遭遇了严重的泛化滑铁卢,以“草莓放盘”为例,常规策略的成功率仅有 65.0%,往往在接近盘子边缘时因为没有见过两者的视觉-动作组合而发生抖动甚至脱手。而 SkillMemo 将该任务的成功率一举拉升至 75.0%,整整提升了 10 个绝对百分点。数据表明,即便全局场景前所未见,SkillMemo 依然从历史记忆中抽取出“从碗任务中抓取草莓的专家配置”和“向盘中平缓释放物体的专家配置”,并在运行中精准完成动态缝合。
启示与局限:具身智能迈向模块化认知的一步
SkillMemo 提出的这套方法论,实际上指出了当前端到端具身大模型发展的一个核心痛点与解决路径。过去两年里,学术界和工业界普遍倾向于依赖纯粹的 Scaling Law——即通过收集数万小时的真实世界示教数据,指望一个几十亿甚至几百亿参数的通用多模态 Transformer 能暴力“涌现”出空间组合能力。然而真实物理世界的排列组合是无限的,简单的参数堆砌无法从根本上消除分布漂移带来的策略崩溃。
SkillMemo 的成功提供了一种更具生物学启发性的折中范式:
-
模型主体依然保持端到端优化的强大表征拟合能力;
-
但在决策内核中,通过信息论正则化强行解耦动作模块(MoE);
-
在外挂架构上,通过结构化显式情景记忆为模型提供随时可调用的先验指引。
从工程落地角度看,SkillMemo 保持了极高的非侵入性与灵活性。它并不破坏现有 DP 或 VLA 模型的主体架构,既可以作为轻量级模块直接嵌入到开源的 UniVLA、OpenVLA 或各类 Diffusion 策略中,也可以随着下游机器人在物理环境中的不断试错与示范持续更新记忆库,实现近乎免重训的技能终身增长。
当然,该框架依然留下了值得深入探索的边界。例如,当前的门控检索与特征融合依赖预设的相似度阈值与经验超参数 $\lambda$,如何在不同动作阶段动态自适应调整对记忆的信任权重?此外,当环境光照、视角或背景发生剧烈变化时,时序平均池化的 Key 向量是否能保持足够鲁棒的几何不变性?这些问题的解答,将进一步推动基于记忆增强的具身策略从“受控组合泛化”迈向真正开放世界的自主适应。但不可否认的是,SkillMemo 用扎实的理论和过硬的实验表明:让机器人拥有“提炼技能、存入经验、按需组合”的记忆能力,是通向通用具身操作极其关键且扎实的一步。