SpatialCLI:先学会用工具再脱离工具,8B模型空间推理逆袭GPT-5.6 Sol
SpatialCLI: Learning to Reason With Spatial Tools, Then Without Them
在具身智能(Embodied AI)和物理世界基础模型的研究中,视觉语言大模型(VLM)始终面临着一个尴尬的结构性矛盾:通用多模态大模型擅长高层任务分解与多步逻辑推理,但对物体的精确像素边界、公制深度和三维位姿等底层几何信息极其迟钝;而专业的计算机视觉模型(如专注于分割的 SAM、单目深度的 DA 或几何估计模型)虽然能给出亚像素级的高精度观测,却缺乏语言理解能力,无法自主判断任务需要何种感知证据,更谈不上将感知结果转化为具体的行动决策。
ArXiv URL:https://arxiv.org/abs/2607.27703
面对这种“懂思考的看不清,看得准的不会想”的割裂局面,现有的主流解法通常是让大模型扮演 Agent,在推理时将各类专用感知模型包装成 API 随时调用。然而,过度依赖外部工具不仅会带来巨大的延迟开销,还使模型停留在“拐杖式”智能的阶段。来自浙江大学等机构的研究团队提出了全新的框架 SpatialCLI,给出了更深远的解决思路:让模型先学会熟练调用空间感知工具,再通过成功的工具交互轨迹反哺自身,最终将专家的感知与度量能力“内化”为模型自身的原生推理能力。
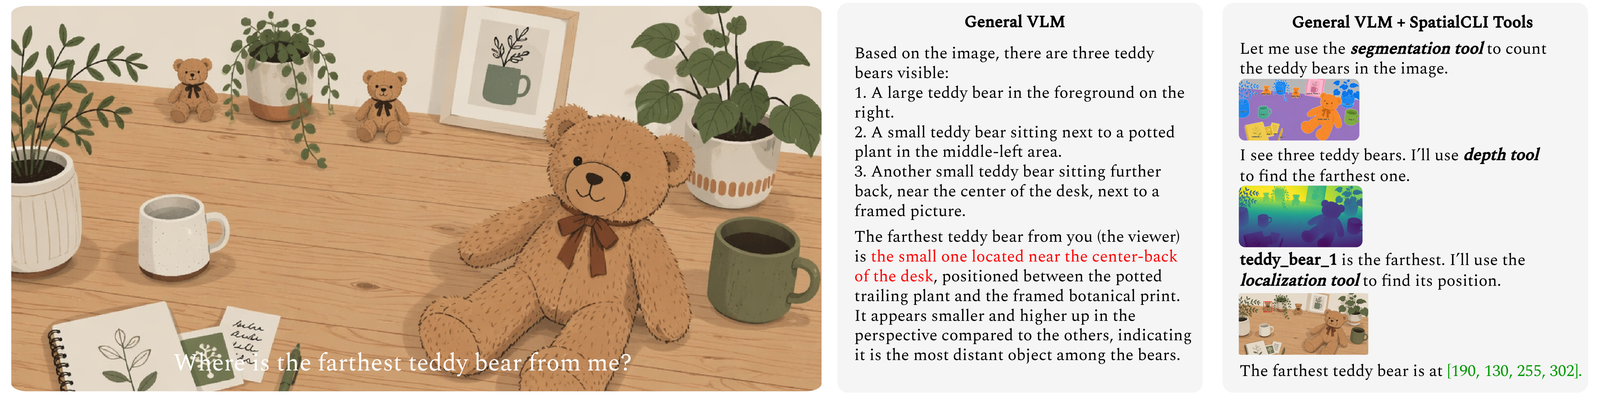
该方案在推理阶段以三阶段演进(Call-Learn-Internalize)打通了从工具调用到能力内化的闭环。在具有挑战性的空间推理基准测试中,基于 Qwen3-VL-8B-Instruct 构建的 SpatialCLI-8B 在挂载工具时,在 MindCube 基准上的表现从 29.3% 跃升至 84.6%,甚至大幅超越了挂载工具的 GPT-5.6 Sol(72.1%);更令人瞩目的是,在完全撤掉所有外部工具、进行端到端自主推理时,该 8B 模型依然保持了 73.8% 的高准确率。这项工作不仅提供了一套严密的具身感知学习范式,也揭示了基础模型迈向物理原生智能的可能演进路径。
通用推理与专用感知的断层
当具身智能体进入真实的物理环境时,现实任务往往要求动态组合多种空间感知能力。例如,为了“在杂乱的房间中找到离人最远的泰迪熊”,智能体必须先通过目标分割(Segmentation)筛选出所有可能的玩具熊候选,再借助深度估计(Depth)比对彼此的空间距离,最后定位(Localization)出目标对象的具体坐标。
目前的通用前沿多模态大模型在处理这类多跳空间推理时极易产生幻觉。即便是 GPT-5.6 Sol 这类顶尖模型,在处理多重几何约束时也经常因为边界估计不清或景深误判而失败。与此同时,学术界训练出的专业视觉模型在单项指标上登峰造极,例如 SAM 3 擅长掩码提取、DA3 精于深度重构、VGGT 能测算视角几何,但它们互为信息孤岛,无法接收人类开放式指令,更无法自行串联。
虽然近期有工作尝试让模型在推理时代调工具,但在具身场景下,直接对原始多模态模型引入多工具强化学习(RL)会面临极其严苛的探索瓶颈:
-
模型容易陷入无效的调用循环或格式错误;
-
参数无法正确传递给底层工具;
-
哪怕工具返回了精准的数值与几何特征,模型也常常因先验偏差(Prior Beliefs)而选择性忽略工具结果。
更本质的问题在于:智能体在调用工具解决复杂空间问题时所积累的多轮感知证据,是否可以直接转化为高质量的监督信号,使得大模型在下一次面对类似物理场景时,就算不用工具也能“看透”空间结构?SpatialCLI 正是基于这一核心设想展开构建。
三阶段演化:从外接工具到参数内化
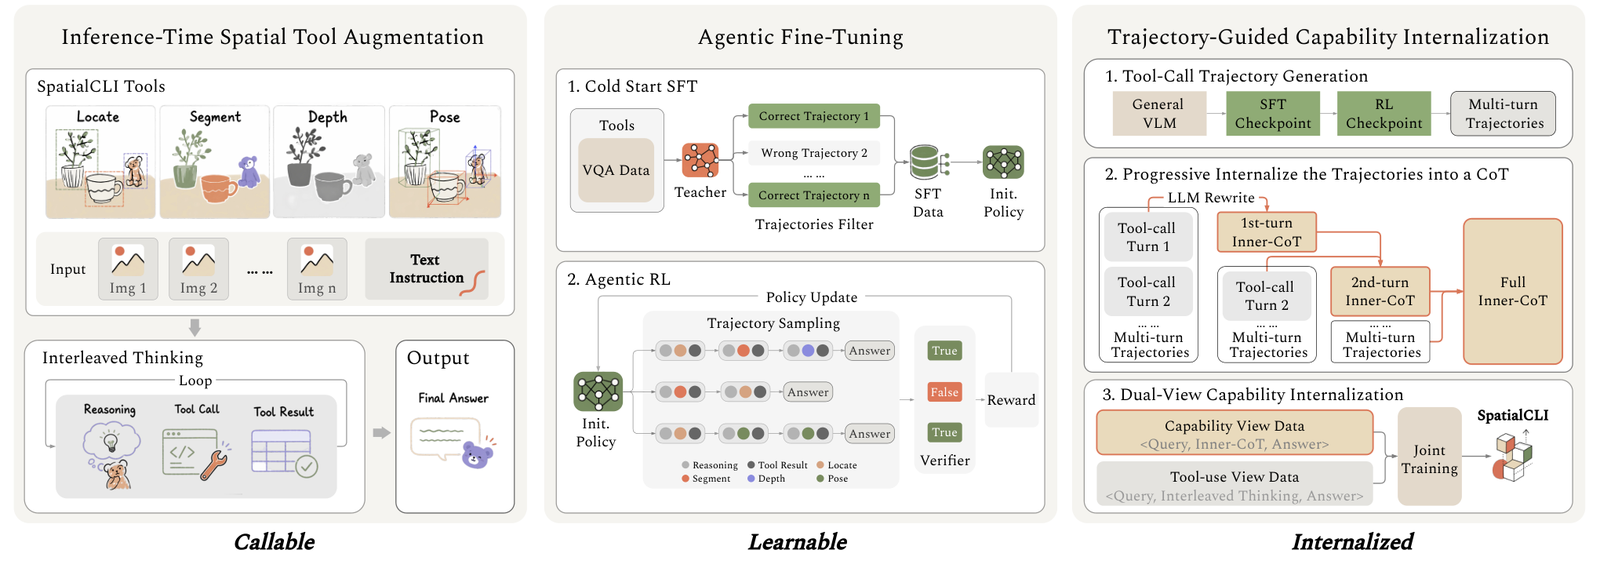
SpatialCLI 的整体流水线被划分为三个逻辑递进的阶段:Call(推理期工具增强)、Learn(智能体化微调)以及 Internalize(基于轨迹引导的能力内化)。
1. Call:将专用视觉专家抽象为统一工具集
在初始的调用阶段,系统将定位(Locate)、分割(Segment)、公制深度(Depth)以及三维位姿(Pose)四类专门模型封装为结构化 API。模型与环境的完整交互过程可以用多轮轨迹表示为:
\[\tau=\left((z_{t},a_{t},o_{t})_{t=1}^{T}\right),\qquad\xi=(I,q,\tau,y)\]其中 $I$ 表示输入的场景图像,$q$ 为具身空间任务指令,$z_t$ 是模型在执行第 $t$ 次工具调用前展开的思维链推理(Thought),$a_t$ 是生成的具体工具调用指令,$o_t$ 是外部工具执行后返回的观测结果,$T$ 是工具调用的总步数,而 $y$ 则是根据全流程证据推导出的最终答案。
研究团队在此处做出了一个关键设计:工具返回的结果并没有采用渲染红框或色块的标注图像,而是采用结构化的数值坐标、多边形点集和度量深度。这种纯文本化的结构表达在降低上下文传输冗余的同时,为后续的语言化学习提供了坚实底座。
2. Learn:冷启动 SFT 与 Agentic RL 强化决策
直接让未经训练的基础模型探索庞大且离散的工具调用空间极易导致崩溃。为了建立稳固的策略先验,SpatialCLI 采用“冷启动 SFT + 智能体强化学习”的进阶路线。
首先是 Cold-Start SFT。研究团队借助超大参数量的教师模型(Qwen3.5-397B-A17B)与工具环境交互,收集多轮成功解题的轨迹。经过严格的语法校验、工具执行成功判定和最终答案比对后,过滤出高质量交互集 $\mathcal{D}{\mathrm{SFT}}$。在有监督微调期间,外部工具返回的 $o_t$ 仅作为上下文输入,损失函数严格计算在模型自主生成的推理思考 $z_t$、工具参数 $a_t$ 和终极决策 $y$ 上。这一步彻底消除了调用格式混乱和参数无效的问题,训练出基础策略 $\pi{\mathrm{SFT}}$。
在此基础上,为了突破教师轨迹模仿的上限,框架引入了 Agentic RL。以 $\pi_{\mathrm{SFT}}$ 为起点,采用基于组相对策略优化(GRPO)的算法框架。针对具身任务 $x = (I, q, y^*) \sim \mathcal{D}_{\mathrm{RL}}$,模型按策略采样 $G$ 组完整的交互轨迹:
\[\{\xi_i\}_{i=1}^G \sim \pi_{\theta_{\mathrm{old}}}\]环境根据最终输出的答案正确性发放任务级奖励 $R_i = V(y_i, y^*)$。在强化学习的反向驱动下,模型学会了如何以更少的调用步数完成任务、如何在工具结果产生冲突时进行纠错,并显著降低了无效的重复调用。
3. Internalize:渐进式证据提炼与双视角联合训练
强化学习产生的大量成功交互轨迹不仅是策略优化的副产物,更是高价值的物理世界认知语料。然而,原始交互轨迹中充斥着冗长的格式符号、临时尝试和跨轮次的散乱输出,直接用其微调会让模型在脱离工具后难以理清思路。SpatialCLI 为此提出了渐进式证据感知轨迹语言化(Progressive Evidence-Grounded Trajectory Verbalization)机制。
处理过程分为两级推进:
第一级是轮次级证据整合(Turn-wise evidence consolidation)。在工具调用的每一步执行完后,提取器将新获得的度量线索与上一阶段的状态相结合,动态沉淀出紧凑的证据-推理单元 $e_t$:
\[e_{t}=\Psi_{\mathrm{ext}}\left(I,q,e_{<t},z_{t},a_{t},o_{t}\right),\qquad t=1,\ldots,T\]第二级是全局语言化(Global verbalization)。当全流程终结且判定答案正确时,语言化模块将整条紧凑证据流 $E_{\tau} = (e_1, \ldots, e_T)$ 转换为一段逻辑自洽、端到端可读的显式物理感知思考链 $c$:
\[c=\Phi_{\mathrm{verb}}\left(I,q,E_{\tau},y^{*}\right)\]此过程严格约束语言模型不得引入观测链中不存在的实体与属性数值,确保了事实层面的百分百接地(Grounded)。
随后,研究团队提出了核心的双视角能力内化(Dual-View Capability Internalization)目标:
-
能力内化视角(Capability-Internalization View):向模型输入原始图片 $I$ 与问题 $q$,要求其在没有任何工具调用的情况下,直接输出提炼后的显式空间感知链 $c$ 并得出答案 $y^*$,对应的损失记为 $\mathcal{L}_{\mathrm{internal}}$;
-
工具调用视角(Tool-Use View):保留原本的工具调用 Prompt 与交互结构,监督其工具规划与解析生成,损失记为 $\mathcal{L}_{\mathrm{agentic}}$。
最终的联合训练目标定义为:
\[\mathcal{L}_{\mathrm{CI}}=\mathcal{L}_{\mathrm{internal}}+\lambda\mathcal{L}_{\mathrm{agentic}}\]通过超参数 $\lambda$ 的调节,模型在强行吸收专用几何感知能力的同时,完全不会丢失原本学到的外接工具交互规范,实现了“既能自力更生,又能外接外挂”。
构建全要素基准:SpatialCLI-Bench
现有的空间评估测试集(如 MindCube、DA-2K)往往局限在特定的单一子领域,例如单独测试深度相对大小或单独测试物体三维姿态,缺乏对复杂复合感知链的考验。针对这一评测盲区,本文构建了 SpatialCLI-Bench,包含 516 道高难度单选试题(六选一),全面覆盖定位、分割、深度与姿态的交织推理。
该基准的构建流程极为严苛:首先通过前沿多模态模型扫描现实场景中的实体与空间拓扑;随后调取专业模型获取目标物体的公制距离、精确掩码与欧拉角;接着将这些物理客观证据注入提示词中,自动合成具有高迷惑性选项的问题;最后组织人类专家独立盲审作答,唯有人类作答结果与真值完全一致的样本才被收录。
测试结果显示,即便是代表当前行业天花板的多模态旗舰模型,在面对此类复合几何任务时也显得力不从心:GPT-5.6 Sol 在没有外挂工具时的得分仅为 48.8%,充分暴露了现代视觉语言模型在底层几何量化感知上的通病。
实验评测与关键发现
研究团队以 Qwen3-VL-8B-Instruct、Qwen3.6-35B-A3B 以及 Qwen3.6-27B 为基座模型进行了全方位验证,测试覆盖了 SpatialCLI-Bench、MindCube、MMSI、DA-2K 以及 BOPASK 等多个主流空间感知评测集。
从基准结果对比中可以提炼出几项极具启发性的实验结论:
1. 小模型借助工具大幅反超闭源旗舰
在引入 SpatialCLI 工具集后,各模型性能呈现出普惠式提升。尤其对于原本底层空间感知较为薄弱的小参数模型,工具带来的飞跃尤为显著。
以 Qwen3-VL-8B-Instruct 为例:
-
在 SpatialCLI-Bench 上,带工具推理的准确率从原生的 35.3% 飙升至 91.3%;
-
在极度考察三维相对关系的 MindCube 上,模型直接从最初的 29.3% 暴涨至 84.6%。
对比之下,即使是让 GPT-5.6 Sol 挂载相同工具集,其在 MindCube 上的最好得分也仅为 72.1%。一个经过针对性智能体微调的开源 8B 模型,在多工具协作任务上实现了对顶级专有闭源大模型的显著超越。
2. 工具能力成功沉淀,脱离工具后依然强势
能力内化模块带来了超出预期的泛化效果。经过双视角内化训练后,各个尺寸的模型在不挂载任何工具(w/o Tools)的纯推理模式下,各项指标相比初始底模均呈现出断层式提升:
-
SpatialCLI-8B 在完全裸跑的设置下,SpatialCLI-Bench 得分从 35.3% 翻倍至 72.7%;
-
MindCube 裸跑成绩从 29.3% 提升至 73.8%(这一成绩甚至压倒了带工具运行的 GPT-5.6 Sol)。
为了科学衡量感知能力的内化程度,本文定义了能力内化指数(Capability Internalization Index, CII),用来量化模型裸跑时输出的几何参量逼近专用感知模型的程度。实验监测显示,随着内化训练步数与语料规模的增长,模型的无工具得分与 CII 指数呈现出强烈的正向共振同步上扬(CII 均值从 45.6 稳步攀升至 61.6),这有力证明了模型确实吸收了底层度量技巧,而非仅仅死记硬背答案。
3. 参数规模与工具依赖的“双轨扩展规律”
研究进一步挖掘了模型容量(Capacity)与调用模式之间的关系,揭示了一条反直觉的模型扩展现象:工具调用性能会快速饱和,而内部参数的内化潜力随着模型参数的增大持续显现。
在实验中,当挂载工具时,8B、27B 与 35B 模型的最终表现几乎没有差异(基准差距小于 1.0 个百分点)。这是因为工具调用的核心在于决策逻辑的严密性,一旦智能体学会了正确的调度协议,感知的主要重担就被外部专家模型分担了,模型本身的参数容量不再是瓶颈。
然而,一旦进入无工具的内化推理阶段,更大参数量的模型(如 SpatialCLI-27B 和 35B-A3B)在各项细分维度(定位、深度、姿态推断)的 CII 指标上全面拉开对 8B 模型的差距。这一现象说明:利用外部工具可以抹平小模型与大模型在感知上的鸿沟;但要让模型彻底告别外部依赖、在神经突触内部完整容纳复杂的物理世界度量结构,更大的模型参数依然展现出无可替代的表征容量优势。
关键消融:为什么这种设计能够成功?
在消融实验部分,论文对工具返回格式以及训练策略进行了深入剖析。
结构化文本 vs 视觉图像增强
学术界此前在处理视觉感知工具时,常用做法是将检测框或分割轮廓画在原图上,再送回给 VLM。SpatialCLI 对比了“纯图像标注”、“纯结构化文本(坐标与点集)”与“图文混合”三种方案。
结果表明,结构化纯文本模式(Structured Only)与图文混合模式效果相当,且大幅超越了纯图像模式(在基准上高出整整 20.1 分)。将几何特征直接转化为离散的数值与坐标,不仅没有给模型增加额外的视觉编码负担,反而更便于大语言模型进行符号级的数学比对与边界推导,同时也极大地简化了向纯文本思考链的沉淀过程。
渐进式提炼与双视角的不可替代性
如果放弃轮次级的 Progressive Verbalization,而选择直接将全流程工具交互一次性送给模型进行单次总结(One-Pass),模型的内化成绩会出现显著下滑。原因在于长程工具交互中充斥着探索尝试与误差修正,单次总结容易丢失跨轮次的因果链条,甚至将中间的试错噪音误认为正确先验。
同时,双视角训练中的损失平衡系数 $\lambda$ 构成了抵御灾难性遗忘的护城河。单纯为了无工具推理而做全量微调,会导致原本训练成熟的工具调用协议退化;只有保持双视角的联合约束,模型才能在日常状态下保持强大的无工具直觉直觉,在遇到超高精度极限挑战时依然能够无缝唤起外部专家工具协同作战。
总结与展望
SpatialCLI 的提出,为物理世界基础模型与具身智能的发展提供了一条兼具实用性与深刻启示的技术路线。在工程层面,它向我们展示了一个 8B 参数级别的小型多模态模型,如何通过“工具协同冷启动 + 强化学习提炼”完成对行业顶级超大模型的逆袭;而在科学层面,它首次严密验证了“从外挂感知到内化心智”的可行性。
长久以来,学术界一直在争论大模型应当走向“无所不包的端到端单体巨兽”还是“调度百千 API 的精巧大脑”。SpatialCLI 证明了这二者从来不是非此即彼的对立面:大模型可以从充当一名熟练的“工具使用者”起步,在每一次与物理工具的交互中吸收世界的几何规则,并在参数中完成对底层视觉能力的重新编译。这种“用后即内化”的学习机制,或许正是通用多模态智能体最终摆脱外部感知拐杖、成长为真正理解三维物理世界的坚实一步。