HL-Gauss PPO:把Critic回归改为分类,pass@256提升9.6分
Start Classifying: Categorical Critics for LLM Reinforcement Learning
在以可验证奖励强化学习(RLVR,Reinforcement Learning with Verifiable Rewards)为主导的大语言模型推理训练中,PPO 与各类 Critic-free 算法(如 GRPO、DAPO)的博弈一直是社区的核心焦点。此前,很多团队倾向于放弃价值网络(Critic),原因在于训练一个稳定的 Critic 成本极高,而且在长程推理中经常出现价值崩溃与方差爆炸。然而,近期以 VAPO 为代表的成果证明,只要 Critic 训练得当,它所提供的密集奖励估计与低方差优势函数,对长程复杂推理任务的样本效率有着不可替代的价值。
ArXiv URL:https://arxiv.org/abs/2608.02181
但绝大多数针对 PPO 的改进都把注意力放在了 Actor 端:例如更激进的非对称裁剪、长度惩罚、组采样或是策略正则化。几乎所有主流框架在处理 Critic 时,依然沿用着古老的经典设定:在主干网络后接一个一维线性输出层,以标量均方误差(MSE)去拟合广义优势估计(GAE)计算出的蒙特卡洛回报或自举目标。
这项研究直接切中了这个长期被忽视的盲区:在终端二值稀疏奖励的推理任务中,用标量 MSE 训练 Critic 到底是不是最优解?
统计学上,MSE 的确是一致估计量,其理论最优预测值就是最终成功的条件概率。但在实际深度神经网络的优化动态中,MSE 的表现非常脆弱。模型在推理前缀上的微小预测偏差,会直接转化为极度不对称的优势估计,进而导致严重的策略震荡。为此,本文提出了 HL-Gauss PPO:彻底放弃标量的 MSE 回归头,改用带有高斯平滑的离散分类头来学习价值分布,最后仅通过求期望还原出标量值供 PPO 使用。该方法在 Qwen2.5-Math-7B 和 Qwen3-4B-Base 上全面超越了强基线 PPO 与 DAPO,在 AIME 等高难度数学基准上实现了显著突破,pass@256 综合提升了 9.58 个百分点。
为什么标量 MSE 在 RLVR 中会“失准”?
在数学证明、代码生成或可验证的问答任务中,环境给出的奖励极其极端:要么正确给 1,要么错误给 0。在此类 RLVR 设定下(通常设定贴现因子 $\gamma=1$ 且 GAE 衰减参数 $\lambda=1$),从任意中间推理前缀状态 $s_t$ 出发,未来的回报 $G_t$ 在本质上服从伯努利分布。此时状态价值 $V^*(s_t) = \mathbb{E}[G_t \mid s_t] = P(G_t = 1 \mid s_t)$,即该前缀最终能够成功推导出正确答案的概率。
既然最优预测值就是一个 $[0, 1]$ 之间的标量概率,使用 MSE 回归在统计意义上是完全合法的。但在深度模型优化和持续变化的策略分布下,“理论一致”绝不等于“优化良好”。
核心瓶颈在于 Critic 的预测误差会通过优势函数直接污染 Actor 的更新。在 $\gamma = \lambda = 1$ 时,GAE 估计退化为极简的残差形式:
\[\hat{A}_t = G_t - V_{\phi}(s_t)\]如果模型在一个推理前缀上产生微小的高估——例如原本的成功概率只有 0.1,但 Critic 预测为 0.35——那么在采样到失败轨迹($G_t = 0$)时,该步获得的负优势值为 $-0.35$;而万一采样到极其罕见但珍贵的成功轨迹($G_t = 1$),获得的正优势值仅为 $1 - 0.35 = 0.65$。
真实情况甚至更加恶劣。研究人员深入统计了 MSE Critic 在训练动态中的优势分布,发现了一个惊人的系统性偏差:MSE Critic 对失败轨迹的惩罚幅度,通常是成功轨迹奖励幅度的 2 到 3 倍。 在 AIME24 验证集上,失败轨迹的平均原始优势值为 $-0.597$,而成功轨迹的平均原始优势值仅为 $+0.227$,惩罚与奖励的绝对值比例高达 2.63。
这种极度负偏的优势信号会对策略优化产生致命影响。在困难问题上,正确解法的样本本就极其稀缺,但模型在正确路径上获得的微弱正反馈,轻易就被大量失败前缀施加的高额惩罚淹没。批次优势归一化(Batch Advantage Normalization)只能统一样本方差,根本无法消除这种内在的相对不对称性。久而久之,策略会变得极度保守,甚至破坏模型在困难前缀上探索正确分支的能力。
HL-Gauss PPO:用分类视角重构价值学习
将连续标量回归转化为离散分类并不是一个全新的统计概念,但在大模型强化学习领域,以往尝试引入分类或分布视角的尝试往往伴随着沉重的架构包袱。例如分布强化学习(Distributional RL)通常需要 Actor 配合感知分位数或风险敏感度,改变了强化学习的优化目标。
HL-Gauss PPO 的精妙之处在于它是一个完全解耦的即插即用型优化替代方案。它仅仅改变 Critic 的输出头和损失函数,而传递给 Actor 的仍然是一个干净、校准良好的标量期望值,整个 PPO 与 GAE 计算流程完全保持原样。
离散支撑集与期望解码
具体实现上,HL-Gauss PPO 将价值区间 $[v_{\min}, v_{\max}]$ 均匀划分为 $m$ 个离散区间(Bins),每个区间的宽度为 $\Delta = (v_{\max} - v_{\min}) / m$。对于二值奖励任务,该区间一般设为 $[0, 1]$ 附近(为了防止边界溢出,可以保留少量边界余量),并将离散区间的中心点记为 $z_i$:
\[z_i = v_{\min} + \left(i - \frac{1}{2}\right)\Delta, \quad i = 1, \dots, m\]Critic 网络不再只输出一个标量,而是输出一个 $m$ 维的对数几率向量 $\boldsymbol{\ell}(s) = W\mathbf{h} + \mathbf{b} \in \mathbb{R}^m$,其中 $\mathbf{h} \in \mathbb{R}^d$ 是主干模型最后一层的隐藏状态。经过 Softmax 之后,网络输出了一个定义在离散支撑集上的分类概率分布 $\mathbf{p}_\phi(s)$。
当 Actor 需要利用价值计算优势函数时,模型并不需要复杂的采样或分位数计算,只需对该离散分布求数学期望,即可还原出平滑的标量状态价值:
\[\hat{V}_{\phi}(s) = \sum_{i=1}^m p_i(s) \, z_i\]这个标量 $\hat{V}_{\phi}(s)$ 会被无缝传入标准的 GAE 模块,用于生成 Actor 更新所需的优势值 $\hat{A}_t$。
直方图高斯平滑目标(HL-Gauss)
如果仅仅是将回归变成离散分类,直接将标量目标 $y_t$ 投影为 One-hot 标签,训练很快就会崩溃。原因在于 One-hot 标签会强制模型把概率推向单纯形的极值顶点,引发预测过度自信,且完全破坏了相邻数值区间之间的连续度量空间结构。
HL-Gauss(Histogram Loss with Gaussian Smoothing)通过向连续目标周围注入局部高斯积分来构建目标分布。对于任意给定的连续标量回归目标 $y_t$(由 GAE 计算得到的回报目标),第 $i$ 个区间所分配的目标概率由标准正态累积分布函数 $\Phi(\cdot)$ 确定:
\[q_i(y_t) \propto \Phi\left(\frac{z_i + \Delta/2 - y_t}{\sigma}\right) - \Phi\left(\frac{z_i - \Delta/2 - y_t}{\sigma}\right)\]式中,$\sigma$ 是控制平滑尺度的带宽超参数。经过归一化后,$\mathbf{q}(y_t)$ 构成了一个以真实标量 $y_t$ 为中心、在相邻离散区间上平滑扩散的软标签分布。
Critic 最终的训练目标就是最小化预测分布 $\mathbf{p}(s_t)$ 与高斯平滑目标分布 $\mathbf{q}(y_t)$ 之间的交叉熵损失:
\[L_{\mathrm{critic}}(\phi) = -\frac{1}{\lvert \mathcal{M} \rvert} \sum_{t \in \mathcal{M}} \sum_{i=1}^m q_i(y_t) \log p_i(s_t)\]其中 $\mathcal{M}$ 代表所有有效的非填充 Token 集合。
为什么分类头能挽救梯度几何与校准?
从优化机制层面分析,将回归重构为平滑分类带来了两重根本性的几何优势。
第一重优势来自反向传播梯度的通道容量。对于传统的标量线性头 $V_{\phi}(s) = \mathbf{w}^{\top}\mathbf{h} + b$,其均方误差损失关于主干表征 $\mathbf{h}$ 的梯度极其单一:
\[\nabla_{\mathbf{h}}\mathcal{L}_{\text{MSE}} = 2(V_{\phi}(s) - y) \cdot \mathbf{w} \in \operatorname{span}(\mathbf{w})\]这意味着无论当前前缀的上下文多么复杂,标量头反传回主干网络的梯度向量始终被死死限制在权重向量 $\mathbf{w}$ 所张成的一维子空间内,标量误差的大小仅仅改变了该方向上的步长。
而在分类头设置下,权重矩阵 $W \in \mathbb{R}^{m \times d}$ 拥有 $m$ 个行向量,其交叉熵梯度为:
\[\nabla_{\mathbf{h}}\mathcal{L}_{\text{CE}} = W^{\top}(\mathbf{p} - \mathbf{q}) = \sum_{i=1}^m (p_i - q_i) \, \mathbf{w}_i\]每个离散区间都可以独立贡献不同维度的梯度分量,允许主干网络在表征空间内接收到更加丰富、多通道的方向引导信号。
第二重也是更关键的优势,在于局部 Fisher 信息矩阵与预测保守性。传统的 MSE 容易让网络在遇到困难样本时发生过拟合或极端偏移,而在极端二值任务中直接采用 One-hot 交叉熵,会导致 Fisher 矩阵在概率接近单纯形顶点时发生退化,梯度更新极度尖锐。HL-Gauss 施加的高斯软标签在理论上阻止了预测分布塌缩到单纯形边缘,迫使网络始终在单纯形内部寻找最优解,从而显著改善了损失曲面的局部条件数,有效抑制了过度自信的误判。
在推理过程中,这种机制展现出了非常直观的物理意义:在问题刚刚开始推导的前期前缀中,由于结果高度未知,分类头输出的概率质量会分散在两端,呈现均匀或多峰分布;而随着解题步骤逼近终点,正确路径上的概率会平滑向 1 集中,错误路径则迅速向 0 集中。这一动态演化完全是通过优化过程自主浮现的。
实验评测:数学推理与工具检索的全面超越
为了验证 HL-Gauss PPO 的实际效能,研究人员在数学密集型推理与多步 Agent 检索任务上展开了详尽评测。所有对比均在严格对齐的基础设定下进行:Actor 侧的 PPO 损失函数、采样策略、超参数规划及计算预算全部保持一致,唯一的变量就是 Critic 的输出架构与学习目标。
在基于 DAPO-Math-17K 训练、以 Qwen2.5-Math-7B 为底座的主实验中,HL-Gauss PPO 在各大权威数学基准上均展现出绝对优势。在包含 AIME24、AIME25、HMMT、BeyondAIME 和 Brumo 的综合测试集中,HL-Gauss PPO 相比标量 MSE PPO 取得了显著增长:
-
avg@256 综合得分:由标准 PPO 的 15.88 提升至 18.74,净增 2.86 分;其中在最难的 AIME25 上,单项提升高达 5.20 分。
-
pass@256 极限表现:由标准 PPO 的 38.48% 跃升至 48.06%,获得了高达 9.58 个百分点的暴涨。
-
与 DAPO 对比:无需复杂的动态采样和更高难度的 Actor 裁剪策略,HL-Gauss PPO 在 avg@256 和 pass@256 上均稳稳超越了当前的强基线 DAPO。
更关键的是,这一提升不仅存在于单一模型家族。当骨干网络切换为 Qwen3-4B-Base 时,HL-Gauss PPO 的 avg@256 依然从 15.33 提升到 17.18,pass@256 从 53.40% 提升至 57.13%,证明了分类 Critic 的通用性。
除了纯粹的数学推理,论文还在更贴近通用智能体场景的 Search-R1 基准(结合检索工具的复杂推理问答)上,使用 Qwen2.5-7B-Instruct 评估了性能。在涵盖 NQ、TriviaQA、PopQA、HotpotQA、2Wiki、MuSiQue 和 Bamboogle 等 7 个开源问答数据集上,HL-Gauss PPO 的表现不仅压制了标准标量 PPO,也超越了无 Critic 的 DAPO 方案,展现了对交错生成与长上下文检索的强健适应力。
消融实验:并非所有分类头都有效
很多研究人员直觉上会产生疑问:提升究竟来自于“将回归做成分类”、“增加了输出头的参数量”,还是来自于“高斯平滑”?为了彻底剖析性能收益的来源,本文设计了一组极其严格的对比控制实验(Controls):
-
Bernoulli 双分类 Critic(Bernoulli 2-bin):既然最终奖励是非 0 即 1 的二值分布,那么直接用二分类交叉熵预测 $P(G=1 \mid s)$ 是否就足够了?实验结果显示,Bernoulli Critic 虽然提升了 pass@256(达到 45.67%,优于 MSE 的 38.48%),但其 avg@256 仅为 15.50,甚至略低于 MSE 的 15.88。这说明纯粹的二分类尽管有助于捕获极端成功样本,却无法在连续的中间推理状态上提供具有度量意义的平滑价值排序。
-
One-hot 101-bin 分类头:将价值切分为 101 个离散区间,但直接将标量目标映射到最近区间的 One-hot 向量。实验显示其 avg@256 仅为 16.48,显著落后于 HL-Gauss 的 18.74。这证明单凭增加线性层参数量或离散化本身,并不能带来理想的增益;缺乏度量平滑的目标只会导致严重的过拟合与概率极化。
-
Two-hot 线性插值:采用连续目标在相邻两区间按距离线性分配权重的方案,其 avg@256 达到 17.42,虽然优于 One-hot,但依旧不敌拥有高斯扩散尾部的 HL-Gauss。
这些细致的消融实验无可辩驳地说明:高斯目标平滑所赋予的局部几何正则性,是让离散分类在价值拟合中大获全胜的决定性因素。
深度诊断:优势信号从失衡走向对称
为了解开 HL-Gauss PPO 优异表现背后的微观机理,研究团队对训练过程中的优势动态与前缀校准进行了深入的诊断性探测。
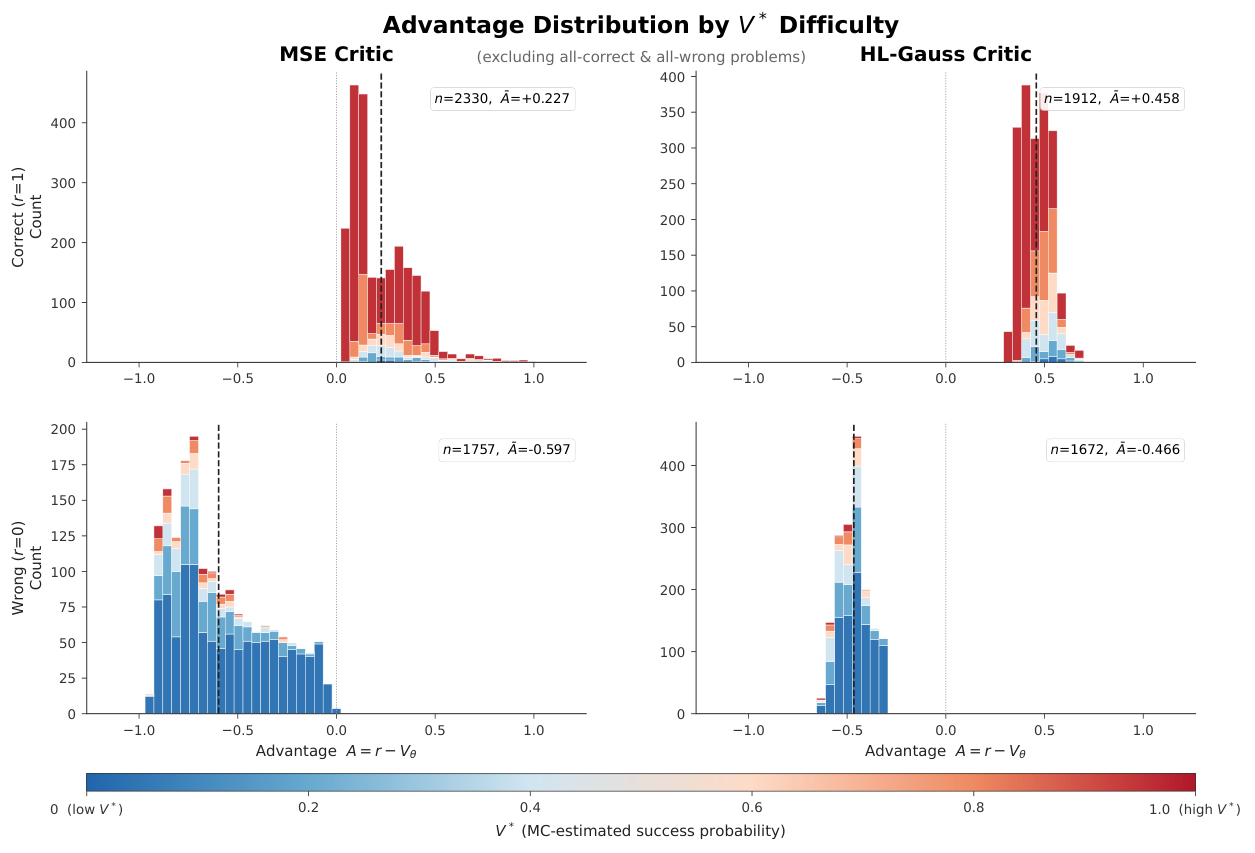
上图揭示了 MSE 与 HL-Gauss Critic 在优势分布质量上的剧烈差异。在 AIME24 和 AIME25 上,通过固定相同的状态前缀并展开采样分析,研究人员观测到:
-
MSE 的惩罚偏置:在 AIME24 上,MSE Critic 对错误轨迹给出的平均负优势值高达 $-0.597$,对正确轨迹给出的平均正优势值仅有 $+0.227$;在 AIME25 上,负优势为 $-0.486$,正优势仅为 $+0.175$,不对称比率高达 2.78 倍。这种不对称随着训练轮次的推进还会进一步恶化。
-
HL-Gauss 的完美对称:HL-Gauss PPO 计算出的平均正负优势呈现出高度的平衡性。在 AIME24 上,负优势均值为 $-0.466$,正优势均值为 $+0.458$,惩罚/奖励比例精确逼近了理想的 $1.0\times$;在 AIME25 上,比例同样稳定在 $0.99\times$。
这种正负优势的平衡性解释了为什么 pass@$k$ 指标会出现格外夸张的爆发。数学上,pass@$k = 1 - (1-p)^k$,它对高难度问题(即成功概率 $p$ 极小的样本)的灵敏度正比于 $k(1-p)^{k-1}$。当问题非常困难时,模型原本探索到的微量成功轨迹如果受到过低的正向优势赋权,就极易被模型遗忘;而 HL-Gauss 恢复了对成功轨迹应有的奖赏强度,使得罕见的正确解法能够被 Actor 强力捕捉并巩固下来。
在针对前缀价值的绝对校准误差测试中(以 256 次蒙特卡洛采样的真实成功率作为 Oracle 真值),HL-Gauss 同样展现出压倒性的优势:
-
Brier 分数 相比 MSE 下降了 19.4%;
-
期望校准误差(ECE) 降低了 18.4%;
-
最大校准误差(MCE) 暴跌了 27.9%;
-
最显著的改进恰恰发生在真实成功率处于 $0 < V^* < 0.5$ 的“高危区间”——在这一区间内,MSE 的 Brier 分数高达 0.296,而 HL-Gauss 仅为 0.121。正是由于消除了解题可能失败时的盲目高估,虚假的高额负向惩罚被彻底扫清。
总结与展望
HL-Gauss PPO 是一项极具启发性的大模型强化学习底层工作。它没有追逐复杂的架构调整或花哨的采样工程,而是回归到强化学术界长期存在的本原问题:在有限样本与非平稳数据流下,传统的标量回归并不适合充当高敏感度策略梯度的基准线。
论文通过严谨的实验与可复现的代码证明:
-
标量 MSE 导致的价值过拟合与过度自信,会诱发深度的优势不对称,对 RLVR 场景下的罕见成功路径造成实质性压制。
-
借道离散化区间与 HL-Gauss 高斯平滑目标,能够以极小的计算代价(仅仅是输出层增加几百个维度)大幅优化梯度流通道,并完美修复优势信号的平衡性。
-
它在概念上严格不同于完整的分布强化学习,Actor 无需承担任何额外的分布建模负担,使其能够无缝嵌入到现存的任何 PPO 系统中。
这项研究为正在搭建推理大模型强化学习底座的工程师和研究者提供了极有价值的参考:下次当你的 PPO 训练在复杂推理任务上陷入崩溃或停滞不前时,不必急于抛弃 Critic 转向复杂的启发式采样,不妨先把 Critic 最后一层的线性标量回归,换成平滑的分类头。