SyncPlan:显式同步与自适应修正,多智能体协同耗时降至0.05%
SyncPlan: Long-Horizon LLM Coordination with Explicit Synchronization and Adaptive Correction
在动态环境中利用大语言模型(LLM)协调多个智能体,长期面临着效率与适应性之间的两难困境。如果为了应对环境变化而在执行过程中反复调用大模型或进行多轮对话,系统延迟会被拉长到无法容忍的地步;而如果只做一次性开环规划,智能体又极易因为同伴动作延迟或环境突变而陷入死锁与失效。
ArXiv URL:https://arxiv.org/abs/2608.01652
针对这一核心冲突,最新研究提出了名为 SyncPlan 的“规划-执行-修正”(Plan-Execute-Correct)长程多智能体协同框架。该框架让中心化 LLM 在单次调用中生成带有显式同步原语的长程动作链,在底层由执行器通过等待原语和有向图死锁检测维护时序依赖,同时引入轻量级的“计划失效检测器”(Plan Staleness Detector, PSD)在运行期持续评估状态漂移,仅在必要时触发按需重规划。
实验结果展现了极大的效率优势:在公开的 Overcooked(胡闹厨房)基准上,SyncPlan 相比最强基线将任务完成率提升了 12.2 个百分点,而端到端物理运行耗时(Wall-clock Runtime)不到现有大模型协同方法的 0.05%;在复杂度更高的《王者荣耀》(Honor of Kings)5v5 真实对抗环境中,SyncPlan 达到了 86.3% 的任务完成率,超越前沿方案 DPT-Agent 达 17.6 个百分点,并将相对耗时缩减至原本的二十六分之一以下。
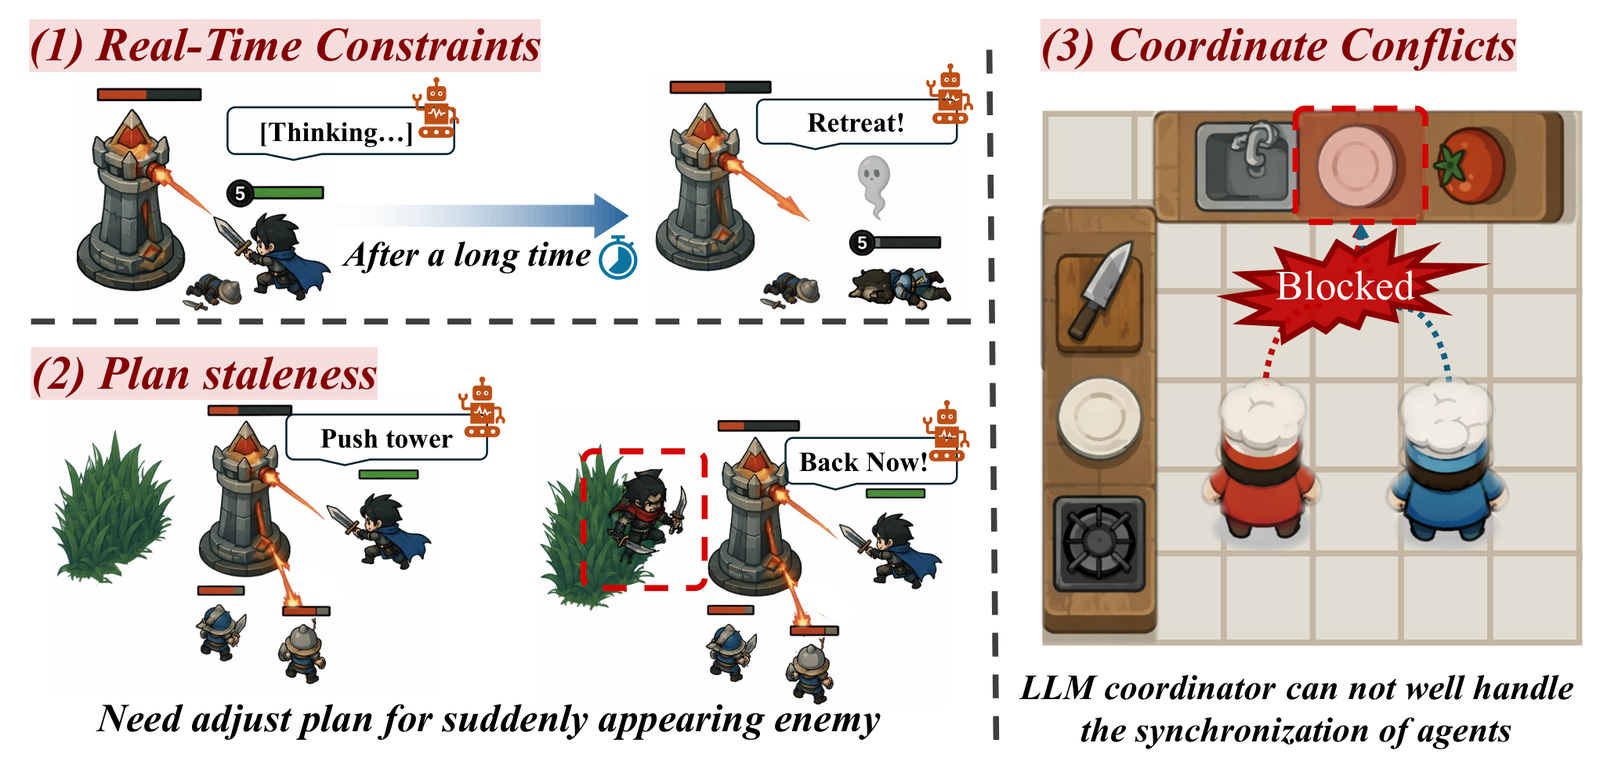
动态协同的三重困境:延时、陈旧与冲突
将大模型引入多智能体协同并非新鲜事,但多数现有方案都默认运行在回合制或低时效性场景中。一旦进入帧级推进的实时环境,三大矛盾便会迅速暴露。
首先是严苛的实时性约束。诸如 MOBA 游戏对局或协作厨房,环境状态每几十毫秒就会刷新一次。如果智能体在执行动作前必须等待中心 LLM 思考,或者多个智能体之间必须通过多轮自然语言协商达成共识,极高的调用延迟会导致智能体在战场上频繁“发呆”,彻底错失战机。
其次是计划陈旧(Plan Staleness)。动态环境充斥着随机事件与非受控实体的干扰,一次性生成的联合长程动作链基于初始观察构建,随着时间推移,现实状态很快会脱离预设假设。如果盲目执行旧计划,会导致大量无效甚至自杀式的操作;但如果采用固定周期的定时重规划,又会在环境平稳时造成巨大的算力浪费。
最后是复杂的协同冲突。多智能体协作并不是单个行动的简单拼盘,不同智能体动作之间往往存在强烈的条件约束。例如,刺客需要等待坦克先行开团抗伤,厨师需要等待队友把洗好的盘子端上台面。传统方案往往试图在提示词中让大模型用自然语言写出协同关系,但底层的低阶执行器根本无法解析或强制执行这些模糊的意图,最终演变成行动不同步或资源争夺。
SyncPlan 的破局思路并非继续堆砌更强大的提示工程,而是重构了中心规划与底层执行的职责边界:大模型专注产出带有严格时序逻辑的高阶动作链,底层执行器负责强制同步,轻量级模型实时看门,最后用面向规划的强化学习打通虚拟规划与物理执行的鸿沟。
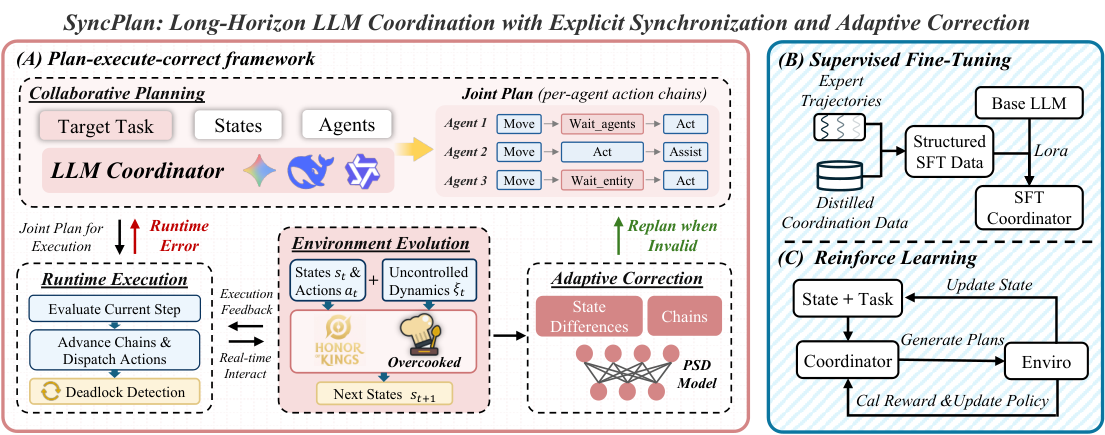
显式同步与死锁检测:让底层执行器看懂时序依赖
SyncPlan 采用中心化规划、分布式执行的设计模式。面对多智能体任务目标与环境状态 $s_t$,中心化 LLM 协调器只进行单次规划调用,为每个被控智能体分别生成一条结构化的长程动作链:
\[\Pi_{t}=\mathcal{D}_{\theta}(s_{t},e)=\{\pi_{t}^{1},\ldots,\pi_{t}^{N}\}\]与常规动作链不同,SyncPlan 在动作定义中显式嵌入了同步原语(Synchronization Primitives)。这些原语主要分为两类:智能体依赖(Agent-dependent Wait)与环境条件依赖(Entity-dependent Wait)。当某智能体动作链的头部处于等待状态时,仅阻塞该智能体本身的推进,其他队友的动作链继续正常异步执行。只有当指定的队友完成了关键阶段任务,或者特定的环境实体达到了预设状态(如目标野怪刷新、敌人进入视野),等待条件才被解除,智能体继续执行后续动作。
这种显式设计将大模型原本含糊的“先等队友上”转化为底层执行器可以无歧义监测的布尔条件。然而,一旦引入显式互等,多智能体系统必然面临经典的并发死锁问题——A 在等 B 到位,B 却在等 A 给出控制技能。
为了防止系统在动态对抗中卡死,SyncPlan 在运行时引入了帧级死锁检测机制。执行器根据当前的等待关系构建有向等待图 $\mathcal{G}{t}=(\mathcal{V},\mathcal{E}{t})$,其中节点代表智能体,有向边 $i \rightarrow j$ 表示智能体 $i$ 正在等待智能体 $j$。执行器在每一帧通过拓扑分析检测图中是否存在有向环。一旦检测到环路,意味着发生了无法自我化解的循环等待死锁,执行模块会立即中断执行,向中心协调器发起强制重规划。
告别盲目重规划:轻量化失效检测器的状态感知
解决了执行期间的时序依赖,下一个难题是如何决定何时重规划。传统的 LLM 多智能体架构要么完全开环不修正,要么按固定步长(如每 5 步或每 10 秒)硬性重规划。前者适应性极差,后者算力开销过大。
SyncPlan 的解决方案是设计了一个高度轻量化的独立模块——计划失效检测器(Plan Staleness Detector, PSD)。PSD 的职责极为聚焦:在执行器推进动作链的同时,持续计算当前剩余计划与瞬息万变的游戏状态是否还匹配。
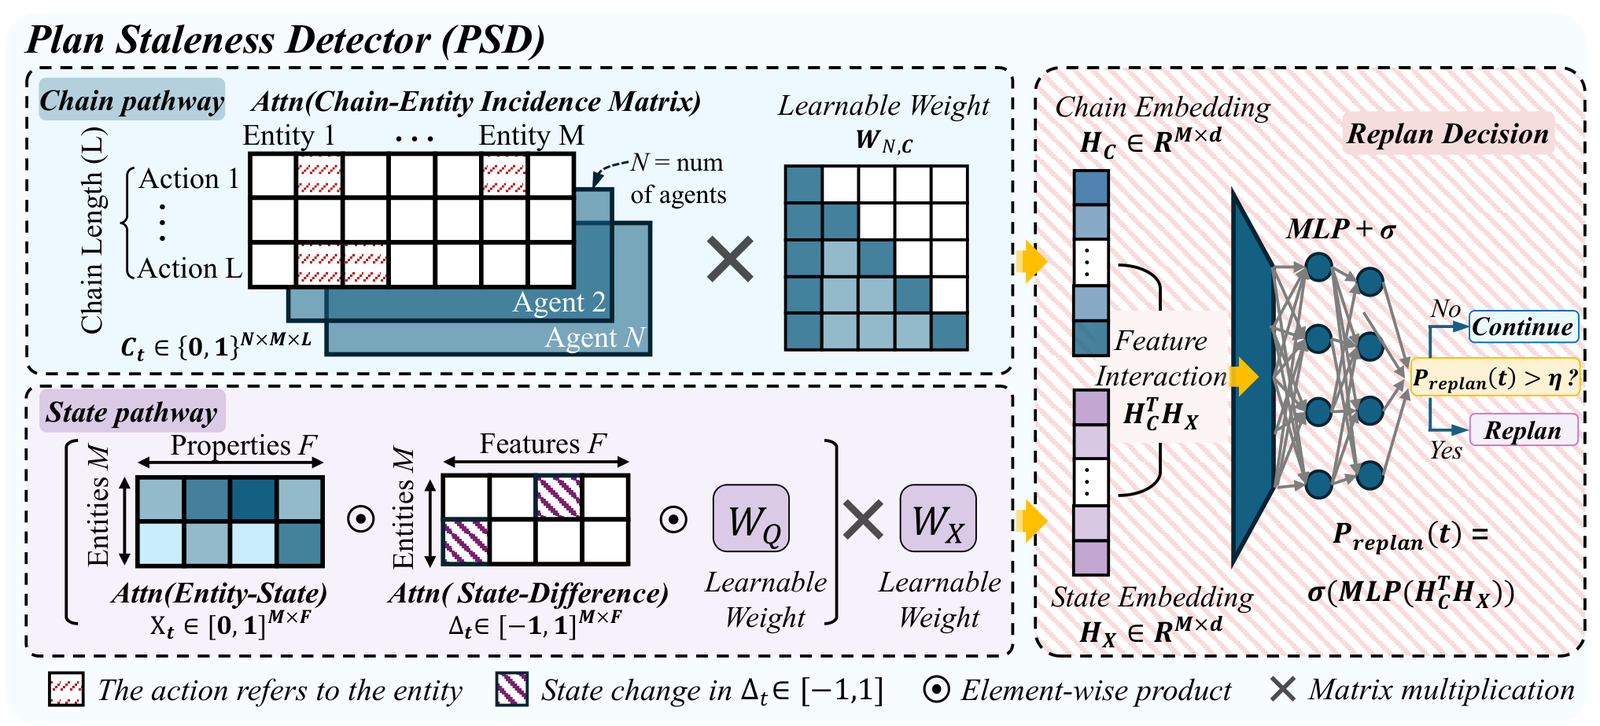
PSD 的核心架构避开了庞大的自回归解码,采用紧凑的交叉注意力与多层感知机(MLP)实现毫秒级推断。该模块将当前剩余的协作动作链特征编码为 $\mathbf{H}{C}$,将当前时刻的环境实体状态特征、状态差分特征编码为 $\mathbf{H}{X}$,最终通过非线性映射输出一个触发重规划的概率值:
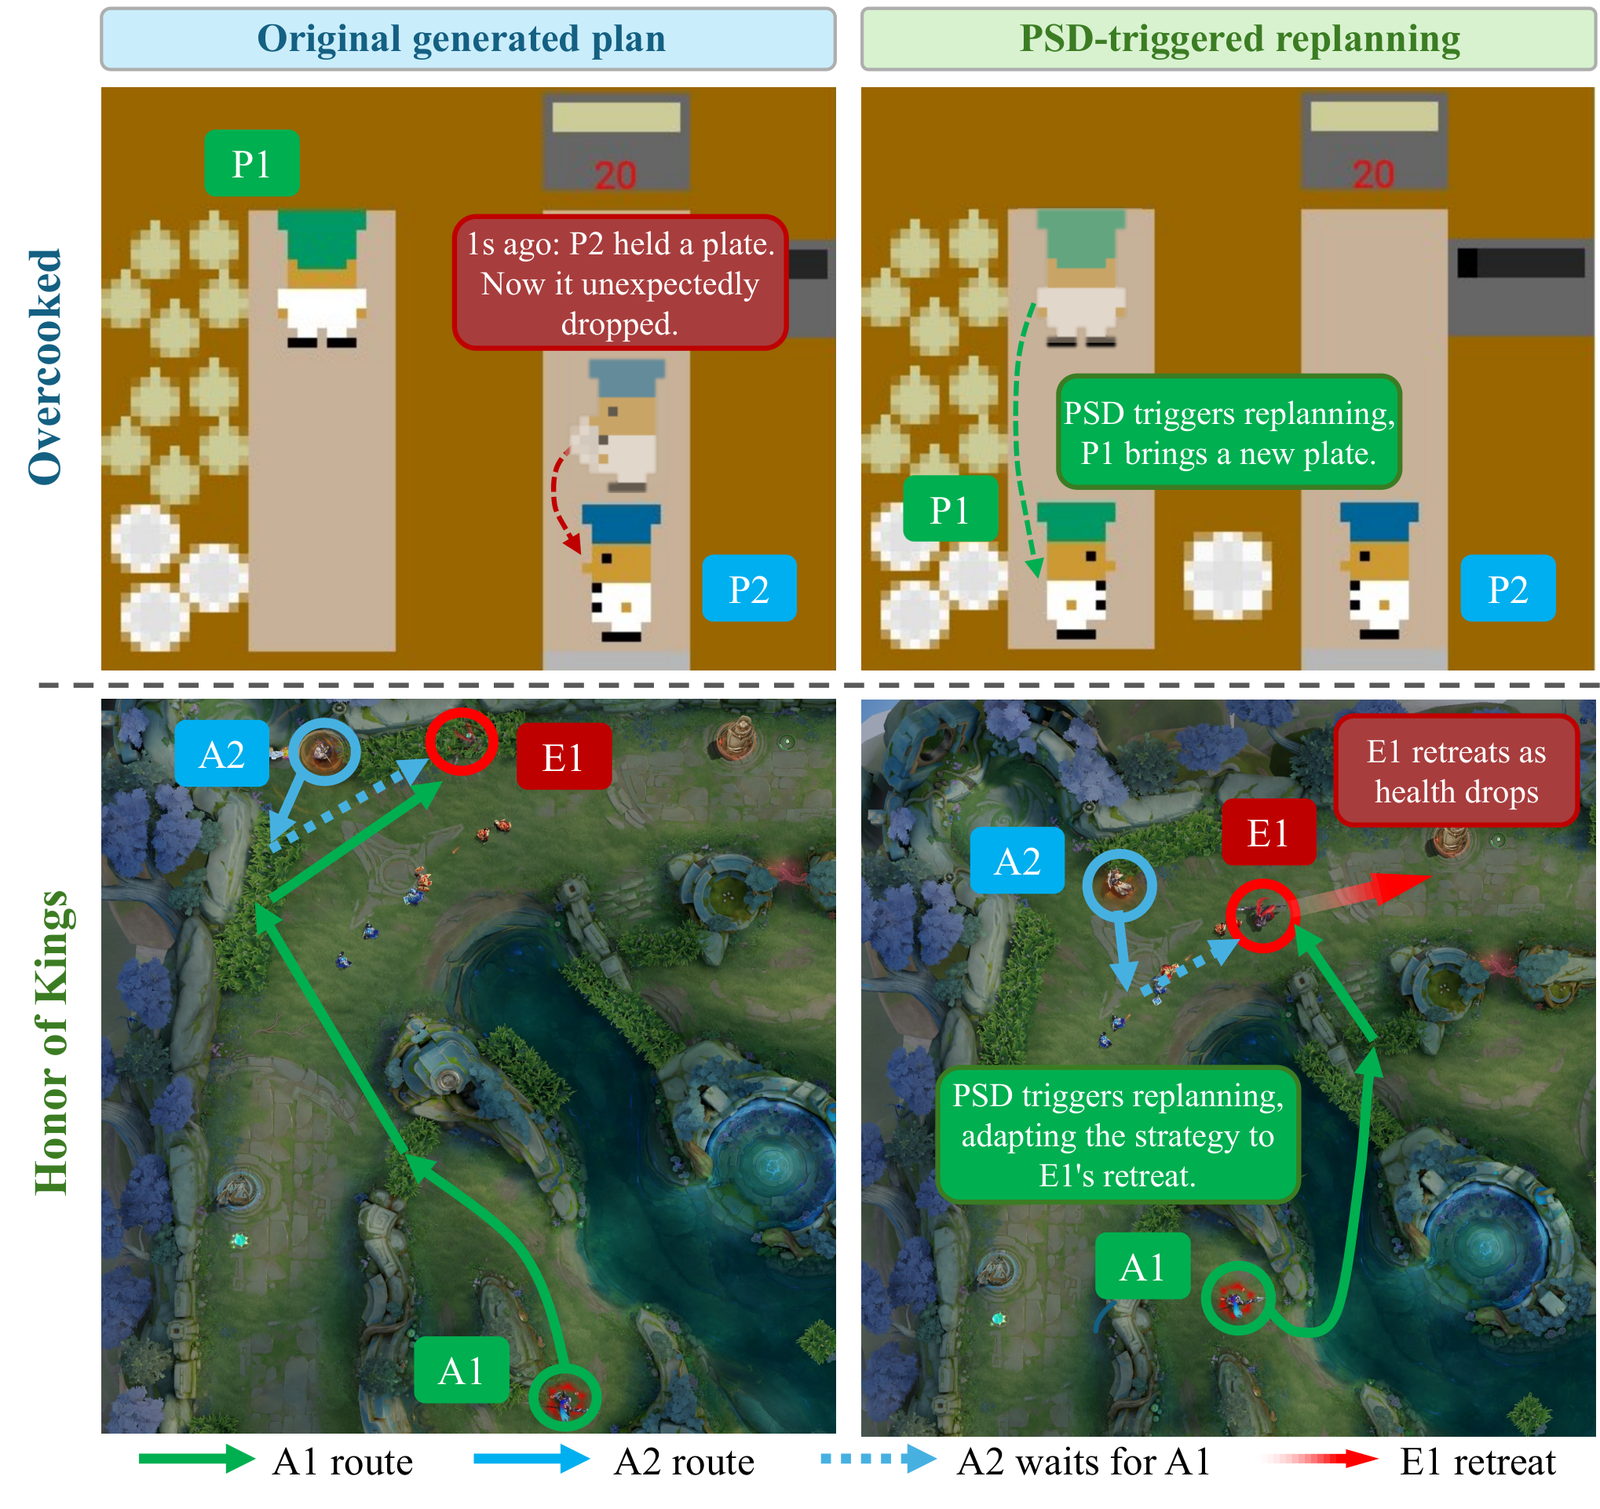
\[P_{\mathrm{replan}}(t)=\sigma\left(MLP\left(\mathbf{H}_{C}^{\top}\mathbf{H}_{X}\right)\right)\]如果某个队友在端菜途中被卡位导致盘子掉落,或者 MOBA 中预定集火的目标残血交闪现逃离了技能范围,PSD 会瞬间捕捉到这种“实际环境状态与剩余动作链预期不符”的偏差,并判定 $P_{\mathrm{replan}}(t)$ 超出阈值,精准唤醒大模型重新制定后续动作链。而在战局符合预期时,整个系统完全由低级执行器以接近零开销的算力全速推进。
从仿制到对齐:密集反馈下的规划强化学习
拥有了良好的框架接口后,另一个关键问题浮出水面:未经专门调优的大模型往往缺乏对底层物理交互与时序约束的感知。通用大模型生成的动作链即使在语法上完全符合 JSON Schema,也可能因为没有考虑到低级智能体的移动加速度、碰撞体积或技能后摇,而在执行层面频繁超时甚至诱发死锁。
为了彻底打通意图生成与底层执行之间的断层,SyncPlan 采用了两阶段训练管道:有监督微调(SFT)热启动加面向规划的强化学习(Planning-oriented RL)。
SFT 阶段主要利用专家对局轨迹以及从强推理模型中蒸馏得到的数据,让协调器牢固掌握带有同步原语的结构化动作链表达格式,建立合理的协同先验。但仅凭 SFT 无法真正解决执行对齐问题,因为离线轨迹中没有包含“如果动作慢了半拍会发生什么”的动态惩罚。
随后的 RL 阶段则将整个动作链规划看作一个强化学习策略优化过程。作者没有采用稀疏的单纯胜负奖励,而是设计了包含内在进展与执行惩罚的复合稠密奖励函数:
\[R(A)=\underbrace{R_{\mathrm{prog}}(A)+\alpha\,\mathbb{1}[\Omega(A)=\textsc{Succ}]}_{\text{内在奖励 }R_{\mathrm{intr}}(A)} - \underbrace{(P_{\mathrm{tmo}}+P_{\mathrm{syn}}+P_{\mathrm{sem}}+P_{\mathrm{dlk}})}_{\text{惩罚项 }\mathcal{P}(A)}\]奖励函数中的内在部分不仅包含任务最终成功的稀疏指示量,更引入了阶段性任务进度反馈 $R_{\mathrm{prog}}$;惩罚项则极其严格地对执行层面的四种典型失败模式进行回馈:超时惩罚 $P_{\mathrm{tmo}}$、同步失败惩罚 $P_{\mathrm{syn}}$、语义非法惩罚 $P_{\mathrm{sem}}$ 以及诱发死锁惩罚 $P_{\mathrm{dlk}}$。
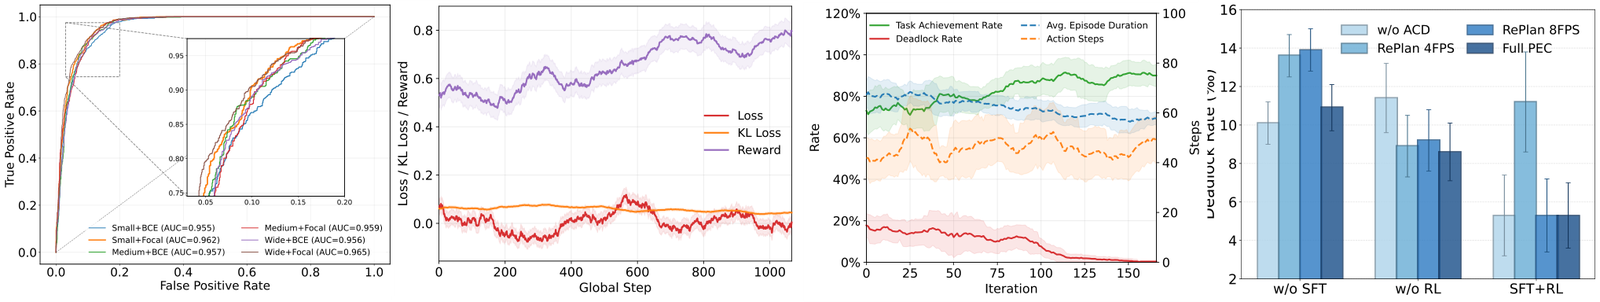
图 5 的实验数据直观印证了这一训练范式的有效性。在 RL 训练过程中,模型的任务成功率与复合奖励稳步攀升,同时死锁发生率持续受到压制。SFT 赋予了模型生成合规动作链的基础语法,而面向执行环境的 RL 闭环则真正教会了模型感知底层实体的物理约束,大幅减少了由于低估行进耗时而导致的指令超时或资源冲突。
复杂对抗验证:Overcooked 与王者荣耀 5v5
为了全面检验长程协同与实时适应能力,作者将 SyncPlan 部署在两个具有鲜明对比的基准环境中:以经典合作博弈著称的 Overcooked,以及极度依赖毫秒级博弈的复杂 MOBA 环境《王者荣耀》。
在 Overcooked 的评测中,不仅包含标准厨房任务,还涵盖了更为严苛的动态干扰测试(包含食材随机位移、路线阻断等)。实验结果表明,在相同的底层执行逻辑下,SyncPlan 的任务达成率平均高出此前最强的大模型协同基线 12.2 个百分点。更惊人的是在运行耗时上,由于摆脱了逐帧或多轮的自然语言沟通,且绝大部分重规划请求被 PSD 拦截,SyncPlan 的实际物理运行时间仅为此前 LLM 基线的 0.05% 不到,将高延迟的大模型协同推到了接近传统强化学习算法的响应水平。
而在王者荣耀的 Commander 模式中,SyncPlan 需要同时指挥最多 5 位己方英雄对指定的敌方目标进行集火打击。在这类复杂的 5v5 对抗中,敌方受内置 AI 驱动进行高频闪躲与技能反击,战局瞬息万变。
实验表明,SyncPlan 取得了 86.3% 的任务达成率,相较于此前的前沿基准 DPT-Agent(68.7%)实现了高达 17.6 个百分点的显著提升。同时,SyncPlan 的动作超时率(Action Timeout Rate)由 baseline 的 12.1% 骤降至 2.3%,端到端运行时间缩减了 26 倍以上。消融实验更进一步指出了各个模块的不可或缺性:如果移除 PSD、退回到固定间隔重规划,任务成功率会发生滑坡,且运行开销急剧攀升;而如果缺失了 RL 阶段的对齐微调,模型在复杂 MOBA 中的动作超时率会直接从 2.3% 反弹到 7.9%。
模型容量与协同能力的临界阈值
在大模型作为智能体控制核心的研究中,人们常常关心一个根本性问题:我们需要多大参数量的模型才能胜任多智能体协同?
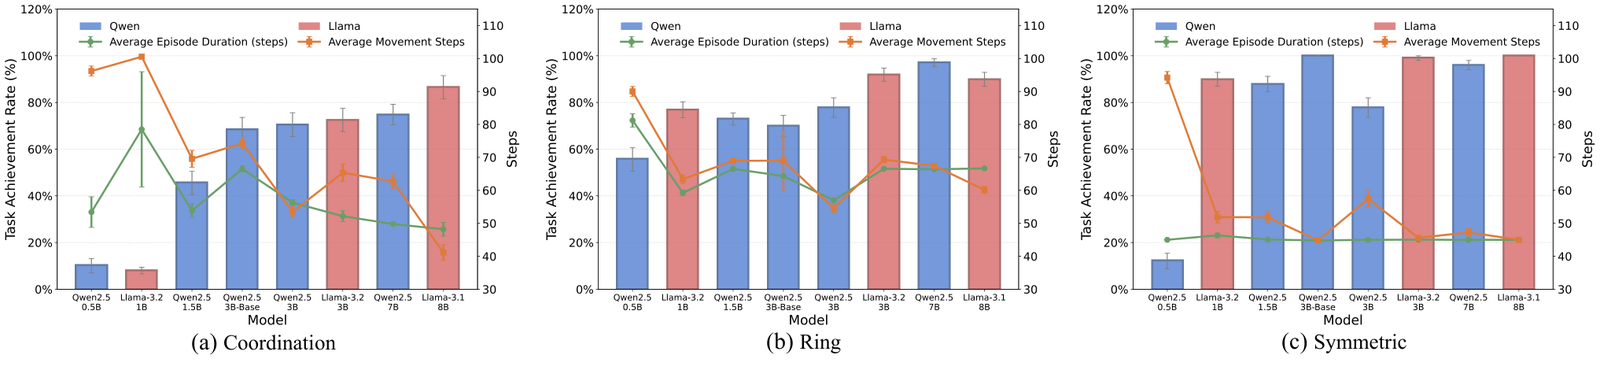
研究团队通过系统评估 LLaMA-3.2(1B/3B)、LLaMA-3.1(8B)以及 Qwen2.5(0.5B/1.5B/3B/7B)等一系列不同体量的底座模型,绘制出了清晰的性能缩放曲线。
实验发现,多智能体协同规划能力的涌现存在一个明显的“临界参数阈值”,大约位于 1B 到 1.5B 之间:
-
低于 1B 的模型几乎不可用:无论是在 Overcooked 还是 MOBA 中,0.5B 级别的极小模型都无法稳定生成符合长程结构化 Schema 的动作链,其输出格式的崩溃率极高,导致下游执行器根本无法解析同步原语;
-
1.5B 到 3B 是性价比极高的黄金区间:模型一旦越过 1.5B 阈值,遵循结构化规划约束的能力呈现对数线性增长,能够稳定产出精准的时序依赖与同步动作;
-
超过 3B 后收益放缓:当参数量达到 7B 或 8B 甚至更大时,任务达成率的提升开始进入平缓期。这是因为 SyncPlan 的结构化规划模式本身已经极大地收敛了决策的搜索空间,一旦底座模型完全掌握了格式遵循与基本战术逻辑,单纯增加参数量带来的增益便会出现边际效用递减。
这一结论在工程部署上具有深远的实践意义:它证明了高效的多智能体协调并不一定要捆绑昂贵且缓慢的数百亿参数巨型模型,通过合理的框架约束(显式同步+状态纠偏)配合面向执行的强化学习,一个轻量级的 3B 级别小模型就足以支撑起帧级动态环境下的多智能体实时协同。
总结与未来启示
SyncPlan 的价值不仅在于刷新了 Overcooked 或王者荣耀的基准指标,更在于它为大模型在具身智能、实时游戏与多机器人协作等长程动态场景下的落地提供了一套具有普适性的范式参考。
长期以来,社区在“大模型实时性差”这一痛点上往往寄希望于推理硬件加速,或者被迫倒退回端到端的黑盒 MARL。SyncPlan 表明,通过在软件架构上将“长程意图生成”、“底层确定性同步”以及“轻量级环境看门狗”进行解耦分工,既能保留大模型对复杂任务的高阶分解与常识理解优势,又能彻底甩掉高频调用的性能包袱。随着未来小参数量开源模型推理能力的进一步演进,这种将符号化显式约束与自适应修正融为一体的协调架构,或将成为大模型真正走向物理世界并发控制的关键路径。